"triu_tril_cuda_template" not implemented for 'BFloat16' が発生する現象と対処法
モデル読み込みで torch_dtype=torch.bfloat16 を指定したとき "triu_tril_cuda_template" not implemented for 'BFloat16' が発生する場合の対処法です
以下は llama3 で発生したときのログです。
  File "/home/mlu/.virtualenvs/ChatStream/lib/python3.10/site-packages/torch/nn/modules/module.py", line 1501, in _call_impl
    return forward_call(*args, **kwargs)
  File "/home/mlu/.virtualenvs/ChatStream/lib/python3.10/site-packages/transformers/models/llama/modeling_llama.py", line 1208, in forward
    outputs = self.model(
  File "/home/mlu/.virtualenvs/ChatStream/lib/python3.10/site-packages/torch/nn/modules/module.py", line 1501, in _call_impl
    return forward_call(*args, **kwargs)
  File "/home/mlu/.virtualenvs/ChatStream/lib/python3.10/site-packages/transformers/models/llama/modeling_llama.py", line 992, in forward
    causal_mask = self._update_causal_mask(attention_mask, inputs_embeds, cache_position, past_seen_tokens)
  File "/home/mlu/.virtualenvs/ChatStream/lib/python3.10/site-packages/transformers/models/llama/modeling_llama.py", line 1095, in _update_causal_mask
    causal_mask = torch.triu(causal_mask, diagonal=1)
RuntimeError: "triu_tril_cuda_template" not implemented for 'BFloat16'
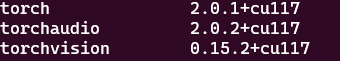
この問題は、 Pytorch が 2.0.1 以下であるときに発生します。
pip list で torch バージョンを確認してみてください。
pip list以下のように、 2.0.1 だと triu_tril_cuda_template が文字通り実装されていないためエラーとなります
対処法
Pytorch を最新にすることで問題は解決します
- CUDA 12.x
pip install --upgrade torch torchvision torchaudio
- CUDA 11.8
pip3 install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
バージョン指定してもOK
pip install torch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0