Qualiteg プロダクト開発部

Qualiteg プロダクト開発部
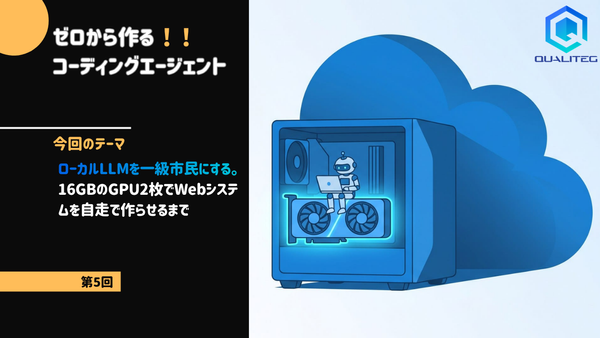
ゼロから作るコーディングエージェント【第5回】ローカルLLMを一級市民にする。16GBのGPU2枚でWebシステムを自走で作らせるまで

AIエージェント

ゼロから作るコーディングエージェント【第5回】ローカルLLMを一級市民にする。16GBのGPU2枚でWebシステムを自走で作らせるまで

RTX A5000(24GB)1枚で始めて、ローカルモデル7種類が全滅。RTX A4000(16GB)2枚にQwen3.6-35B-A3BをAWQ 4bitで載せ、fp8のKVキャッシュと98kの文脈で、認証つきWebシステムを3本連続93.8〜96.5点で作らせるまでの構成と落とし穴。モデルの癖、量子化の劣化、文脈長、壊れたツール呼び出しの直し方を、測った数字で書きます。
By Qualiteg プロダクト開発部
ゼロから作るコーディングエージェント【第4回】自走の規律は「人がいない場面」のためのもの。人がいるなら止まって聞く

AIエージェント

ゼロから作るコーディングエージェント【第4回】自走の規律は「人がいない場面」のためのもの。人がいるなら止まって聞く

評価ランで鍛えた「止まらない」規律を、人が答えられる場面にまで効かせていました。曖昧な指示に聞き返したモデルを押し戻して勝手に作らせる、断られた確認を形を変えて7回聞き直す、他人のプロセスの止め方を教える。6種類の使い方を演じて出た19件から、人がいる場面の設計と、設定の不備を1行で止める話を書きます。

By Qualiteg プロダクト開発部
日本語対応 LLMランキング2026 ~ベンチマーク分析レポート~(10月22日版)

LLM

日本語対応 LLMランキング2026 ~ベンチマーク分析レポート~(10月22日版)

まず結論 2026年10月22日時点のLLMランキング 日本語対応LLMランキングの2026年10月22日版です。前置きは後回しにして、まず最新のランキングからお見せします。 フロンティアモデルの最新ランキング TOP20(Epoch Capabilities Index) 順位 モデル 開発元 提供形態 公開日(Epoch AI記載) ECI 1Claude Opus 5.5AnthropicAPI09/22168.8 2GPT-6 AstraOpenAIAPI09/03168.8 3GPT-6.1 SolOpenAIAPI09/29168.4 4Claude Fable 5.1AnthropicAPI09/01166.5 5Gemini 4 ArgonGoogleAPI09/30166.4 6Claude Sonnet 5.5AnthropicAPI09/28166.2

By Qualiteg プロダクト開発部, Qualiteg コンサルティング
CEATEC 2026に出展します!AIアバター動画生成「MotionVox®」の最新版を実体験いただけます

News

CEATEC 2026に出展します!AIアバター動画生成「MotionVox®」の最新版を実体験いただけます

株式会社Qualitegは、2026年10月13日(火)~16日(金)に幕張メッセで開催される「CEATEC 2026」に出展いたします。今回の出展では、当社が開発したAIアバター動画生成サービス「MotionVox®」の最新版を中心に、動画生成の実演と作例をご紹介いたします。 昨年の CEATEC 2025 に続き、2年連続の出展となります。昨年の会場の様子は 出展レポート にまとめております。 出展概要 * 会期 2026年10月13日(火)~10月16日(金)10:00~17:00 * 会場 幕張メッセ(千葉県千葉市美浜区中瀬2-1) * 出展エリア ネクストジェネレーションパーク * ブース番号 ホール4 4H339 * 入場 無料(来場事前登録制) * CEATEC内特設サイト https://www.ceatec.com/nj/exhibitor_

By Qualiteg プロダクト開発部
ゼロから作るコーディングエージェント【第3回】「止まらなかった」は「進んだ」ではない。空転を数え、思考は切らずに上限だけ置く

AIエージェント

ゼロから作るコーディングエージェント【第3回】「止まらなかった」は「進んだ」ではない。空転を数え、思考は切らずに上限だけ置く

300ターン走ってAPIが0本。「モデルの限界」と結論を書いた翌日、記録を読み直すと234ターンがツールを1度も呼んでいませんでした。空転率という指標、1つ塞ぐと次の形に移る空転、思考をオフにすると95点が71点に落ちて時間も縮まなかった話、出力枠を広げたら反対側を数える話を書きます。

By Qualiteg プロダクト開発部
Ubuntuの自動更新でカーネルだけ上がり、再起動したらGPUが消えた。NVIDIAモジュールが置き去りになる原因と3つの対策

GPU

Ubuntuの自動更新でカーネルだけ上がり、再起動したらGPUが消えた。NVIDIAモジュールが置き去りになる原因と3つの対策

Ubuntu 24.04のGPUサーバーを再起動したらnvidia-smiが動かない。原因はunattended-upgradesがカーネルだけを更新し、NVIDIAモジュールが依存関係の都合で見送られていたこと。ログで原因を突き止め、1コマンドで復旧し、apt-mark holdを含む3つの再発防止策を比べて採用した記録。

By Qualiteg プロダクト開発部
ゼロから作るコーディングエージェント【第2回】完了は「作った」ではなく「動いた」で決める。完了の門と、押し戻しに書くこと

AIエージェント

ゼロから作るコーディングエージェント【第2回】完了は「作った」ではなく「動いた」で決める。完了の門と、押し戻しに書くこと

モデルの「完了しました」は5つの形ですり抜けました。構文検査だけ、テストは通るが動かない、待ち受けは立つが最初の要求で落ちる、起動するが仕様のAPIが無い、assertの無いテスト。完了の門を3段で閉じる設計と、押し戻しに「落ちた行と調べ方」を書いて「答え」を書かない理由を、数字つきで書きます。

By Qualiteg プロダクト開発部
「Blackwell」は 1 つではなかった。NVIDIA の Compute Capability 番号のわかりにくさを整理する

GPU

「Blackwell」は 1 つではなかった。NVIDIA の Compute Capability 番号のわかりにくさを整理する

こんにちは! NVIDIA の GPU を扱っていると、sm_120 や sm_100 といった番号を見かけます。Compute Capability と呼ばれる番号です。 この番号、製品の世代名と対応しているように見えて、実はずれています。 きっかけは、2026年9月23日に公開された TensorRT-LLM の v1.3.0rc28 でした。リリースノートに「SM107」という記述があります。次世代の Rubin に対応した、という文脈です。 ここで引っかかります。Blackwell の GeForce は sm_120 です。次の世代の Rubin が、なぜ 107 という小さい番号なのでしょうか。 調べてみると、引っかかりの原因は Rubin ではありませんでした。

By Qualiteg プロダクト開発部
ゼロから作るコーディングエージェント【第1回】「最後までやりきる」が難しい理由と、ターンを回す係と止める係を分ける設計

AIエージェント

ゼロから作るコーディングエージェント【第1回】「最後までやりきる」が難しい理由と、ターンを回す係と止める係を分ける設計

コーディングエージェントを自作すると、いちばん難しいのはループを回すことではなく「いつ止めるか」を決めることでした。あるランでは、300ターン中234ターンでツールが1度も呼ばれていませんでした。この数字を出発点に、ターンを回す係と止めてよいか決める係を分け、押し戻しの送り方を直すまでを書きます。

By Qualiteg プロダクト開発部
Claude Codeで急にgrepが承認待ちになる v2.1.259でRead denyルールがBashのgrepにも効くようになった

Claude Codeで急にgrepが承認待ちになる v2.1.259でRead denyルールがBashのgrepにも効くようになった

Claude Code を bypassPermissions で走らせているのに、今日から grep -r が承認待ちで止まるようになった。原因は 2026年9月2日リリースの v2.1.259 で、settings.json の Read deny ルールが Bash の grep にも当たるようになったこと。前日の v2.1.258 と並べて実測し、通る書き方と通らない書き方を表にまとめました。

By Qualiteg プロダクト開発部
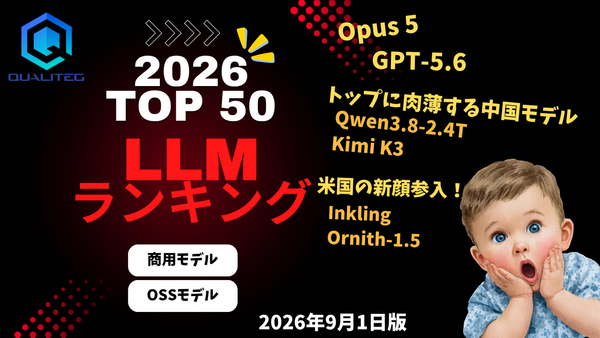
日本語対応 LLMランキング2026 ~ベンチマーク分析レポート~(9月1日版)

LLM

日本語対応 LLMランキング2026 ~ベンチマーク分析レポート~(9月1日版)

はじめに 本レポートは、Nejumi Leaderboard 4のベンチマークデータ(2026/9/1版)に基づいて、日本語対応LLMの性能を総合的に分析したものです。 前回は 2026/7/10 版の分析レポート を公開しましたが、わずか2か月弱で首位が入れ替わり、 オープンモデルが総合3位に食い込む激アツの回となりました! (定期的に最新LLMランキングを更新してまいります。当社のX(旧Twitter)をフォローいただくことで更新情報を受け取り可能です) Nejumi Leaderboard 4は、日本語タスクにおけるLLMの性能を多角的に評価する信頼性の高いベンチマークとして知られています。汎用的言語性能(GLP)とアラインメント(ALT)の2軸で構成され、翻訳・要約・推論・コーディングから毒性・バイアス・真実性まで、幅広い観点をカバーしているのが特徴です。 本分析では、商用APIモデルとオープンモデルの両方を対象に、それぞれの特徴や傾向を詳しく見ていきます。 まず、今回の3大トピックを先にご紹介します。 * Claude Opus 5が総合スコア0.8720で

By Qualiteg プロダクト開発部, Qualiteg コンサルティング