日本語対応 LLMランキング2026 ~ベンチマーク分析レポート~(10月22日版)
まず結論 2026年10月22日時点のLLMランキング
日本語対応LLMランキングの2026年10月22日版です。前置きは後回しにして、まず最新のランキングからお見せします。
フロンティアモデルの最新ランキング TOP20(Epoch Capabilities Index)
| 順位 | モデル | 開発元 | 提供形態 | 公開日(Epoch AI記載) | ECI |
|---|---|---|---|---|---|
| 1 | Claude Opus 5.5 | Anthropic | API | 09/22 | 168.8 |
| 2 | GPT-6 Astra | OpenAI | API | 09/03 | 168.8 |
| 3 | GPT-6.1 Sol | OpenAI | API | 09/29 | 168.4 |
| 4 | Claude Fable 5.1 | Anthropic | API | 09/01 | 166.5 |
| 5 | Gemini 4 Argon | API | 09/30 | 166.4 | |
| 6 | Claude Sonnet 5.5 | Anthropic | API | 09/28 | 166.2 |
| 7 | Claude Opus 5 | Anthropic | API | 07/24 | 163.9 |
| 8 | GPT-6 Sol | OpenAI | API | 09/22 | 163.7 |
| 9 | Claude Fable 5 | Anthropic | API | 06/09 | 163.4 |
| 10 | GPT-5.5 Pro | OpenAI | API | 04/23 | 162.9 |
| 11 | GPT-5.6 Sol | OpenAI | API | 07/09 | 162.8 |
| 12 | Muse Wonder | Meta AI | API | 10/12 | 161.8 |
| 13 | GPT-5.6 Terra | OpenAI | API | 07/09 | 160.1 |
| 14 | GPT-5.5 | OpenAI | API | 04/23 | 159.7 |
| 15 | GPT-5.4 Pro | OpenAI | API | 03/05 | 159.6 |
| 16 | Claude Haiku 5.5 | Anthropic | API | 10/07 | 159.3 |
| 17 | Claude Opus 4.8 | Anthropic | API | 05/28 | 159.0 |
| 18 | Gemini 3.7 Flash | API | 08/13 | 158.0 | |
| 19 | Kimi K3 | Moonshot | オープン | 07/16 | 157.9 |
| 20 | Gemini 3.8 Flash | API | 09/02 | 157.4 |
※総合能力の指数(Epoch AI、10月21日更新)。読み方と考察は第1部で。
日本語タスクの実測ランキング TOP10(Nejumi Leaderboard 4)
| 順位 | モデル名 | カテゴリ | 総合スコア |
|---|---|---|---|
| 1 | anthropic/claude-opus-5: adaptive-thinking-max | api | 0.8720 |
| 2 | anthropic/claude-fable-5: adaptive-thinking-max with fallback to Opus 4.8 | api | 0.8699 |
| 3 | Qwen/Qwen3.8-2.4T-A95B: reasoning-xhigh | Large (30B+) | 0.8598 |
| 4 | anthropic/claude-opus-4.8: adaptive-thinking-xhigh | api | 0.8523 |
| 5 | anthropic/claude-opus-4.7: adaptive-thinking-xhigh | api | 0.8509 |
| 6 | openai/gpt-5.6-sol: max-effort | api | 0.8499 |
| 7 | openai/gpt-5.6-terra: max-effort | api | 0.8440 |
| 8 | moonshotai/kimi-k3: reasoning-max | api | 0.8432 |
| 9 | google/gemini-3.1-pro-preview | api | 0.8430 |
| 10 | moonshotai/Kimi-K3: reasoning-enabled | Large (30B+) | 0.8425 |
※日本語タスクの総合スコア(評価ラン単位)。水色の行はオープンモデル。2位のClaude Fable 5はOpus 4.8へのフォールバックを含む構成での評価値です。TOP50の全表と考察は第2部で。
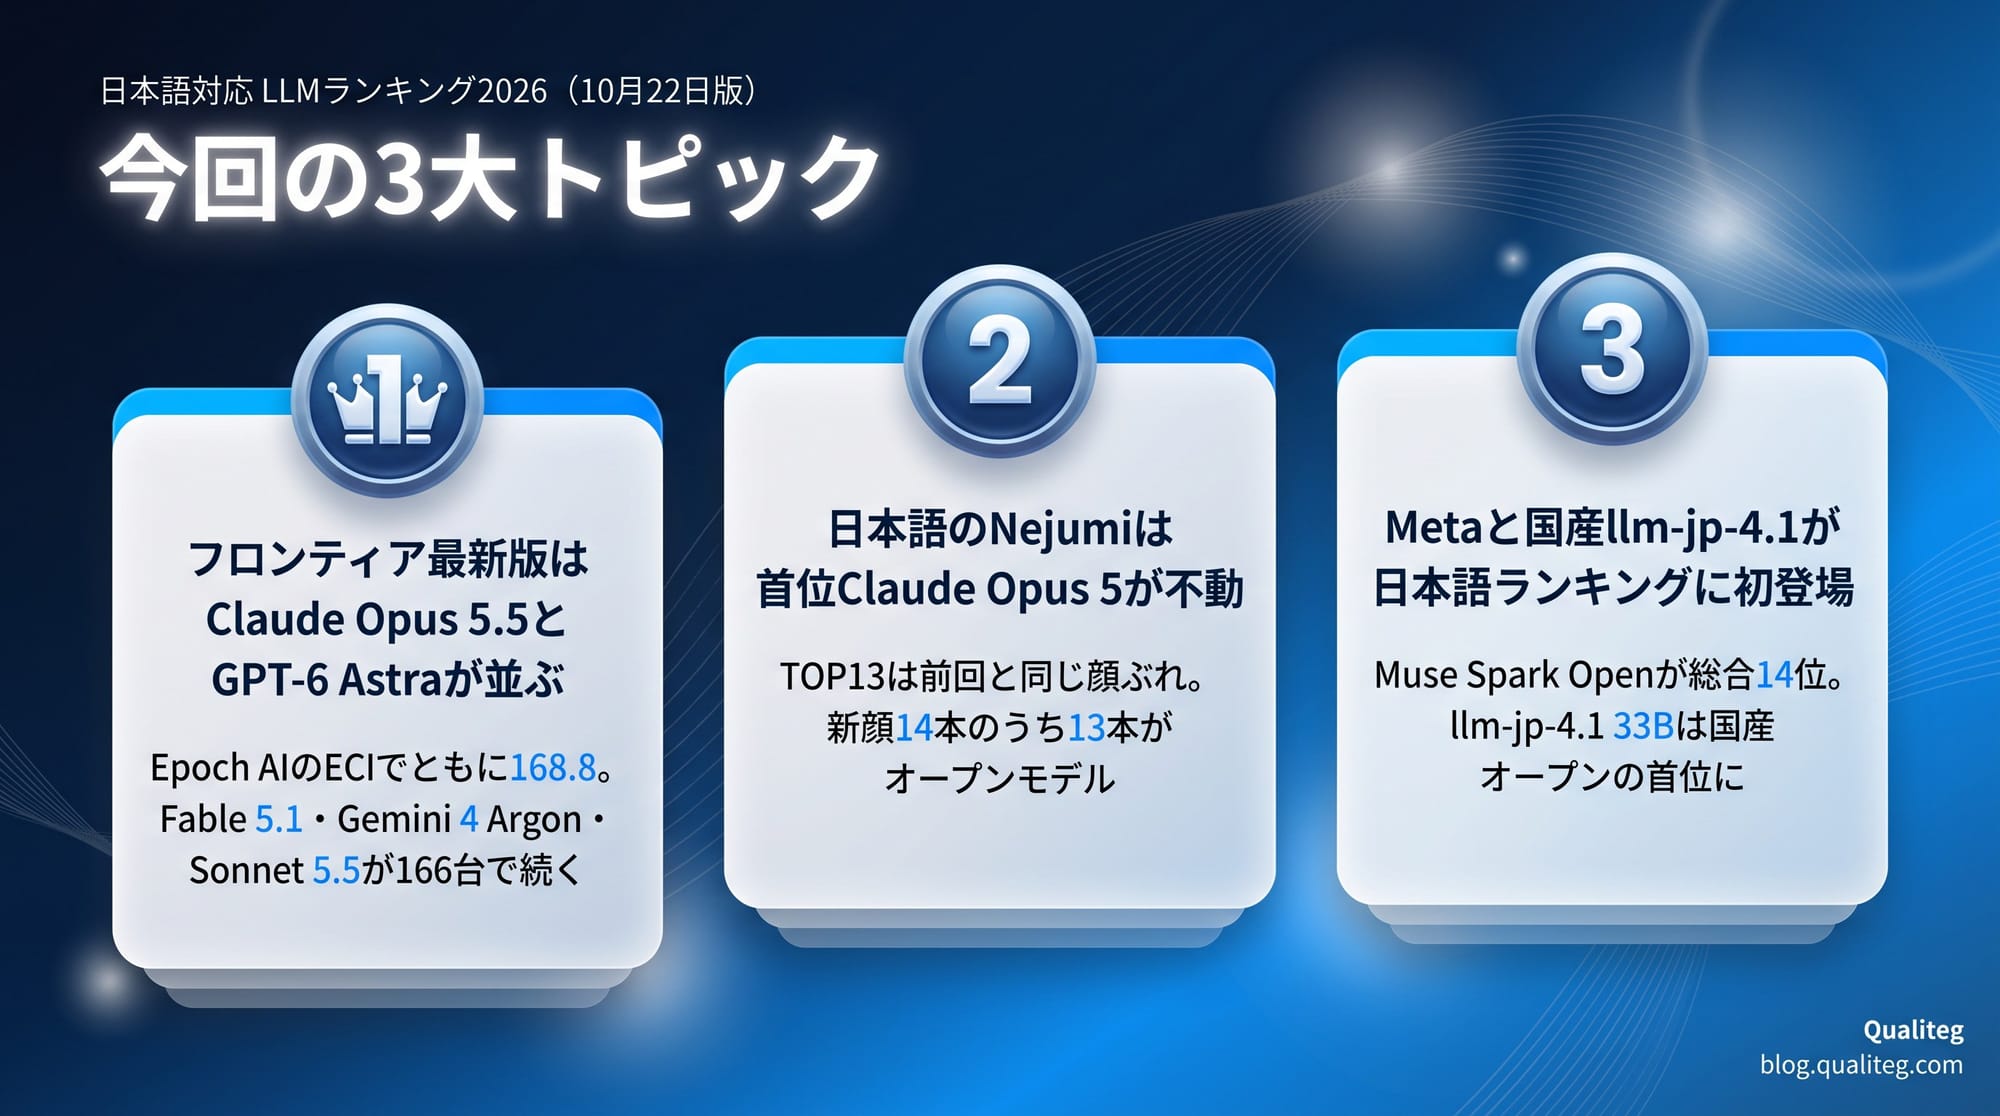
今回の3大トピックは次のとおりです。
- フロンティア最新版はClaude Opus 5.5とGPT-6 Astraが並ぶ。
Epoch AIのECIでともに168.8。Claude Fable 5.1、Gemini 4 Argon、Claude Sonnet 5.5が166台で続き、いずれもNejumiでは未評価です - 日本語のNejumiは首位Claude Opus 5(0.8720)が不動。TOP13の顔ぶれは前回とまったく同じで、新顔14モデルのうち13本がオープンモデルでした
- Metaと国産llm-jp-4.1が日本語ランキングに初登場。
MetaのオープンモデルMuse Spark Openが総合14位(0.8379)、国立情報学研究所のllm-jp-4.1は33B版が国産オープンモデルの首位に立ちました
(定期的に最新LLMランキングを更新してまいります。当社のX(旧Twitter)をフォローいただくことで更新情報を受け取り可能です)
今回から2部構成にした理由と、3つのランキングの位置づけ
前回の 2026/9/1 版 まで、本シリーズはNejumi Leaderboard 4(Weights & Biases Japan)※のデータだけを使ってきましたが、公開直後のモデルも追うことができる新たなランキングソースを併用することになりました。
今回から、公開直後のモデルも追える独立評価のデータを第1部に置き、Nejumiの詳しい分析を第2部に置く2部構成にしました。
今回から使うのは次の3つです。測り方が違うので、3つの点数を横に並べて比べることはしません。
| ランキング | 運営 | 何を測っているか | 対象 | 最新の更新 |
|---|---|---|---|---|
| Epoch Capabilities Index(ECI) | Epoch AI(米国の研究機関) | 50 以上のベンチマークを統合した「総合能力」の指数。自社の実測、独立リーダーボード、開発元の報告値を組み合わせる | 商用 API とオープンの両方 | 10月21日 |
| Arena 日本語カテゴリ | Arena(旧 LMArena) | 人が 2 つのモデルの回答を見比べて投票した結果を Bradley-Terry 法でレーティング化。日本語のプロンプトだけを集計 | 商用 API とオープンの両方 | 10月20日 |
| Nejumi Leaderboard 4 | Weights & Biases Japan | 日本語タスクの汎用的言語性能(GLP)とアラインメント(ALT)を 2 軸・35 列で実測 | 商用 API とオープンの両方 | 最新ラン 10月19日(米国の商用 API 勢は 7月25日が最後) |
※水色の行は第1部、白の行は第2部で使います。
- Epoch Capabilities Index(ECI) 米国の研究機関Epoch AIが、GPQA DiamondやSWE-bench Verifiedなど50以上のベンチマークの結果を1本の「総合能力」の物差しに統合した指数。Epoch自身の実測に加え、独立リーダーボードの値や開発元の報告値も取り込むため、公開から数日で新モデルが載ります。値が大きいほど高性能で、推定値には信頼区間が付きます(Epoch AIの公開データ)
- Arenaの日本語カテゴリ 利用者が同じ質問を2つのモデルに投げ、良かったほうに投票した結果をレーティング化したもの。ベンチマークではなく「日本語で人がどちらを好むか」の集計で、投票数が少ないモデルは順位が動きやすい点に注意(Arenaの公開データ)
- Nejumi Leaderboard 4 翻訳・要約・推論・コーディングから毒性・バイアス・真実性まで、日本語タスクでの実力をGLPとALTの2軸・35列で実測。「何が得意で何が危ういか」が内訳まで見える点が他の2つにない価値
なお、独立評価機関のArtificial AnalysisやVals AIも最新モデルをいち早く載せています。本稿では数値を転載せず、リンクのみ紹介します。
第1部 フロンティアモデルの最新ランキング
総合能力でみる最新フロンティア(Epoch Capabilities Index)
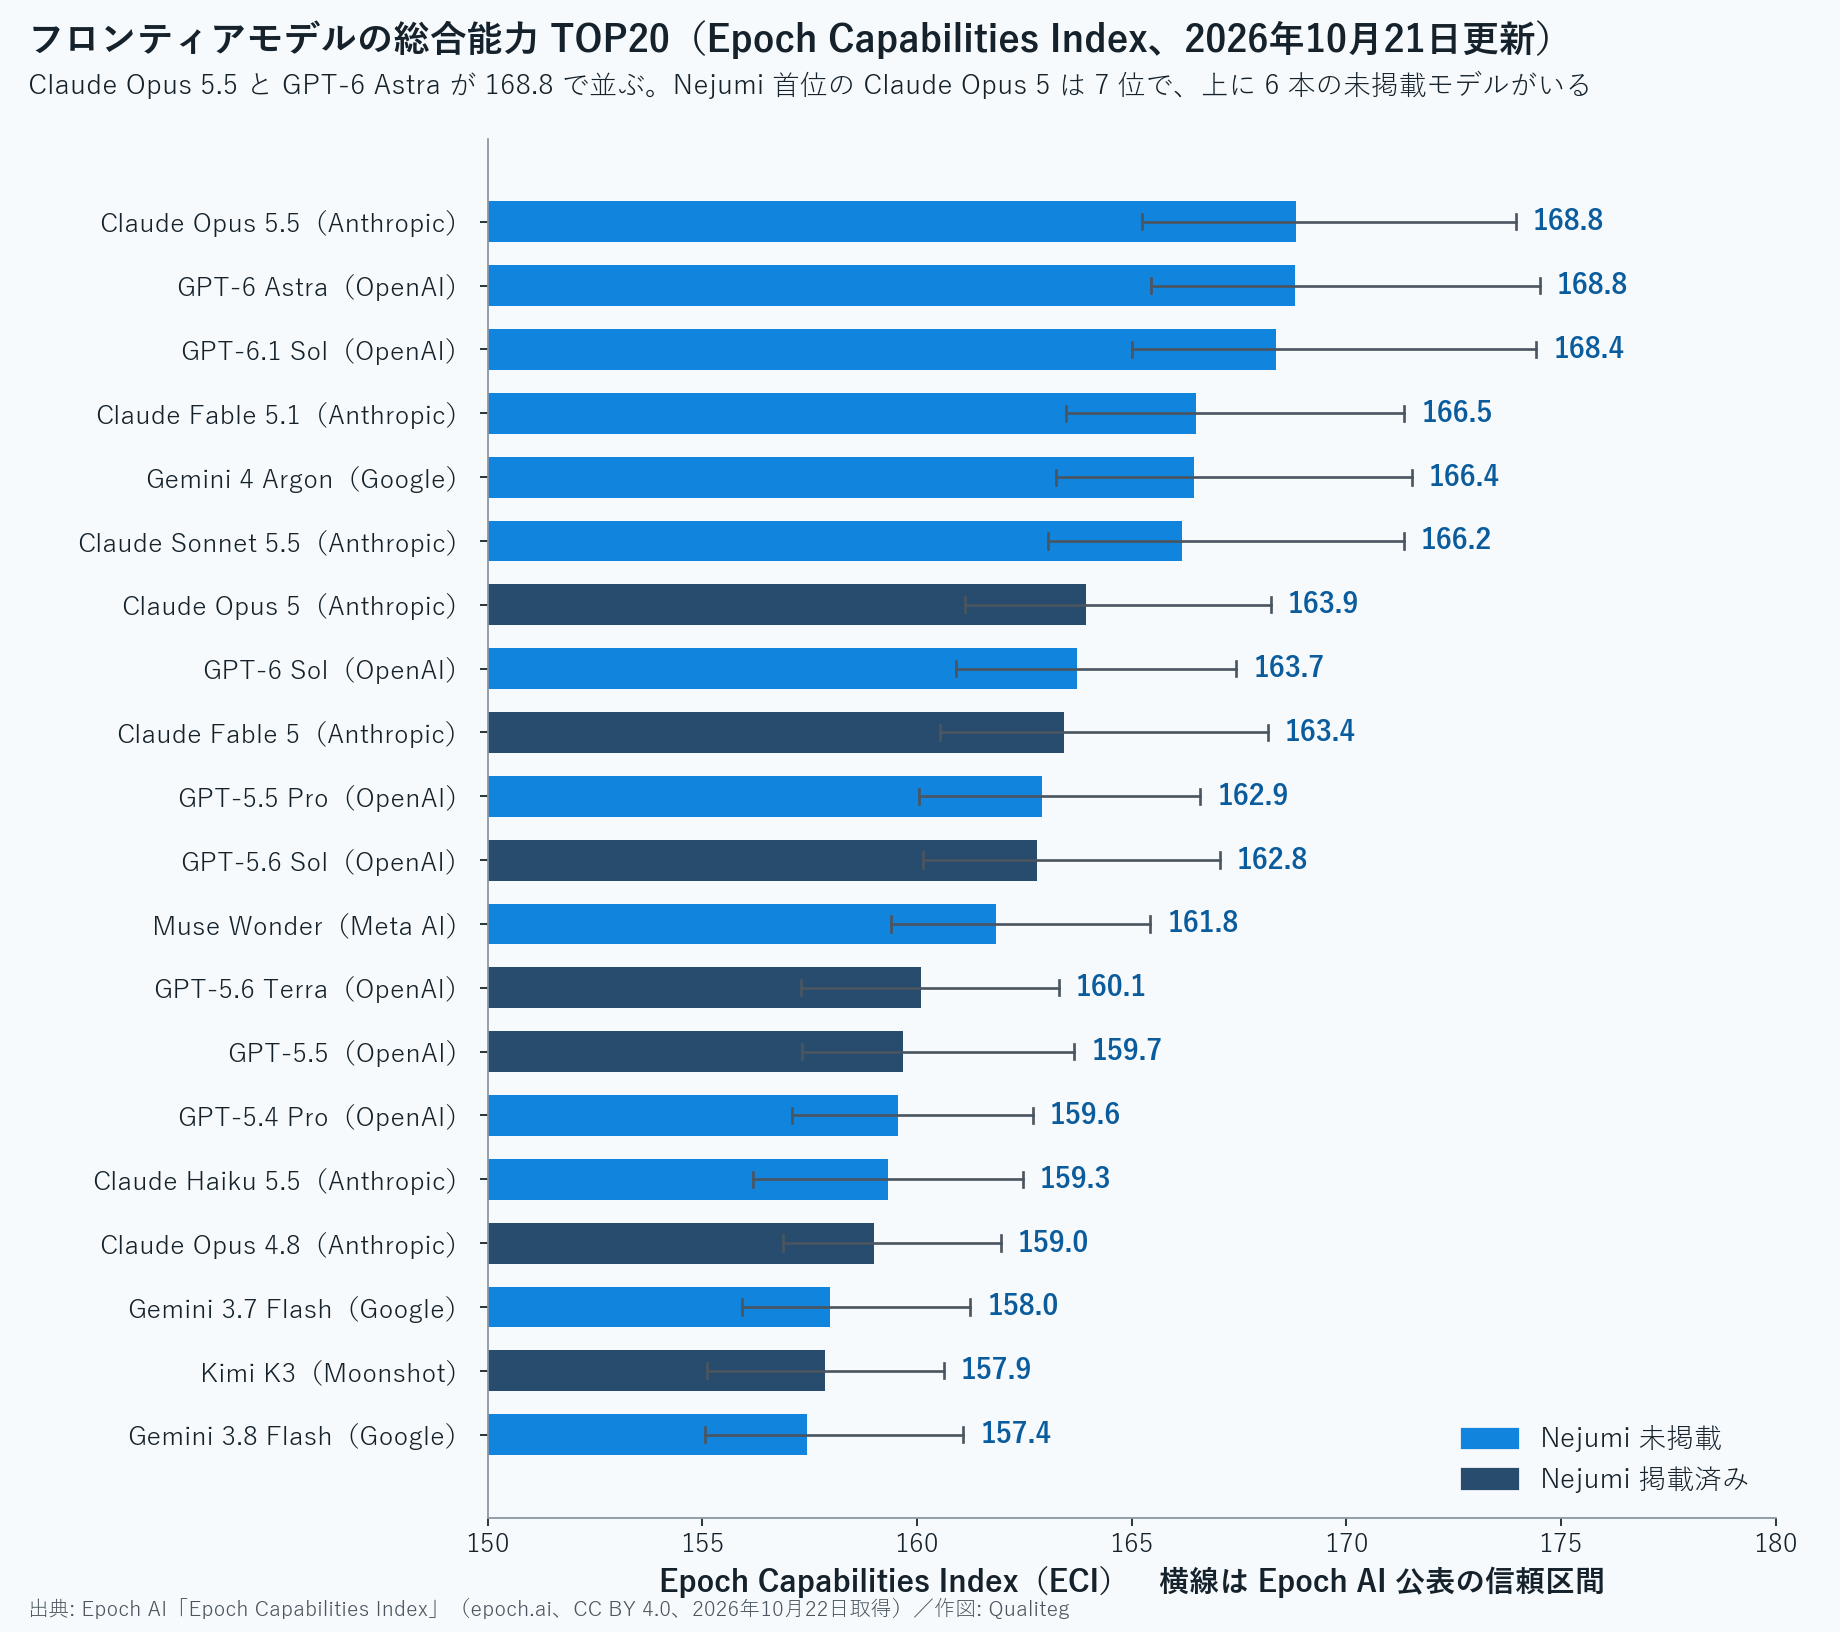
冒頭に載せたTOP20の表を再掲します。
| 順位 | モデル | 開発元 | 提供形態 | 公開日(Epoch AI記載) | ECI |
|---|---|---|---|---|---|
| 1 | Claude Opus 5.5 | Anthropic | API | 09/22 | 168.8 |
| 2 | GPT-6 Astra | OpenAI | API | 09/03 | 168.8 |
| 3 | GPT-6.1 Sol | OpenAI | API | 09/29 | 168.4 |
| 4 | Claude Fable 5.1 | Anthropic | API | 09/01 | 166.5 |
| 5 | Gemini 4 Argon | API | 09/30 | 166.4 | |
| 6 | Claude Sonnet 5.5 | Anthropic | API | 09/28 | 166.2 |
| 7 | Claude Opus 5 | Anthropic | API | 07/24 | 163.9 |
| 8 | GPT-6 Sol | OpenAI | API | 09/22 | 163.7 |
| 9 | Claude Fable 5 | Anthropic | API | 06/09 | 163.4 |
| 10 | GPT-5.5 Pro | OpenAI | API | 04/23 | 162.9 |
| 11 | GPT-5.6 Sol | OpenAI | API | 07/09 | 162.8 |
| 12 | Muse Wonder | Meta AI | API | 10/12 | 161.8 |
| 13 | GPT-5.6 Terra | OpenAI | API | 07/09 | 160.1 |
| 14 | GPT-5.5 | OpenAI | API | 04/23 | 159.7 |
| 15 | GPT-5.4 Pro | OpenAI | API | 03/05 | 159.6 |
| 16 | Claude Haiku 5.5 | Anthropic | API | 10/07 | 159.3 |
| 17 | Claude Opus 4.8 | Anthropic | API | 05/28 | 159.0 |
| 18 | Gemini 3.7 Flash | API | 08/13 | 158.0 | |
| 19 | Kimi K3 | Moonshot | オープン | 07/16 | 157.9 |
| 20 | Gemini 3.8 Flash | API | 09/02 | 157.4 |
※公開日はEpoch AIの記載によります。
ECIの首位はClaude Opus 5.5(168.8)とGPT-6 Astra(168.8)で、推定値の差は約0.02ポイントです。Epoch AIが公表する信頼区間(Opus 5.5が165.3〜174.0、Astraが165.5〜174.5)も大きく重なっており、今回のデータから明確な優劣を判断することはできません。3位のGPT-6.1 Sol(168.4)も近い水準にあります。
その下にClaude Fable 5.1(166.5)、Gemini 4 Argon(166.4)、Claude Sonnet 5.5(166.2)が166台で並びます。ここまでの6本はすべてNejumi未掲載です。
Nejumiで首位のClaude Opus 5は、ECIでは163.9の7位です。つまりNejumiの首位の上に、未評価のモデルが6本いることになります。ECIとNejumiは測り方が違うので順位がそのまま移るわけではありませんが、これらがNejumiに載ったとき、日本語ランキングの上位が動く可能性は十分あります。
ほかに目を引く点が3つあります。
- Metaのフロンティア参戦 10月12日公開のMuse Wonder(161.8)は、Metaの商用APIモデルとして初めてECIのTOP12に入りました。第2部で紹介するオープンモデルのMuse Spark Open(155.1)とは別の、上位版です
- 小型モデルが前世代の旗艦に並ぶ Claude Haiku 5.5(159.3)が、5月公開の旗艦Claude Opus 4.8(159.0)と同じ水準です。Claude Sonnet 5.5(166.2)にいたっては、Nejumi首位のOpus 5(163.9)を上回ります
- オープンモデルの最高位はKimi K3 オープンウェイトで最も高いのはKimi K3の157.9(19位)で、GLM-5.3(156.0)、DeepSeek V4.1 Flash(155.9)、Muse Spark Open(155.1)が続きます。ECIの上では、オープン勢と最上位API勢の差は約11ポイントです
ECIは開発元の報告値も含む指数なので、ベンダー公称の影響をゼロにはできません。それでも、独立リーダーボードの値と自社実測を合わせて算出している点で、公開直後のモデルの相対位置を知るには現状もっとも使いやすい指標です。
日本語での人間評価(Arena 日本語カテゴリ)
| 順位 | モデル(Arena 表記) | 開発元 | レーティング | 投票数 |
|---|---|---|---|---|
| 1 | Claude Fable 5.1 (Max) | anthropic | 1,562 | 282 |
| 2 | Claude Opus 5.5 (High) | anthropic | 1,534 | 179 |
| 3 | Claude Opus 5 (Max) | anthropic | 1,520 | 594 |
| 4 | Claude Opus 5 (High) | anthropic | 1,516 | 1,163 |
| 5 | Gemini 3.7 Flash (High) | 1,511 | 476 | |
| 6 | Gemini 3 Pro | 1,509 | 476 | |
| 7 | Gemini 3.8 Flash (High) | 1,507 | 762 | |
| 8 | Claude Fable 5 (High) | anthropic | 1,504 | 643 |
| 9 | GPT-5.5 (High) | openai | 1,499 | 907 |
| 10 | Qwen3.5-Max-Preview | alibaba | 1,495 | 209 |
| 11 | Kimi K3 (Max) | moonshot | 1,494 | 662 |
| 12 | Gemini 3.1 Pro Preview | 1,491 | 1,582 | |
| 13 | Gemini 3 Flash | 1,489 | 340 | |
| 14 | Claude Opus 4.6 (High) | anthropic | 1,488 | 950 |
| 15 | Gemini 3.5 Flash (High) | 1,486 | 700 |
※括弧内はArenaが区別している推論設定です。
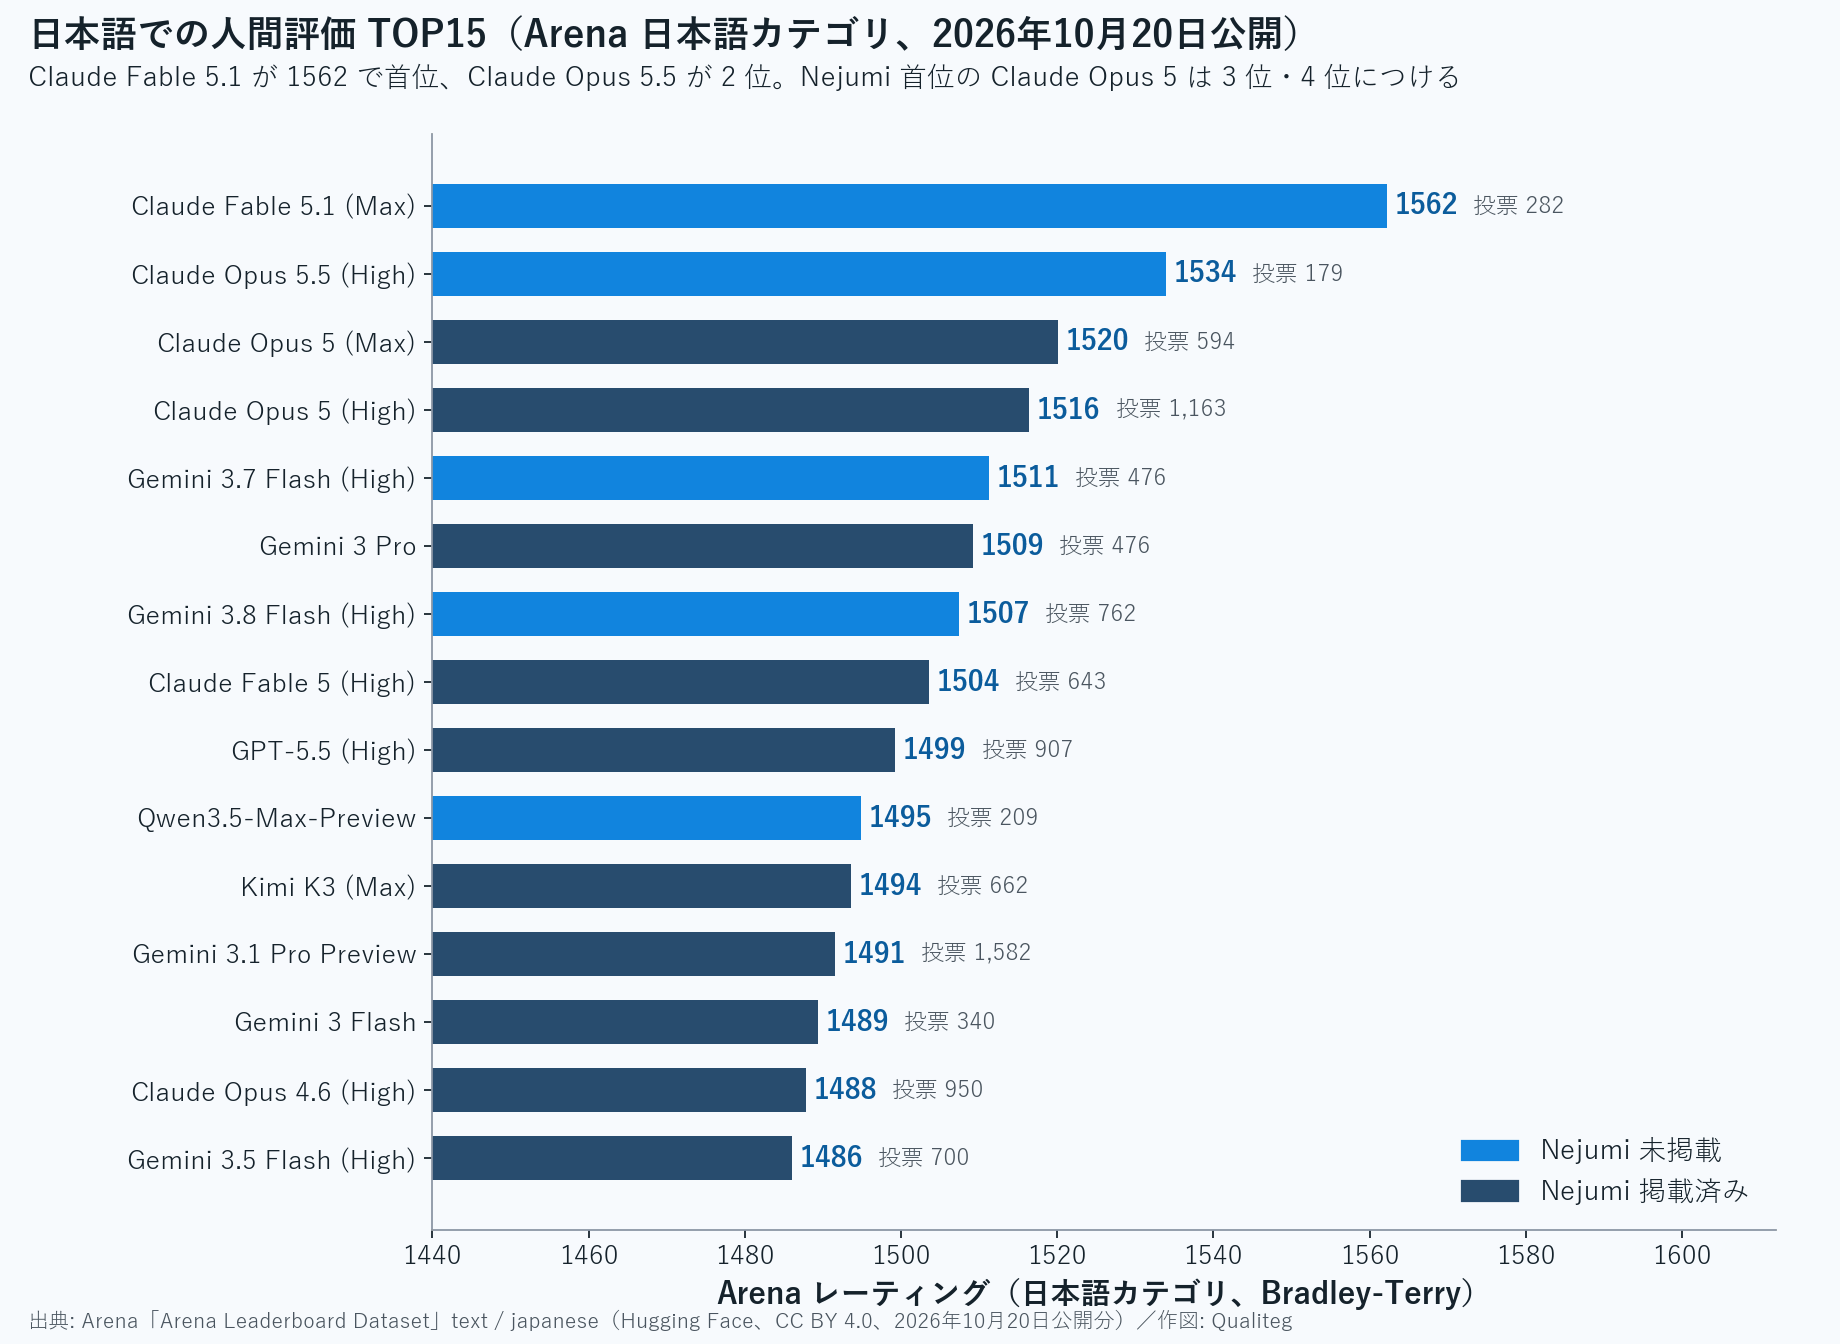
日本語のプロンプトだけを集計したArenaの日本語カテゴリでは、Claude Fable 5.1(1562)が首位、Claude Opus 5.5(1534)が2位です。Nejumi首位のClaude Opus 5は3位・4位につけており、総合能力のECIと同じく「Opus 5の上にFable 5.1とOpus 5.5がいる」構図が、日本語の人間評価でも見えています。
ただし、Fable 5.1の投票数は282件とまだ少なく、今後レーティングが変動する可能性があります。Opus 5(High設定)は1,163票、Gemini 3.1 Pro Previewは1,582票と比較データが多いものの、順位の確からしさは投票数だけでなくレーティングの推定誤差も含めて判断する必要があります。
もうひとつ注目したいのは、ECIで首位に並ぶGPT-6 Astraが、今回取得した日本語カテゴリのTOP15に入っていないことです。Gemini 4 ArgonとMuse Wonderも同様です。日本語カテゴリに未掲載なのか、投票がまだ十分でないのか、単に16位以下なのかはこの表だけでは判断できないため、現時点では日本語での相対評価を保留します。
オープンモデルでは、Kimi K3(1494)が11位に入りました。第2部のNejumiでもオープン2位・総合10位にいるモデルで、日本語の人間評価でもオープン勢の先頭です。
第1部のまとめ 次にNejumiの上位を動かすのは誰か
- 総合能力(ECI)でも日本語の人間評価(Arena)でも、Claude Opus 5.5とClaude Fable 5.1がNejumi首位のClaude Opus 5より上にいます。Nejumiでも上位に入る有力候補ですが、日本語タスクでの首位交代は実際の評価結果を待つ必要があります
- GPT-6 Astraは総合能力では同率首位ですが、日本語の人間評価ではまだ上位に見えません。日本語タスクでの実力はNejumiの評価待ちです
- Claude Sonnet 5.5とClaude Haiku 5.5は、価格帯が下のモデルが前世代の旗艦級に並ぶ動きで、コスト重視の用途では有力な候補になります
それでは第2部で、日本語タスクでの実力をNejumi Leaderboard 4のデータから詳しく見ていきましょう。
第2部 日本語対応モデルのランキング(Nejumi Leaderboard 4)
第2部は、Nejumi Leaderboard 4のベンチマークデータ(2026/10/22版)に基づく分析です。今回は首位をはじめ上位の顔ぶれがそのまま動かなかった一方で、新たに登場した14モデルがすべてオープンモデルか米国以外の勢力という、静かながら地殻変動を感じる回となりました!
オープンソースモデルについて
Weightがオープンなモデルは場合によっては「オープンソースモデル」、「OSSモデル」と呼ばれますが、学習データや学習コードまで完全に公開されているモデルばかりではないため、本稿では「オープンモデル」という表記に統一しています。
ベンチマーク分析について
本レポートは、LLM選択の参考情報として、ベンチマークデータから読み取れる傾向や特徴を提示するものです。実際の導入にあたっては、用途に応じた実環境での検証をおすすめいたします。
また、今回の集計はリーダーボード掲載中の評価ラン(アーカイブ扱いを除く)を取得したデータに基づいています。同一モデルでも思考モード(reasoning/thinking)等の設定が異なる評価ランは別エントリーとして掲載される場合があります。
それでは、2026/10/22 現在の日本語対応LLMの総合ランキングをみてみましょう。
総合スコアランキング TOP50
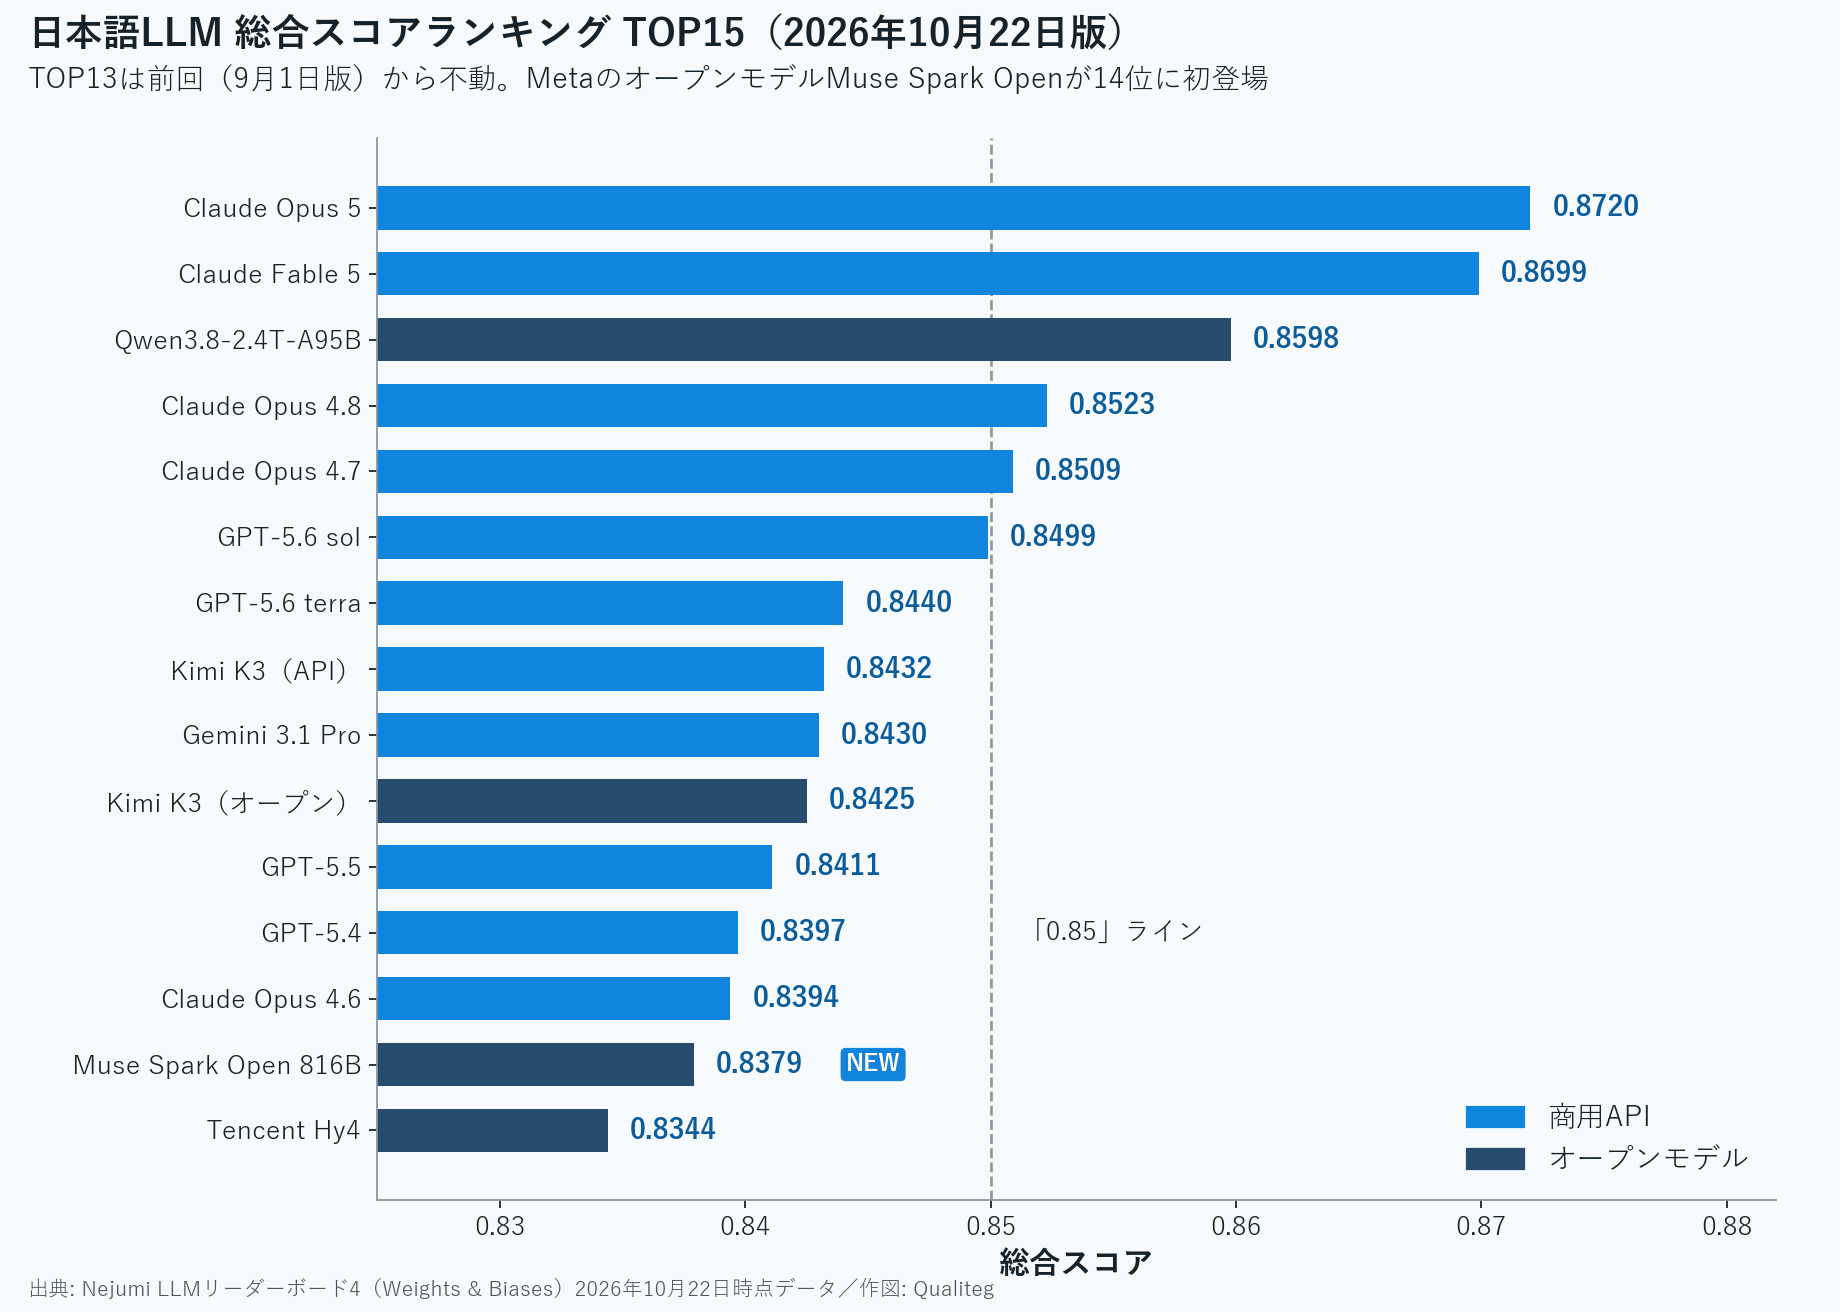
冒頭のTOP10を含む、TOP50の全表です。
| 順位 | モデル名 | カテゴリ | 総合スコア |
|---|---|---|---|
| 1 | anthropic/claude-opus-5: adaptive-thinking-max | api | 0.8720 |
| 2 | anthropic/claude-fable-5: adaptive-thinking-max with fallback to Opus 4.8 | api | 0.8699 |
| 3 | Qwen/Qwen3.8-2.4T-A95B: reasoning-xhigh | Large (30B+) | 0.8598 |
| 4 | anthropic/claude-opus-4.8: adaptive-thinking-xhigh | api | 0.8523 |
| 5 | anthropic/claude-opus-4.7: adaptive-thinking-xhigh | api | 0.8509 |
| 6 | openai/gpt-5.6-sol: max-effort | api | 0.8499 |
| 7 | openai/gpt-5.6-terra: max-effort | api | 0.8440 |
| 8 | moonshotai/kimi-k3: reasoning-max | api | 0.8432 |
| 9 | google/gemini-3.1-pro-preview | api | 0.8430 |
| 10 | moonshotai/Kimi-K3: reasoning-enabled | Large (30B+) | 0.8425 |
| 11 | openai/gpt-5.5-2026-04-23: xhigh-effort | api | 0.8411 |
| 12 | openai/gpt-5.4-2026-03-05: high-effort | api | 0.8397 |
| 13 | anthropic/claude-opus-4-6: extended-thinking | api | 0.8394 |
| 14 | meta-models/Muse-Spark-Open-816B-A42B: reasoning-xhigh | Large (30B+) | 0.8379 |
| 15 | tencent/Hy4-preview: reasoning-high | Large (30B+) | 0.8344 |
| 16 | google/gemini-3.6-flash | api | 0.8312 |
| 17 | qwen/qwen3.6-max-preview: openrouter-reasoning | api | 0.8295 |
| 18 | Qwen/Qwen3.8-Flash-Next: reasoning-xhigh | Large (30B+) | 0.8291 |
| 19 | zai-org/GLM-5.3: reasoning-max | Large (30B+) | 0.8287 |
| 20 | openai/gpt-5.4-2026-03-05: xhigh-effort | api | 0.8286 |
| 21 | openai/gpt-5.2-2025-12-11: xhigh-effort | api | 0.8285 |
| 22 | zai-org/GLM-5.3-Flash: reasoning-max | Large (30B+) | 0.8260 |
| 23 | google/gemini-3.5-flash | api | 0.8249 |
| 24 | thinkingmachines/Inkling: reasoning-max | Large (30B+) | 0.8244 |
| 25 | anthropic/claude-sonnet-4.6: extended-thinking | api | 0.8230 |
| 26 | thinkingmachines/Inkling-Small: reasoning-max | Large (30B+) | 0.8222 |
| 27 | tencent/Hy3: reasoning-high | Large (30B+) | 0.8200 |
| 28 | Qwen/Qwen3.5-397B-A17B: reasoning-enabled | Large (30B+) | 0.8191 |
| 29 | deepseek-ai/DeepSeek-V4-Flash-0731: reasoning-max | Large (30B+) | 0.8169 |
| 30 | ornith-ai/Ornith-1.5-397B: reasoning-enabled | Large (30B+) | 0.8161 |
| 31 | XiaomiMiMo/MiMo-V2.6-Pro-MOPD: reasoning-enabled | Large (30B+) | 0.8159 |
| 32 | deepseek-ai/DeepSeek-V4.1-Flash: reasoning-effort-100 | Large (30B+) | 0.8158 |
| 33 | zai-org/GLM-5.2: reasoning-max | Large (30B+) | 0.8156 |
| 34 | xai/grok-4.5: reasoning-high | api | 0.8156 |
| 35 | google/gemini-3-flash-preview | api | 0.8155 |
| 36 | openai/gpt-5.6-luna: max-effort | api | 0.8145 |
| 37 | google/gemini-3-pro-preview | api | 0.8134 |
| 38 | Qwen/Qwen3.5-122B-A10B: reasoning-enabled | Large (30B+) | 0.8094 |
| 39 | Qwen/Qwen3.8-27B: reasoning-xhigh | Medium (10B-30B) | 0.8091 |
| 40 | openai/gpt-5.1-2025-11-13: high-effort | api | 0.8085 |
| 41 | deepseek-ai/DeepSeek-V4-Flash-Vision-Exp: reasoning-max | Large (30B+) | 0.8077 |
| 42 | google/gemma-4-31b-it | Large (30B+) | 0.8077 |
| 43 | deepseek-ai/DeepSeek-V4-Pro: reasoning-max | Large (30B+) | 0.8067 |
| 44 | anthropic/claude-opus-4.5-20251125: extended-thinking | api | 0.8064 |
| 45 | MiniMaxAI/MiniMax-M3: reasoning-enabled | Large (30B+) | 0.8061 |
| 46 | Qwen/Qwen3.5-27B: reasoning-enabled | Medium (10B-30B) | 0.8049 |
| 47 | z-ai/glm-5.2: openrouter-reasoning-xhigh | api | 0.8040 |
| 48 | anthropic/claude-opus-4-1-20250805: extended-thinking | api | 0.7992 |
| 49 | deepseek-ai/DeepSeek-V4-Pro-0813: reasoning-max | Large (30B+) | 0.7984 |
| 50 | Qwen/Qwen3.6-35B-A3B: reasoning-enabled | Large (30B+) | 0.7978 |
※水色の行はオープンモデルです。
総合スコアの傾向と考察
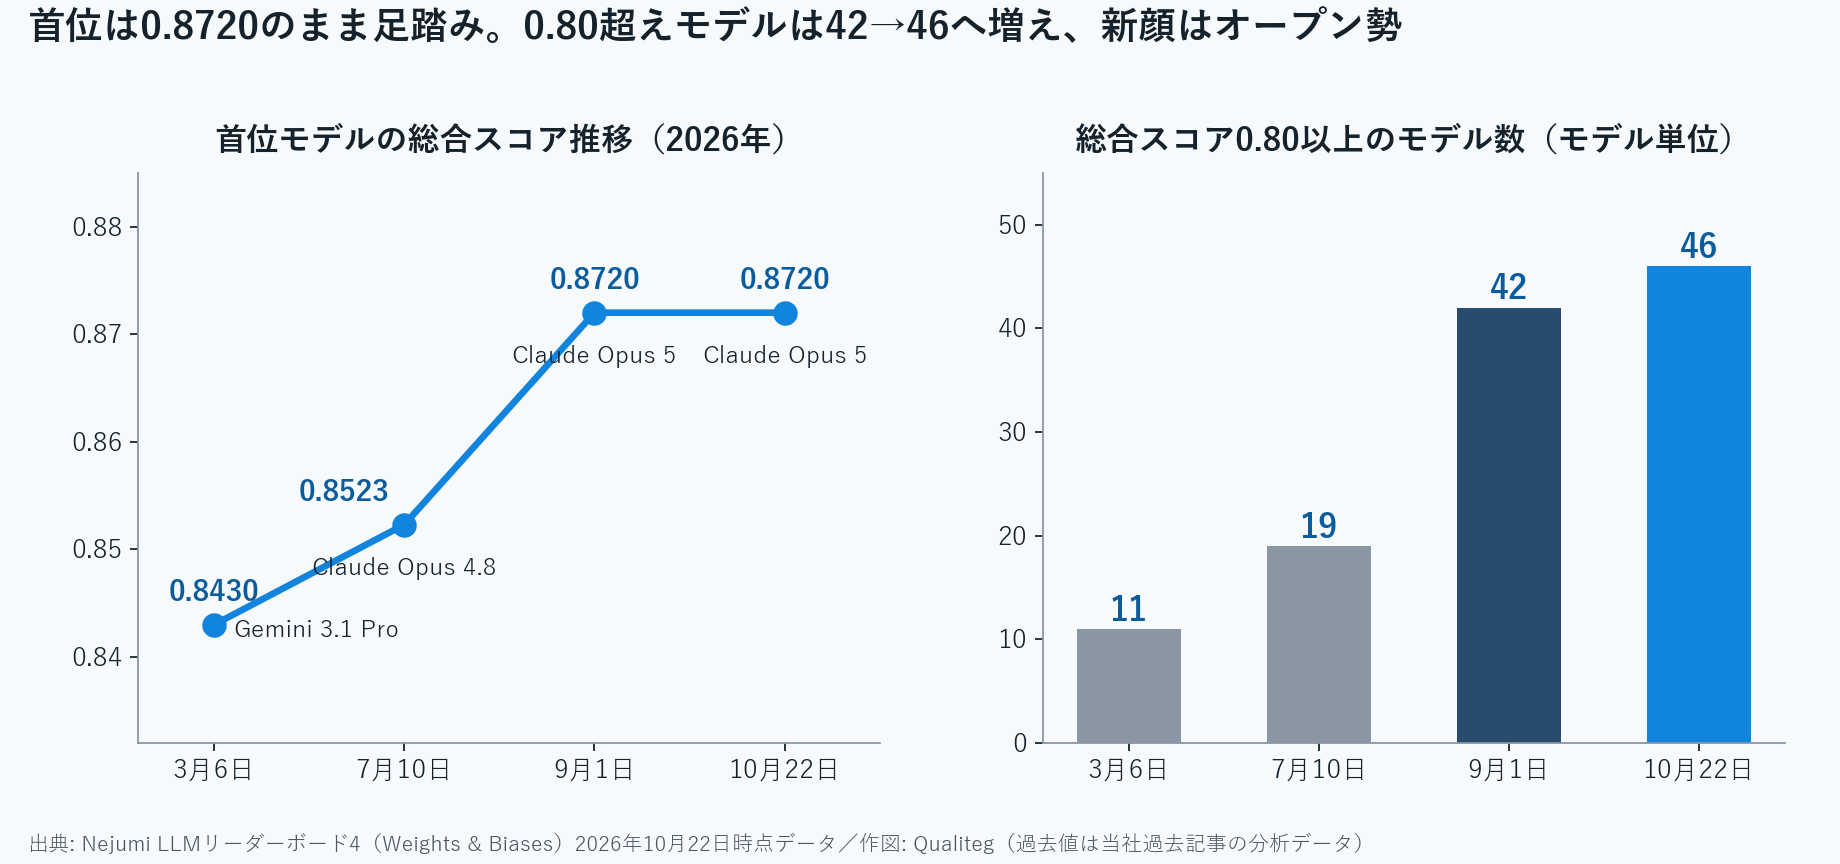
今回の最大の特徴は、なんといっても上位が動かなかったことです。首位のClaude Opus 5(0.8720)、2位のClaude Fable 5(0.8699)、3位のQwen3.8-2.4T-A95B(0.8598)から13位のClaude Opus 4.6(0.8394)まで、TOP13の顔ぶれも順位もスコアも前回とまったく同じでした。
- 0.85以上は5モデルで前回と同数(Opus 5/Fable 5/Qwen3.8/Opus 4.8/Opus 4.7)
- 0.80以上は46モデル(前回は42モデル。いずれもモデル単位で、同一モデルの複数評価ランは最高スコアの1本に統合して数えています。TOP50表は評価ラン単位なので、本数は一致しません)
- TOP50に入った新顔は4本。Muse Spark Open(14位)、MiMo-V2.6-Pro(31位)、DeepSeek-V4.1-Flash(32位)、DeepSeek-V4-Flash-Vision-Exp(41位)で、すべてオープンモデルです
- 押し出された前回の47〜50位(GPT-5、DeepSeek V4 Pro API版、Qwen3.6-27B、Claude Sonnet 4.5)は51〜55位へ。スコアは変わっていません
2026年に入って初めて、首位が据え置きに
本シリーズでは2026年3月6日版(Gemini 3.1 Pro)、7月10日版(Claude Opus 4.8)、9月1日版(Claude Opus 5)と、更新のたびに首位が入れ替わってきました。今回は2026年に入って初めて首位が据え置きです。
理由は単純で、この7週間にリーダーボードへ追加された評価ランのうち、Anthropic・OpenAI・Google・xAIといった米国の商用API勢のものが1本もなかったためです。新たに加わった15ラン(14モデル)のうち、商用APIは韓国UpstageのSolar Pro 4だけで、残る13モデルはすべてオープンモデルでした。
第1部で見たとおり、この間にGPT-6 Astra、Claude Opus 5.5、Claude Fable 5.1、Gemini 4 Argonなどが公開されていますが、いずれもNejumiでは未評価です。今回の順位は「評価済みのモデルの中での順位」であり、これらが評価されれば上位が動く可能性がある点を、あらかじめお断りしておきます。
Nejumiの中では、フロンティアの「上限」は動かず、「層の厚み」だけが増えた7週間でした。0.80超えの46モデルの内訳は、商用APIが23本、オープンモデルが23本と、ちょうど半々になりました。
新顔14モデルの顔ぶれ
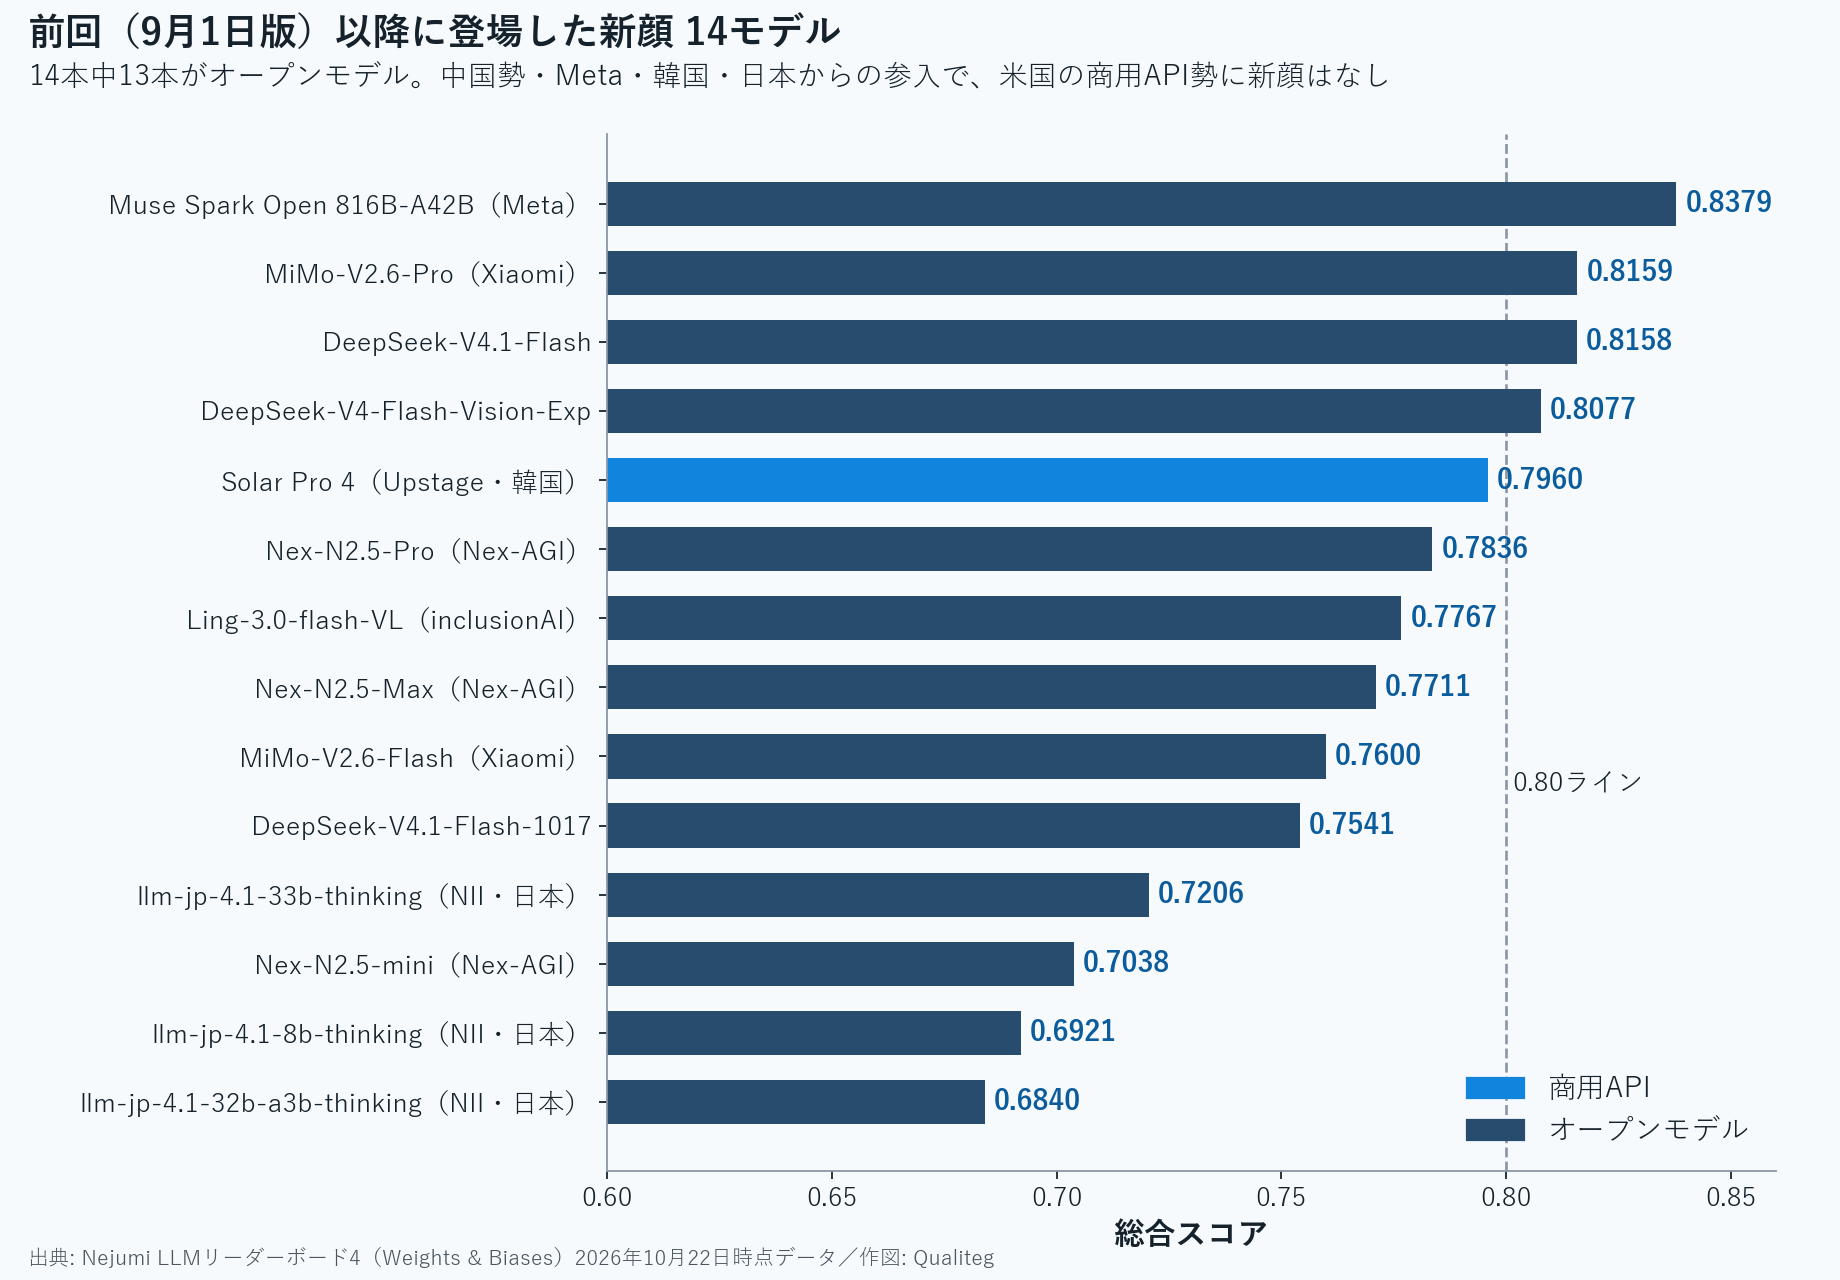
上図が、前回版以降にリーダーボードへ加わった14モデルの一覧です。とくに注目すべき新顔を紹介します。
- Muse Spark Open 816B-A42B(14位、0.8379) Metaのオープンモデルが総合TOP15、オープン部門3位に初登場(オープンモデルの章で詳しく紹介します)
- MiMo-V2.6-Pro(31位、0.8159) Xiaomiの総1.02T・アクティブ42BのMoE。前世代MiMo-V2.5-Pro(0.7812)から約0.035積み上げ、Xiaomi初の0.80超えです
- DeepSeek-V4.1-Flash(32位、0.8158) DeepSeekの新世代。GLP(言語性能)では前世代を上回りましたが、総合では旧版V4-Flash-0731(0.8169)にわずかに届きませんでした(次節で詳しく)
- Solar Pro 4(52位、0.7960) 韓国Upstageの商用APIで、今回唯一のAPI新顔。英語・韓国語に加えて日本語を公式の対応言語に掲げており、0.80にあと一歩まで迫りました
- llm-jp-4.1シリーズ(102位・117位・124位) 国立情報学研究所(NII)の国産モデルが3本同時に登場。33B版(0.7206)は国産オープンモデルの首位に立ちました(オープンモデルの章で詳しく紹介します)
GLP×ALTの勢力図 今回の教訓は「新版が旧版を抜けない」こともある
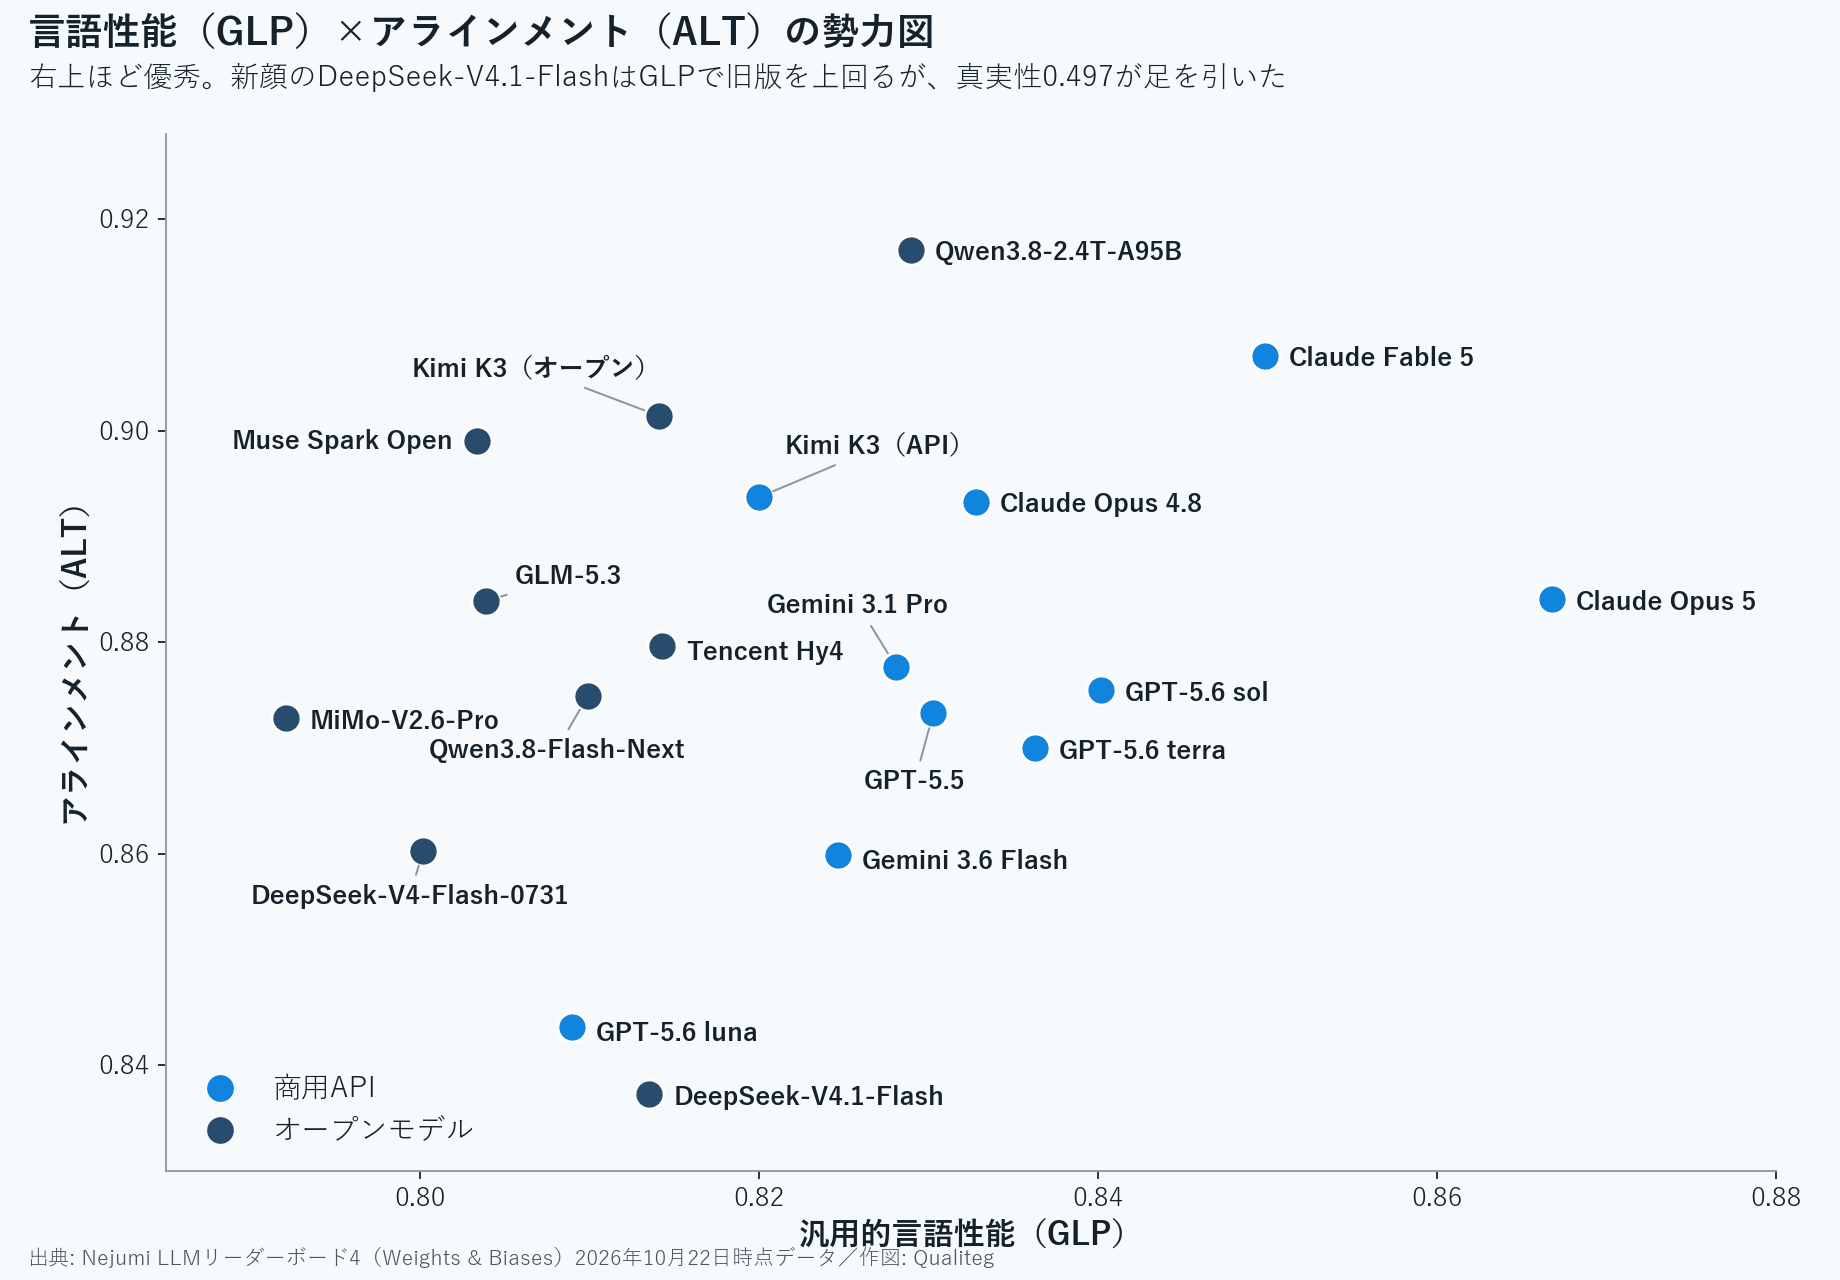
上の散布図は、GLP(言語性能)とALT(アラインメント)の2軸で主要モデルを配置したものです。総合上位モデルはすべて右上、つまり「賢さ」と「安全性・制御性」を両立しています。
今回の教材は、新顔のDeepSeek-V4.1-Flashです。GLPは0.8135で、旧版V4-Flash-0731の0.8002を上回ります。数学的推論0.9683、抽象的推論0.81と、推論系の項目はしっかり伸びました。
ところが真実性が0.497と、TOP50のなかで最も低い値でした(次点はGemini 3 Flash Previewの0.518)。ALTの内訳を旧版と比べると、制御性・倫理・毒性・堅牢性は旧版を上回り、バイアスはわずかな低下(0.870→0.864)にとどまる一方、真実性だけが0.760から0.497へ大きく落ちています。この項目が主因となってALTが0.8603から0.8373へ下がり、総合では0.8158と旧版の0.8169をわずかに下回りました。「新世代なのに旧版を抜けない」という珍しい逆転です。
前回のGemini 3.6 Flash(真実性0.607)に続き、今回も速度・コスト重視クラスのモデルで真実性の低さが目立ちました。2例から一般化はできませんが、高速・低価格モデルを採用する際は、この軸を個別に確認することをおすすめします。
ちなみに前回紹介した「GPT-5.4はhigh設定(0.8397)がxhigh設定(0.8286)を上回る」という逆転現象も、今回のデータでそのまま残っています。
ベンチマーク結果の解釈について
本レポートで紹介するスコアは、あくまでもベンチマークテストにおける評価結果です。ベンチマークは、LLMの性能を客観的に比較する有用なツールですが、以下の点にご注意ください。
- ベンチマークは特定のタスクセットに基づいて評価されるため、そのタスク構成に適したモデルほど高いスコアを獲得する傾向があります
- 実際の業務での使用感や、特定の用途における有用性は、ベンチマークスコアだけでは完全には測れません
- モデルによっては、ベンチマークで測定されていない独自の強みや特徴を持っている場合があります
次は、オープンモデルに限定して実力をみていきましょう。今回動いたのは、ほぼすべてこの部門です。
オープンモデル 総合スコアランキング TOP20
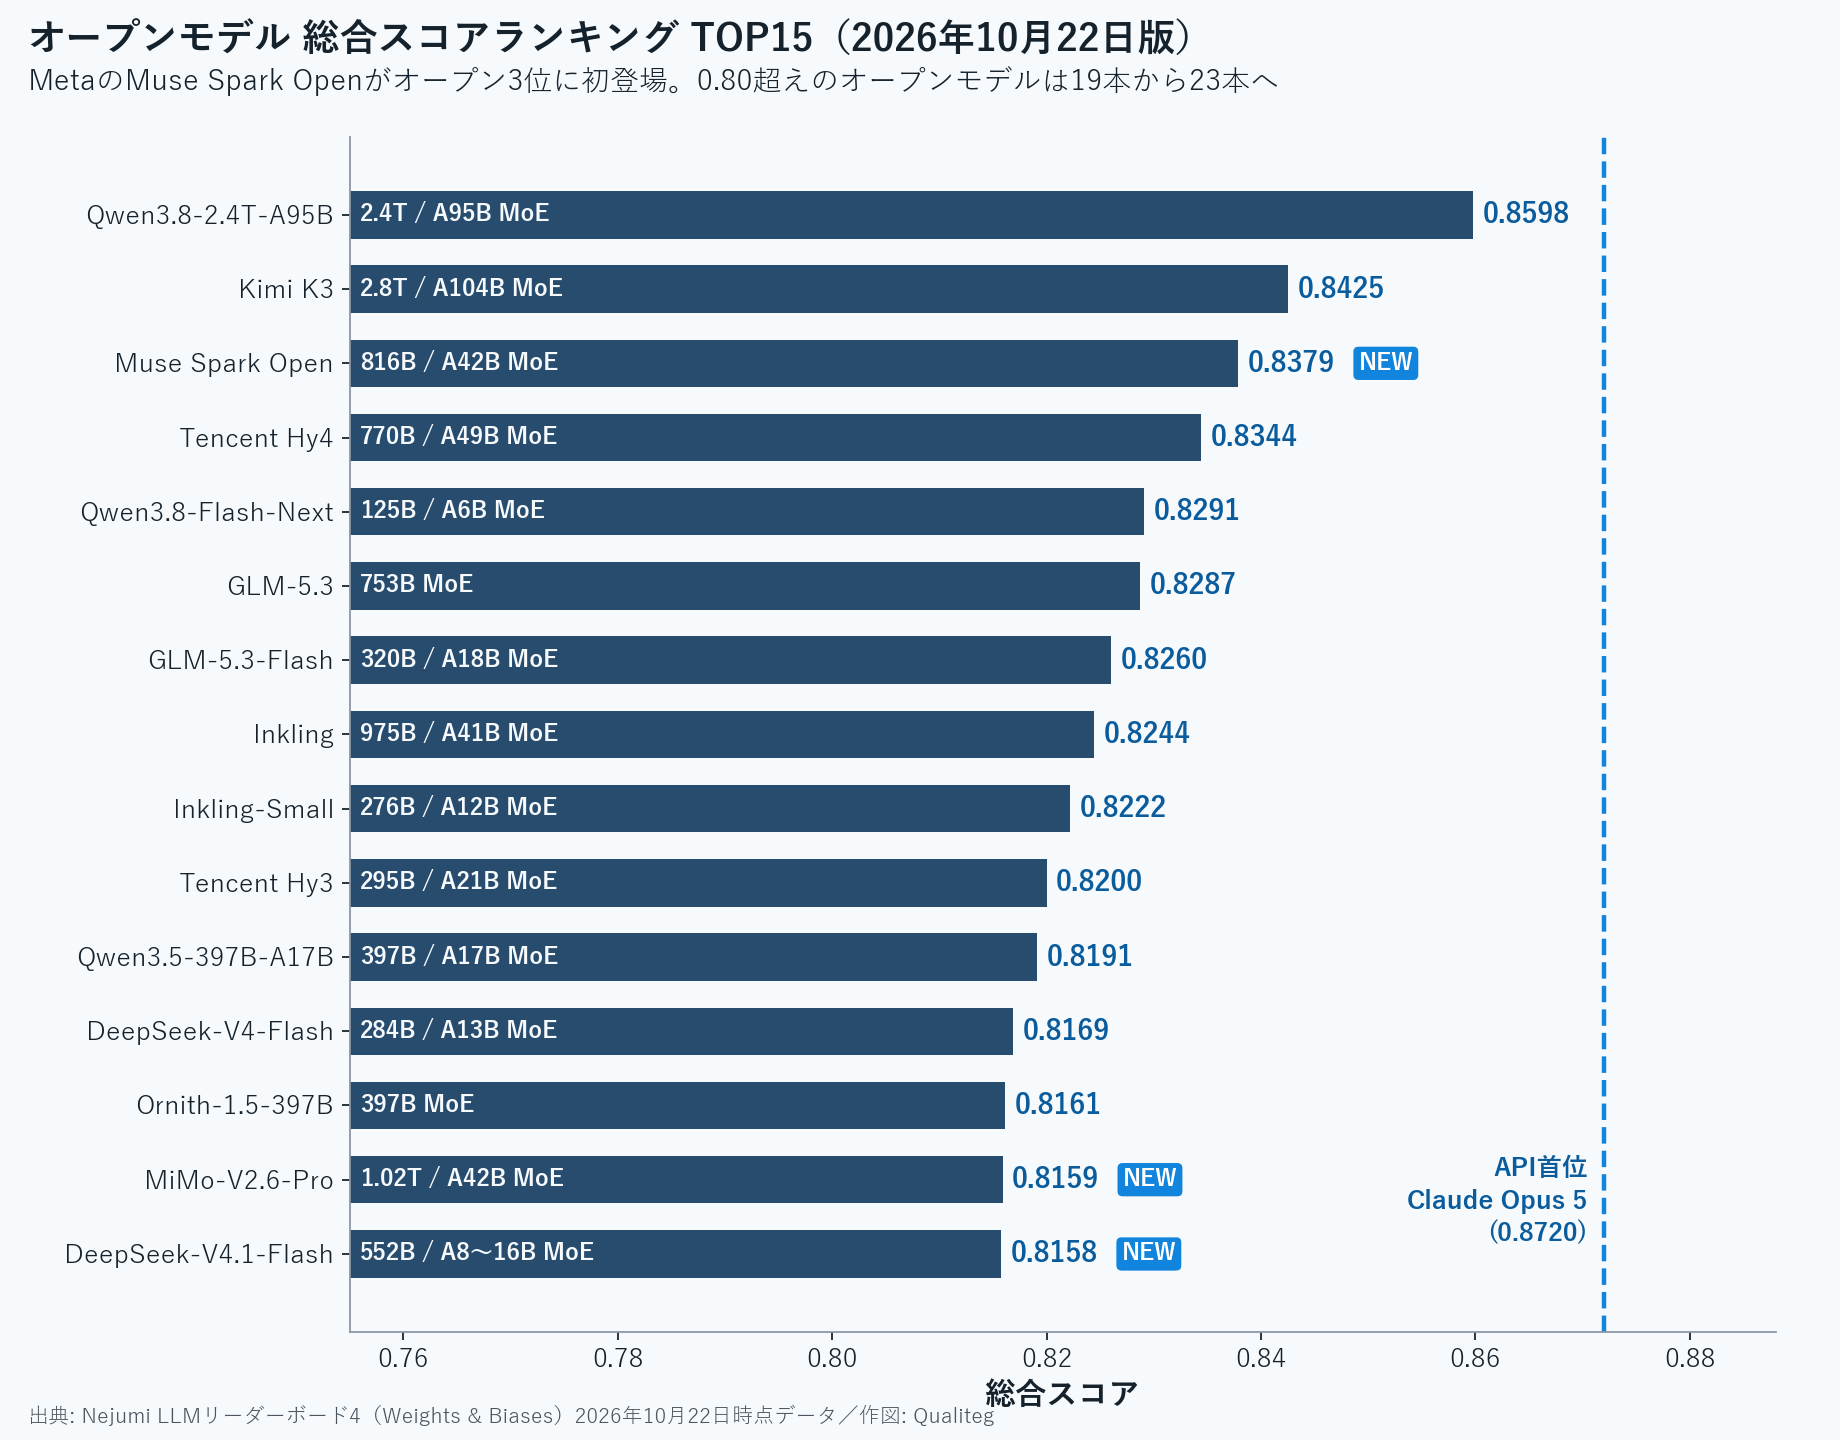
| 順位 | モデル名 | サイズ区分 | 総合スコア |
|---|---|---|---|
| 1 | Qwen/Qwen3.8-2.4T-A95B: reasoning-xhigh | Large (30B+) | 0.8598 |
| 2 | moonshotai/Kimi-K3: reasoning-enabled | Large (30B+) | 0.8425 |
| 3 | meta-models/Muse-Spark-Open-816B-A42B: reasoning-xhigh | Large (30B+) | 0.8379 |
| 4 | tencent/Hy4-preview: reasoning-high | Large (30B+) | 0.8344 |
| 5 | Qwen/Qwen3.8-Flash-Next: reasoning-xhigh | Large (30B+) | 0.8291 |
| 6 | zai-org/GLM-5.3: reasoning-max | Large (30B+) | 0.8287 |
| 7 | zai-org/GLM-5.3-Flash: reasoning-max | Large (30B+) | 0.8260 |
| 8 | thinkingmachines/Inkling: reasoning-max | Large (30B+) | 0.8244 |
| 9 | thinkingmachines/Inkling-Small: reasoning-max | Large (30B+) | 0.8222 |
| 10 | tencent/Hy3: reasoning-high | Large (30B+) | 0.8200 |
| 11 | Qwen/Qwen3.5-397B-A17B: reasoning-enabled | Large (30B+) | 0.8191 |
| 12 | deepseek-ai/DeepSeek-V4-Flash-0731: reasoning-max | Large (30B+) | 0.8169 |
| 13 | ornith-ai/Ornith-1.5-397B: reasoning-enabled | Large (30B+) | 0.8161 |
| 14 | XiaomiMiMo/MiMo-V2.6-Pro-MOPD: reasoning-enabled | Large (30B+) | 0.8159 |
| 15 | deepseek-ai/DeepSeek-V4.1-Flash: reasoning-effort-100 | Large (30B+) | 0.8158 |
| 16 | zai-org/GLM-5.2: reasoning-max | Large (30B+) | 0.8156 |
| 17 | Qwen/Qwen3.5-122B-A10B: reasoning-enabled | Large (30B+) | 0.8094 |
| 18 | Qwen/Qwen3.8-27B: reasoning-xhigh | Medium (10B-30B) | 0.8091 |
| 19 | deepseek-ai/DeepSeek-V4-Flash-Vision-Exp: reasoning-max | Large (30B+) | 0.8077 |
| 20 | google/gemma-4-31b-it | Large (30B+) | 0.8077 |
※順位はモデル単位(同一モデルの複数評価ランはベストスコアのみ採用)です。
オープンモデル総合スコアの傾向と考察
Metaがオープン3位で参戦 Muse Spark Open
今回のオープン部門で最大のニュースは、MetaのMuse Spark Open 816B-A42B(0.8379)の登場です。オープン首位のQwen3.8-2.4T-A95B(0.8598)、2位のKimi K3(0.8425)に次ぐ3位で、Tencent Hy4(0.8344)を抜きました。
Meta Superintelligence Labsが10月15日に公開した総816B・アクティブ42BのMoEで、256エキスパートのうち8つを使う構成、画像入力用のエンコーダも備えます。Metaの説明では、API提供中のMuse Spark 1.3と同じベースモデルをオープンウェイト化したものです。前回紹介した蒸留版のMuse Glimmer 30B(0.7754)に続き、いよいよ本体級が日本語ランキングに乗ってきました。
内訳をみると、数学的推論0.9633と論理的推論0.97が高く、ALT(アラインメント)0.8990はオープン勢でもトップクラスです。一方でコーディング0.7121、関数呼び出し0.5636は上位勢より見劣りし、GLP 0.8034がQwen3.8やKimi K3に届かなかった要因になっています。
ひとつ注意点があります。ライセンスはApache 2.0やMITではなく、Meta独自の「Muse Model License」で、商用利用に条件が付きます。また学習言語は「100以上」とされているものの、日本語は名指しされていません。商用利用の際は条件の確認をおすすめします。
層の厚みという点では、0.80超えのオープンモデルは前回の19本から23本へ増えました。これで0.80超え46モデルのちょうど半数がオープンモデルです。
中国勢の新顔 Xiaomi、DeepSeek、Nex-AGI、inclusionAI
中国発オープンモデルの新顔ラッシュは今回も続いています。
- MiMo-V2.6-Pro(0.8159)/MiMo-V2.6-Flash(0.7600) Xiaomiの新世代。Proは総1.02T・アクティブ42B、Flashは総約310B・アクティブ15BのMoEで、どちらもMITライセンス。今回評価された「MOPD」版は、複数の教師モデルからのオンポリシー蒸留でツール呼び出しの反復を抑えた版だとXiaomiは説明しています(ベンダー説明)
- DeepSeek-V4.1-Flash(0.8158) 9月10日公開の新世代。本体552Bに加えて196Bの「Engram」条件付きメモリを持つ構成で、アクティブ数はprefill時8B・decode時16Bと公表されています(MITライセンス)。10月17日の更新版「1017」(0.7541)も掲載されていますが、評価ラン名に推論設定の表記がなく、推論なし相当の評価とみられます
- DeepSeek-V4-Flash-Vision-Exp(0.8077) V4-Flashに視覚モジュールを加えて継続学習した実験版です。リーダーボードへの掲載は9月1日ですが、API提供は9月10日にV4.1-Flashへ置き換えられ終了しています
- Nex-N2.5シリーズ(Pro 0.7836/Max 0.7711/mini 0.7038) 上海のNex-AGIによるApache 2.0のモデル群。Proは総397B・アクティブ17B(Qwen3.5-397B-A17Bベース)、Maxは総1.6T・アクティブ49B(DeepSeek-V4-Pro-Baseベース)、miniは総35B・アクティブ3B(Qwen3.5-35B-A3Bベース)です。小さいProが大きいMaxを上回る逆転が起きています
- Ling-3.0-flash-VL(0.7767) inclusionAIの総124B・アクティブ5.5B、MITライセンスのマルチモーダル版。テキスト版のLing-3.0-flash(0.7924)をわずかに下回りました
国産オープンモデルの新首位 llm-jp-4.1
日本発では、国立情報学研究所(NII)大規模言語モデル研究開発センターのllm-jp-4.1シリーズが3本同時に登場しました。33B dense版(0.7206)、8B dense版(0.6921)、32B-A3B MoE版(0.6840)で、いずれもApache 2.0、日本語対応を明示するモデルです。
前世代と比べると、llm-jp-4-33b-thinking(0.6760)から33B版は約0.045の上積み、32B-A3B版も0.6679から0.6840へ伸びました。NIIの説明では、4.1は事後学習(SFTとDPO)の改善版です。33B版は東京科学大学SwallowチームのGPT-OSS-Swallow-120B-RL-v0.1(0.6914)を抜き、国産オープンモデルの首位に立ちました。
内訳をみると、33B版の数学的推論0.93と翻訳0.9029は健闘しています。一方で毒性は0.5887と上位勢(0.78〜0.85)を大きく下回り、抽象的推論も0.14と極端に低い値でした。GLPの伸びに対してALT側に課題が残る形で、事実性や安全性が重要な業務で使う場合は、この軸の検証をおすすめします。
近隣の動き 韓国UpstageのSolar Pro 4
近隣では、韓国Upstageの商用APIモデルSolar Pro 4(0.7960)が今回唯一のAPI新顔として登場しました。パラメータ数は非公開ですが、公式ドキュメントで英語・韓国語・日本語を入出力の対応言語に明記しています。推論設定なしの評価ラン(0.7207)との差が大きく、推論を有効にして使う前提のモデルといえます。
前回紹介したSK TelecomのA.X-K2(0.7041)、LG AIのK-EXAONE-236B-A23B(0.7186)と合わせ、日本語を正式にカバーする韓国発モデルの選択肢が広がっています。
さて、次は中規模10B~30B程度のモデルをみてみましょう。中規模モデルのうれしいところは、個人レベルでも比較的入手しやすいGPUでも実行できるところではないでしょうか。
中規模モデル(10B-30B)総合スコアランキング
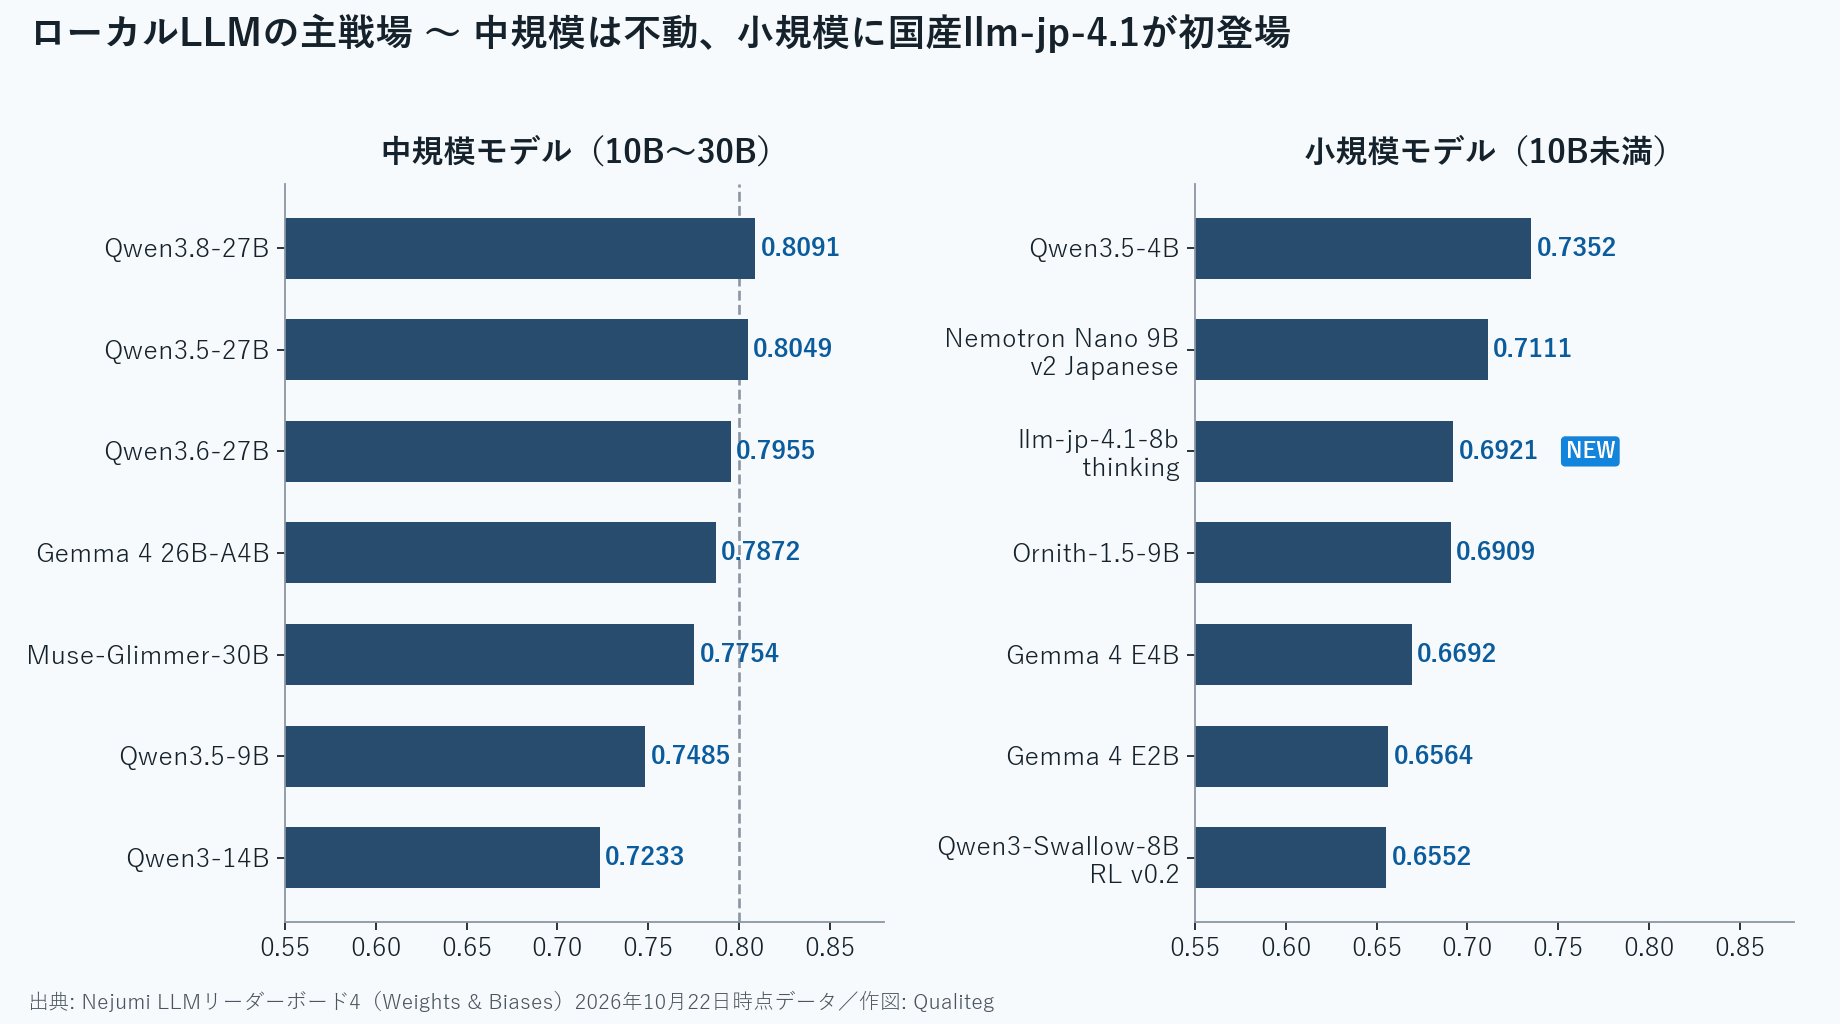
| 順位 | モデル名 | 総合スコア |
|---|---|---|
| 1 | Qwen/Qwen3.8-27B: reasoning-xhigh | 0.8091 |
| 2 | Qwen/Qwen3.5-27B: reasoning-enabled | 0.8049 |
| 3 | Qwen/Qwen3.6-27B: reasoning-enabled | 0.7955 |
| 4 | google/gemma-4-26B-A4B-it | 0.7872 |
| 5 | meta-models/Muse-Glimmer-30B: reasoning-xhigh | 0.7754 |
| 6 | Qwen/Qwen3.5-9B: reasoning-enabled | 0.7485 |
| 7 | Qwen/Qwen3-14B: reasoning-enabled | 0.7233 |
※リーダーボード掲載中の評価ランに基づくため、前回掲載モデルの一部はアーカイブ化により今回の集計対象外です。中規模・小規模の区分(Qwen3.5-9BがMedium扱いである点など)もリーダーボードのサイズ区分に従っています。
中規模モデル総合スコアの傾向と考察
中規模カテゴリは、この7週間で新顔がなく、7本すべてが前回と同じ順位でした。
首位は引き続きQwen3.8-27B(0.8091)です。27Bのdenseモデルで、画像・動画入力にも対応するマルチモーダル構成。Apache 2.0で公開されています。2位のQwen3.5-27B(0.8049)と合わせ、「30B級ローカルLLMの本命」はQwenの2本という構図に変わりはありません。
量子化を併用すれば単一GPU構成も視野に入るサイズで総合0.80超えという水準は、同じリーダーボード上で2025年8月公開のGPT-5(high設定、0.7970)を上回ります(必要VRAMは精度やコンテキスト長で変わります)。オンプレ・機密データ用途の現実解として、引き続き有力な選択肢です。
4位のGemma 4 26B-A4B(0.7872)、5位のMuse-Glimmer-30B(0.7754)も健在です。次回以降、llm-jp-4.1の32B-A3B版がこのカテゴリでどう扱われるかにも注目したいところです(今回はリーダーボードの区分上「Large」扱いです)。
さて、最後に小規模モデルもみてみましょう。こうした小型モデルは比較的安価なコンシューマ向けGPUでも動作しますので、エッジ・オンプレ用途の本命です。
小規模モデル(10B未満)総合スコアランキング
| 順位 | モデル名 | 総合スコア |
|---|---|---|
| 1 | Qwen/Qwen3.5-4B: reasoning-enabled | 0.7352 |
| 2 | nvidia/NVIDIA-Nemotron-Nano-9B-v2-Japanese: reasoning-enabled | 0.7111 |
| 3 | llm-jp/llm-jp-4.1-8b-thinking: reasoning-high | 0.6921 |
| 4 | ornith-ai/Ornith-1.5-9B: reasoning-enabled | 0.6909 |
| 5 | google/gemma-4-E4B-it | 0.6692 |
| 6 | google/gemma-4-E2B-it | 0.6564 |
| 7 | tokyotech-llm/Qwen3-Swallow-8B-RL-v0.2: reasoning-enabled | 0.6552 |
小規模モデル総合スコアの傾向と考察
小規模モデルは前回に引き続きQwen3.5-4B(0.7352)が首位です。わずか4Bで0.73超えという水準は、同じリーダーボード上で2025年7月公開のQwen3-30B-A3B-Thinking-2507(0.7331)を上回るもので、小型化の進展を象徴しています。
2位のNVIDIA Nemotron Nano 9B v2 Japanese(0.7111)も引き続き健在です。日本語向けに追加学習された小規模モデルとして、有力な選択肢のひとつでしょう。
今回の新顔は3位のllm-jp-4.1-8b-thinking(0.6921)です。オープンの章で紹介したllm-jp-4.1シリーズの8B dense版で、Apache 2.0。日本語対応を明示する国産の小規模モデルとして、Ornith-1.5-9B(0.6909)をわずかに上回って入ってきました。数学的推論0.925は小規模としては目を引く一方、SWE-Bench系評価0.0625、毒性0.5515は大きな弱点です。
Gemma 4のオンデバイス版E4B(0.6692)とE2B(0.6564)、東京科学大学SwallowチームのQwen3-Swallow-8B-RL-v0.2(0.6552)も、引き続き小規模の定番として並んでいます。
まとめ、本格導入に向けての道しるべ
今回はEpoch AI・Arena・Nejumi Leaderboard 4の3つのデータを分析いたしました。今回の分析でみえたポイントをまとめます。
フロンティアは動き、日本語ランキングはその手前で止まっている
今回の最大のポイントは2つあります。フロンティアではClaude Opus 5.5とGPT-6 Astraが総合能力で並び、Claude Fable 5.1がArena日本語カテゴリの首位に立ったこと、そして日本語実測のNejumiではこれらが未評価のまま、首位Claude Opus 5をはじめTOP13が前回から不動だったことです。
Nejumiの中で動いたのはオープン勢で、新顔14モデルのうち13本がオープンモデル、0.80超えのオープンモデルは23本に達し、46モデルの半数を占めました。前回「オープン0.85時代の幕開け」とお伝えした流れは、裾野が広がる形で続いています。
- 商用API勢 総合能力ではAnthropic(Opus 5.5/Fable 5.1/Sonnet 5.5)とOpenAI(GPT-6 Astra/GPT-6.1 Sol)が同じ集団を形成し、Google(Gemini 4 Argon)とMeta(Muse Wonder)が加わった。Nejumiでの日本語評価はこれから
- オープン勢 Nejumiでは Qwen3.8とKimi K3の2強に、MetaのMuse Spark Openが3位で割って入る。Xiaomi・DeepSeek・Nex-AGIなど中国勢の新顔も途切れず
- 国産勢 llm-jp-4.1が3本登場し、33B版が国産オープンの首位に。Swallow RL版、Nemotron日本語版と、日本語特化の選択肢は着実に拡大
モデルサイズ別の特徴
| カテゴリ | 候補モデル | 特徴 |
|---|---|---|
| 最高性能を追求(商用API) | Claude Opus 5.5 / GPT-6 Astra / Claude Fable 5.1 | 総合能力(ECI)で首位級。日本語の Nejumi では未評価なので、日本語業務では Nejumi 首位の Claude Opus 5 も併せて検証を |
| コスト効率と性能の両立(商用API) | Claude Sonnet 5.5 / Claude Haiku 5.5 / Gemini 3.8 Flash | ECI で Sonnet 5.5 は Opus 5 を上回り、Haiku 5.5 は前世代旗艦の Opus 4.8 と同等。大量処理・日常業務向け(Nejumi 未評価) |
| オープンモデル最高峰 | Qwen3.8-2.4T-A95B / Kimi K3 | Nejumi で総合 0.84〜0.86 と API 上位と同水準。自社インフラで運用可能(ライセンスは独自条件を要確認) |
| 単一GPUクラスのローカル運用 | Qwen3.8-27B / Qwen3.5-27B | 27B級で総合0.80超え。量子化併用で単一GPU運用も視野。オンプレ・機密データ用途の現実解 |
| 小規模・エッジ | Qwen3.5-4B / Gemma 4 E4B | Qwen3.5-4Bは4Bで総合0.73超え。Gemma 4 E4B(0.6692)も含め、端末内・低リソース環境で検討できる候補 |
| 日本語特化 | NVIDIA Nemotron Nano 9B v2 Japanese / llm-jp-4.1-33b-thinking | 日本語データで学習された特化モデル。国内運用・日本語業務向け。llm-jp-4.1は国産オープンの新首位 |
LLMの本格導入にむけて 用途別の最適なモデル選択
今回は総合スコアを軸に各モデルの位置づけを見てきましたが、実際の導入判断はそれほど単純ではありません。
ベンチマークは有力な参考情報である一方、実務では精度だけでなく、推論コスト、応答速度、機密データの扱い、既存システムとの統合性など、多面的な評価が必要です。とくに今回のように選択肢が広がり続ける状況では、「最もスコアの高いモデルを一つ選ぶ」というより、「用途ごとに複数のモデルを適切に使い分けられる状態をどう作るか」が、導入の現場ではより重要になります。
当社では、こうした複数モデル運用の実務に対応する選択肢として、複数のLLMを1つのプラットフォームで利用できる統合AIプラットフォーム Bestllam を提供しています。モデルの選定から、業務フローへの組み込み、AIエージェント活用を前提とした運用設計まで含めてご支援可能です。
また、単なるツール提供にとどまらず、貴社業務のAI化を見据えたBPRコンサルティングもあわせてご提供しており、業務分析からBPR計画策定、成功指標の設計、導入支援まで伴走いたします。
まずはお気軽にご相談くださいませ
https://qualiteg.com/contact?inquiry=consulting