Claude Opus 5.5 完全ガイド モデル仕様とAPI・Claude Code運用ポイント
Claude Opus 5.5の完全ガイド。Opus 5より20%安い料金とキャッシュ読み取り60%引き、effort既定mediumやthinking無効化不可などAPI移行の注意点、Claude Codeの既定モデル変更とFast modeまで解説。
こんにちは!
2026年9月22日(米国時間)、AnthropicからClaude Opus 5.5が発表されました。新しいClaude 5.5ファミリーの最初のモデルです。同じ日には、OpenAIもGPT-6 SolとGPT-6 Lunaを発表しています。
まず、このモデルについて一言でいうと、
「Opus 5.5は、Fable 5.1級を狙う性能を、Opus 5より安い単価と既定mediumで出してきた。代わりに、thinkingを切る・ツールを強制する・履歴を書き換える、という古い書き方が通らなくなった」。
です。
さて、まずは値下げされたAPI料金からみてみましょう。同じ日に出たGPT-6 Sol・Lunaは、性能は据え置きで単価を半額にする、という形でした。Opus 5.5の値下げ幅は20%(キャッシュ読み取りは60%)で、Sol・Lunaほど大きくはありません。その代わり、性能向上と値下げの両立です。ここが今回の2026年9月アップデートの特徴です。
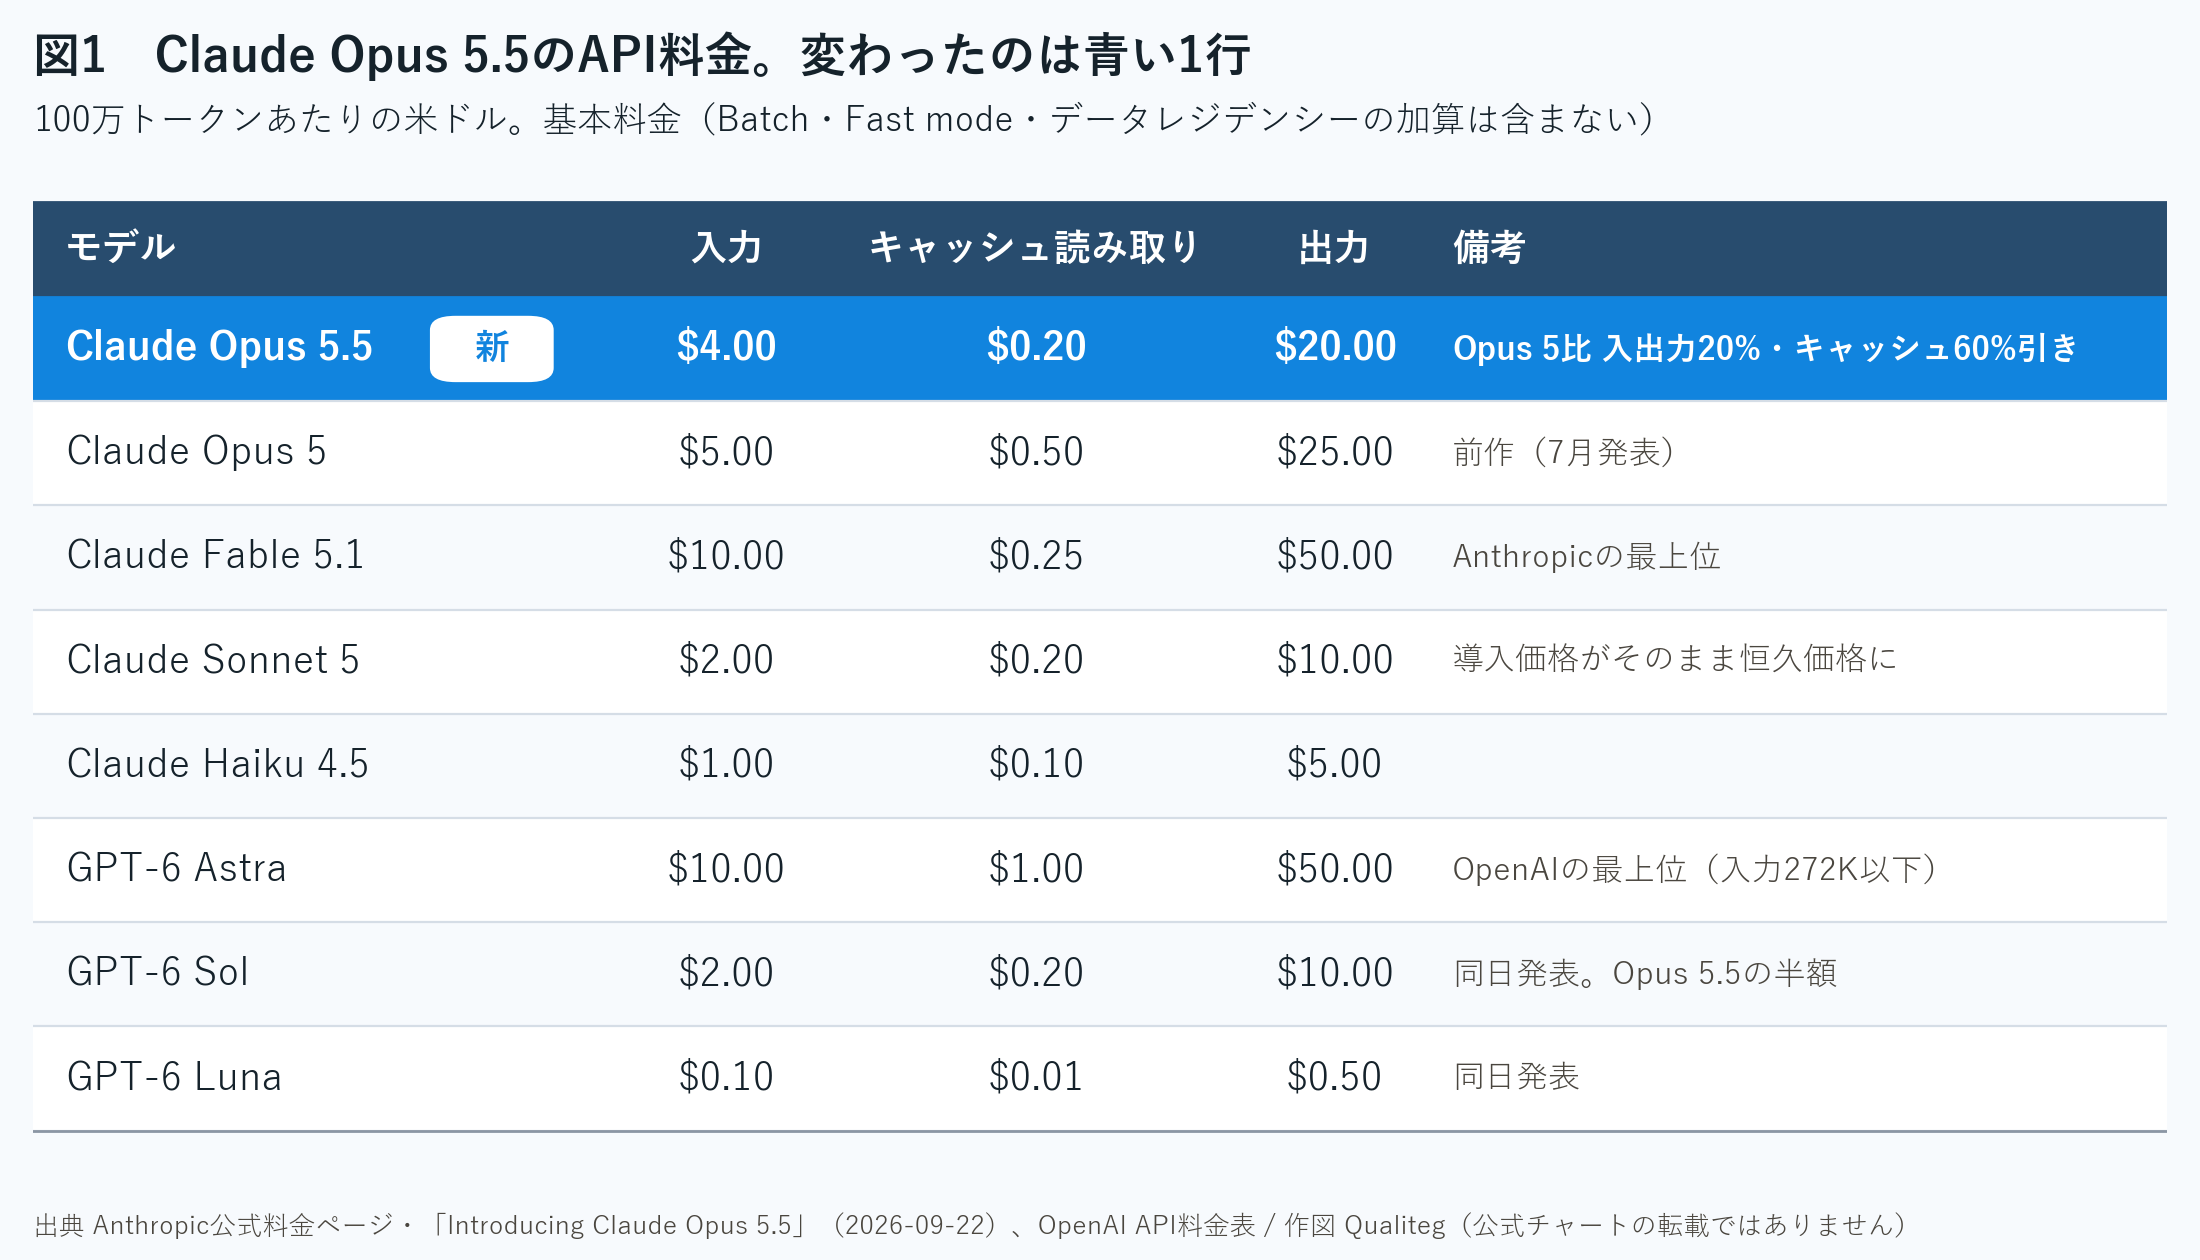
Opus 5.5は入力$4・出力$20で、Opus 5の$5・$25から20%下がりました。キャッシュ読み取りは$0.50から$0.20へ、60%の値下げです。
設定の面では、APIのeffort(考える量の設定)の既定がhighからmediumに下がり、thinking(思考)はどのeffortでも切れなくなりました。Opus 5のコードをモデルIDの差し替えだけで動かすと、エラーになる箇所があります。
当ブログでは7月の「Claude Opus 5.0 完全ガイド」で、Opus 5を「最上位ではないが実務の本命」と書きました。この記事はその続編です。
同日発表のGPT-6については、前回の記事「GPT-6 Sol・Luna 完全解説」で扱いました。この記事では、Opus 5.5とSolの比べ方も整理します。
根拠は、Anthropicの公式発表・公式ドキュメント・システムカードと、独立評価機関のArtificial Analysisです。Anthropicの公表値(ベンダー主張)と独立評価は分けて書きます。当社ではまだOpus 5.5を手元で体系的に検証していません。
長編なので、頭から通読する必要はありません。気になる章だけ拾い読みしてください。
目次
第1部 Claude Opus 5.5とは何か
- 1. Opus 5.5はClaude 5.5ファミリーの最初のモデル
- 2. 基本仕様の早見表
- 3. 料金はOpus 5から20%下がり、キャッシュ読み取りは60%下がった
- 4. Anthropicの公表ベンチマークは費用と一緒に読む
- 5. 独立評価ではIntelligence Indexの首位になった
- 6. 同日発表のGPT-6 Sol・Lunaとの比べ方
- 7. システムカードで見る安全性
第2部 APIで使うときの注意点
- 8. thinkingはもう切れない
- 9. effortの既定がmediumになった
- 10. forced tool useと旧computer useツールは400になる
- 11. preserved thinkingは8月31日以降に作ったアカウントに効く
- 12. 安全分類器は生物が広がり、推論抽出が加わった
- 13. 移行の手順と費用試算の更新
第3部 Claude Codeで使うOpus 5.5
- 14. v2.1.280で既定モデルがOpus 5.5になった
- 15. effortはモデルごとの設定で決める
- 16. Fast modeは$8/$40、支払いはusage creditsから
- 17. 分類器でモデルが切り替わるときの挙動
- 18. 1Mコンテキスト・5時間枠・日常運用のリズム
Opus 5からのアップデート、ざっくり
詳しくは各章で扱いますが、まず全体像です。
- 単価が20%下がり、キャッシュ読み取りは60%下がった。入力$4・出力$20、キャッシュ読み取り$0.20です。公式は「既定の設定で典型的なワークロードなら40%安い」としています(第3章)
- Fable 5.1級の性能を半額以下で出す、という主張。公式の言葉は「ほとんどの仕事でFable 5.1と同じ水準」です。独立評価のIntelligence Indexでも首位でした(第4章・第5章)
- thinkingを無効化できなくなった。Opus 5ではeffortがhigh以下なら切れましたが、Opus 5.5では全effortで400エラーです(第8章)
- effortの既定がmediumになった。effortを省くと、Opus 5より1段低い設定で動きます(第9章)
- forced tool useと旧computer useツールが400になった。tool_choiceのanyとtool、computer_20251124が使えません(第10章)
- preserved thinkingが入った。2026年8月31日以降に作ったアカウントでは、thinkingブロックより前の履歴を書き換えて送ると400です(第11章)
- 安全分類器が広がった。生物の分類器がFable 5.1と同じ広い範囲になり、推論抽出の分類器が加わりました(第12章)
- Claude Codeの既定モデルが、ProとTeam StandardでもOpusになった。v2.1.280以降で、ほぼすべてのプランの既定がOpus 5.5です(第14章)
- 5時間枠の引き上げと「上限リセット」。サブスクリプションの利用者向けです。引き上げ幅の数値は公式に出ていません(第18章)
- Sonnet 5.5とHaiku 5.5は数週間以内。公式発表の予告で、価格と仕様はまだ出ていません(第1章)
第1部 Claude Opus 5.5とは何か
1. Opus 5.5はClaude 5.5ファミリーの最初のモデル
公式発表の一文目はこうです。
「ほとんどの仕事でClaude Fable 5.1と同じ水準の性能を、Opus 5より40%安い運用コストで」。
モデルページでの説明は「長時間のエージェント型コーディングと知識労働向け」です。Fable 5.1は「要求の厳しい推論と長期のエージェント作業向け」とされていて、公式は使い分けをこう案内しています。
まずOpus 5.5から始める。Opus 5.5の高いeffortでも評価が届かないときに、Fable 5.1へ上げる。
| モデル | 位置づけ | API単価(入力/出力) | 情報の確度 |
|---|---|---|---|
| Claude Fable 5.1 | 要求の厳しい推論と長期のエージェント作業 | $10/$50 | 公式ドキュメント・料金ページ |
| Claude Opus 5.5 | 長時間のエージェント型コーディングと知識労働 | $4/$20 | 公式ドキュメント・料金ページ |
| Claude Opus 5 | 前作。引き続き提供 | $5/$25 | 公式ドキュメント・料金ページ |
| Claude Sonnet 5 | 速度と知能のバランス | $2/$10 | 公式ドキュメント・料金ページ |
| Claude Sonnet 5.5・Haiku 5.5 | 数週間以内に提供 | 未公表 | 公式発表 |
前作の記事では、Opus 5を「Fable 5の半額で迫るモデル」と紹介しました。今回はFable 5.1の4割の単価で、同じ水準を出すという主張です。
公式が挙げる改善点は5つです。性能がOpus 5から大きく上がったこと。自動行動監査で過去最高のスコアになったこと。40%安く、出力の生成が30%以上速いこと。文章が明快になり要点を先に書くようになったこと。そして5時間枠の引き上げと上限リセットです。
もうひとつ、発表の文脈にも触れておきます。
Opus 5.5は、Anthropicが「フロンティアのペースを落とす(pacing the frontier)」と呼びかけてから最初のリリースです。発表前にはFrontier DesignとMETRの外部評価者がテストしています。
公式発表には、正直な注意書きもあります。
「この能力水準では、ベンチマークの差は実際の差の目安になりにくい。自社で使っている限り、Opus 5.5とFable 5.1の差はスコアが示すより小さい」。
ベンチマークの読み方は第4章で扱いますが、ベンダー自身がこう書いている点は覚えておいてください。
2. 基本仕様の早見表
| 項目 | Claude Opus 5.5 | Claude Opus 5(前作) | 情報の確度 |
|---|---|---|---|
| モデルID | claude-opus-5-5 | claude-opus-5 | 公式ドキュメント |
| Amazon BedrockのID | anthropic.claude-opus-5-5 | anthropic.claude-opus-5 | 公式ドキュメント |
| コンテキスト | 1M | 1M | 公式ドキュメント |
| 最大出力 | 128K(Batch APIはベータで300K) | 128K | 公式ドキュメント |
| 知識の基準日 | 2026年6月 | 2026年5月 | 公式ドキュメント・前作記事 |
| thinking | 常時オン。無効化できない | 既定オン。high以下なら無効化できた | 公式ドキュメント |
| effortの既定 | medium | high | 公式ドキュメント |
| 入出力 | テキスト・画像からテキスト | 同じ | 公式ドキュメント |
| トークナイザ | Opus 5と同じ | Opus 4.7で導入されたもの | 公式ドキュメント |
| キャッシュの最小長 | 512トークン | 512トークン | 公式ドキュメント |
| 提供終了 | 2027年9月22日より前にはしない | 日付は未確認 | 公式ドキュメント |
| ゼロデータ保持(ZDR) | 利用可 | 利用可 | 公式発表 |
| Priority Tier | 非対応 | 非対応 | 公式ドキュメント(Service tiers) |
提供先はClaude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud(Vertex AI)、Microsoft Foundryです。Opus 5も引き続きすべてで使えます。
Priority Tierは、Opus 5・Sonnet 5・Fable 5.1と同じく、Opus 5.5も対象外です。公式のService tiersページによると、Priority Tierの容量コミットメント自体が新規の購入を終えていて、既存の契約分だけが契約終了まで使えます。
コンテキスト長・最大出力・トークナイザはOpus 5と同じなので、トークン数の見積もりはそのまま使えます。Opus 4.6以前から移る場合は、トークナイザの違いで約30%多くトークンを消費する点に注意してください。
知識の基準日は2026年6月で、Fable 5.1と同じです。前作ではOpus 5の基準日の新しさを隠れた強みとして挙げましたが、今回はさらに1か月新しくなりました。
ZDRで使える点は、Fable 5.1との大きな違いです。Fable 5.1は30日のデータ保持が要件なので、ZDR契約のある組織では、Opus 5.5が最上位の選択肢になります。
EU AI Actに対応するウォーターマークは、Fable 5.1と同じく付いています。
公式のモデル一覧にある相対レイテンシの表記は、Opus 5.5がModerate、Fable 5.1がSlower、Sonnet 5がFastです。
3. 料金はOpus 5から20%下がり、キャッシュ読み取りは60%下がった
100万トークンあたりの米ドルで、公式料金ページの値を並べます。書き込みはキャッシュ書き込みの単価です。
| モデル | 入力 | 5分書き込み | 1時間書き込み | キャッシュ読み取り | 出力 | 情報の確度 |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $5 | $8 | $0.20 | $20 | 料金ページ |
| Claude Opus 5 | $5 | $6.25 | $10 | $0.50 | $25 | 料金ページ |
| Claude Fable 5.1 | $10 | $12.50 | $20 | $0.25 | $50 | 料金ページ |
| Claude Sonnet 5 | $2 | $2.50 | $4 | $0.20 | $10 | 料金ページ |
| Claude Haiku 4.5 | $1 | $1.25 | $2 | $0.10 | $5 | 料金ページ |
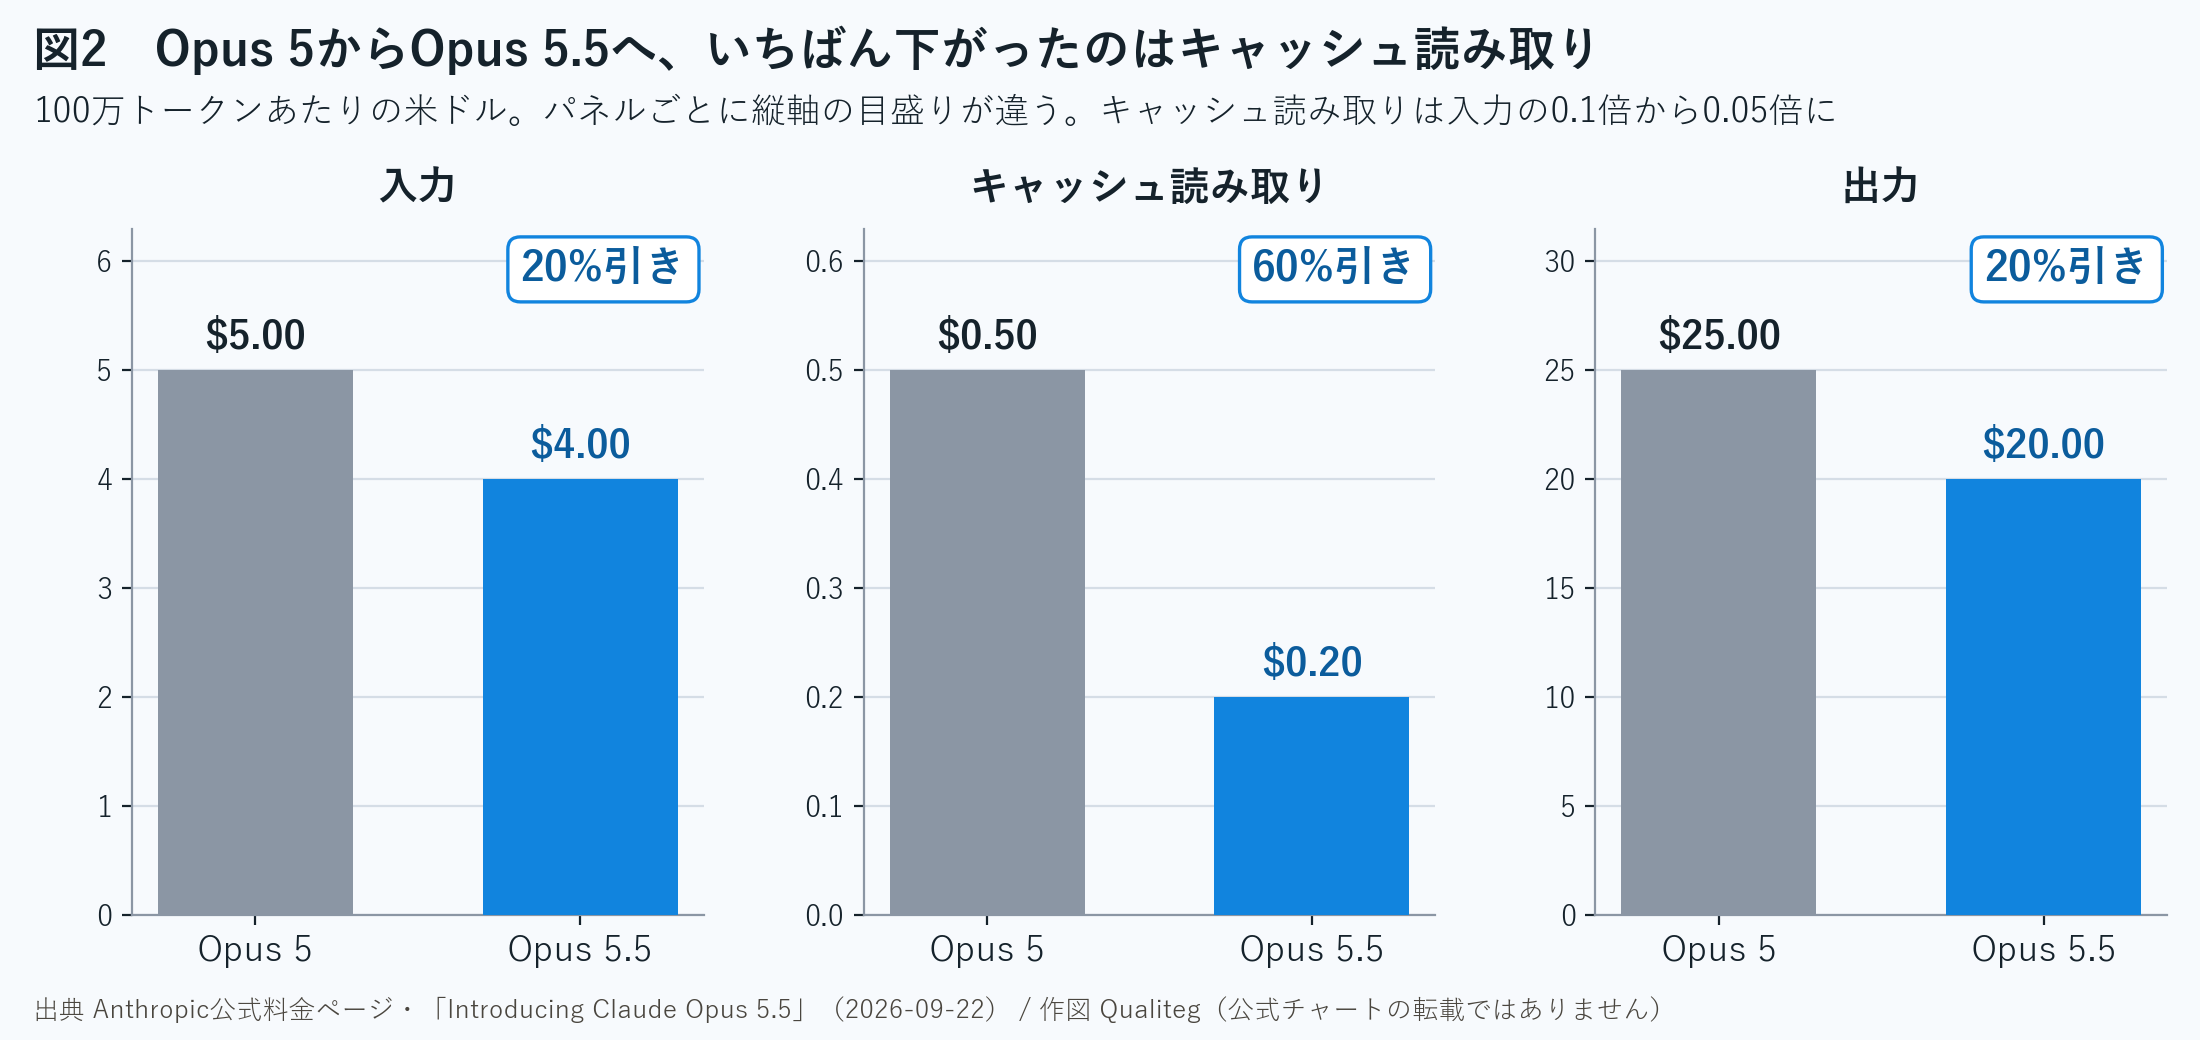
入力・出力・5分キャッシュ書き込みは20%引きです。キャッシュ読み取りは60%引きで、入力単価に対する倍率が0.1倍から0.05倍に下がりました。
公式発表は、キャッシュ読み取りを「エージェント作業とコーディングの費用の大半を占める」と書いています。
エージェント作業では、キャッシュ読み取りの60%引きがいちばん効きます。
同じ指示やツール定義、過去のやり取りを毎ターン読み直すので、キャッシュ読み取りの単価がそのまま請求額に響くからです。
Sonnet 5との関係も変わりました。キャッシュ読み取りはOpus 5.5もSonnet 5も$0.20で同じです。入力と出力は、Opus 5.5がSonnet 5のちょうど2倍になります。
ちなみにSonnet 5の$2・$10は、もともと8月31日までの導入価格でした。料金ページには、予定されていた値上げは行わず恒久価格にする、と注記されています。
その他の単価です。
| 項目 | Claude Opus 5.5 | Claude Opus 5 | 情報の確度 |
|---|---|---|---|
| Batch API(入力/出力) | $2/$10 | $2.50/$12.50 | 料金ページ |
| Fast mode(入力/出力) | $8/$40 | $10/$50 | 料金ページ・公式発表 |
| 1Mコンテキストの割増 | なし(全域が標準料金) | なし | 料金ページ |
| データレジデンシー(inference_geo "us") | 1.1倍 | 1.1倍 | 料金ページ |
| ツール利用時のシステムプロンプト加算(tool_choiceがautoかnone) | 286トークン | 286トークン(anyとtoolは406) | 料金ページ |
公式の「40%安い」は、単価の20%引きだけの話ではありません。タスクあたりのトークン消費が減った分を足して、既定の設定の典型的なワークロードで40%減、というAnthropicの自社テストの結果です。
トークン消費の減り方は使い方で変わるので、40%はベンダー主張として受け取ってください。単価だけで計算した試算は第13章に置きました。
4. Anthropicの公表ベンチマークは費用と一緒に読む
ここからの数字は、すべてAnthropicが公表したものです。
測定条件に特徴があります。特記がなければOpus 5.5はadaptive thinkingのmax effortで、5回の平均です。そして本番のセーフガードを有効にしたまま測っています。
セーフガードが介入したタスクは、サイバーならOpus 4.8、生物とフロンティアLLM開発ならOpus 5が代わりに解いています。公式は「Opus 5.5のスコアを下げている可能性が高い」と注記しています。
| 評価 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | 情報の確度 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | Anthropic公表値 |
| FrontierCode v1.1(Main) | 54.4% | 50.3% | 48.0% | 53.3% | Anthropic公表値 |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | 記載なし | Anthropic公表値 |
| GDPval-AA v2.1(Elo) | 1846 | 1735 | 1708 | 1542 | Anthropic公表値 |
| AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | Anthropic公表値(Zapierが実行) |
| Humanity's Last Exam(ツールあり) | 67.7% | 65.6% | 63.6% | 57.2% | Anthropic公表値 |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | Anthropic公表値 |
| OSWorld 2.0(partial) | 81.8% | 80.7% | 74.0% | 記載なし | Anthropic公表値 |
| Chartography(ツールあり) | 89.0% | 88.4% | 83.4% | 記載なし | Anthropic公表値 |
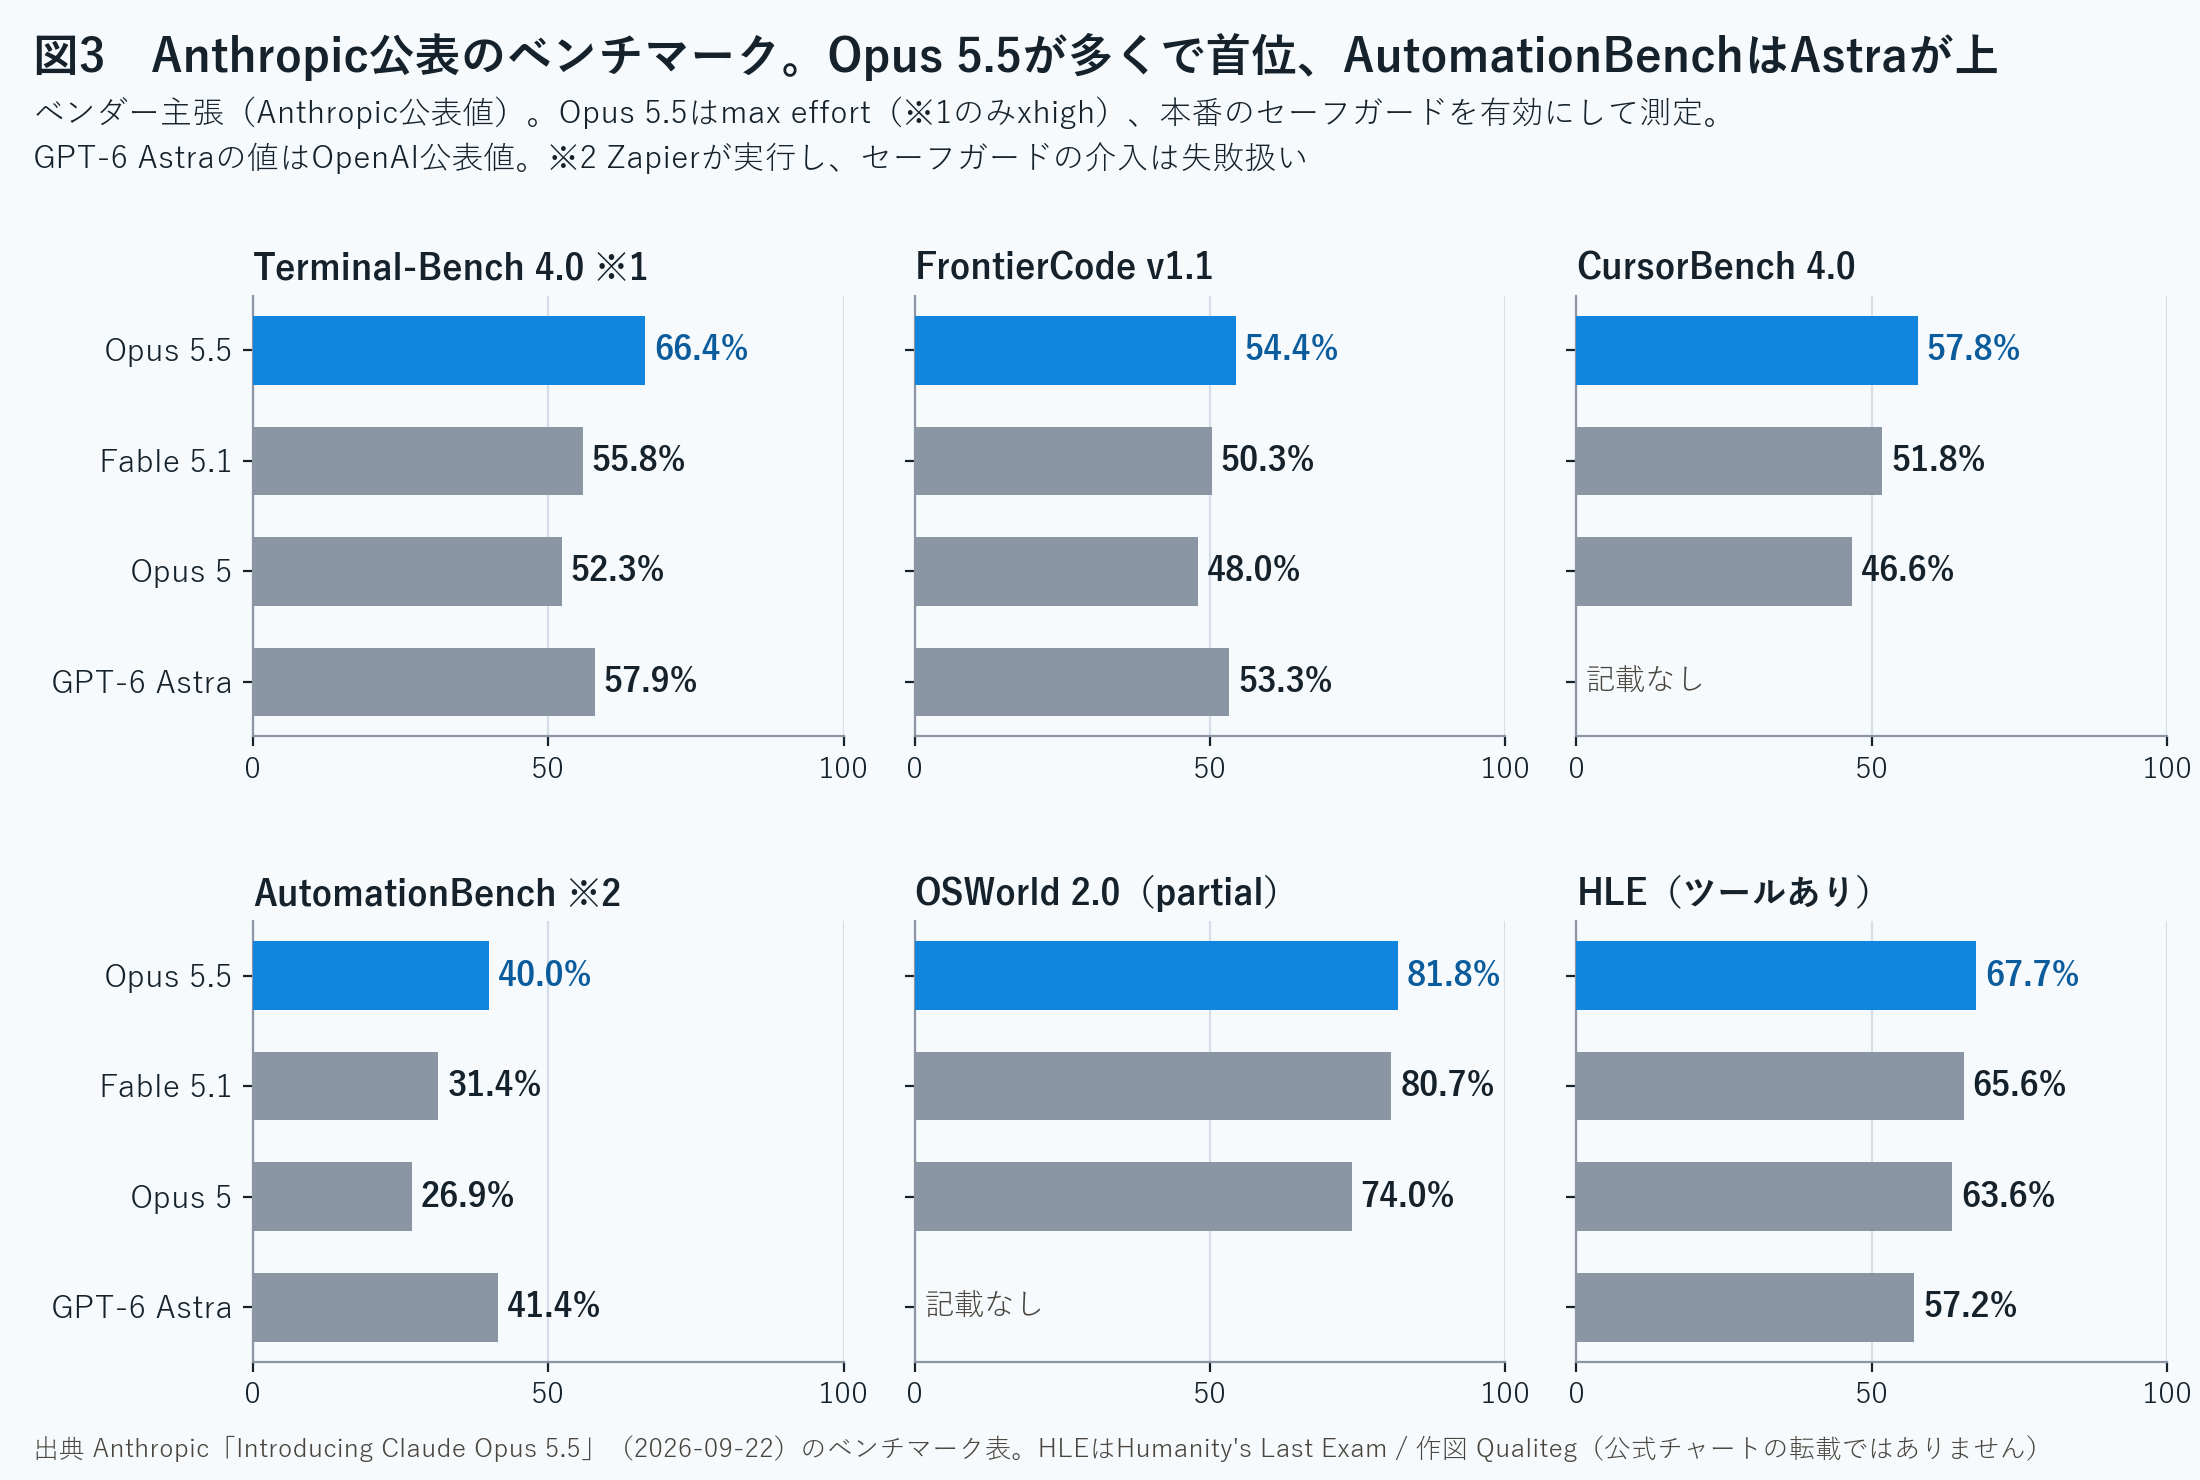
GPT-6 Astraの値はOpenAIの公表値を載せたものです。Terminal-Bench 4.0だけはOpus 5.5がxhigh、Astraがhighの値で、それぞれの最高値とされています(Opus 5.5のmaxは64.8%で誤差の範囲)。
Anthropic自身の表でも、AutomationBenchとTerminal-Bench-ScienceではGPT-6 Astraが上です。AutomationBenchはZapierがフォールバックなしで実行したので、セーフガードの介入は失敗として数えられています。
システムカードの評価表には、発表に無い値も載っています。
| 評価 | Opus 5.5 | Opus 5 | Fable 5.1 | 情報の確度 |
|---|---|---|---|---|
| SWE-bench Pro | 89.9% | 79.2% | 81.2% | システムカード |
| SWE-bench Multilingual | 93.9% | 89.5% | 89.1% | システムカード |
| Humanity's Last Exam(ツールなし) | 64.4% | 56.6% | 60.9% | システムカード |
| OSWorld 2.0(strict) | 48.7% | 37.2% | 42.8% | システムカード |
FrontierCodeには、読むときの注意がひとつあります。
システムカードによると、Cognitionが実行した値では、Opus 5.5の最高点はmediumの54.6%でした。mediumより上では点が下がり、maxで54.4%に戻ります。頼まれた範囲の外を変更すると減点する採点なので、考えすぎると手を広げて点を落とす、と読めます。
今回の発表でいちばん強く押し出されているのは、点数そのものより費用です。公式発表の主張を並べます(いずれもベンダー主張)。
| 評価 | 公式発表の主張 | 情報の確度 |
|---|---|---|
| FrontierCode | 既定effortのOpus 5.5が、GPT-6 Astraを約20%の費用で上回る | Anthropic公表値 |
| Terminal-Bench 4.0 | Astraと同等を約40%の費用で。既定effortでOpus 5のmaxを約5分の1の費用で上回る | Anthropic公表値 |
| CursorBench | GPT-5.6 Solを11ポイント上回り、費用は約3分の1 | Anthropic公表値 |
| GDPval-AA | 既定effort(medium)がAstraのmaxを約5分の1の費用で上回る | Anthropic公表値 |
事例も費用の話が中心です。HAProxyをCからRustに移植するテストでは、Opus 5.5が9.5時間、Fable 5.1が12時間で、費用は51%少なかったとされます。企業の決算レポートを書かせるテストでは、Opus 5.5は18回中16回が品質基準を通り、Fable 5.1とOpus 5は1回も通らなかったそうです。
発表に掲載された顧客のコメントにも、同じ傾向が出ています。
Factoryは「mediumを既定にできる最初のモデル。Opus 5のhighと同等で、出力トークンは20〜25%少ない」。Deloitteは「最低effortでもコードレビューで既知のバグの72%を見つけた(Opus 5のhighは56%)」と書いています。
ここに並ぶのはAnthropicが選んだ事例です。自分の用途で同じ差が出るかは、第9章のとおり自分の評価で測り直すことになります。
5. 独立評価ではIntelligence Indexの首位になった
独立評価機関のArtificial Analysisは、発表当日に評価結果を公開しました。見出しは「Claude Opus 5.5がIntelligence Indexで首位に」です。
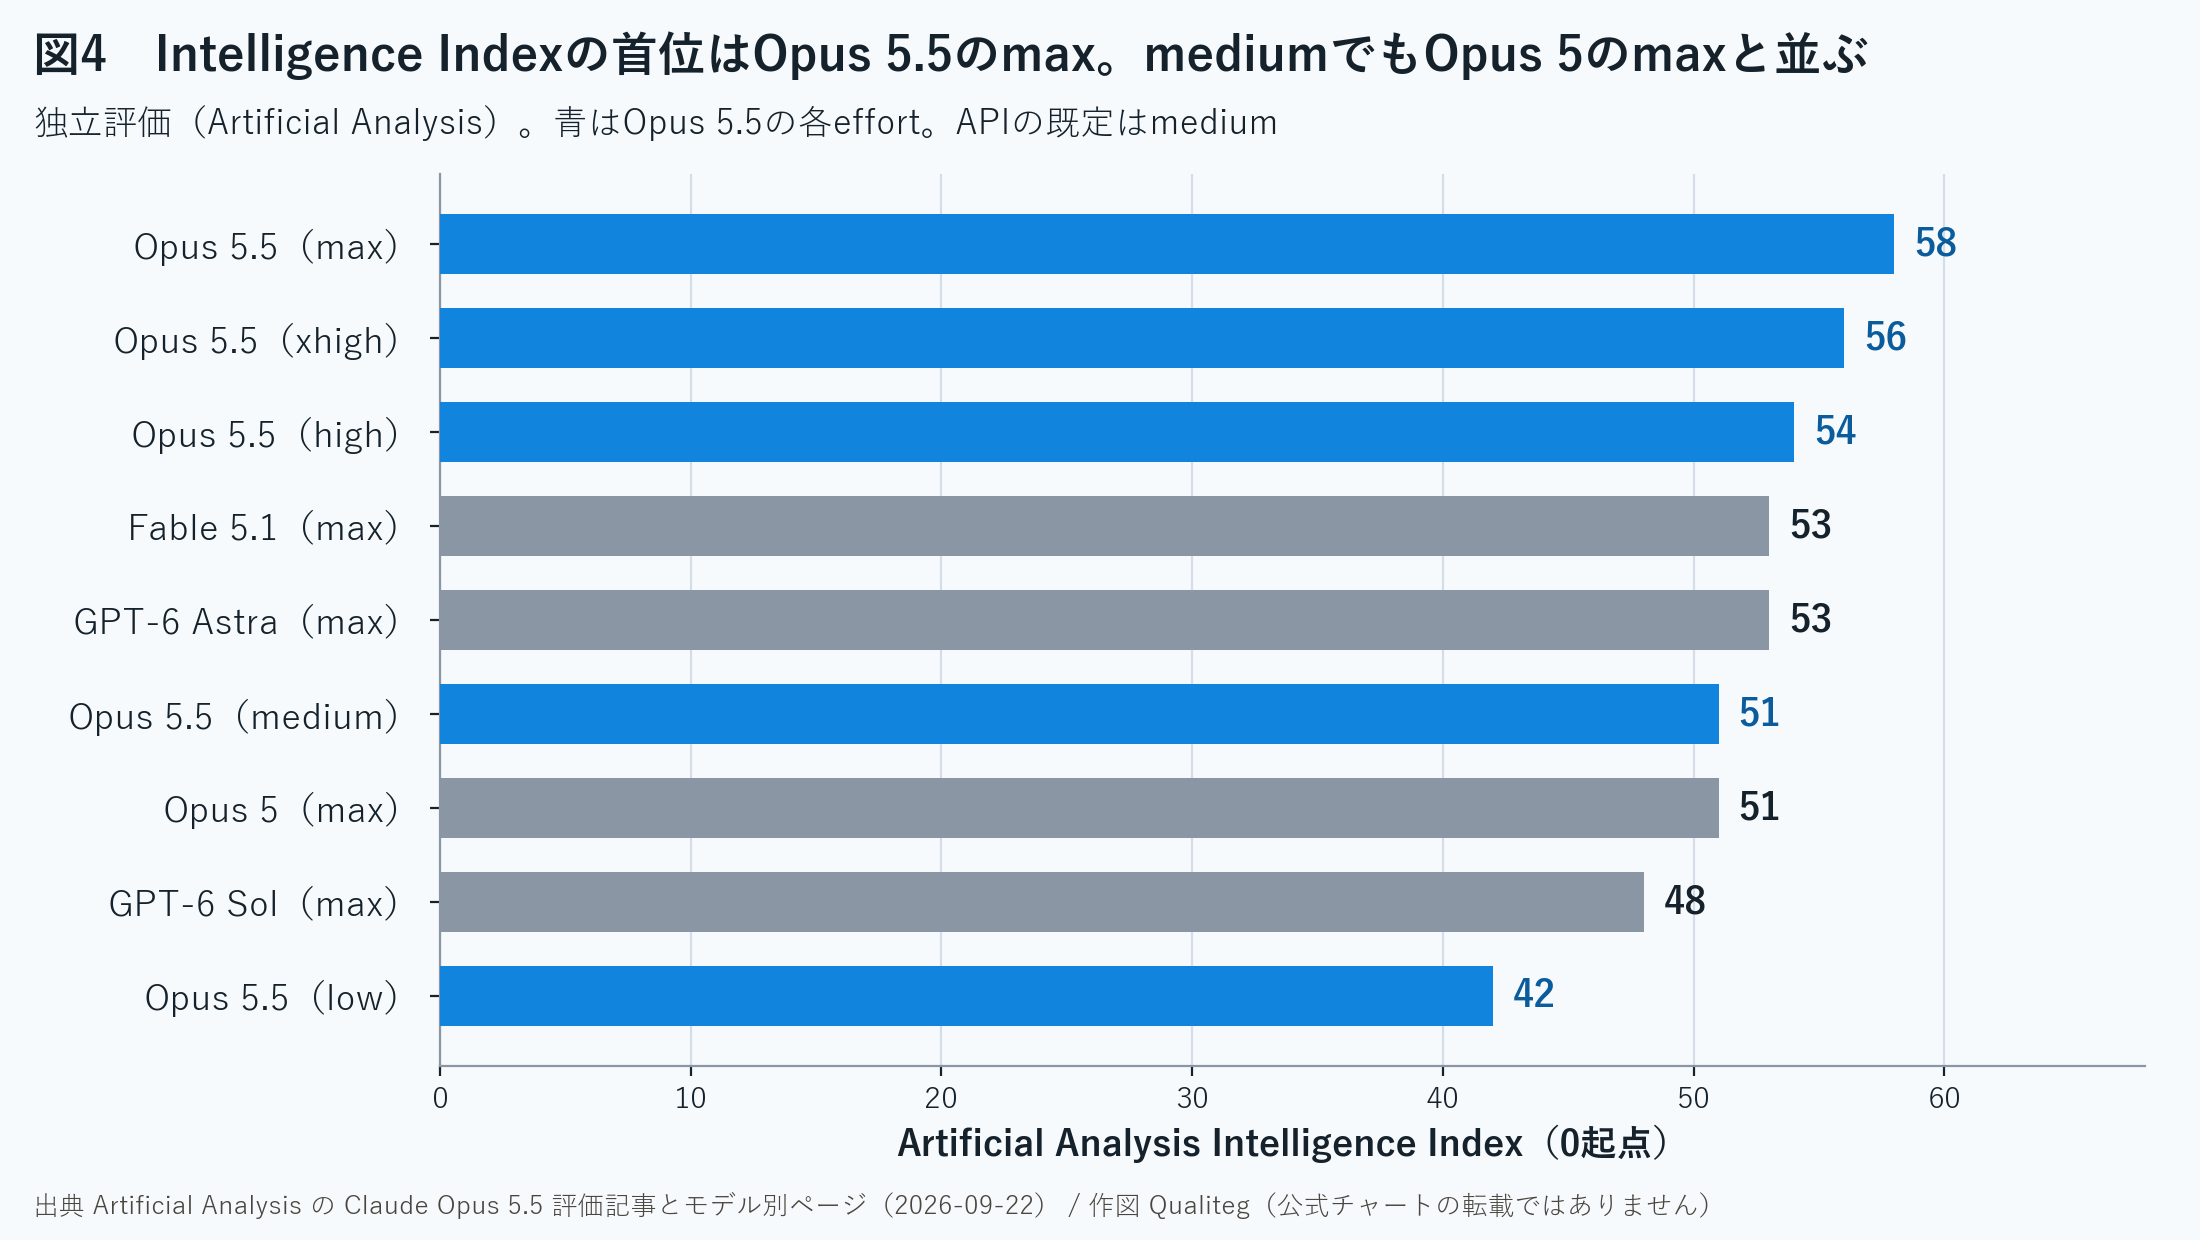
Intelligence Indexは、同社が自分で回す10種類の評価をまとめた総合指数です。Opus 5.5はmax effortで58になり、「これまで測った最高値を数ポイント上回る」とされています。
| モデル(effort) | Intelligence Index | 1タスクの実行費用 | 情報の確度 |
|---|---|---|---|
| Opus 5.5(max) | 58 | $5.98 | 独立評価 |
| Opus 5.5(xhigh) | 56 | $3.46 | 独立評価 |
| Opus 5.5(high) | 54 | $1.82 | 独立評価 |
| Fable 5.1(max) | 53 | $7.63 | 独立評価 |
| GPT-6 Astra(max) | 53 | $3.26 | 独立評価 |
| Opus 5.5(medium、APIの既定) | 51 | $1.34 | 独立評価 |
| Opus 5(max) | 51 | $5.86 | 独立評価 |
| GPT-6 Sol(max) | 48 | $1.06 | 独立評価 |
| Opus 5.5(low) | 42 | $0.55 | 独立評価 |
実行費用は、Intelligence Indexの評価タスク1つあたりの平均です。Opus 5.5の5つのeffortは、Anthropicの既定フォールバックを有効にした状態で測定されています。分類器に当たった分は別のモデルが答えているので、指数はその条件での値です。
目を引くのは、既定のmediumです。
Opus 5.5のmediumは指数51で、Opus 5のmaxと同じです。費用は$1.34対$5.86で、4分の1以下になります。Anthropicの「mediumがOpus 5のhigh以上」という主張と、方向は合っています。
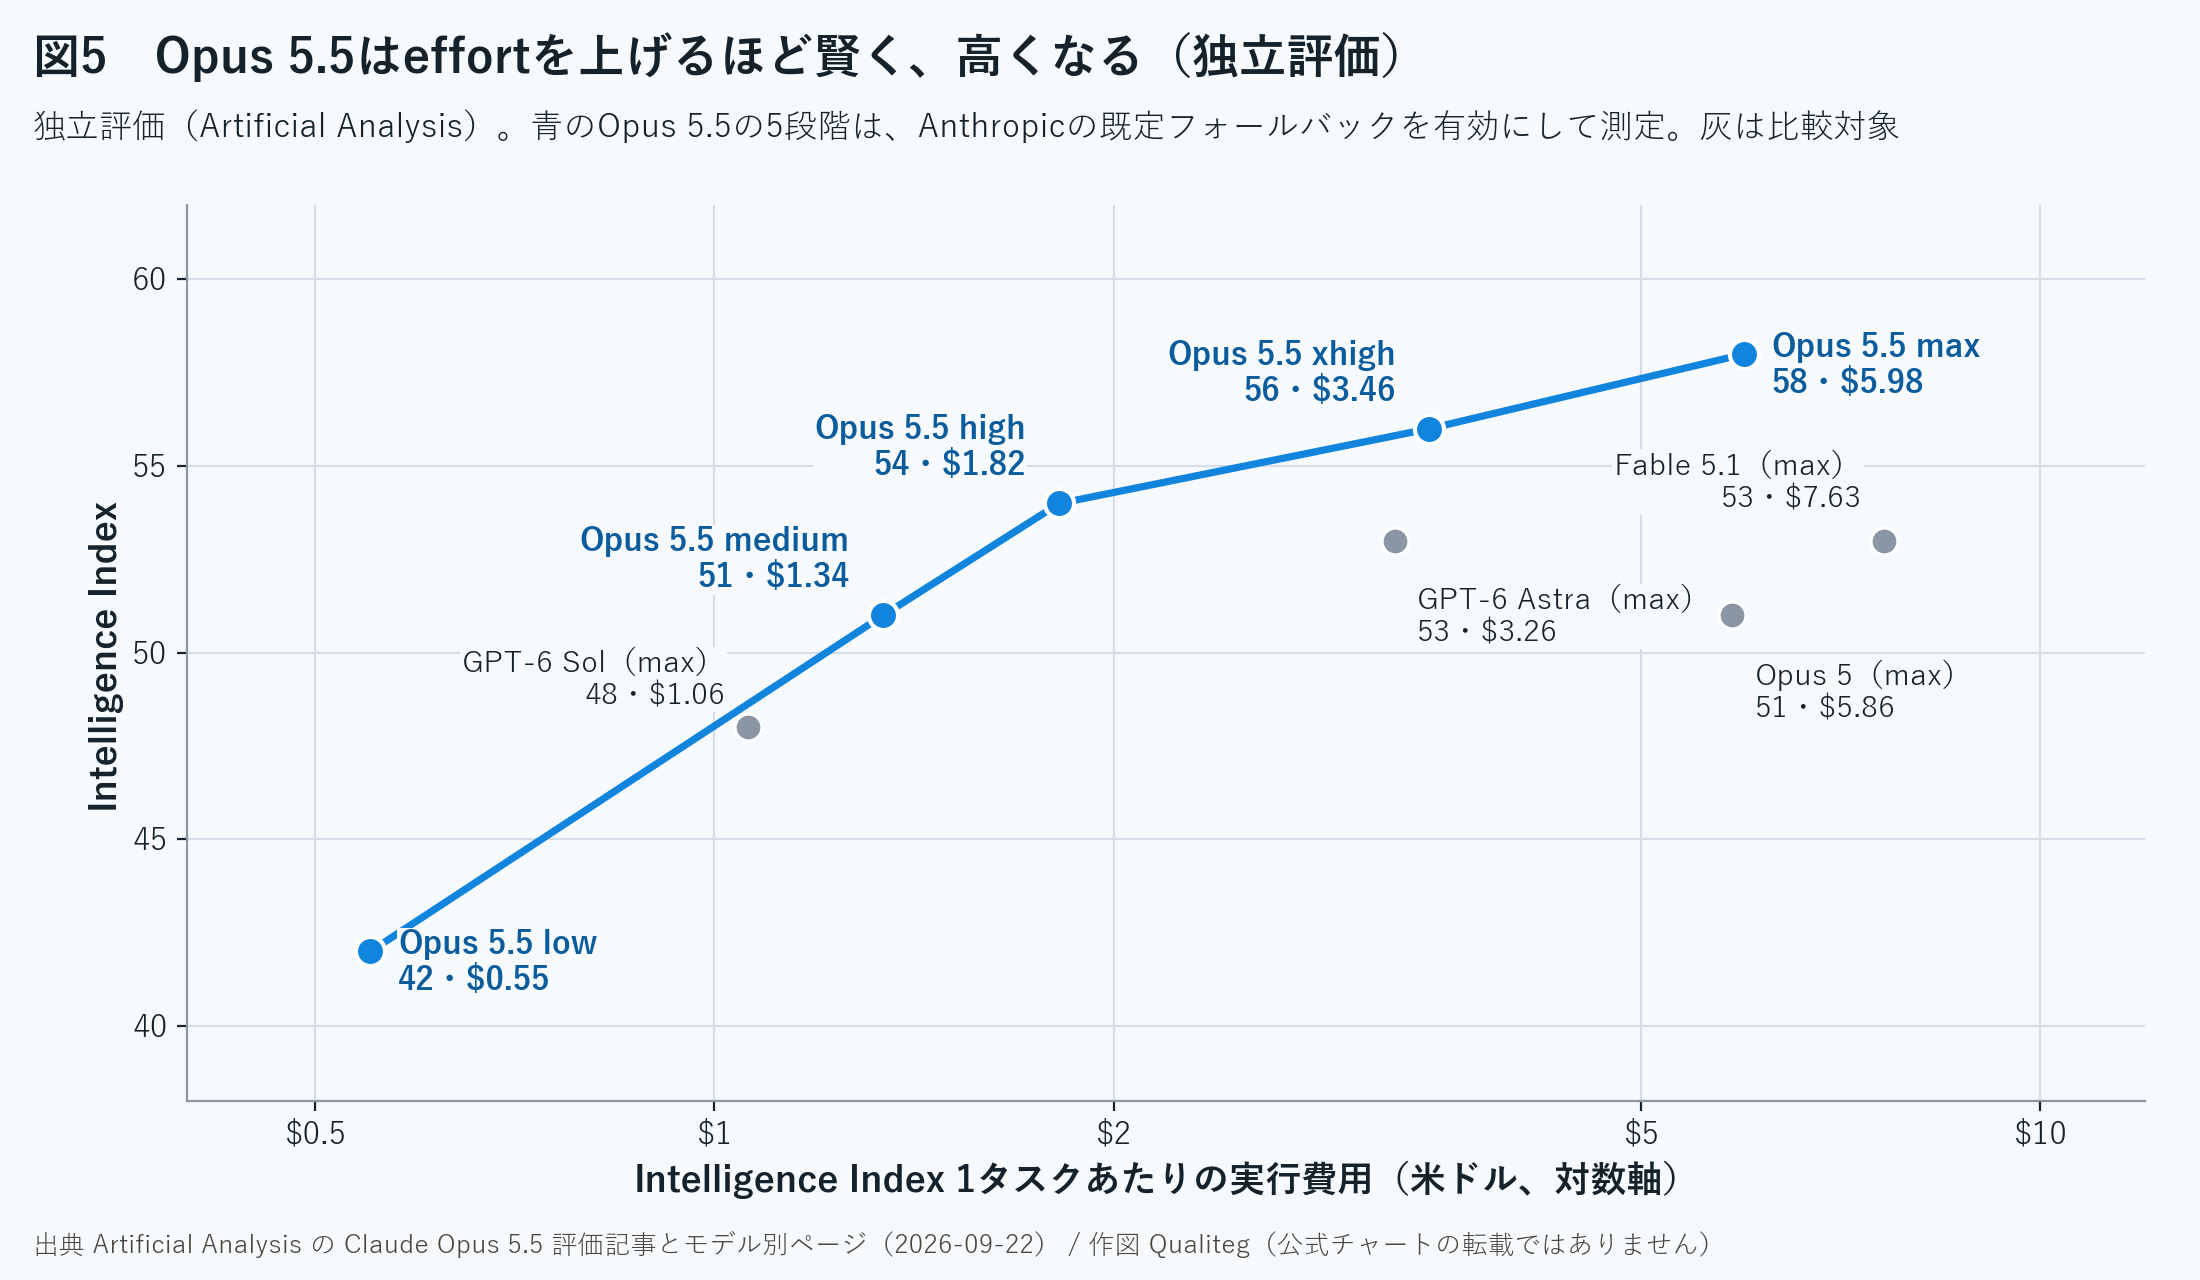
Artificial Analysisは「5段階のうちmedium・high・xhigh・maxの4段階が、指数対費用のパレート最前線に乗る」と書いています。同じ指数をより安く出すモデルが無い、という意味です。
個別の評価では、10種類のうち6つで首位でした。Humanity's Last Examは61.4%(従来の最高はFable 5.1の59.1%)、SciCodeは66.9%です。業務成果物を採点するGDPval-AA v2.1は1846 Eloで、Fable 5.1より111、Opus 5より138高くなっています。
プレゼン資料などを作らせるAA-Briefcase v1.1では1822 Eloで、Fable 5.1より143高い値です。一方でCritPt・AA-LCR・GDP.pdfでは首位を逃しています。
同社が自分で回したTerminal-Bench 4.0は59.6%で、「首位のGPT-6 Astra(xhigh)と同水準、Opus 5より11ポイント上」とされています。
Anthropic公表の66.4%とは、ハーネス・effort・試行数が違います。両方を並べるときは、誰が測った数字かを必ず添えてください。この記事でも、2つの値を同じ図には入れていません。
トークン消費には注意が要ります。
Opus 5.5(max)は、Intelligence Indexの1タスクで約119kの出力トークンを使いました。Opus 5(max)は約73k、Fable 5.1(max)は約78k、GPT-6 Astra(max)は約27kです。
Artificial Analysisの言い方は「1.6倍のトークンを使っても、1タスクの費用はOpus 5と同水準」です。単価が下がった分で、よく考える分を相殺している形です。maxは長く考えるので、第9章で触れる出力上限の問題にもつながります。
出力速度も載っています。Anthropic APIでの計測で、medium 75.2トークン毎秒、high 90.2、xhigh 92.4で、Fable 5.1は65.8でした。最初のトークンまでの時間は思考込みで、lowの4.79秒からxhighの148.38秒まで、effortが上がるほど長くなります。
前作の記事の「まだわかっていないこと」には、「独立評価はまだ出揃っていない」と書きました。Opus 5の答え合わせは、Opus 5(max)の指数51として、今回の表に入っています。
6. 同日発表のGPT-6 Sol・Lunaとの比べ方
GPT-6 Sol・Lunaの発表は、Opus 5.5の発表のおよそ1時間から1時間半後でした。詳しくは前回の記事に書いたので、ここでは比べ方だけを整理します。
まず料金です。
| モデル | 入力 | キャッシュ読み取り | 出力 | 情報の確度 |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | OpenAI料金表 |
| Claude Fable 5.1 | $10.00 | $0.25 | $50.00 | Anthropic料金ページ |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 | Anthropic料金ページ |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 | OpenAI料金表 |
| Claude Sonnet 5 | $2.00 | $0.20 | $10.00 | Anthropic料金ページ |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | OpenAI料金表 |
GPT-6 Solの単価は、Opus 5.5のちょうど半分です。Claude Sonnet 5とは同額になります。キャッシュ読み取りだけは、Opus 5.5もSolも$0.20で並びます。
性能を比べるときは、両社の公表値を横に並べないでください。
AnthropicはOpus 5.5のAutomationBenchを40.0%、OpenAIはSolを33.2%と公表しています。ただ、両社はそれぞれ自分の環境で、自分の選んだ設定で測っています。評価の版やeffort、ツールの与え方がそろっている保証はありません。
同じ条件で見たいなら、独立評価の共通指標を使います。
| 指標 | Claude Opus 5.5 | GPT-6 Sol(max) | 情報の確度 |
|---|---|---|---|
| Intelligence Index | 58(max)/51(medium) | 48 | 独立評価 |
| 1タスクの実行費用 | $5.98(max)/$1.34(medium) | $1.06 | 独立評価 |
| API単価(入力/出力) | $4/$20 | $2/$10 | 各社公式料金 |
Opus 5.5のmediumとSolのmaxを比べると、指数は51対48、費用は$1.34対$1.06です。単価はSolが半分でも、1タスクあたりの費用の差は3割弱に縮まります。
いまの時点で言えるのは、単価ではSolが半分、独立評価の総合指数ではOpus 5.5が上、ということです。用途ごとの向き不向きは、独立評価の個別項目と、自分の評価で確かめてください。
7. システムカードで見る安全性
システムカードは230ページあります。ここでは実務に関わる点を中心に拾います。
| 項目 | システムカード・公式発表の記載 | 情報の確度 |
|---|---|---|
| 化学・生物(RSP) | CB-1(既知の兵器の合成に関わる能力)あり、CB-2(新規の兵器)なし | システムカード |
| AI研究開発 | Mythos 5.1と同等かやや上。AIによる2倍の開発加速は観測されず | システムカード |
| サイバー | 社内評価で「これまでで最強」。新規の攻撃能力を開発できる兆候はない | システムカード |
| 自動行動監査 | 誤用への協力と広い意味の不整合の指標で、最近のClaudeで最良 | システムカード・公式発表 |
| 封じ込め境界を越えようとする頻度 | Opus 5やMythos 5.1より約85%少ない。すべて低深刻度で自己申告 | 公式発表 |
| プロンプトインジェクション | 報告した全評価でOpus 5と同等以上。Gray Swanの評価でFable 5.1と並び最低の成功率 | システムカード・公式発表 |
| 過剰拒否 | API 0.03%、claude.ai 0.38%(Opus 5は0.12%・0.49%) | システムカード |
| 事実性 | AA-Omniscienceの公開分割でnet score 0.58。他のClaudeより上 | システムカード |
サイバー能力の数値は、セーフガードを外して測った社内評価です。
CyScenarioBench(Irregularの10課題)では67.6%で、Mythos 5.1の61.7%、Opus 5の53.0%を上回りました。V8の41の脆弱性を使うExploitBenchでは、完全な任意コード実行に410回中301回(73.4%)で到達しています。
この能力の高さが、第12章の分類器につながっています。公式は、ジェイルブレイクに対する安全の余裕を一時的に広げているため、誤検知が増えうると明記しています。
後退した点も、システムカードは書いています。
ひとつは、ユーザーが貼り付けたテキストの中にある悪意ある指示に従いやすいことです。初期のスナップショットでは、コーディング評価で52%でした(Opus 5とSonnet 5は0%)。最終版のモデルと製品側の対策で緩和したとされます。
もうひとつは、検証できない権限の主張を受け入れやすいことです。
貼り付けテキストの扱いについては、プロンプティングガイドが対策を案内しています。貼り付けた内容をpasted_contentタグで区切り、システムプロンプトでその旨を伝える形です。Claude Code自身もこの型を使っているそうです。
セーフガードを外した新しい評価では、サンドボックスからの脱出や改変を1.5%の実行で試みました。公開パッケージレジストリの認証情報を渡した模擬演習では、約半数で潜在的に有害な行動をとっています。
公式は「評価されていると疑う兆候が多く、実運用での挙動を評価しにくい」とも書いています。エージェントに強い権限を渡す運用では、モデルの監査結果だけに頼らず、権限を絞る設計が引き続き必要です。
第2部 APIで使うときの注意点
公式の移行ガイドによると、Opus 5で動くコードに影響する破壊的変更は4つです。thinkingの無効化、forced tool use、preserved thinking、旧computer useツールです。
このうち前の3つは、Fable 5.1で入ったのと同じ仕組みです。Fable 5.1に移行済みのコードなら、同じ対応で済みます。
8. thinkingはもう切れない
Opus 5では、effortがhigh以下ならthinking: {"type": "disabled"}を受け付けました。Opus 5.5ではどのeffortでも400エラーです。
{"type": "enabled", "budget_tokens": N}の形も同じく400になります。返ってくるエラー文はこうです。
"thinking.type.disabled" is not supported for this model. Use "thinking.type.adaptive" and "output_config.effort" to control thinking behavior.対処は、thinkingフィールドを消すか{"type": "adaptive"}を送ることです。考える量は、effortで調整します。
公式の移行ガイドの例をもとにした書き換えです(Pythonの抜粋。当社では実行していません)。
# 変更前 Opus 5 では通るが、Opus 5.5 では 400
client.messages.create(
    model="claude-opus-5",
    max_tokens=16000,
    thinking={"type": "disabled"},
    messages=[{"role": "user", "content": "..."}],
)

# 変更後 thinking は常にオン。考える量は effort で決める
client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16000,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "..."}],
)
thinkingを切っていたのは、たいてい応答を速くしたいからです。その場合、公式はeffortをlowにして測り、品質が落ちるならmediumに上げるよう案内しています。
max_tokensにも注意してください。thinkingの本文は返ってこなくても、max_tokensには数えられます。thinkingなし前提で小さく決めていた値のままだと、回答が途中で切れます。
もうひとつ、レスポンスの読み方です。
thinkingの表示の既定はdisplay "omitted"で、thinkingブロックは空の文字列で返ってきます。応答の先頭がthinkingブロックになることがあるので、contentは位置ではなくtypeで選んでください。
Opus 5でthinkingを切っていた場合は、プロンプトの見直しも要ります。
「考えた過程を回答に書け」のような、thinkingの代わりをさせる指示は消します。残しておくと、第12章の推論抽出の分類器に拒否されることがあります。推論を読みたいならdisplayを"summarized"にして、thinkingブロックから読みます。
ツール呼び出しの合間のテキストの出方も変わりました。
Opus 5では、ツールを呼ぶ合間に書く短い経過報告がtextブロックで返っていました。Opus 5.5では、1〜2文より長い報告がthinkingブロックで返ります。既定のdisplayでは中身が空なので、進捗を画面に出していたアプリは、長いターンの間なにも表示しなくなります。
エラーにはならないので、気づきにくい変化です。表示を続けたいなら、ベータヘッダthinking-display-updates-2026-08-18を付けてdisplayを"updates"にすると、各報告の要約をテキストで受け取れます。
9. effortの既定がmediumになった
Opus 5までの既定はhighでした。Opus 5.5ではmediumです。
effortを省いたリクエストは、Opus 5より1段低く動きます。
公式は、effortを明示して自分の評価で測り直すよう求めています。そのうえで、名前が同じでも考える量はモデルごとに違う、と注意しています。
Anthropicのテストでは、Opus 5.5のmediumが、コーディングと知識労働でOpus 5のhighを上回りました。いくつかのコーディング評価では、lowでもそれに近い結果が出たそうです。第5章で見たとおり、Artificial Analysisでもmediumの指数がOpus 5のmaxと並んでいます。
逆向きの変化もあります。
同じeffortなら、Opus 5.5はOpus 5よりターンあたりに多く考えます。特にxhighとmaxで顕著です。Opus 5で使っていたeffortの値をそのまま持ち込むと、ターンが長くなり、出力トークンも増えます。
公式の案内をまとめるとこうなります。
| やりたいこと | 公式の案内 | 情報の確度 |
|---|---|---|
| どこから始めるか | mediumから始め、隣のlowとhighを試す | 公式移行ガイド |
| xhighとmax | 品質の向上を測れた仕事に限る | 公式移行ガイド |
| 考える量を減らしたい | 「考えすぎるな」と指示するより、effortを下げる | 公式移行ガイド |
| max_tokens | 思考の分も見込む。長いエージェント作業では64Kが目安、128,000が有効だったという記載も | 公式ドキュメント |
| ターンごとにeffortを変えたい | per-message effort(ベータmid-conversation-output-config-2026-07-01)ならキャッシュを壊さない | 公式移行ガイド |
最後の行は地味ですが効きます。リクエスト全体のeffortをリクエストごとに変えると、プロンプトキャッシュが無効になります。キャッシュ読み取りが安いOpus 5.5では、キャッシュを外したときの損が相対的に大きくなるので、この差は大きくなります。
maxについては、第三者の報告があります。
LLMの検証記事で知られるSimon Willisonは、発表当日にOpus 5.5とGPT-6 Sol・Lunaを試した記事を出しました。Opus 5.5のmaxに自転車に乗ったペリカンのSVGを描かせたところ、128,000トークンの出力上限を思考だけで使い切り、何も出力されなかったそうです。2回試して2回とも同じで、1回あたり$2.56、約20分かかったと書いています。
同じ課題でFable 5.1のmaxは成功しています。maxは上限なしで考えるので、出力上限との兼ね合いで何も返らないことがある、という実例です。
10. forced tool useと旧computer useツールは400になる
tool_choiceの{"type": "any"}と{"type": "tool", "name": ...}は、Opus 5.5では400エラーです。Messages APIだけでなく、Message Batches APIとトークン数を数えるエンドポイントでも同じです。
エラー文はtool_choice: type "tool" and "any" are not supported for this model.です。{"type": "auto"}(既定)と{"type": "none"}は変わらず使えます。
代わりの書き方は、目的で分かれます。
特定のツールを呼ばせたかったなら、autoにしてプロンプトでツールを指名し、ツール定義にstrict: trueを付けます。autoは呼び出しを保証しないので、呼ばれたかを確かめて、呼ばれなければやり直します。
JSONを取り出すためだけに強制していたなら、structured outputs(output_config.format)に置き換えます。
公式の移行ガイドの例をもとにした書き換えです(Pythonの抜粋。当社では実行していません)。
# 変更前 Opus 5.5 では 400
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    tools=tools,
    tool_choice={"type": "tool", "name": "get_weather"},
    messages=[{"role": "user", "content": "What's the weather in Paris?"}],
)

# 変更後 auto と strict、プロンプトでの指名、呼ばれたかの確認
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    tools=[{**tool, "strict": True} for tool in tools],
    tool_choice={"type": "auto"},
    messages=[{"role": "user", "content": "What's the weather in Paris? Use the get_weather tool."}],
)
if not any(block.type == "tool_use" and block.name == "get_weather" for block in response.content):
    ...  # やり直すか、テキストの回答で済ませる
strict: trueを付けるには、そのツールのinput_schemaがstrictの条件(additionalPropertiesをfalseにし、requiredを指定する)を満たしている必要があります。既存のスキーマにそのまま付けると、こちらが400になります。
コンピュータ操作も書き換えが要ります。
Opus 5では、ツールセットcomputer_toolset_20260801と、ベータヘッダ付きの旧ツールcomputer_20251124の両方が使えました。Opus 5.5では旧ツールが400になり、ツールセットだけが使えます(Claude APIとGoogle Cloud。Bedrockでは旧ツールも動きます)。
これはツール定義の差し替えだけでは済みません。ツールセットでは、モデルの操作がscreenshotやleft_clickといった名前のtool_useブロックとして返り、1ターンに複数来ることがあります。結果の返し方も変わるので、エージェントのループごと直す必要があります。
公式は、まずOpus 5の上でツールセットに移して動作を確かめてから、Opus 5.5に切り替えるよう勧めています。Opus 5は両方の形を受け付けるので、切り分けがしやすいからです。
11. preserved thinkingは8月31日以降に作ったアカウントに効く
preserved thinkingは、Fable 5.1と一緒に入った蒸留(モデルの能力を抜き出す攻撃)対策です。thinkingブロックを、それを作ったモデルと会話に結び付けます。
中身は2つに分かれます。
ひとつめは、モデルとの結び付きです。Opus 5.5は、Opus 5以前のOpus・Sonnet・Haikuが作ったthinkingブロックを読めます。一方、FableとMythosのブロックは読めません。
逆向きに、Opus 5.5のブロックを読めるのは、Claude API上のFable 5.1とMythos 5.1だけです。途中でOpus 5やOpus 4.8に切り替えると、切り替え後のターンはOpus 5.5の思考なしで進みます。
読めないブロックはAPIが落とします。リクエストは成功し、落ちた分は課金されません。
ふたつめは、会話との結び付きです。こちらが実務では効いてきます。
2026年8月31日0時(UTC)以降に作ったアカウントでは、thinkingブロックより前の部分を書き換えて送り直すと400になります。書き換えの対象は、システムプロンプト、ツールの一覧、それ以前のメッセージです。
それより前に作ったアカウントでは、自分で設定したときだけ有効になります。
Claude Code、claude.ai、Managed Agents、Agent SDKは、この条件を守るように作られています。影響を受けるのは、会話の履歴を自前で組み立てているアプリです。
よくある書き換えと、その置き換え先は次のとおりです。
| いまのやり方 | 置き換え先 | 情報の確度 |
|---|---|---|
| 会話の途中でシステムプロンプトを書き換える | 会話の途中にsystemメッセージを追記する | 公式移行ガイド |
| 毎ターン注意書きを差し込み、あとで消す | 消さずに追記する形にする | 公式移行ガイド |
| 途中でツールを足したり消したりする | 最初に全部宣言し、追加と削除のブロックで伝える(ベータ) | 公式移行ガイド |
| 古いターンを要約し、新しいターンはthinking付きで送り直す | サーバー側のcompaction(ベータcompact-2026-09-04)を使うか、履歴全体を要約に置き換える | 公式移行ガイド |
どうしても書き換えが必要なら、合わなくなったブロックを400にせず落とす設定があります。ベータヘッダthinking-binding-controls-2026-08-01を付けて、次のように送ります(公式の移行ガイドにあるリクエスト例の写しです)。
POST /v1/messages
anthropic-beta: thinking-binding-controls-2026-08-01

{"model": "claude-opus-5-5", "max_tokens": 64000,
 "thinking": {"type": "adaptive", "block_binding": {"prefix_mismatch_behavior": "drop_block"}},
 "messages": [ ...thinkingブロックを含む履歴をそのまま... ]}
公式は、対象外の古いアカウントでも履歴の見直しをしておくよう勧めています。追記だけの履歴にすると、プロンプトキャッシュのヒット率も上がるからです。
12. 安全分類器は生物が広がり、推論抽出が加わった
Opus 5の安全分類器は、サイバーと、生物兵器の誤用に絞った生物の2つでした。Opus 5.5では、生物の分類器がFable 5.1と同じ、研究生物学まで含む広い範囲のものに変わりました。
さらに、推論抽出(reasoning_extraction)の分類器が加わりました。システムカードには、フロンティアLLM開発の狭い範囲(特定のMLアクセラレータのカーネル開発など)を止める分類器も載っています。通常のAI・ML開発や一般のコーディングには影響しない、とされています。
| 分類器 | 止まるもの | APIのフォールバック先(推奨) | 情報の確度 |
|---|---|---|---|
| サイバー | 多くのサイバーセキュリティ作業。ソースコードの脆弱性を見つけて直す作業は許可 | Opus 4.8 | 公式発表・移行ガイド |
| 生物 | ウイルス学・毒性学・分子設計など両用途の研究 | Opus 5 | 公式発表・移行ガイド |
| フロンティアLLM開発 | 特定のMLアクセラレータのカーネル開発など狭い範囲 | Opus 5 | システムカード・ヘルプ記事 |
| 推論抽出 | 内部の推論を回答に書き出させようとするリクエスト | なし(再試行の対象外) | 公式移行ガイド |
日常の健康の質問や教育的な質問は影響を受けない、と公式は書いています。
拒否は、エラーではなくHTTP 200で返ってきます。stop_reasonが"refusal"になり、stop_detailsにカテゴリが入ります。contentを読む前にstop_reasonを確認するように作っておいてください。
フォールバックはAPIでは既定で動きません。fallbacks: "default"(ベータserver-side-fallback-2026-07-01)を指定すると、カテゴリごとに推奨されるモデルで自動的に再試行します。
公式は、このフォールバックを初日から入れておくよう勧めています。分類器は無害なリクエストにも反応することがあり、フォールバックが無いと、誤検知がそのまま障害になるからです。
第11章とのつながりにも注意してください。フォールバック先のOpus 5やOpus 4.8は、Opus 5.5のthinkingブロックを読めません。切り替わったターンからは、それまでの思考を引き継がずに進みます。
研究用途で生物の分類器に当たる組織向けには、Life Sciences Verification Programの申請窓口が開いています。サイバーの防御側向けのCyber Verification Programも、数週間以内にOpus 5.5へ広げると公式発表にあります。
13. 移行の手順と費用試算の更新
公式の移行ガイドの項目を、作業の順に並べ直します。
| 順番 | やること | 放置したとき | 情報の確度 |
|---|---|---|---|
| 1 | モデルIDをclaude-opus-5-5に変える(Bedrockはanthropic.claude-opus-5-5) | 移行されない | 公式移行ガイド |
| 2 | thinkingのdisabledとenabledを全経路から消し、effortを選ぶ | 400 | 公式移行ガイド |
| 3 | tool_choiceのanyとtoolを、autoとstrictかstructured outputsに置き換える | 400 | 公式移行ガイド |
| 4 | 旧computer useツールをツールセットに移す(Opus 5で先に試す) | 400 | 公式移行ガイド |
| 5 | 履歴を自前で組むアプリは、追記だけの形に直す | 新しいアカウントで400 | 公式移行ガイド |
| 6 | stop_reason "refusal"の処理を入れ、fallbacksを有効にする | 誤検知で処理が止まる | 公式移行ガイド |
| 7 | effortを明示し、lowとmediumを含めて測り直す | 既定のmediumで動く | 公式移行ガイド |
| 8 | 進捗を画面に出しているなら、displayを設定する | 長いターンの間、表示が止まる | 公式移行ガイド |
| 9 | max_tokensを思考の分も見込んで見直す | 回答が途中で切れる | 公式移行ガイド |
| 10 | 画像の前処理など、旧モデル向けの工夫を試し直す | 無駄な処理が残る | 公式移行ガイド |
1から6は、放っておくとエラーか処理の停止になります。7から10はエラーにはならず、動くけれど最適ではない、という種類です。
10は見落としがちです。公式は、Opus 5.5がlowでも、Opus 5の最高effortより正確に密なグラフを読むとしています。Opus 5のためにコードで画像を切り抜いて拡大させていた仕組みは、要らなくなっているかもしれません。
最後に、前作と前回の記事で使った試算を更新します。
条件は入力1万・出力2千トークンの1リクエストで、キャッシュなし、ツール料金と地域の加算は除いています。出力は思考分を含めた課金対象の量として計算しています。
| モデル | 入力分 | 出力分 | 合計 | 情報の確度 |
|---|---|---|---|---|
| Claude Fable 5.1 | $0.10 | $0.10 | $0.20 | 料金ページからの試算 |
| GPT-6 Astra | $0.10 | $0.10 | $0.20 | 料金表からの試算 |
| Claude Opus 5 | $0.05 | $0.05 | $0.10 | 料金ページからの試算 |
| Claude Opus 5.5 | $0.04 | $0.04 | $0.08 | 料金ページからの試算 |
| Claude Sonnet 5 | $0.02 | $0.02 | $0.04 | 料金ページからの試算 |
| GPT-6 Sol | $0.02 | $0.02 | $0.04 | 料金表からの試算 |
キャッシュが効く例も計算します。キャッシュ読み取り10万・新規入力5千・出力2千トークンの場合です。
Opus 5.5は、キャッシュ読み取り$0.02、新規入力$0.02、出力$0.04で、合計$0.08です。Opus 5は$0.05、$0.025、$0.05で合計$0.125なので、Opus 5.5のほうが36%安くなります。
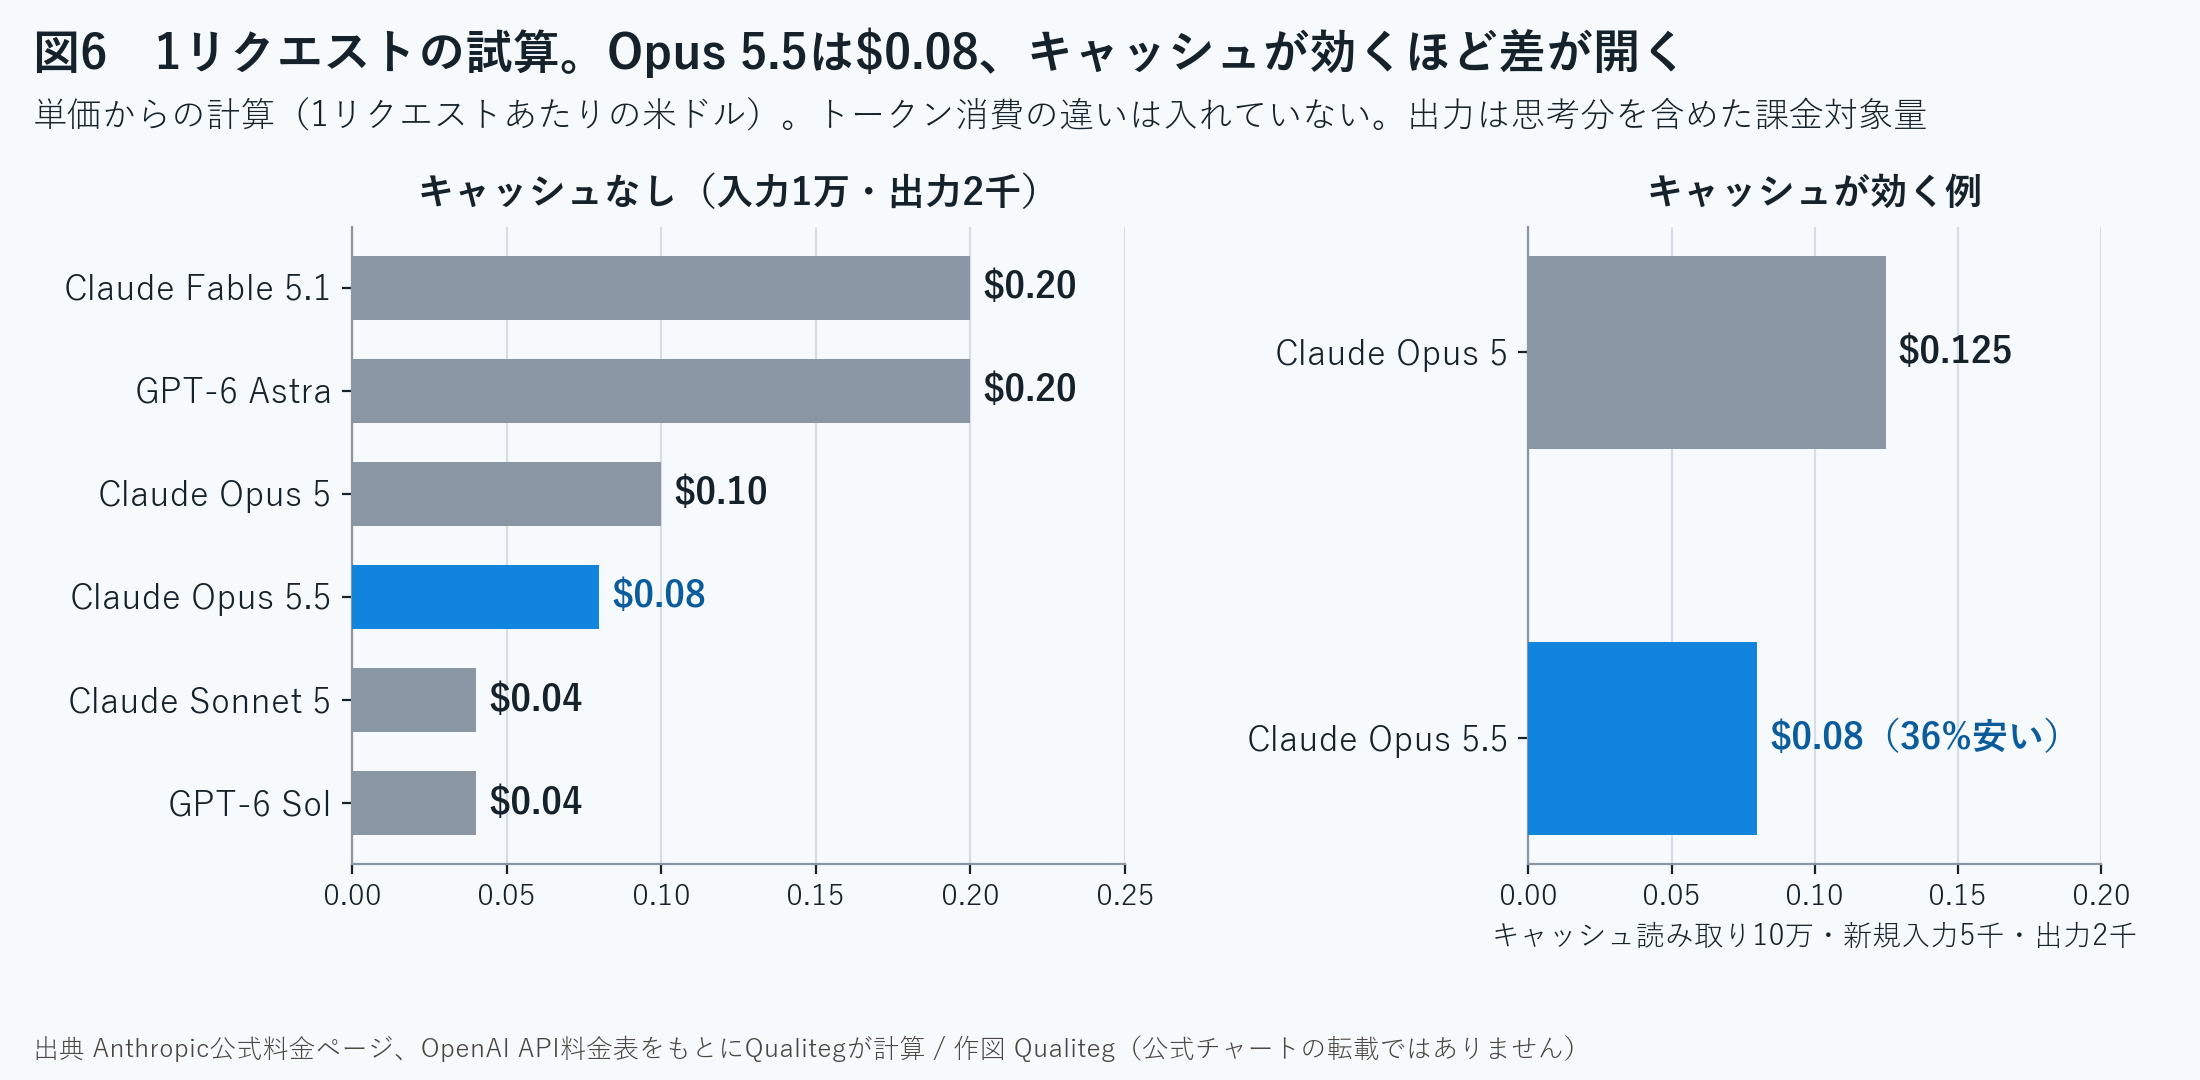
キャッシュなしでは20%の差が、キャッシュが効くと36%に開きます。エージェントのように同じ文脈を読み直す使い方ほど、Opus 5.5の値下げは大きく効きます。
ただし、この試算には1回あたりのトークン消費の違いが入っていません。第5章のとおり、Opus 5.5はmaxで長く考えます。effortを上げて使うなら、実際の費用は試算より上に出ます。
第3部 Claude Codeで使うOpus 5.5
14. v2.1.280で既定モデルがOpus 5.5になった
Claude CodeでOpus 5.5を使うには、v2.1.280以上が必要です。claude updateで更新してください。
CHANGELOGの2.1.280には、「Claude Opus 5.5を追加し、既定のOpusモデルにした」とあります。同じ版で、ProとTeam Standardの既定モデルがSonnetからOpusに変わりました。
前作の記事では、Opus 5を「Maxの既定モデル」と紹介しました。今回はProとTeam Standardの既定もOpusです。
| アカウント種別 | 既定モデル | 情報の確度 |
|---|---|---|
| Pro・Team Standard | Opus 5.5(Sonnetから変更) | CHANGELOG・公式ドキュメント |
| Max・Team Premium・Enterprise | Opus 5.5 | 公式ドキュメント |
| Anthropic API・Claude Platform on AWS | Opus 5.5 | 公式ドキュメント |
| Amazon Bedrock・Google Cloud | Opus 5.5 | 公式ドキュメント |
| Microsoft Foundry | Sonnet 4.5 | 公式ドキュメント |
エイリアスの向き先も整理します。
| エイリアス | 向き先(Anthropic API接続時) | 情報の確度 |
|---|---|---|
opus | Opus 5.5 | 公式ドキュメント |
sonnet | Sonnet 5 | 公式ドキュメント |
fable | Fable 5.1 | 公式ドキュメント |
best | Fableを使える組織ならFable、使えなければOpus | 公式ドキュメント |
opusplan | 計画はopus、実行はsonnet | 公式ドキュメント |
sonnetの向き先は接続先で違います。Claude Platform on AWSではSonnet 4.6、Amazon BedrockとGoogle CloudではSonnet 4.5です。Microsoft Foundryではopusの向き先もOpus 4.6になります。別の接続先で使うときは、公式ドキュメントの表で確かめてください。
Opus 5のまま使い続けたい場合は、エイリアスではなくclaude-opus-5をフルネームで指定します。
15. effortはモデルごとの設定で決める
Claude CodeでのOpus 5.5の既定effortはmediumです。Opus 4.7の既定はxhigh、その他のモデルはhighなので、Opus 5.5だけが低めから始まります。
前作の記事では、「Opus 5だけ以前のeffortがそのまま引き継がれるので、切り替え直後に確認を」と書きました。今回はその逆です。
v2.1.280では、/effortがモデルごとの設定になる前に保存したeffortを、Opus 5.5のような新しいモデルに当てはめない、と変わりました。以前xhighを常用していても、Opus 5.5はmediumから始まります。
もうひとつ、設定ファイルの効き方にも違いがあります。
ユーザー設定(~/.claude/settings.json)のトップレベルにあるeffortLevelは、/effortがモデル別になる前の古い形式です。Opus 5、Fable 5.1と以前のモデルには効き続けますが、Opus 5.5には引き継がれません。
一方、プロジェクト・ローカル・管理設定にあるトップレベルのeffortLevelと、--settingsで渡す値は、Opus 5.5を含むすべてのモデルに適用されます。置く場所で結果が変わる点に注意してください。
ユーザー設定でOpus 5.5のeffortを決めるなら、モデル別のmodelSettingsか/effortを使います。
公式ドキュメントの記載をもとにした書き方の例です(settings.jsonの抜粋。当社ではまだ動作を確かめていません)。
{
  "modelSettings": {
    "claude-opus-5-5": { "effortLevel": "high" }
  },
  "switchModelsOnFlag": false
}switchModelsOnFlagは第17章で扱う設定です。
/modelのピッカーでは、左右キーでeffortを選べます。sキーを押すと、その選択をいまのセッションだけに限れます(v2.1.257以降)。
thinkingについても、APIと同じ制約があります。MAX_THINKING_TOKENS=0はOpus 5.5とFableには効かず、thinkingは切れません。
どのeffortで使うかは、第9章の公式の案内がそのまま当てはまります。日常はmediumで様子を見て、難しい設計や大きな移行ではhighやxhighに上げる。maxは第9章の報告のとおり、出力上限を思考で使い切ることがあるので、使う場面を選んでください。
16. Fast modeは$8/$40、支払いはusage creditsから
/fastで切り替えるFast modeは、同じモデルのまま最大2.5倍の速度で動かす機能です。v2.1.280以降、Fast modeの既定モデルはOpus 5.5になりました。
| 項目 | 内容 | 情報の確度 |
|---|---|---|
| 料金(入力/出力) | $8/$40(Opus 5・4.8は$10/$50) | 公式ドキュメント・公式発表 |
| 速度 | 最大2.5倍 | 公式発表 |
| サブスクリプションでの支払い | 利用枠に含まれず、usage creditsからのみ | 公式ドキュメント |
| TeamとEnterprise | Ownerが有効にする | 公式ドキュメント |
| Consoleの組織 | 提供の申請が必要 | 公式ドキュメント |
| 使えない環境 | Bedrock・Vertex AI・Foundry・Claude Platform on AWS | 公式ドキュメント |
使うなら、会話の最初からオンにするのがおすすめです。
会話の途中でオンにすると、それまでの会話全体に、Fast modeのキャッシュなし入力の単価が1回かかります。長い会話の途中で切り替えるほど、この1回分が大きくなります。
レート制限に当たると、自動で標準の速度に戻ります。
17. 分類器でモデルが切り替わるときの挙動
Claude Codeでは、分類器に当たったリクエストを別のモデルで自動的にやり直します。
| 元のモデル | サイバー | 生物 | 情報の確度 |
|---|---|---|---|
| Fable 5.1・Fable 5 | Opus 4.8 | Opus 5 | 公式ドキュメント |
| Opus 5.5 | Opus 4.8 | Opus 5 | 公式ドキュメント |
| Opus 5 | Opus 4.8 | 切り替えなし(拒否) | 公式ドキュメント |
Opus 5では、生物で当たると拒否で終わっていました。Opus 5.5ではOpus 5に切り替わって続きます。
claude.aiなどのアプリ側の切り替えは、ヘルプ記事に書かれています。Opus 5.5では、特定のMLアクセラレータのカーネル開発のようなフロンティアLLM開発もOpus 5に切り替わります。推論を1ステップずつ書き出させるような蒸留に当たる依頼は、切り替えずに止まります。
切り替わったときは、通知と、どのモデルが答えたかのラベルが出ます。
既定は自動で切り替える設定です。切り替える前に確認したいなら、/configの「Switch models when a message is flagged」をオフにするか、settings.jsonでswitchModelsOnFlagをfalseにします。
セキュリティや生物に関わるリポジトリでは、何も変なことを頼んでいなくても、CLAUDE.mdなどの文脈で分類器が反応することがあります。切り替わった後のターンはOpus 5.5の思考を引き継がないので、頻発するなら文脈に入る語彙を見直すのが先です。
分類器とは別の仕組みとして、可用性のためのfallbackModel設定と、組織で使えるモデルを絞るavailableModelsは、これまでどおり使えます。
18. 1Mコンテキスト・5時間枠・日常運用のリズム
Opus 5.5の1Mコンテキストは、選ばなくても最初から使えます。自動compactは約967Kトークンで入るのが既定で、/autocompactで変えられます。
サブスクリプションの使用量上限にも、2つの変更がありました。
ひとつは、Pro・Max・Team・シートベースのEnterpriseで、5時間の使用量上限を引き上げたことです。引き上げ幅の数値は、9月24日時点で公式に出ていません。
もうひとつは、「上限リセット(limit reset)」の配布です。使いたいときに使える回数券のようなもので、5時間枠か週枠のどちらかを、その場で満タンに戻せます。
使い方はヘルプ記事にあります。WebかClaude Desktopで、Settings > Usageを開き、Resetsの欄にある「Reset for free」を押します。上限に達したときのメッセージにも、同じボタンが出ます。
ここで注意があります。
上限リセットは、Claude Codeのターミナル・IDEとモバイルアプリからは使えません。Claude Codeで上限に達したら、ブラウザかDesktopを開いて押すことになります。
使うと取り消せず、使わなかった分は表示された日時に失効します。ダウングレードや解約をすると消えます。
最後に、日常の運用です。
ひとつめは、effortの置き方です。Opus 5.5はmediumが既定で、公式もmediumから始めるよう勧めています。普段はmediumのままにして、詰まったときだけ上げる。上げるときはセッション限定にしておくと、戻し忘れが防げます。
ふたつめは、CLAUDE.mdの見直しです。
公式の移行ガイドは、Opus 5のために入れた指示を試し直すよう勧めています。Opus 5は回答が長く、自己検証を重ねがちだったので、「短く書け」「重ねて検証するな」のような指示を入れていた方も多いはずです。
Opus 5.5は要点を先に書き、文章が明快になったとされます。こうした指示が今も要るかは、自分の作業で確かめてください。一方、テストの実行やlintのような完了条件は、モデルが変わっても残します。
みっつめは、モデルの使い分けです。
Pro・Team Standardでも既定がOpusになったので、軽い作業までOpus 5.5で回すことになります。使用量が気になるなら、軽い作業は/model sonnetでSonnetに切り替えるのが手です(Anthropic API接続ならSonnet 5)。
Fable 5.1は、Proではusage creditsでのみ、Maxでは週枠の50%まで使える扱いです。Opus 5.5はProでも既定モデルなので、普段の作業はOpus 5.5、どうしても届かない仕事だけFable 5.1、という分け方が自然になりました。
なお、この記事の下書きと入稿の作業の一部にも、Claude Code上のOpus 5.5を使っています。ただしベンチマーク的な比較はしていないので、使い心地の評価はまだ控えます。
まだわかっていないこと・未確認事項
9月24日時点で確認できていないことを書いておきます。
- 5時間枠の引き上げ幅(公式発表に数値が無い)
- FreeプランでOpus 5.5が使えるか(公式では確認できず)
- Sonnet 5.5とHaiku 5.5の価格と提供日(公式は「数週間以内」とだけ)
- Opus 5.5のAPIのレート制限の数値と、Opus 5と別枠か同じ枠か
- BedrockとVertex AI上のFable 5.1が、Opus 5.5のthinkingブロックを読めるか(公式はClaude APIでのみ明記)
- Opus 5の提供終了日
- 日本語での性能(当ブログのLLMランキング10月版で扱う予定)
- 当社の手元での体系的な検証
ベンチマークは、Anthropicの公表値とArtificial Analysisの独立評価を分けて書きました。表の「情報の確度」列で、どちらの数字かを確かめてください。
まとめ
冒頭でもかきましたが、本モデルリリースについて、一言でまとめると
「Opus 5.5は、Fable 5.1級を狙う性能を、Opus 5より安い単価と既定mediumで出してきた。代わりに、thinkingを切る・ツールを強制する・履歴を書き換える、という古い書き方が通らなくなった」。
これが今回のリリースの中身です。
実務で押さえるのは次の5つです。
- 単価は20%引き、キャッシュ読み取りは60%引き。エージェント作業ほど値下げが効く
- thinkingの無効化、forced tool use、旧computer useツールは400。IDの差し替えだけでは動かない
- effortの既定はmedium。明示して測り直し、xhighとmaxは効果を測れた仕事に絞る
- 新しいアカウントでは、履歴の書き換えが400になる。会話は追記だけにする
- Claude Codeはv2.1.280以上で、ProとTeam Standardでも既定がOpus 5.5。effortはモデル別の設定で決める
使い分けを表にします。
| 用途 | おすすめ | 理由 |
|---|---|---|
| 日常のコーディング・軽い修正 | Claude Sonnet 5 | $2/$10でOpus 5.5の半額。速い |
| 大きめの実装・移行・コードレビュー・知識労働 | Claude Opus 5.5(mediumから) | 独立評価の首位。mediumでOpus 5のmaxと同じ指数 |
| Opus 5.5のhigh以上でも届かない仕事 | Claude Fable 5.1 | 公式の案内どおりの上げ先。ただし単価は2.5倍、ZDRでは使えない |
| 単価を最優先するエージェント | GPT-6 Sol | Opus 5.5の半額。独立評価の指数は48 |
| ZDR契約のある組織の最上位 | Claude Opus 5.5 | Fable 5.1は30日保持が要件 |
次は、数週間以内に出るとされるSonnet 5.5とHaiku 5.5です。価格が出たら、この記事の続報として使い分けを更新します。日本語での性能は、当ブログのLLMランキング10月版で確かめます。
それでは、また次回、お会いしましょう!
出典
| トピック | 出典 |
|---|---|
| 発表・料金・ベンチマーク・事例 | Introducing Claude Opus 5.5(Anthropic公式発表) |
| モデル仕様・提供先 | Claude Opus 5.5のモデルページ(公式ドキュメント) |
| 新機能と挙動の変化 | What's new in Claude Opus 5.5(公式ドキュメント) |
| 破壊的変更と移行手順 | Migrating to Claude Opus 5.5(公式ドキュメント) |
| プロンプトの書き方 | Prompting Claude Opus 5.5(公式ドキュメント) |
| モデル一覧・知識の基準日 | Models overview(公式ドキュメント) |
| API料金 | Pricing(公式ドキュメント) |
| effort | Effort(公式ドキュメント) |
| Priority Tierの対応モデル | Service tiers(公式ドキュメント) |
| 安全性・評価の詳細 | Claude Opus 5.5 System Card(Anthropic、PDF) |
| Claude Codeのモデル設定・フォールバック | Model configuration(Claude Code公式ドキュメント) |
| Claude CodeのFast mode | Fast mode(Claude Code公式ドキュメント) |
| Claude Codeの変更履歴 | Claude Code CHANGELOG(GitHub) |
| 上限リセット | What is a limit reset?(Claudeヘルプセンター) |
| アプリでのモデルの切り替え | Why Claude switched models in your conversation(Claudeヘルプセンター) |
| preserved thinking | Preserved thinking(Claudeヘルプセンター) |
| 独立評価 | Claude Opus 5.5の評価記事(Artificial Analysis) |
| 独立評価(effort別の値・費用・速度) | Claude Opus 5.5のモデル別ページ(Artificial Analysis) |