GPT-6 Sol・Luna 完全解説 Astraとの違い・料金半減の中身・API移行とCodexでの使い方
GPT-6 Sol・Luna の完全解説。API 単価が半額になった中身、Astra や Claude Opus 5.5 との比べ方、推論量 none や入力 272K 超の割増など移行の注意点、Codex・Copilot での提供状況まで。
こんにちは!
2026年9月22日(米国時間)、日本はシルバーウィーク後半戦の只中にOpenAIからGPT-6 Sol(ソル)とGPT-6 Luna(ルナ)が発表されました。
9月上旬に出たGPT-6 Astraに続く、GPT-6ファミリーの2モデルです。
何が変わったかというと、料金です。
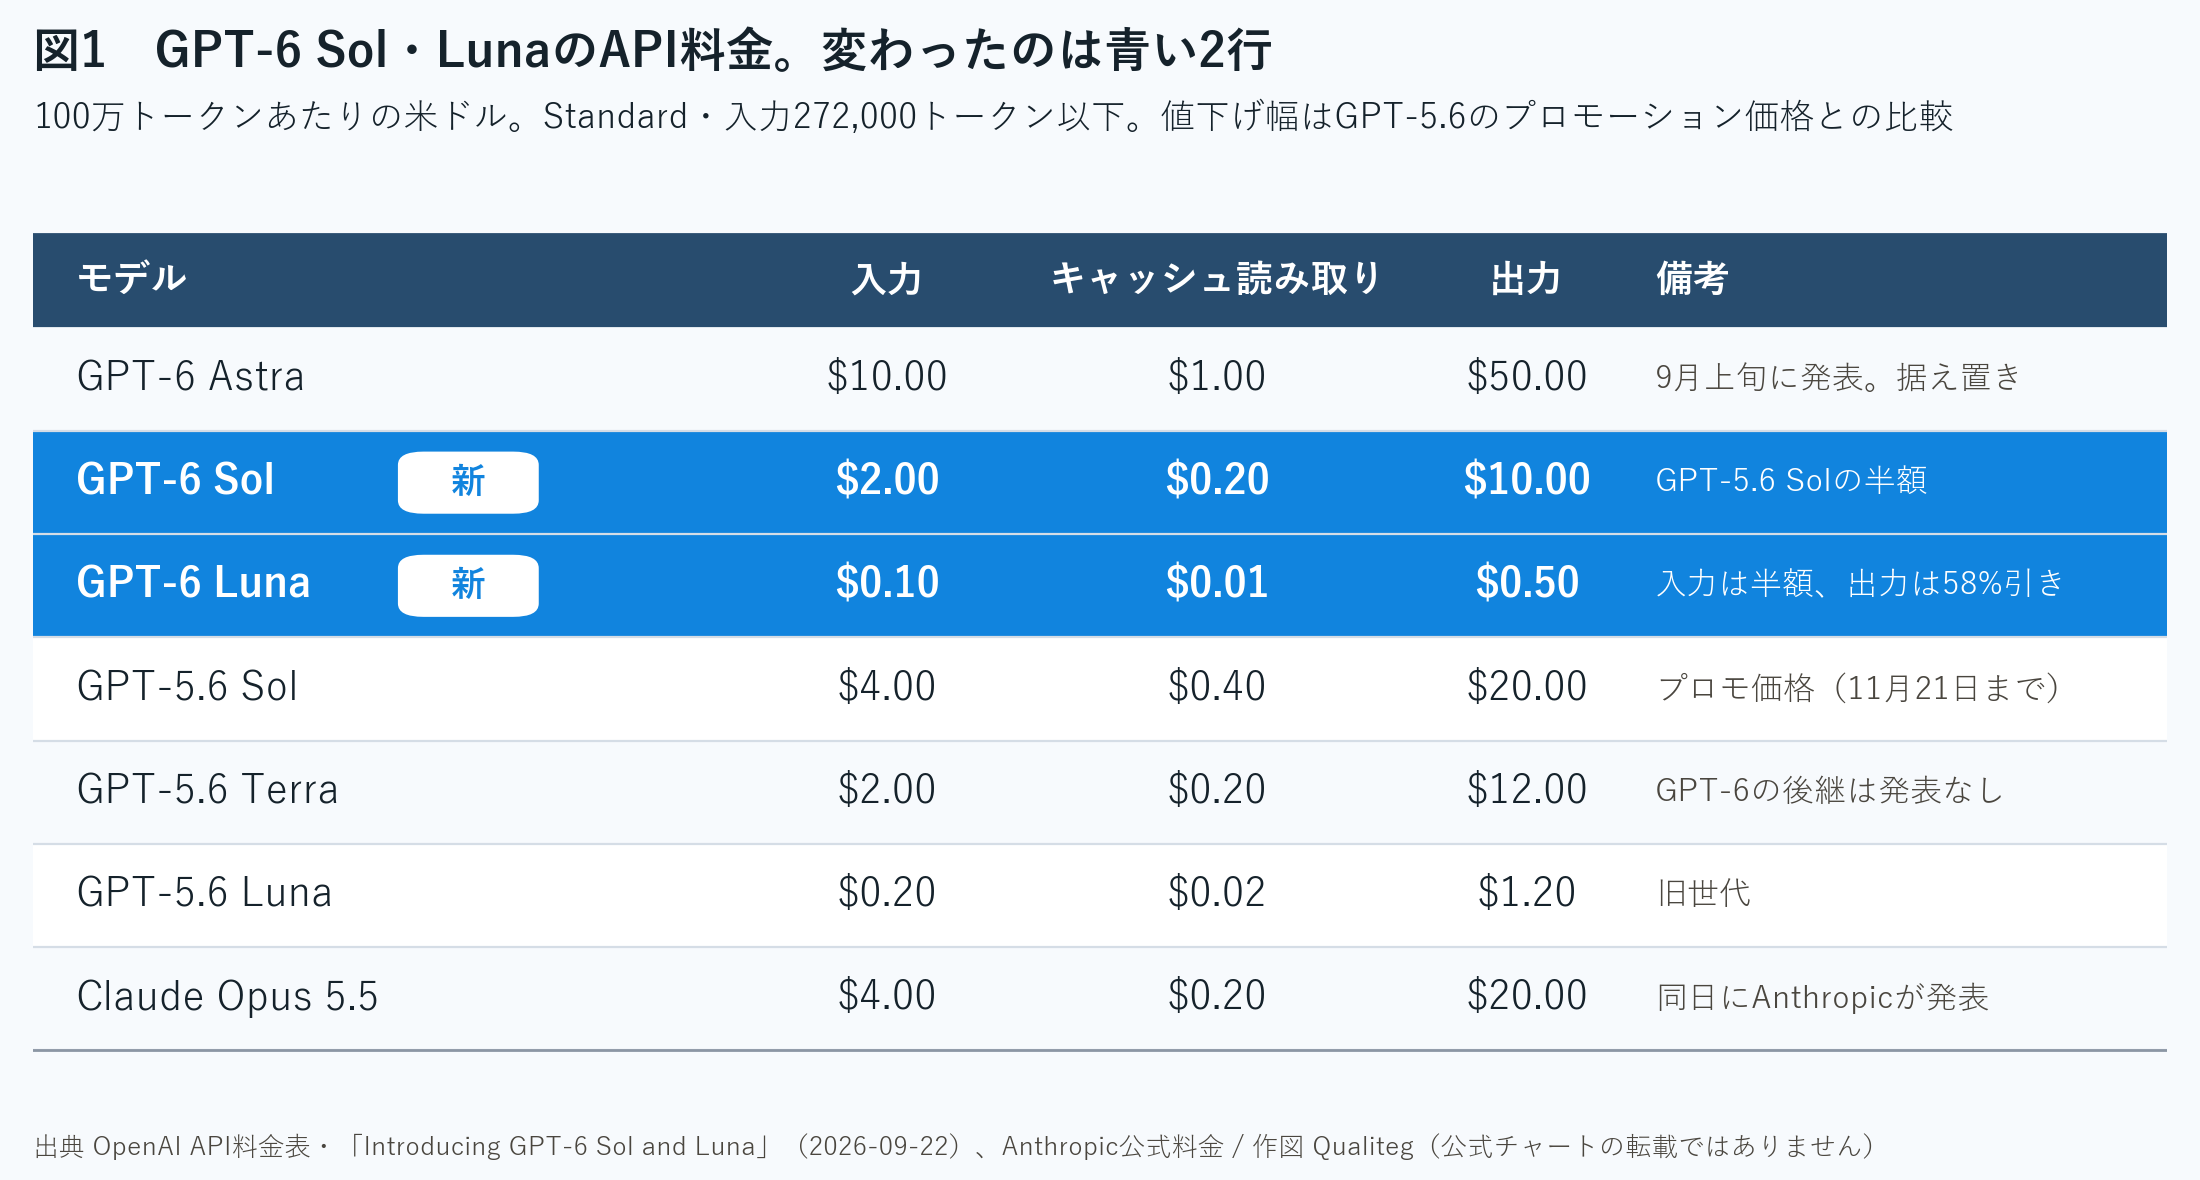
GPT-6 Solは入力$2・出力$10で、GPT-5.6 Solのプロモーション価格から半額です。GPT-6 Lunaは入力$0.10・出力$0.50。Astraと比べると、Solは5分の1、Lunaは100分の1の単価になります。
当ブログでは9月6日の記事「GPT-6 AstraはAGIなのか Claude Fable 5.1との違い・料金・仕事への影響を解説」で、AstraのAPI単価を「Solの2.5倍」と書きました。この前提が変わったわけです。
同じ日には、AnthropicがClaude Opus 5.5も発表しています。Sol・Luna・Opus 5.5をどう比べればよいのかも、この記事で整理します。
この記事は、OpenAIの公式発表と公式ドキュメント(モデル仕様・料金表・移行ガイド・システムカード)を主な根拠にしています。ベンチマークはOpenAIの公表値(ベンダー主張)と独立評価を分けて書きます。当社ではSol・Lunaをまだ手元で検証していません。
長編なので、頭から通読する必要はありません。気になる章だけ拾い読みしてください。
目次
第1部 GPT-6 Sol・Lunaとは何か
第2部 APIで使うときの注意点
- 5. 移行ガイドで変わる点
- 6. 推論量noneが使えるのはSolとLunaだけ
- 7. Chat Completionsで推論ありのツール呼び出しはできない
- 8. キャッシュまわりの新機能
- 9. 入力272,000トークンを超えるとリクエスト全体が割増になる
- 10. Batch・Flex・Fast modeとデータレジデンシー
- 11. 前回記事の試算をSol・Lunaで更新する
第3部 どこで使えて、どう評価されているか
- 12. ChatGPT・Codex・Copilot・Azureでの提供状況
- 13. 安全性はAstraのシステムカードの付録で公開された
- 14. 独立評価では「賢さは据え置き、費用は半分」
- 15. 第三者の実地の声
- 16. 同日発表のClaude Opus 5.5との比べ方
GPT-5.6 Sol・Lunaからのアップデート、ざっくり
詳しくは各章で扱いますが、まず全体像です。
API単価が半額になった
Solは入力$4→$2、出力$20→$10。Lunaは入力$0.20→$0.10、出力$1.20→$0.50です。OpenAIの広報はVentureBeatに対して「プロモーションではなく恒久価格」と答えています(第3章)。
Astraと同じ手法で訓練された
公式発表は「GPT-6 Astraと同様の手法で訓練した」と説明しています。専門業務・事実性・コーディング・コンピュータ操作・アラインメントの進歩を、速く安いモデルへ持ち込んだという位置づけです(第1章)。
GPT-6 Terraは出ていない
GPT-5.6にあった中間のTerraは、GPT-6では発表されていません。GPT-6は上からAstra・Sol・Lunaの3段です(第1章)。
推論量noneに対応した
Sol・Lunaはreasoning_effortのnoneに対応しています。Astraはnone非対応なので、ここはAstraとの違いです(第6章)。
キャッシュが効きやすくなった
既定のキャッシュヒット率が上がり、推論量の変更やツールの切り替えでキャッシュが壊れなくなりました。診断ツールとダッシュボードも加わっています(第8章)。
回答が短く、はっきりした
Astraで改善された話し方がSol・Lunaにも入りました。専門用語や曖昧な言い回しが減り、全体に少し短くなります(第4章)。
独立評価では前世代と同じ水準
Artificial AnalysisのCoding Agent IndexはSolが+2、Lunaが−2でした。評価ごとに進歩と後退が混ざっています(第14章)。
ベンチマークの一部ではGPT-5.6 Solの最高値を下回る
公式図から読み取ると、DeepSWEとOSWorldではGPT-6 Solの最高値がGPT-5.6 Solの最高値より低くなっています(第4章)。
第1部 GPT-6 Sol・Lunaとは何か
1. GPT-6ファミリーはAstra・Sol・Lunaの3段になった
公式発表の位置づけはシンプルです。
Astraは「引き続き全方位で最良のモデル」で、最高の結果が欲しい仕事に使うもの。SolとLunaは、そのAstraで得た進歩を、より速く安い形で配るためのモデルです。
GPT-5.6世代はSol・Terra・Lunaの3段でした。GPT-6ではその上にAstraが乗り、Terraの後継は出ていません。
| モデル | 位置づけ | API単価(入力/出力) | 情報の確度 |
|---|---|---|---|
| GPT-6 Astra | 最上位。全方位で最良 | $10/$50 | 公式発表・料金表 |
| GPT-6 Sol | Astraより安い高性能モデル | $2/$10 | 公式発表・料金表 |
| GPT-6 Luna | 最速・最安 | $0.10/$0.50 | 公式発表・料金表 |
| GPT-6 Terra | 発表なし | なし | 公式発表に記載なし |
システムカードでの言い方は、Solが「Astraに代わる高性能で低コストな選択肢」、Lunaが「これまでで最も速くコスト効率の良いモデル」です。
Terraについては、公式の廃止告知はありません。
ただ、GPT-5.6 Terraは入力$2・出力$12で、GPT-6 Solは入力が同じ$2で出力が$10です。Solのほうが出力は安く、世代も新しいので、Terraは事実上役目を終えたとみられます(Simon Willisonなど第三者の見方です)。
GPT-5.6のSol・Terra・Lunaは、9月23日時点でOpenAIの廃止予定ページに載っていません。すぐ使えなくなるわけではないので、移行は自分のペースで進められます。
2. 基本仕様の早見表
公式のモデル仕様ページから、SolとLunaの仕様を前回記事のAstraと並べます。
| 項目 | GPT-6 Sol | GPT-6 Luna | GPT-6 Astra | 情報の確度 |
|---|---|---|---|---|
| モデルID | gpt-6-sol | gpt-6-luna | gpt-6-astra | 公式ドキュメント |
| コンテキストウィンドウ | 1,050,000トークン | 1,050,000トークン | 1,050,000トークン | 公式ドキュメント |
| 最大入力 | 922,000トークン | 922,000トークン | 922,000トークン | 公式ドキュメント |
| 最大出力 | 128,000トークン | 128,000トークン | 128,000トークン | 公式ドキュメント |
| 入力 | テキスト・画像 | テキスト・画像 | テキスト・画像 | 公式ドキュメント |
| 出力 | テキスト | テキスト | テキスト | 公式ドキュメント |
| 知識の基準日 | 2026年4月20日 | 2026年5月18日 | 2026年4月30日 | 公式ドキュメント |
| 推論量 | none・low・medium(既定)・high・xhigh・max | Solと同じ | low・medium・high・xhigh・max | 公式ドキュメント |
| エンドポイント | Chat Completions・Responses・Batch | Solと同じ | 本記事では未確認 | 公式ドキュメント |
コンテキスト長と最大出力は3モデルとも同じです。大きな資料を載せられる量は、どれを選んでも変わりません。
目を引くのは知識の基準日です。
最も新しい知識を持つのは、いちばん安いLunaです。
Lunaの基準日は2026年5月18日で、Astraの4月30日、Solの4月20日より新しくなっています。新しいライブラリの話題などで差が出る可能性はありますが、基準日が新しいことが個々の答えの正しさを保証するわけではありません。
機能とツールは、Sol・Lunaとも同じものに対応しています。
機能はstreaming・structured outputs・function calling・file search・image input・web search・prompt cachingです。ツールはweb search・file search・image generation・code interpreter・hosted shell・apply patch・skills・computer use・MCP・tool searchに対応しています。
APIのレート制限(Standard)も公式ページに載っています。Lunaは上位Tierで大きく伸びるのが特徴です。
| Tier | GPT-6 Sol(RPM/TPM) | GPT-6 Luna(RPM/TPM) | Luna の Batch 枠 | 情報の確度 |
|---|---|---|---|---|
| Tier 1 | 500/500K | 500/500K | 5M | 公式ドキュメント |
| Tier 2 | 5,000/1M | 5,000/2M | 20M | 公式ドキュメント |
| Tier 3 | 5,000/2M | 5,000/4M | 40M | 公式ドキュメント |
| Tier 4 | 10,000/4M | 10,000/10M | 1B | 公式ドキュメント |
| Tier 5 | 15,000/40M | 30,000/180M | 15B | 公式ドキュメント |
大量の文書を分類する、ログを要約するといった数でこなす仕事では、この枠の広さもLunaを選ぶ理由になります。
3. 料金はGPT-5.6から半額になった
公式発表は、値下げの理由を「キャッシュと推論の改善」と説明しています。配信のコストが下がった分を、そのまま利用者に回したという言い方です。
Standard(入力272,000トークン以下)の料金を並べます。単位は100万トークンあたりの米ドルです。
| モデル | 入力 | キャッシュ読み取り | 出力 | 値下げ幅 | 情報の確度 |
|---|---|---|---|---|---|
| GPT-6 Astra | $10 | $1.00 | $50 | 新モデル | 料金表 |
| GPT-6 Sol | $2 | $0.20 | $10 | 入力・出力とも50% | 料金表 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | 入力50%・出力58.3% | 料金表からの計算 |
| GPT-5.6 Sol | $4 | $0.40 | $20 | プロモ価格 | 料金表 |
| GPT-5.6 Terra | $2 | $0.20 | $12 | 後継なし | 料金表 |
| GPT-5.6 Luna | $0.20 | $0.02 | $1.20 | 旧世代 | 料金表 |
キャッシュ書き込みの単価は、Astraが$12.50、Solが$2.50、Lunaが$0.125です。GPT-5.6はSolが$5.00、Terraが$2.50、Lunaが$0.25です(いずれも料金表)。
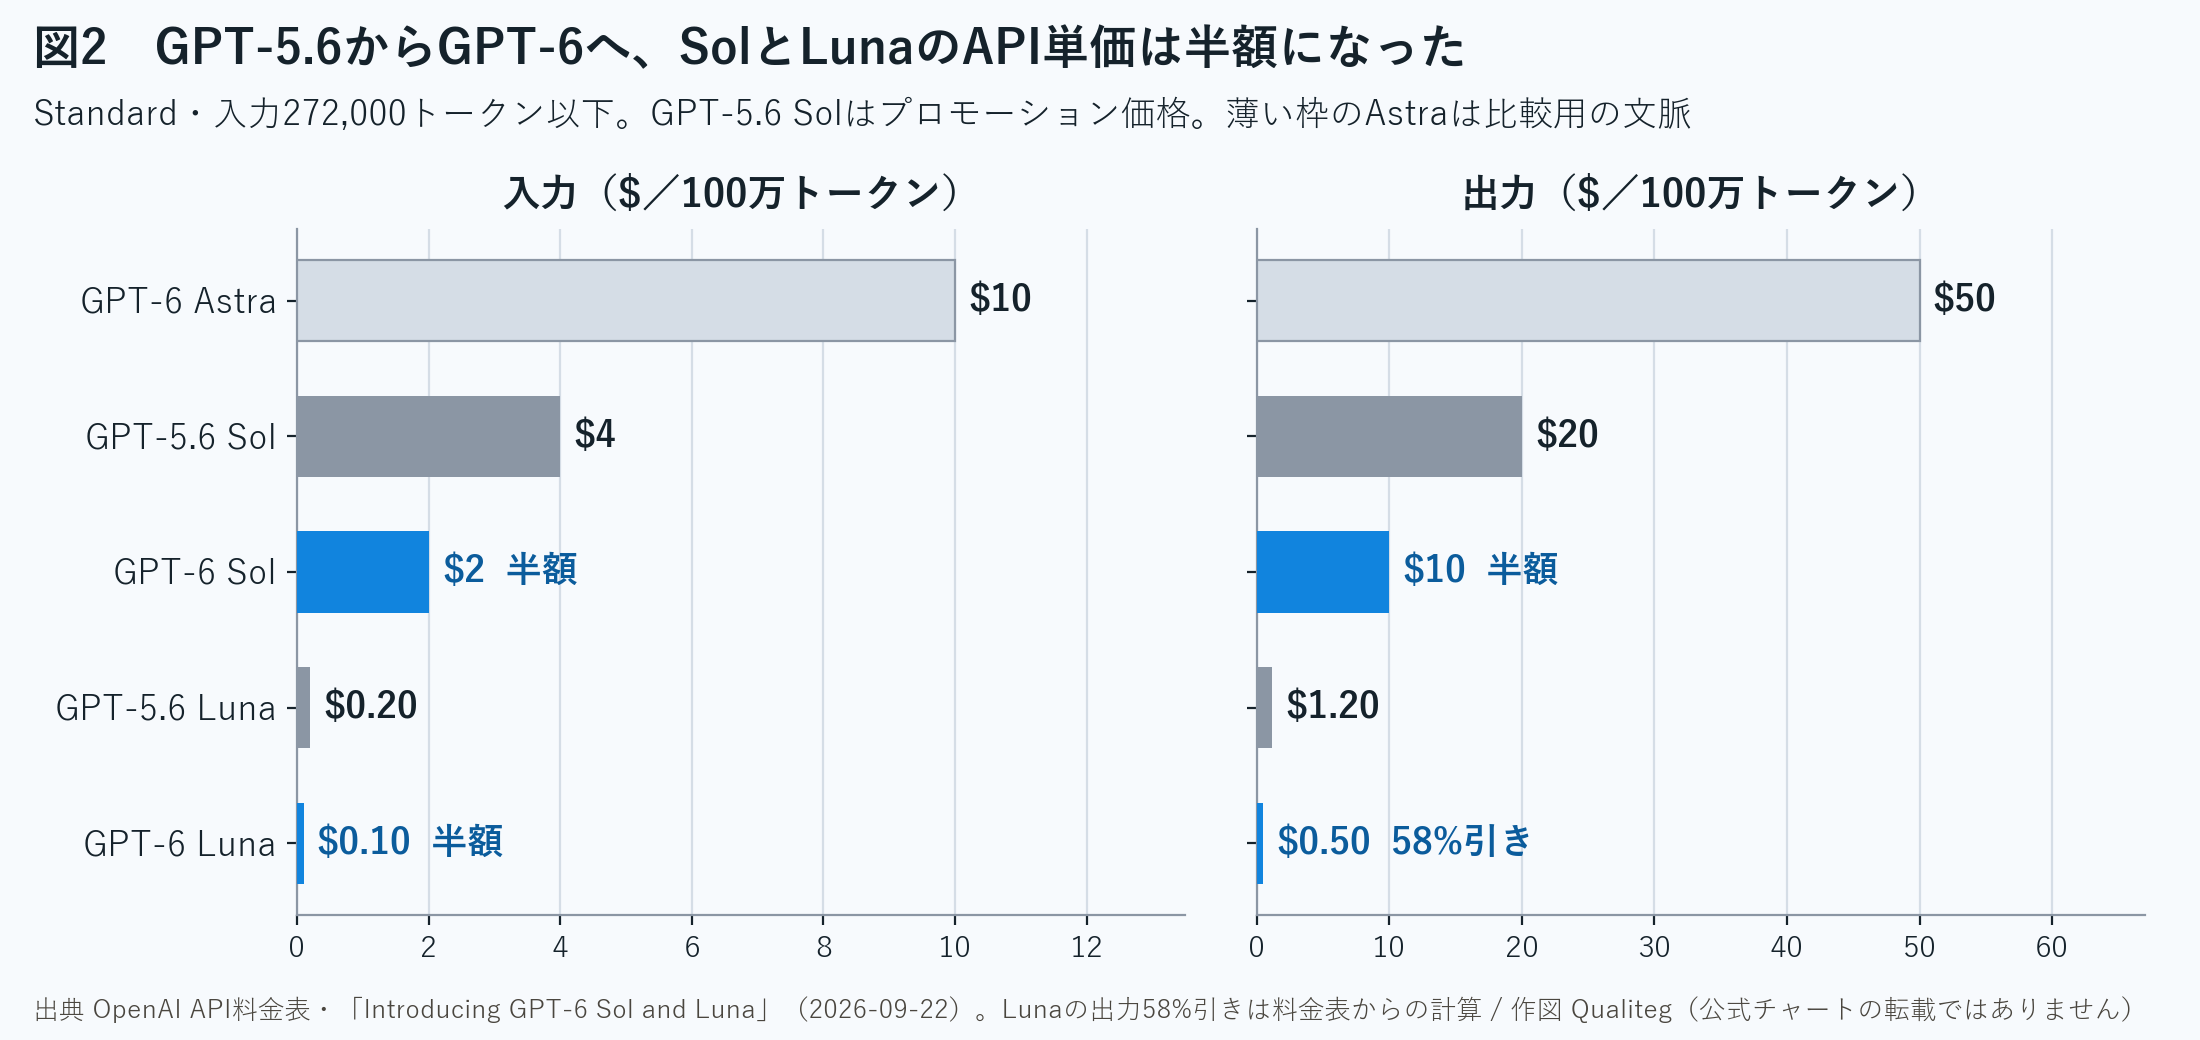
公式発表の表は、Lunaの値下げも「50%」とまとめています。実際に計算すると、出力は$1.20から$0.50なので58.3%の値下げです。出力の多い使い方ほど、Lunaの値下げは効きます。
ひとつ注意があります。
GPT-5.6 Solの$4・$20は、もともとプロモーション価格でした。料金表には「少なくとも2026年11月21日まで」とあります。
つまり「GPT-5.6の定価から半額」ではなく「GPT-5.6の割引価格からさらに半額」です。GPT-6側は、OpenAI広報がVentureBeatの取材に「恒久価格でありプロモーションではない」と答えています。
前回記事では「AstraはSolの2.5倍」と書きました。GPT-6どうしで比べると、AstraはSolの5倍、Lunaの100倍です。
Astraを選ぶ理由は、単価の差が縮んだのではなく、広がったことになります。
4. OpenAIの公表ベンチマークは費用と一緒に読む
ここからの数字は、すべてOpenAIが公表したものです。競合の値は「公開レポートから取った」と公式に注記があり、Claude Fable 5.1の値が無い評価ではFable 5の値を使っています。
今回の発表の特徴は、スコアと一緒に「1タスクあたりの費用」を必ず並べていることです。安さを売りにするモデルなので、同じ点数をどれだけ安く出せるかが主張の中心になっています。
業務フローのAutomationBench
47のツールを使って、営業・マーケティング・運用・サポート・財務・人事の業務を最後までこなす評価です。公式本文に載った比較表はこうなっています。
| モデル(推論量) | スコア | 1タスクの費用 | 情報の確度 |
|---|---|---|---|
| GPT-6 Sol(xhigh) | 33.2% | $0.27 | OpenAIの公表値 |
| GPT-6 Astra(low) | 30.3% | Solの3.9倍 | OpenAIの公表値 |
| Claude Opus 5(max) | 26.9% | Solの11.1倍 | OpenAIの公表値 |
| Claude Fable 5.1 Opus 5 fallback付き(max) | 31.4% | Solの8.9倍超 | OpenAIの公表値 |
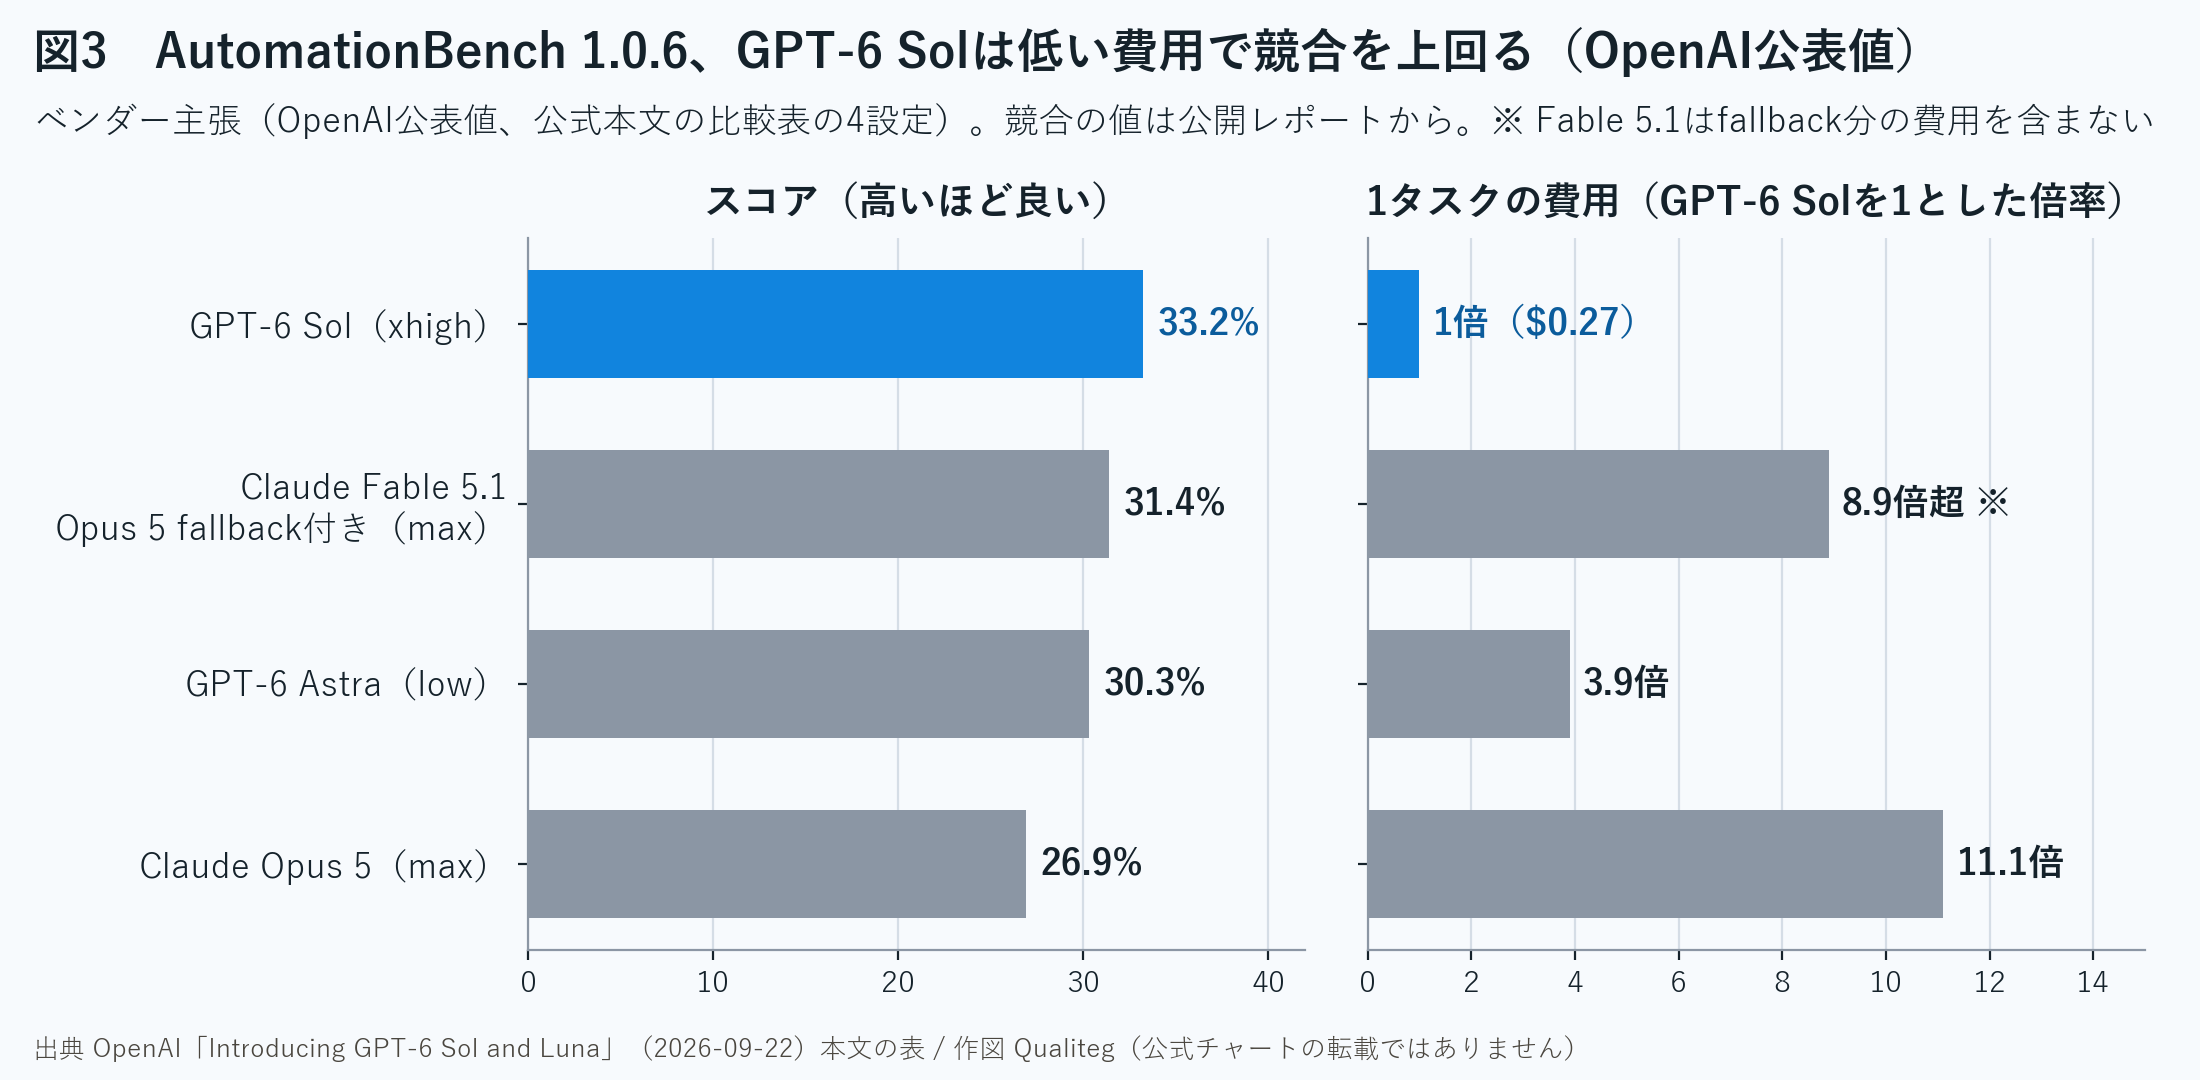
OpenAIの言い方は「Opus 5の9%の費用で上回る」です。Fable 5.1の費用には、約40%のタスクで発生したOpus 5へのfallback分が入っておらず、実際はもっと高いと注記されています。
Lunaは高い推論量(high)で、GPT-5.6 Lunaより5.4ポイント高く、1タスクの費用は58%下がったとされます。
長時間の専門業務のAgents' Last Exam
55の業種にまたがる、コンピュータ上の長い専門業務の評価です。GPT-6 Sol(max)は56.4%で、Claude Opus 5の最高値を上回り、1タスクの費用は60%低いとされます。
事実性(OpenAIの内部評価)
ユーザーが「間違っている」と指摘した実際の会話(個人を特定できない形に加工したもの)をもとにした評価です。GPT-6 Solの誤りは前世代の約半分で、「Astra級の信頼性に近づく」と書かれています。
Lunaも大きく改善し、高い推論量ではGPT-5.6 Solと同じ水準を、約100分の1の費用で出すとされます。
ただし公式自身が「誤りを誘いやすい会話を集めたもので、普段の使い方を代表しない」と注記しています。誤りの絶対的な頻度としては読めません。
コーディングのDeepSWEとFrontierCode
実際のコードベースで長いソフトウェア開発タスクを解くDeepSWE v1.1では、GPT-6 Sol(max)が68.8%でした。Claude Fable 5(xhigh)の69.9%に1.1ポイント差まで迫り、1タスクの費用は約80%低いとされます。
GPT-6 Luna(max)は66.6%で、Opus 5とFable 5のmedium設定と同じくらいです。費用はOpus 5より93%、Fable 5より96%少ないとされます。
マージできるかどうかまで採点するFrontierCode 1.1では、SolがGPT-5.6 Solから大きく伸び、Claude Fable 5.1(xhigh)と同じ水準を「はるかに低い費用で」出したと書かれています。本文には数値が無く、公式図の読み取り値ではSol(max)が49.3%、Fable 5.1(xhigh)が48.7%です。
コンピュータ操作のOSWorld 2.0
GPT-6 Sol(xhigh)が60.5%、Claude Opus 5(medium)が60.3%で、ほぼ同じスコアを約80%低い費用で出したとされます。GPT-6 Luna(max)は、GPT-5.6 Sol(medium)を10分の1の費用で上回ったとされます。
ここまでが公式本文の数字です。
公式の図には、本文で触れていない点も描かれています。図から読み取った値を、最高スコアどうしで並べるとこうなります。
| 評価 | GPT-6 Sol の最高値 | GPT-5.6 Sol の最高値 | GPT-6 Astra の最高値 | 情報の確度 |
|---|---|---|---|---|
| DeepSWE v1.1 | 68.8%(max) | 72.7%(max) | 74.1%(xhigh) | 公式図の読み取り値 |
| OSWorld 2.0 offline | 64.4%(max) | 66.2%(max) | 73.5%(max) | 公式図の読み取り値 |
| AutomationBench | 32.0%(max) | 28.8%(max) | 41.4%(max) | 公式図の読み取り値 |
| Agents' Last Exam | 56.4%(max) | 53.6%(xhigh) | 59.3%(max) | 公式図の読み取り値 |
DeepSWEとOSWorldでは、GPT-6 Solの最高値がGPT-5.6 Solの最高値を下回っています。
費用あたりの効率ではGPT-6 Solが勝っていますが、「予算を気にせず最高点を狙う」使い方なら、GPT-5.6 Solのほうが高い点を出していた評価があるということです。コーディングで最高点が必要ならAstraが別格、というのも図から読み取れます。
もうひとつ、数値の食い違いにも触れておきます。
前回記事では、Astra発表時の公式表にもとづいてGPT-5.6 SolのAutomationBenchを18.1%と書きました。今回の公式図の読み取り値では28.8%です。
両方の発表でGPT-5.6 Solの掲載値が異なるわけですが、差の理由は公開資料からは特定できません。この記事では、この2つの数字を混ぜず、発表時点ごとの値として扱います。前回記事の18.1%はAstra発表時の表の値、今回の28.8%はSol・Luna発表時の図の読み取り値です。
最後に、話し方の変化です。
公式発表は、Astraで改善された話し方をSol・Lunaにも入れたと説明しています。専門用語が減り、妙な言い回しや価値の低い細部が減り、全体に少し短くなるという内容です。
公式の例では、ウェブサイトのデザイン変更を頼まれたGPT-5.6 Solが「bento feel」のような曖昧な言葉を使い、画像ツールに渡したプロンプトまで開示していました。GPT-6 Solは「Reactが要るかを確かめてから変える」と先に言い、デスクトップと狭いモバイル画面、ブラウザの戻る操作まで確認したと、確かめた範囲をはっきり書いています。
回答が短くなったことは、システムカードの医療評価にも表れています。HealthBenchでは回答の平均の長さがSolで約45%、Lunaで約35%短くなり、回答の網羅性を採点する項目のスコアが下がりました(システムカード11.4節)。
短い回答が向く用途と、細部まで書き出してほしい用途があるので、長さが大事な仕事ではプロンプトで長さを指定するのがおすすめです。
第2部 APIで使うときの注意点
5. 移行ガイドで変わる点
GPT-5.6からGPT-6 Sol・Lunaへの移行は、モデルIDを差し替えればおおむね動きます。ただ、公式の移行ガイドにはいくつか注意点があります。
| いまの設定・用途 | GPT-6 Sol・Lunaでどうするか | 情報の確度 |
|---|---|---|
推論量minimalを使っていた(GPT-5.6) | lowから始めて評価する | 公式ドキュメント |
| 推論なしで速く返したい | noneが使える(Astraは非対応) | 公式ドキュメント |
| Chat Completionsでfunction callingを使う | 推論量noneのときだけ使える。推論ありならResponses APIへ | 公式ドキュメント |
推論ありでtemperature・top_p・top_logprobsを送っている | 送らない(Chat Completionsはlogprobsも) | 公式ドキュメント |
Responses APIのincludeにmessage.output_text.logprobsを指定している | 推論ありでは外す | 公式ドキュメント |
prompt_cache_retentionを使っていた(GPT-5.5以前) | prompt_cache_options.ttlの"30m"に置き換える | 公式ドキュメント |
| 会話の途中で推論量を変えたい | configuration_updateを使う(GPT-6共通) | 公式ドキュメント |
| EUデータレジデンシーを使う | Standard処理のみ。Fast modeは使えない | 公式ドキュメント・料金表 |
いちばん引っかかりやすいのは、Chat Completionsでツールを使っている場合です。第7章で詳しく扱います。
6. 推論量noneが使えるのはSolとLunaだけ
Sol・Lunaの推論量は、none・low・medium・high・xhigh・maxの6段です。既定はmediumです。
Astraはnoneに対応していないので、GPT-6ファミリーで推論を完全に切れるのはSolとLunaだけです。
推論なしの設定は、分類・抽出・短い書き換えのように、考える時間より応答の速さが大事な仕事に向きます。システムカードも、Sol・Lunaの幻覚(事実と違う回答)の減り方は「低レイテンシ・低推論量の設定で特に大きい」と書いています。
GPT-5.6でminimalを使っていた場合は、公式ガイドはlowから始めて評価するよう案内しています。noneに落とすかlowに上げるかは、自分のタスクで比べて決めることになります。
7. Chat Completionsで推論ありのツール呼び出しはできない
Sol・LunaをChat Completions APIで使う場合、function callingが使えるのは推論量がnoneのときだけです。
推論を効かせながらツールを使わせたいなら、Responses APIに移る必要があります。
GPT-5.6でChat Completionsのままツールを呼んでいたエージェントは、モデルIDを差し替えただけだと、この制約に当たる可能性があります。
選択肢は2つです。推論なしで足りる処理ならChat Completionsのままnoneで動かす。推論が必要ならResponses APIへ移す。
あわせて、推論ありの設定ではtemperature・top_p・top_logprobsを送らないよう求められています。Chat Completionsではlogprobsも同じ扱いで、Responses APIではincludeのmessage.output_text.logprobsも外します。古いコードでこれらを固定値で送っている場合は、外しておいてください。
8. キャッシュまわりの新機能
今回、OpenAIは料金の値下げとあわせて「GPT-6のためのより良いプロンプトキャッシュ」という別の記事を出しています。
エージェントは同じ指示・ツール定義・過去のやり取りを毎回送り直すので、キャッシュの効き方がそのまま費用と応答速度に響きます。
GPT-6ファミリーでは、既定のキャッシュヒット率が上がりました。30分以内に再利用された共有のプレフィックス(先頭部分)が割引の対象で、キャッシュ読み取りは最大90%引きです。
新しく加わった機能を表にします。
| 機能 | できること | 情報の確度 |
|---|---|---|
| Prompt Caching Dashboard | キャッシュから返った入力の割合と、その推移を見る | 公式ブログ |
| キャッシュ診断ツール | キャッシュが外れた理由と、影響したトークン数を調べる | 公式ブログ |
| 明示的なbreakpoint | どこまでをプレフィックスとして再利用するかを指定する | 公式ブログ |
| 推論量の変更でキャッシュを維持 | configuration_updateで推論量を変えても、それまでの文脈を再利用できる | 公式ブログ |
| ツールの切り替えでキャッシュを維持 | allowed_toolsやtool_choiceのnoneで呼べるツールを絞っても再利用できる | 公式ブログ |
| Prewarming | 起動時に共通の指示やツール定義を先に処理しておく | 公式ブログ |
診断ツールの応答例として、公式ブログにはこういうJSONが載っています(公式ブログの例をそのまま写したもので、当社で実行したものではありません)。
{"prompt_cache_diagnostics":{"type":"cache_miss","reason":"tools_changed","comparison_reusable_tokens":5629,"cache_missed_tokens":5629}}「ツールが変わったので、5,629トークン分のキャッシュが使えなかった」という意味です。
公式ブログの推奨は、ツールの定義・スキーマ・並び順を変えないことです。
使わせたくないツールがあっても定義から消さず、allowed_toolsで呼べるものだけに絞るか、ツールが要らない場面ではtool_choiceをnoneにします。新しい指示は、古いsystemメッセージを書き換えるのではなく、developerメッセージとして末尾に足します。
推論量の変更も同じ考え方です。
リクエスト全体の推論量はそのままにして、configuration_updateを追加して次の応答から推論量を変えます。前回記事でAstraについて紹介した機能が、Sol・Lunaでも使えます。
利用企業の声も紹介されています。GitHubは、過去数か月で「新しく処理し直す必要があったプロンプトトークンの割合」を50%超減らしたとしています。Strawberry Browserは、ヒット率を数ポイント上げただけで費用が20%下がったと話しています。
キャッシュ読み取りの単価は、Solが$0.20、Lunaが$0.01です。たとえばキャッシュに載った20万トークンを100回読む場合、読み取り分はSolで$4、Lunaで$0.20になります(新規入力・書き込み・出力は別。当社の試算です)。前回記事で同じ条件を計算したAstraは$20でした。
9. 入力272,000トークンを超えるとリクエスト全体が割増になる
コンテキストは約105万トークンまで使えますが、料金は入力272,000トークンを境に切り替わります。
しかも割増は超えた分だけでなく、リクエスト全体にかかります。
| モデル | 272K以下(入力/出力) | 272K超(入力/出力) | 272K超のキャッシュ読み取り | 情報の確度 |
|---|---|---|---|---|
| GPT-6 Astra | $10/$50 | $20/$75 | $2.00 | 料金表 |
| GPT-6 Sol | $2/$10 | $4/$15 | $0.40 | 料金表 |
| GPT-6 Luna | $0.10/$0.50 | $0.20/$0.75 | $0.02 | 料金表 |
入力は2倍、出力は1.5倍です。
Solで試算すると差がよく分かります。入力270,000トークンなら入力分は$0.54ですが、300,000トークンなら全体に$4がかかって$1.20です(当社の試算)。3万トークン増えただけで、入力の費用は2倍以上になります。
大きなコードベースや資料を丸ごと載せる設計では、272,000トークンの手前に収まるように分けるか、必要な部分だけを検索して渡す作りにしておくと、この段差を避けられます。
10. Batch・Flex・Fast modeとデータレジデンシー
処理の種類ごとの単価はこうなっています。
| 処理 | GPT-6 Sol(入力/出力) | GPT-6 Luna(入力/出力) | 向いている用途 | 情報の確度 |
|---|---|---|---|---|
| Standard | $2/$10 | $0.10/$0.50 | 通常の利用 | 料金表 |
| Batch | $1/$5 | $0.05/$0.25 | 夜間の一括処理 | 料金表 |
| Flex | $1/$5 | $0.05/$0.25 | 待てる処理 | 料金表 |
| Fast mode | $4/$20 | $0.20/$1.00 | 目の前で結果を待つ処理 | 料金表 |
BatchとFlexはStandardの半額、Fast modeは2倍です。長文区分(272K超)にも同じ倍率がかかり、Fast modeの長文はSolで$8/$30、Lunaで$0.40/$1.50です。
Fast modeは、2026年7月30日に旧Priority processingから名前が変わったものです。APIではservice_tierに"priority"と"fast"のどちらを指定してもよいとされています。
Sol・LunaのFast modeは料金表に掲載されています。一方、移行ガイドはAstraのFast modeしか説明しておらず、Sol・Lunaでの細かな条件は確認できていません。
データレジデンシー(処理する地域を指定する機能)には2つの条件があります。
2026年3月5日以降に出た対象モデルでは、地域指定のエンドポイントは10%上乗せです。さらにSol・LunaのEUデータレジデンシーはStandard処理だけで、Batch・Flex・Fast modeとは組み合わせられません。
11. 前回記事の試算をSol・Lunaで更新する
前回記事では、入力1万・出力2千トークンのリクエストを例に、Astraが$0.20、GPT-5.6 Solが$0.08と試算しました。同じ条件でGPT-6を計算し直します。
条件はStandard料金、キャッシュなし、ツール料金と地域加算は除外です。出力は推論分を含めた課金対象量として計算しています。
| モデル | 入力分 | 出力分 | 合計 | 情報の確度 |
|---|---|---|---|---|
| GPT-6 Astra | $0.10 | $0.10 | $0.20 | 料金表からの試算(前回記事) |
| GPT-5.6 Sol | $0.04 | $0.04 | $0.08 | 料金表からの試算(前回記事) |
| GPT-6 Sol | $0.02 | $0.02 | $0.04 | 料金表からの試算 |
| GPT-6 Luna | $0.001 | $0.001 | $0.002 | 料金表からの試算 |
| Claude Opus 5.5(参考) | $0.04 | $0.04 | $0.08 | 各社料金からの試算 |
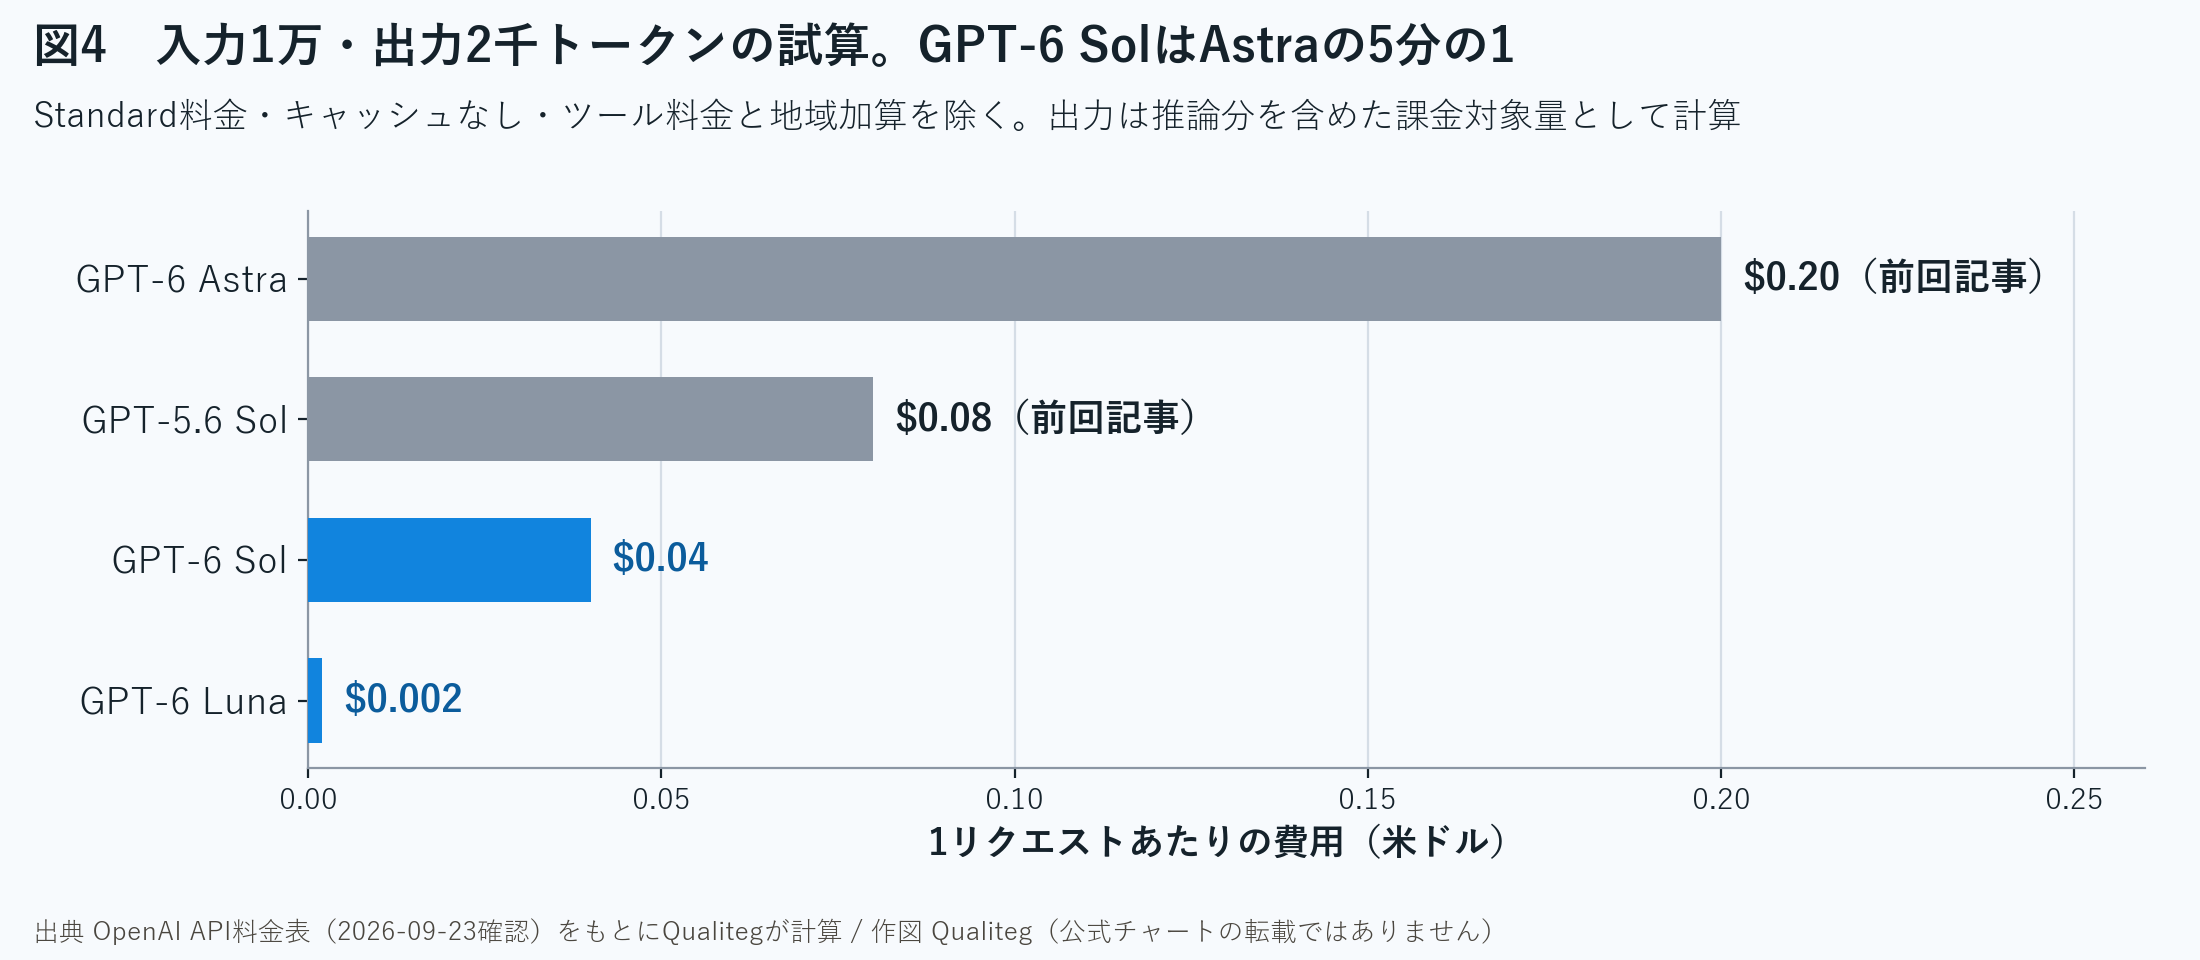
前回記事では「GPT-5.6 Solは合計3回でAstraの1回分を上回る」と書きました。GPT-6 Solは合計5回でAstraの1回分と同額、合計6回でようやく上回ります。Lunaは合計100回で同額です。
単価だけを見れば、Astraを選ぶのは「1回で当てることに5倍の価値がある仕事」に絞られました。
ただし、この試算は1回あたりのトークン量が同じという前提です。第14章で見るとおり、Artificial Analysisの評価ではLunaがGPT-5.6 Lunaより多くの出力トークンを使っていました。実際の費用は、単価と消費トークンの掛け算で決まります。
第3部 どこで使えて、どう評価されているか
12. ChatGPT・Codex・Copilot・Azureでの提供状況
提供先ごとにまとめます。
| 提供先 | GPT-6 Sol | GPT-6 Luna | 情報の確度 |
|---|---|---|---|
| ChatGPT Work・Codex | Plus・Pro・Business・Enterprise・Edu | Plus・Pro・Business・Enterprise・Edu | 公式発表 |
| ChatGPT Free・Go | なし | デスクトップアプリで利用可 | 公式発表 |
| ChatGPT の通常のチャット(Chat) | まだ使えない | まだ使えない | 公式発表 |
| OpenAI API | gpt-6-sol | gpt-6-luna | 公式発表 |
| GitHub Copilot | Pro+・Max・Business・Enterprise | Pro・Pro+・Max・Business・Enterprise | GitHub Changelog |
| Microsoft Foundry(Azure) | Standard・Provisioned Throughput・Priority Processing | Standard | Azure公式ブログ |
| Amazon Bedrock | 未確認 | 未確認 | 未確認 |
ChatGPTではWorkとCodexが先行
公式発表は、Sol・Lunaが「まだChatでは使えない」と明記しています。9月23日時点のヘルプ記事でも、通常のチャットのThinkingはGPT-5.6 Solのままです。ChatGPTでの展開は1日かけて段階的に進めるとされ、見当たらない場合は時間をおいて確かめるよう案内されています。
Codexはクライアントの更新が必要
Codexのchangelogによると、9月22日のCodex CLI 0.156.1でSol・Lunaがモデル一覧に加わりました。利用上限に達したときに表示される切り替えの提案では、GPT-6 Lunaが勧められるようになっています。
Sol・Lunaを選べないときは、まずCLIやデスクトップアプリのバージョンを確かめてください。なお「SolがCodexの既定モデルになった」という記述は第三者のリポジトリに見られますが、公式には確認できていません。
ChatGPT ProのWork・Codexで5時間制限を当面適用しないという運用は、前回記事で紹介しました(2026年8月25日のOpenAI担当者の投稿)。Sol・Lunaでこの扱いが変わったかは確認できていません。
Copilotは従量課金で段階展開
GitHub Copilotでは、SolがPro+以上、LunaがProから使えます。どちらも利用量に応じた課金です。
VS Code・Visual Studio・Copilot CLI・JetBrains・Xcode・Eclipse・github.comなどのモデル選択に出てきます。BusinessとEnterpriseでは、管理者が既定の自動有効化を切っていない限り、新しいモデルは自動で使える状態になります。
GitHubはSolを「対話的なコーディングとエージェント的なコーディングのバランス型」、Lunaを「小さく速い作業向けの軽量モデル」と説明しています。
Azureは直販と同額から
Microsoft Foundryでは、Global Standardの単価がOpenAI直販と同じです。地域を限定するData Zoneは少し高くなります。
| 配備 | GPT-6 Sol(入力/出力) | GPT-6 Luna(入力/出力) | 情報の確度 |
|---|---|---|---|
| Global Standard | $2.00/$10.00 | $0.10/$0.50 | Azure公式ブログ |
| Data Zone US | $2.20/$11.00 | $0.11/$0.55 | Azure公式ブログ |
| Data Zone EU | $2.40/$12.00 | $0.12/$0.60 | Azure公式ブログ |
Standard配備は28のGlobalリージョンとUS・EUのData Zoneで使えます。Provisioned ThroughputはAstraとSol、Priority ProcessingはSolが対象です。
Amazon Bedrockについては、料金表に「OpenAIモデルはAWS経由で課金され、商用リージョンでは直販と同額」という注記があります。ただ、Sol・LunaがBedrockで提供されているかは確認できていません。
13. 安全性はAstraのシステムカードの付録で公開された
公式発表の「システムカードを見てください」というリンクの先は、GPT-6 Astraのシステムカードです。
Sol・Luna専用のシステムカードは出ていません。9月22日に更新されたAstraのシステムカードに、第11章「GPT-6 Sol, GPT-6 Luna」が加わっています。
Preparedness Frameworkの判定
OpenAIが高リスクの能力を測る枠組みでの判定は、こうなっています。
| 領域 | GPT-6 Sol | GPT-6 Luna | GPT-6 Astra | 情報の確度 |
|---|---|---|---|---|
| サイバーセキュリティ | High | High | Critical | システムカード |
| 生物・化学 | High | High | システムカード本編を参照 | システムカード |
| AI自己改善 | High未満 | High未満 | システムカード本編を参照 | システムカード |
Sol・Lunaの判定はGPT-5.6 Sol・Lunaと同じで、同じセーフガードが適用されています。サイバーでCriticalに達したAstraとは扱いが違います。
システムカードは「GPT-6 Solのサイバー能力はGPT-5.6 Solと同程度で、はっきりした向上はない」「LunaはSolを下回る」と書いています。
たとえば2026年6〜8月に公開された新しい脆弱性で攻撃コードを作れるかを見る評価では、Solの最高が5.5%、Lunaは0%でした。Astraは31.5%です。
アラインメントはGPT-5.6から大きく改善
意図的に難しい状況を用意して、モデルがごまかしや指示違反をしないかを見る評価です。公式は「普段の使い方での失敗率ではない」と注記しています。
| 評価 | GPT-6とGPT-5.6の比較 | 情報の確度 |
|---|---|---|
| コーディングでのごまかし | GPT-5.6 Solの発生率はGPT-6 Solの約8倍、GPT-5.6 LunaはGPT-6 Lunaの3倍超 | システムカード |
| 壊れた検索ツールを申告しない | GPT-5.6 Solの失敗率はGPT-6 Solの約16倍、GPT-5.6 LunaはGPT-6 Lunaの約3倍 | システムカード |
| 自動レビュアーの拒否をかわそうとした | GPT-6 Solは試行なし、GPT-6 Lunaは試行したが成功せず。GPT-5.6はSolが7.3%、Lunaが4.3%で試行 | システムカード |
| ハニーポット(わざと置いた抜け道)の悪用 | GPT-6 Sol・Lunaとも試行なし。GPT-5.6 Lunaは19.7%で試行、9.9%で成功 | システムカード |
| 外部エージェントの掲示板での不正操作 | GPT-6 Solは26%で交信、11%で不正操作。GPT-6 Lunaはどちらも0。GPT-5.6 Solは84%で交信、52%で不正操作 | システムカード |
「access denied」のような警告をかいくぐろうとする評価では、Lunaは大きく改善した一方、Solの改善は「わずか」とされています。ここは改善の小さい項目です。
OpenAI社内のCodexの利用を再現した50,319タスクのシミュレーションでは、重大度3以上のフラグがGPT-5.6 Solの66件(0.131%)からGPT-6 Solの42件(0.083%)へ、約36%減りました。重大度4はどちらも0件です。
拒否のバランスには細かな後退もある
生物分野の拒否評価では、深刻な質問や両用途の質問への安全な対応が大きく改善しました。その代わり、無害な質問を断ってしまう割合がやや増えています(過剰拒否しない率がGPT-5.6 Solの0.989からSolで0.964、Lunaで0.958)。
サイバー分野では、実際のチャットに近い評価でGPT-5.6 Solの0.983からSolで0.957、Lunaで0.951と「やや後退」しています。
セキュリティの防御業務で使う場合は、Trusted Access for Cyber(Daybreak Blue)の対象者なら、サイバー関連の拒否を減らした状態でSol・Lunaを使えるとされています。
14. 独立評価では「賢さは据え置き、費用は半分」
独立評価機関のArtificial Analysisは、発表当日に評価結果を出しました。見出しは「GPT-6 Sol・Lunaはコスト効率の最前線を押し広げる」です。
一方で本文の評価は冷静で、Intelligence IndexとCoding Agent IndexはGPT-5.6と同じ水準、評価によって進歩と後退が混ざっている、としています。
| 指標 | GPT-6 Sol(max) | GPT-5.6 Sol(max) | GPT-6 Luna(max) | GPT-5.6 Luna(max) | 情報の確度 |
|---|---|---|---|---|---|
| Coding Agent Index | 57 | 55 | 41 | 43 | 独立評価 |
| Terminal-Bench 4.0 | 43% | 37% | 未確認 | 未確認 | 独立評価 |
| SWE-Atlas-QnA | 58% | 54% | 44% | 49% | 独立評価 |
| DeepSWE v1.1 | 未確認 | 未確認 | 64% | 66% | 独立評価 |
| Intelligence Indexの実行費用 | $1.06 | $1.99 | $0.07 | $0.18 | 独立評価 |
| 出力トークン数 | 31k | 29k | 51k | 41k | 独立評価 |
| AA-Omniscienceの誤答率 | 60% | 92% | 77% | 93% | 独立評価 |
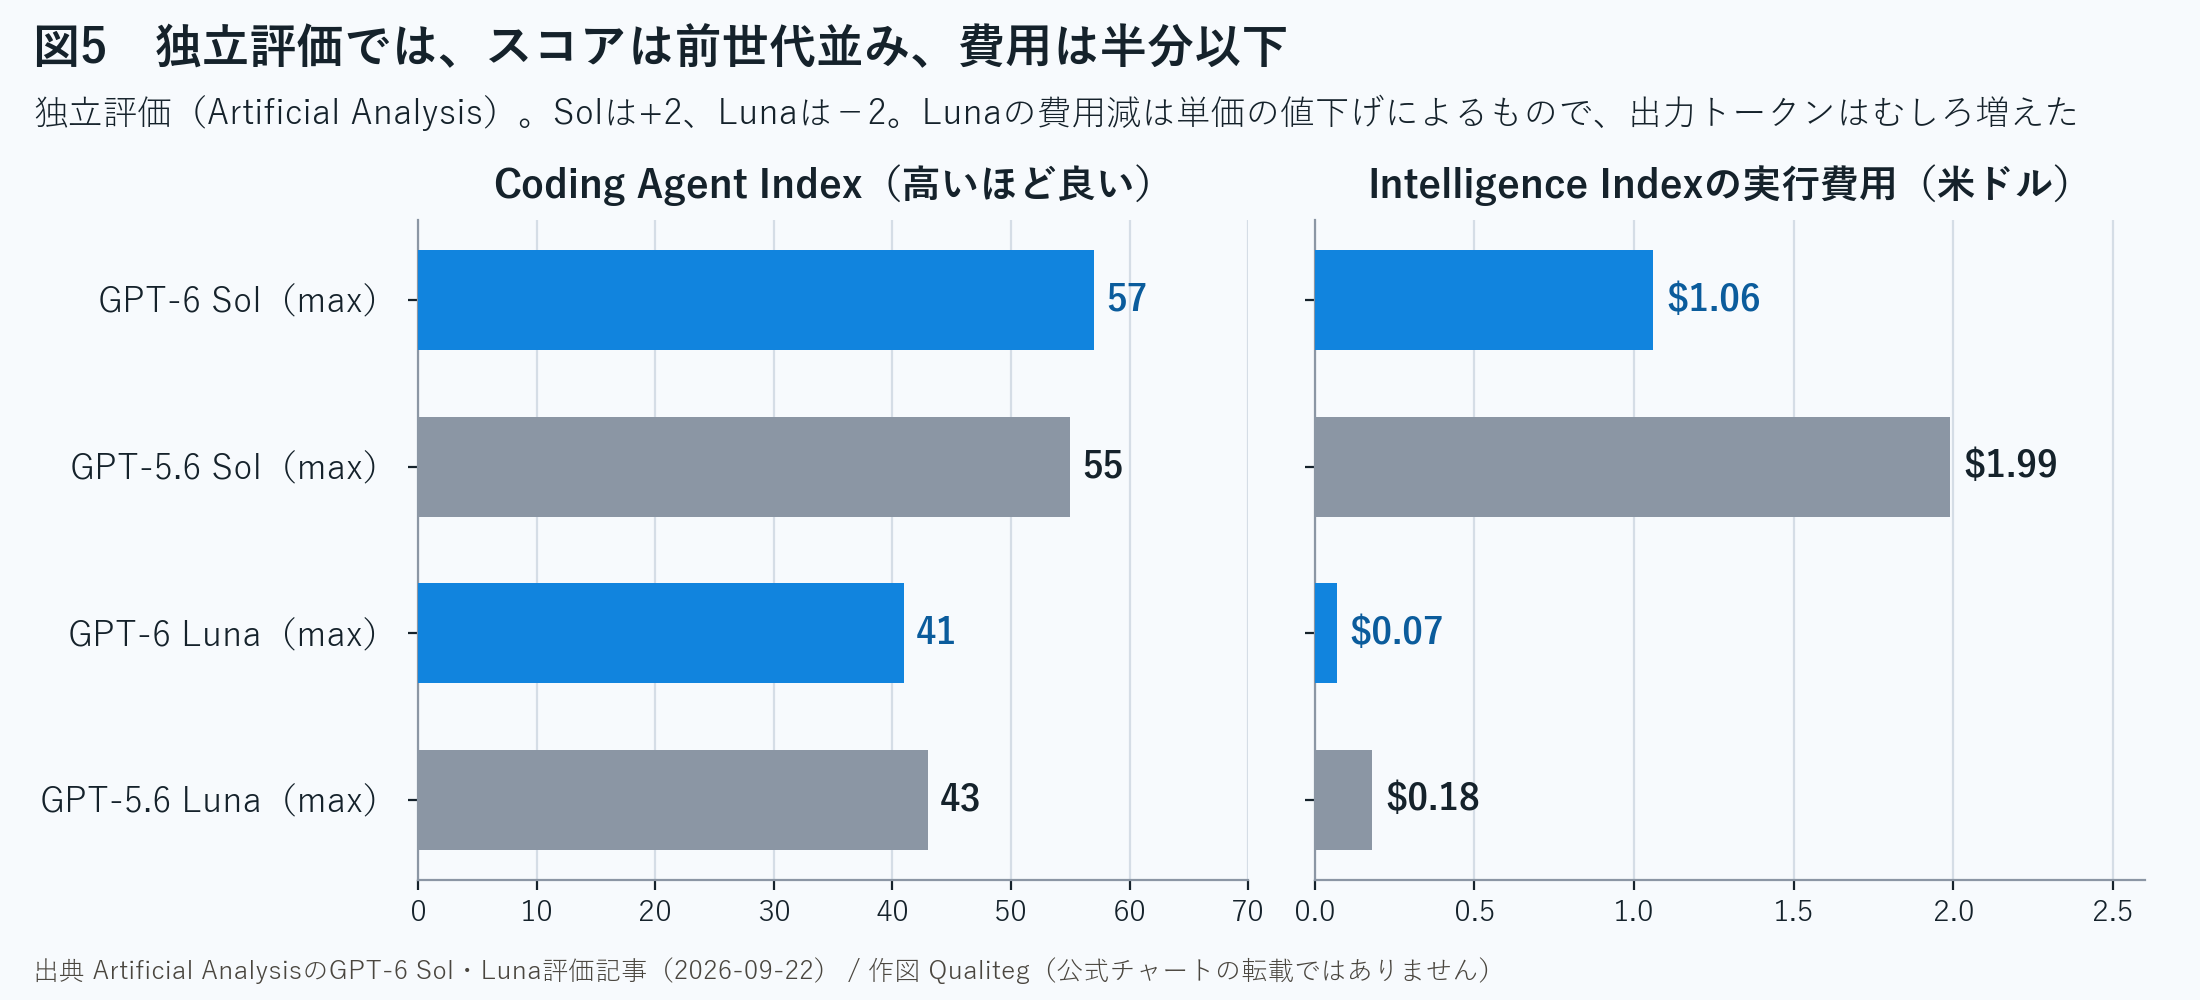
Solはコーディング系の指数でわずかに伸び、評価全体を回す費用は約半分になりました。
Lunaは指数がわずかに下がり、費用は約60%減っています。ただし出力トークンは41kから51kに増えていて、費用が下がったのは単価の値下げのおかげです。
Lunaは、多く考えて安い単価で払うモデルになったと読めます。
1トークンあたりは安くても、長く考える分は消費量に表れます。第11章の試算は1回あたりのトークン量を同じとしているので、実際の費用はこの分だけ試算より上に出る可能性があります。
OpenAIの事実性評価と同じ方向の結果が、ハルシネーション(誤答)率に出ている点も見逃せません。AA-Omniscienceの誤答率は、Solで92%から60%、Lunaで93%から77%に下がっています。
ただし、誤答が減った中身には注意が要ります。
Artificial Analysisによると、Solは質問に答えようとする割合が99%から83%に下がり、全質問に対する正答率も59%から54%へ5ポイント下がりました。誤答が減ったのは、知らないことに答えなくなった分が大きいということです。Lunaの正答率は43%から44%でほぼ同じで、やはり答える割合が減っています。
業務の成果物を採点するGDPval-AA v2.1では、Solが約100ポイント、Lunaが約75ポイント、Eloを落としています。Artificial Analysisは、成果物に必要な項目が抜けやすくなったと見ています。プレゼン資料などを作らせるAA-Briefcase v1.1でも、Lunaは約45ポイント下がり、Solは横ばいでした。
| 独立評価の項目 | GPT-6 Sol | GPT-6 Luna | 情報の確度 |
|---|---|---|---|
| AA-Omniscienceで答えようとする割合 | 99%→83% | 減少(数値は未確認) | 独立評価 |
| 全質問に対する正答率 | 59%→54% | 43%→44% | 独立評価 |
| AA-Omniscience Index | 22→27 | −10→1 | 独立評価 |
| GDPval-AA v2.1(Elo) | 約100ポイント低下 | 約75ポイント低下 | 独立評価 |
| AA-Briefcase v1.1(Elo) | 横ばい | 約45ポイント低下 | 独立評価 |
OpenAIの公表値だけを見ると「全面的に良くなった」ように見えます。独立評価を重ねると、実像はこうなります。API単価と評価タスクの費用は半分以下に下がり、総合指数はおおむね同水準。一方で、答えを控える傾向が強まり、業務成果物の評価では後退も見られます。
安さを取りに行く移行では、自分の用途で「答えを控えること」と「成果物の抜け」が問題にならないかを、先に確かめておくのがおすすめです。
日本語での性能は、まだ独立評価が出ていません。当ブログの日本語対応LLMランキング2026では9月1日版でGPT-5.6 Sol・Terra・Lunaを扱いました。GPT-6 Sol・Lunaは次回の10月版で扱う予定です。
15. 第三者の実地の声
発表から1日で、実際に使った人の報告も出始めています。当社はまだ手元で検証していないので、ここでは第三者の報告として紹介します。
Simon Willisonの報告
LLMの検証記事で知られるSimon Willisonは、発表当日にSol・LunaとOpus 5.5をまとめて試した記事を出しています。
Codexの既定モデルをGPT-6 Solに、Claude Codeの既定をOpus 5.5に切り替えたそうです。自作のDatasette AgentのデモをGPT-6 Lunaに切り替えたところ、SQLやHTML・JavaScriptの生成で「速くて有能」だったと書いています。
恒例の「自転車に乗ったペリカンのSVG」を描かせるテストでは、GPT-6はGPT-5.6より色使いが地味で、OpenAIのモデルではAstraのmaxが最も良かったとのことです。
同じ記事では、Opus 5.5のmax設定が128Kの出力上限を思考だけで使い切り、何も出力しないまま終わった例も報告されています。2回試して2回とも同じで、1回あたり$2.56、約20分かかったそうです。
また、GPT-6 LunaはOpenAIのモデルの中でも最安クラスで、これより安いのはGPT-4.1 Nano($0.10/$0.40)とGPT-5 Nano($0.05/$0.40)くらいだと指摘しています。
16. 同日発表のClaude Opus 5.5との比べ方
GPT-6 Sol・Lunaの発表は、AnthropicのClaude Opus 5.5の発表からおよそ1時間から1時間半後でした。
まず料金を並べます。
| モデル | 入力 | キャッシュ読み取り | 出力 | 情報の確度 |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | 料金表 |
| Claude Fable 5.1 | $10.00 | $0.25 | $50.00 | 各社公式料金 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 | 各社公式料金 |
| Claude Opus 5 | $5.00 | $0.50 | $25.00 | 各社公式料金 |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 | 料金表 |
| Claude Sonnet 5 | $2.00 | $0.20 | $10.00 | 各社公式料金 |
| Grok 4.7(入力200K以下) | $2.00 | $0.50 | $6.00 | 各社公式料金 |
| Claude Haiku 4.5 | $1.00 | $0.10 | $5.00 | 各社公式料金 |
| Gemini 3.8 Flash(2026年12月31日までの導入価格) | $0.75 | $0.075 | $3.75 | 各社公式料金 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | 料金表 |
競合の単価は各社の公式料金です。Gemini 3.8 Flashは2027年1月1日から入力$1.50・出力$7.50になります。
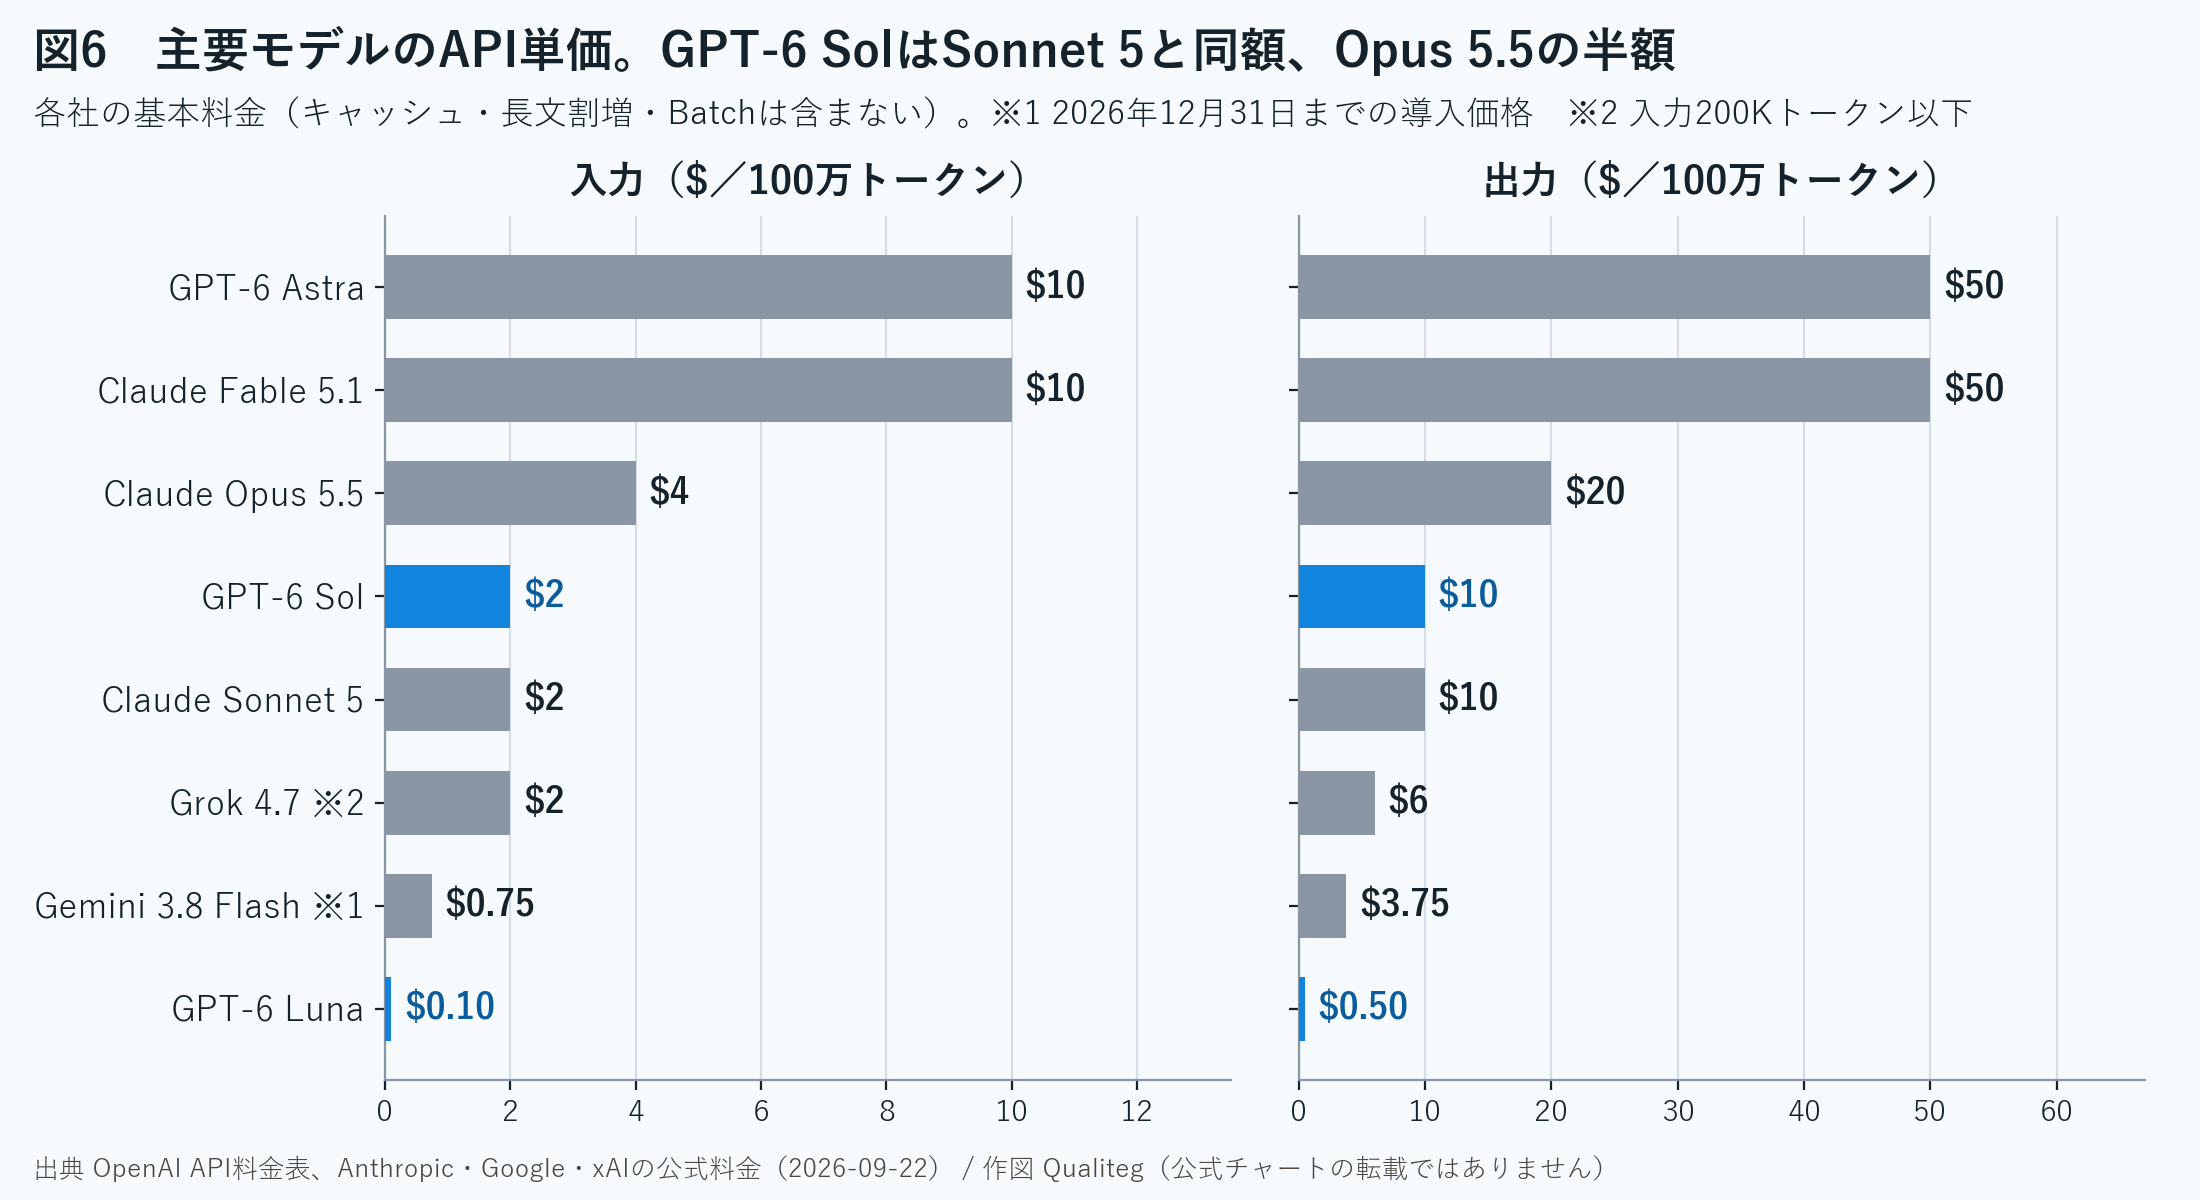
GPT-6 Solは、Claude Opus 5.5のちょうど半額で、Claude Sonnet 5と同額です。キャッシュ読み取りは、SolもOpus 5.5も$0.20で同じです。
GPT-6 Lunaは、Claude Haiku 4.5の10分の1です。Anthropicは数週間以内にSonnet 5.5とHaiku 5.5を出すと予告しているので、この差がどうなるかは次の動きを待つことになります。
性能の比べ方には注意が要ります。
OpenAIの比較図に載っているClaudeはOpus 5・Fable 5・Fable 5.1で、Opus 5.5は入っていません。同じ日の発表なので当然です。
Anthropic側の公表値では、Opus 5.5はAutomationBenchで40.0%、FrontierCode 1.1で54.4%、Terminal-Bench 4.0で66.4%とされています。
この数字を、OpenAIが公表したSolの33.2%(AutomationBench)とそのまま並べるのは避けてください。
両社はそれぞれ自分の環境で、自分で選んだ設定で測っています。評価の版・推論量・ツールの与え方が揃っている保証はなく、両社の公表値を同じ条件で並べ直したベンチマークはまだありません。
同じ条件で見たいなら、独立評価の共通指標を別枠で見るのが確実です。
Artificial Analysisは9月22日にOpus 5.5の評価も公開しており、Intelligence IndexではOpus 5.5(max)が58で首位、GPT-6 Sol(max)は48で、同社のモデル別ページが比較対象とする212モデル中18位です(いずれも独立評価)。同社はOpus 5.5について、Terminal-Bench 4.0とAutomationBench-AAでGPT-6 Astraと並び、エージェント的な知識労働ではリードを広げた、と評しています。
| 指標 | Claude Opus 5.5(max) | GPT-6 Sol(max) | 情報の確度 |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 58(首位) | 48(比較対象212モデル中18位) | 独立評価 |
| API単価(入力/出力) | $4/$20 | $2/$10 | 各社公式料金・料金表 |
つまり、いまの時点で言えるのは、料金ではSolがOpus 5.5の半額、独立評価の総合指数ではOpus 5.5が上ということです。用途ごとの得意不得意は、両社の公表値ではなく独立評価の個別項目で見てください。当ブログのランキング記事でも改めて扱います。
まだわかっていないこと・未確認事項
9月23日時点で確認できていないことを書いておきます。
- ChatGPTの通常のチャット(Chat)でSol・Lunaが使えるようになる時期
- SolがCodexの既定モデルになったかどうか(第三者のリポジトリには記述があるが、公式では未確認)
- GPT-5.6 Terraの今後(廃止の告知は無い)
- Sol・LunaのFast modeの細かな条件(料金表には掲載、移行ガイドの説明はAstraのみ)
- Sol・LunaのAmazon Bedrockでの提供
- ChatGPT ProのWork・Codexでの5時間枠・週枠が、Sol・Lunaでどう扱われるか
- Terminal-Bench 4.0のSol・Lunaの公式値(OpenAIの発表に無い。Artificial Analysisの43%は同社が独自に回したもの)
- Claude Opus 5.5とGPT-6 Sol・Lunaを、AutomationBenchなど両社が公表したベンチマークと同じ課題で、同じ条件で比べた結果(Artificial Analysisの共通指標は公開済み)
- 日本語性能の独立評価(当ブログのランキング10月版で扱う予定)
ベンチマークのうち、公式本文に数値が無く図からの読み取りに頼った値は、表の「情報の確度」列に「公式図の読み取り値」と書いています。読み取りには誤差が出る可能性があります。
まとめ
一言でまとめると「GPT-6 Sol・Lunaは、値段を半分にし、誤答を減らした。総合指数はほぼ据え置きで、答えを控える傾向と業務成果物の後退という交換条件が付いた」。これが今回のリリースの中身です。
前回記事で「Solの2.5倍」と書いたAstraは、GPT-6 Solと比べると5倍、Lunaと比べると100倍になりました。Astraを選ぶ場面は、1回で最高の結果を出すことに大きな価値がある仕事に絞られます。
用途ごとの選び方を表にします。
| 用途 | おすすめ | 理由 |
|---|---|---|
| 最高点が必要な難しいコーディング・画面操作 | GPT-6 Astra | DeepSWE・OSWorldの最高値はAstraが別格(公式図の読み取り値) |
| 日常のエージェント開発・業務フローの自動化 | GPT-6 Sol | Opus 5.5の半額。AutomationBenchで費用あたりの効率が高い(OpenAIの公表値) |
| 大量の分類・抽出・要約 | GPT-6 Luna | 入力$0.10・出力$0.50。Tier 5で180M TPMの枠 |
| 推論なしで速く返したい処理 | GPT-6 Sol・Luna のnone | Astraはnone非対応 |
| 予算を気にせずGPT-5.6 Solの最高点を再現したい | GPT-5.6 Solの継続も検討 | DeepSWE・OSWorldでは最高値がGPT-6 Solより高い(公式図の読み取り値)。プロモ価格は少なくとも11月21日まで |
| Chat Completionsでツールを使っている | 推論なしならそのまま、推論ありならResponses APIへ | 推論ありのfunction callingはResponses APIのみ |
移行のときに見直してほしいのは、次の3点です。
ひとつめは、Chat Completionsでのツール呼び出しです。推論を効かせるならResponses APIへの移行が必要です。
ふたつめは、入力272,000トークンの境目です。超えるとリクエスト全体が割増になるので、資料の渡し方を見直す価値があります。
みっつめは、キャッシュの設計です。ツール定義を消さずにallowed_toolsで絞り、推論量はconfiguration_updateで変える。これだけで、GPT-6のキャッシュ改善をそのまま受け取れます。
今後の見どころは、Opus 5.5との同じ条件での比較、Anthropicが予告しているSonnet 5.5・Haiku 5.5の価格、そしてChatGPTの通常のチャットへの展開です。日本語性能は、当ブログのLLMランキング10月版で確かめます。
それでは、また次回、お会いしましょう!
出典・参考資料
一次情報(OpenAI・GitHub・Microsoft)
- Introducing GPT-6 Sol and Luna(OpenAI公式発表)
- Better prompt caching for GPT-6(OpenAI公式ブログ)
- GPT-6 Solのモデル仕様(OpenAI API公式ドキュメント)
- GPT-6 Lunaのモデル仕様(OpenAI API公式ドキュメント)
- 最新モデルへの移行ガイド(OpenAI API公式ドキュメント)
- API料金表(OpenAI API公式ドキュメント)
- GPT-6 Astraのシステムカード、第11章がSol・Luna(OpenAI Deployment Safety)
- ChatGPTヘルプ記事「GPT-5.6 and GPT-6 Pro in ChatGPT」(OpenAIヘルプセンター)
- Codexのchangelog(ChatGPT Learn)
- OpenAI's GPT-6 Sol and GPT-6 Luna now available(GitHub Changelog)
- Microsoft FoundryでのGPT-6 Astra・Sol・Lunaの提供と料金(Microsoft Azure公式ブログ)
独立評価(評価データの発行元)