Ubuntuの自動更新でカーネルだけ上がり、再起動したらGPUが消えた。NVIDIAモジュールが置き去りになる原因と3つの対策
Ubuntu 24.04のGPUサーバーを再起動したらnvidia-smiが動かない。原因はunattended-upgradesがカーネルだけを更新し、NVIDIAモジュールが依存関係の都合で見送られていたこと。ログで原因を突き止め、1コマンドで復旧し、apt-mark holdを含む3つの再発防止策を比べて採用した記録。
こんにちは!
Ubuntu の GPU サーバーを再起動したら、nvidia-smi が動かない。modprobe nvidia を打つと「Module nvidia not found」。昨日まで 2 枚の GPU が普通に見えていたのに、再起動しただけで消えた。
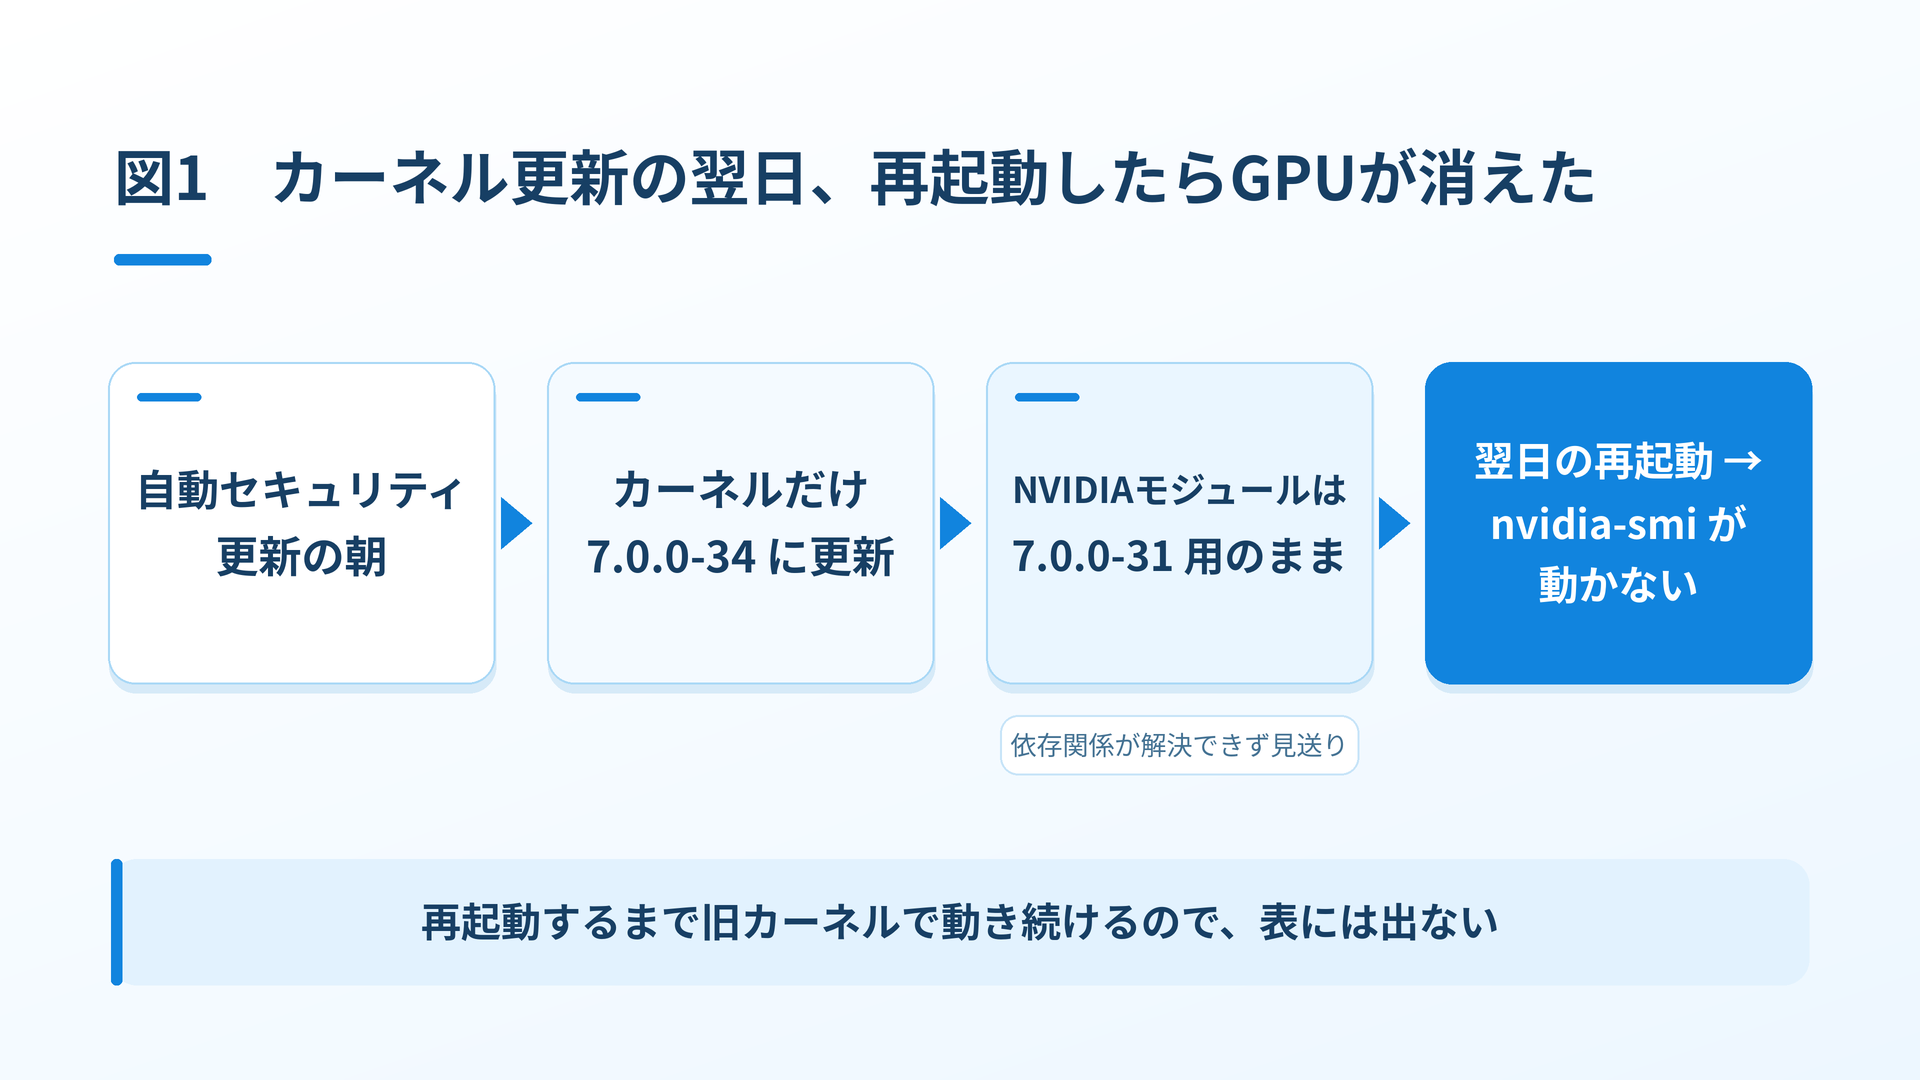
先日、弊社の社内 GPU 機(Ubuntu 24.04.4 LTS・RTX A5000 を 2 枚)で実際に起きた話です。結論から言うと、犯人は Ubuntu の自動セキュリティ更新(unattended-upgrades)でした。カーネルだけが新しい版に上がり、そのカーネル用の NVIDIA モジュールが置き去りになったまま再起動した、というのが今回起きたことです。
この記事では、症状の確認から原因の特定、その場の復旧、そして再発防止の 3 つの選択肢をどう比べてどれを採ったかまでを、手元のログを抜粋しながら書きます。対象は Ubuntu 純正の NVIDIA ドライバ(nvidia-driver-5xx 系)を apt で入れている方です。NVIDIA 公式の .run インストーラを使っている場合は仕組みが違うので、この記事の範囲外とします。
1. 症状は「再起動しただけで GPU が消える」
再起動前は何の問題もありませんでした。GPU ワーカーを載せる前の起動試験として電源を入れ直したところ、ドライバが載っていません。
$ sudo modprobe nvidia
Module nvidia not found in /lib/modules/7.0.0-34-genericここで見るべきはディレクトリ名です。/lib/modules/7.0.0-34-generic。動いているカーネルが 7.0.0-34 になっています。手元の記録では、この機は 7.0.0-28 でセットアップし、その後も自動更新で -29、-30、-31 と上がってきていました。-34 はいつ入ったのか。
$ uname -r
7.0.0-34-generic

$ ls /lib/modules/
7.0.0-28-generic  7.0.0-29-generic  7.0.0-30-generic  7.0.0-31-generic  7.0.0-34-generic  kernel
カーネル -34 が入っていて、それが起動に使われている。ところが、-34 のモジュールディレクトリに NVIDIA のモジュールが無い。1 つ前の -31 にはあります。
$ ls /lib/modules/7.0.0-31-generic/kernel/ | grep nvidia
nvidia-595-open
同じコマンドを -34 に対して打っても、この時点では何も出ません。modprobe のエラーが言っているのはそのことです(復旧後には -34 でも nvidia-595-open が出るようになります)。
なお ls /lib/modules/ に古い版のディレクトリが残っているのは、カーネルパッケージを削除しても索引ファイルだけが残るためです。-28 から -30 は、カーネル本体(linux-image-7.0.0-XX-generic)も NVIDIA モジュール(linux-modules-nvidia-595-open-7.0.0-XX-generic)も自動更新がすでに削除済みで、dpkg -l ではどちらも rc(パッケージは削除され、設定ファイルだけ残っている状態)になっています。この時点で本当に入っていたカーネルは、dpkg -l で ii の -31 と -34 の 2 つでした。
症状はこれで説明がつきます。カーネルは新しくなったのに、そのカーネル用の NVIDIA モジュールが入っていない。
2. Ubuntu の NVIDIA ドライバは「カーネルとモジュールのペア」で動く
原因に入る前に、そもそも論から始めましょう。
Ubuntu 純正の NVIDIA ドライバは、大きく 2 つの部品でできています。ひとつは nvidia-driver-595-open を頂点とするユーザー空間側の一式(ライブラリ・ユーティリティ・nvidia-smi など)。もうひとつがカーネルモジュールで、これは linux-modules-nvidia-595-open-7.0.0-34-generic のようにカーネルの版ごとに別パッケージになっています。カーネルモジュールはそのカーネル専用にビルドされているので、カーネルが -34 に上がったら -34 用のモジュールパッケージが要ります。
この「版ごとのモジュール」を自動で追いかけてくれるのがメタパッケージ linux-modules-nvidia-595-open-generic-hwe-24.04 です。カーネル側にも同じ役目のメタパッケージ linux-image-generic-hwe-24.04 があって、通常はこの 2 つが同時に更新されることで、新しいカーネルと新しいモジュールがペアで入ります。
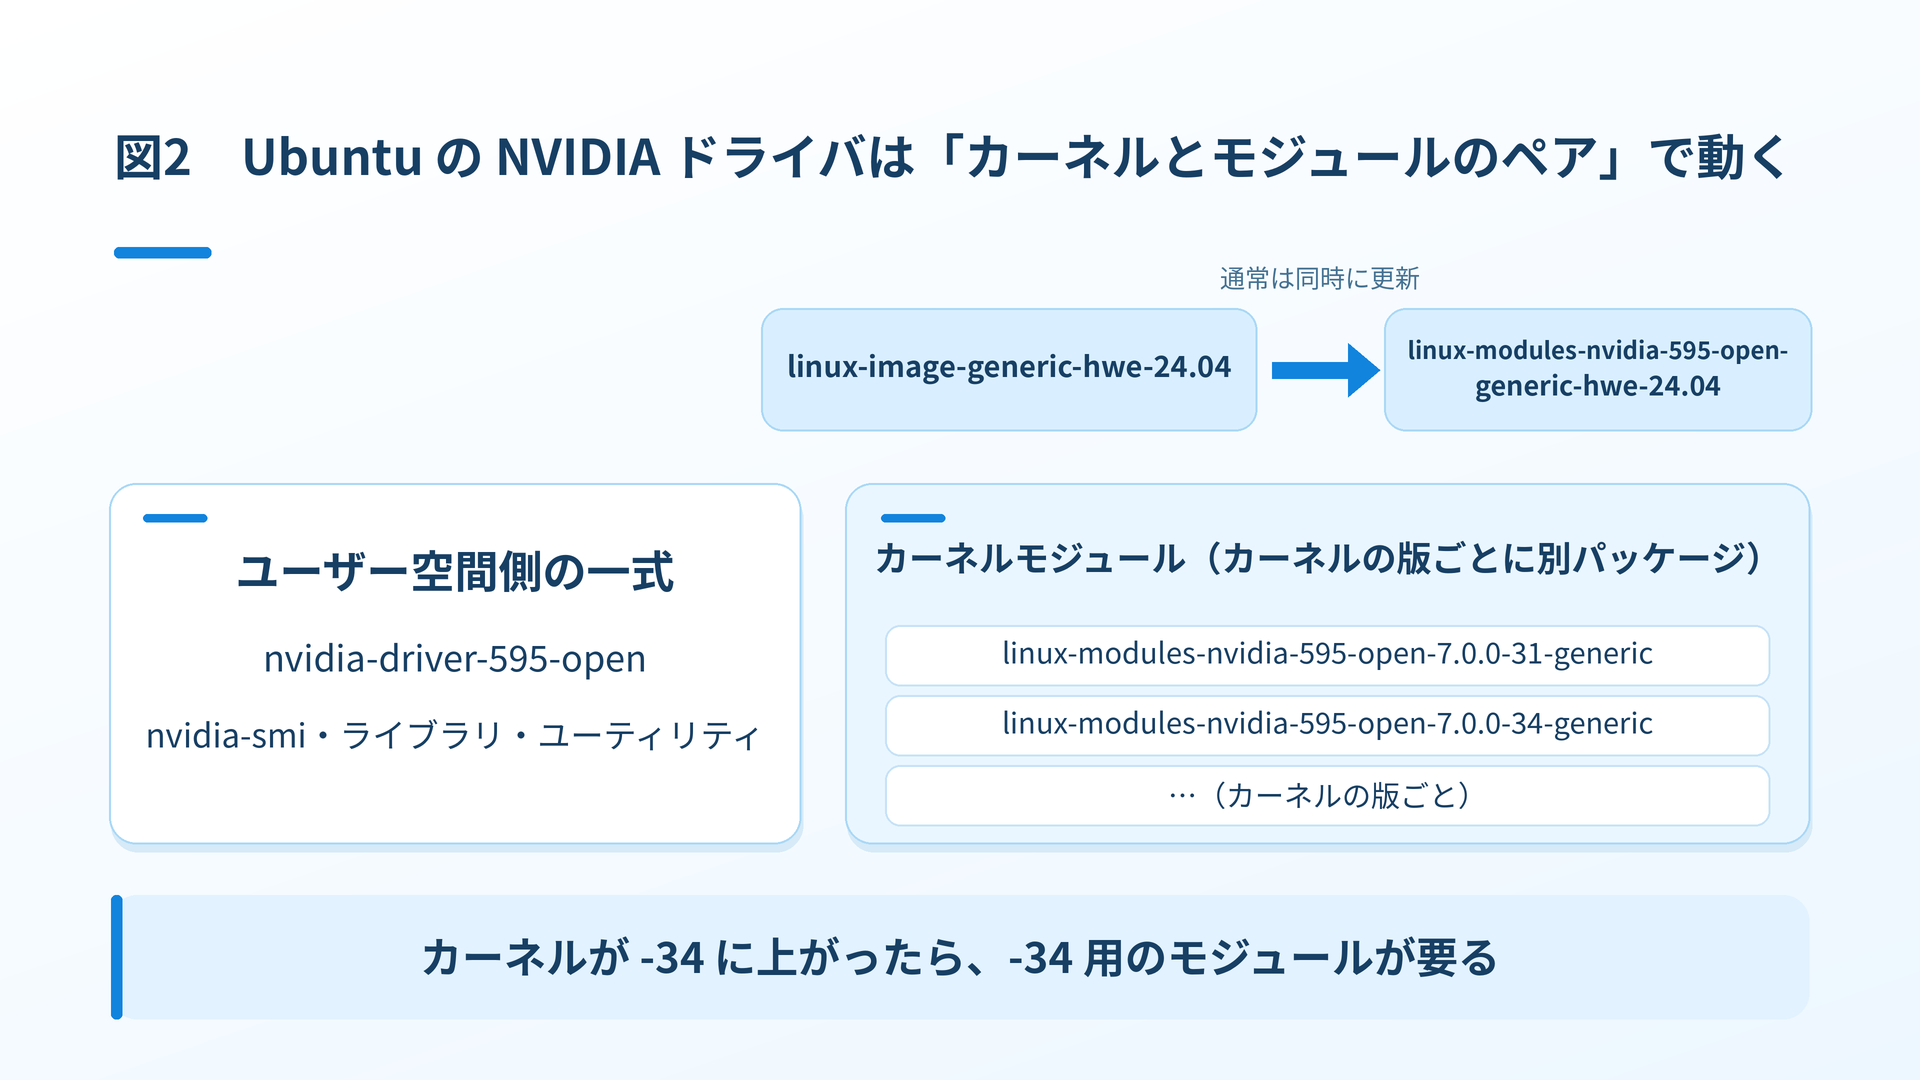
今回はこのペアが崩れました。
3. 原因は、自動更新がカーネルだけ上げてモジュールを見送ったこと
いつ何が入ったかは /var/log/dpkg.log に全部残っています。直近 4 回の自動更新について、カーネルとモジュールの導入時刻を並べるとこうなります(日付は省き、時刻だけ載せます)。
# 3 回前の自動更新
06:50:26 install linux-image-7.0.0-29-generic
06:50:42 install linux-modules-nvidia-595-open-7.0.0-29-generic
# 2 回前
06:18:15 install linux-image-7.0.0-30-generic
06:18:31 install linux-modules-nvidia-595-open-7.0.0-30-generic
# 前回
06:08:41 install linux-image-7.0.0-31-generic
06:08:41 install linux-modules-nvidia-595-open-7.0.0-31-generic
# 今回
06:41:57 install linux-image-7.0.0-34-generic
(-34 用のモジュールはここで入っていない)-29、-30、-31 のときは、カーネルとモジュールが同じ分内に一緒に入っています。-34 だけカーネル単独です。
では今回の更新が走った朝 6 時 41 分に何が起きたのか。unattended-upgrades のログを見ます。
06:41:53 INFO 自動アップグレードスクリプトを開始します
06:41:53 INFO 許可されているパッケージ導入元: o=Ubuntu,a=noble, o=Ubuntu,a=noble-security, ...
06:41:55 WARNING パッケージ linux-modules-nvidia-595-open-generic-hwe-24.04 はアップグレード可能ですが、
         アップグレード予定にできませんでした (E:Unable to correct problems, you have held broken packages.)
06:41:56 INFO アップグレード予定のパッケージ: linux-generic-hwe-24.04 linux-headers-generic-hwe-24.04
         linux-image-generic-hwe-24.04 linux-libc-dev linux-tools-common
06:42:13 INFO すべてのアップグレードがインストールされました
06:42:23 INFO Package linux-modules-nvidia-595-open-generic-hwe-24.04 is kept back because
         a related package is kept back or due to local apt_preferences(5).
正直に書いてあります。NVIDIA モジュールのメタパッケージは「アップグレード可能だが、依存関係が解決できないので予定に入れられない」。そのうえでカーネルのメタパッケージだけを更新している。unattended-upgrades から見ると、モジュールは入れられない、カーネルは入れられる、だから入れられるほうだけ入れた、という判断です。
なぜモジュールの依存関係が解決できなかったのか。パッケージの依存関係を見ると分かります。
$ apt-cache show linux-modules-nvidia-595-open-7.0.0-34-generic | grep -E "^(Version|Depends)"
Version: 7.0.0-34.34~24.04.1+1
Depends: linux-image-7.0.0-34-generic | linux-image-unsigned-7.0.0-34-generic,
         nvidia-kernel-common-595 (<= 595.91.07-1), nvidia-kernel-common-595 (>= 595.91.07)

$ apt-cache policy nvidia-kernel-common-595
     595.91.07-0ubuntu0.24.04.1 500
        500 http://jp.archive.ubuntu.com/ubuntu noble-updates/multiverse amd64 Packages
     595.84-0ubuntu0.24.04.1 500
        500 http://security.ubuntu.com/ubuntu noble-security/multiverse amd64 Packages
ここが今回のポイントです。
-34 用の NVIDIA モジュールは、nvidia-kernel-common-595 が 595.91.07 以上 595.91.07-1 以下であることを要求している。ところが 595.91.07 は noble-updates にしかなく、noble-security には 595.84 までしかない。
nvidia-kernel-common-595 はドライバ一式のうちカーネルモジュール側の共通部品で、ドライバ本体(nvidia-driver-595-open)と同じ版で揃えて配布されています。この機に入っていたのは 595.84 で、要求される 595.91.07 を満たせませんでした。
595.84 だったことは、復旧時の dpkg.log に upgrade nvidia-kernel-common-595 595.84-0ubuntu0.24.04.1 595.91.07-0ubuntu0.24.04.1 と残っていることで確認できます。一方でカーネル -34 のほうは noble-security にも出ていました。
$ apt-cache policy linux-image-7.0.0-34-generic
 *** 7.0.0-34.34~24.04.1 500
        500 http://jp.archive.ubuntu.com/ubuntu noble-updates/main amd64 Packages
        500 http://security.ubuntu.com/ubuntu noble-security/main amd64 Packages
        100 /var/lib/dpkg/status
弊社の GPU 機は「セキュリティ更新だけ自動で入れる」設定(unattended-upgrades の既定に近い形)で運用しています。ログの 2 行目の「許可されているパッケージ導入元」に noble-updates が入っていないのはそのためです。カーネル -34 は noble-security に出ていたので入る。しかし -34 用モジュールが要求する nvidia-kernel-common-595 595.91.07 は noble-updates にしか無いので、許可された導入元の中では依存関係を満たせない。この機のログと依存関係を突き合わせる限り、これが「アップグレード予定にできませんでした」の中身とみられます。結果として、カーネルだけが先に進みました。
なお、ログに出ている E:Unable to correct problems, you have held broken packages. は apt が依存関係を解決できなかったときの一般的なメッセージで、この文言だけから原因が「許可導入元の外にある」と決まるわけではありません。今回は依存先の候補版が許可導入元に無かったことと整合する、という読み方です。
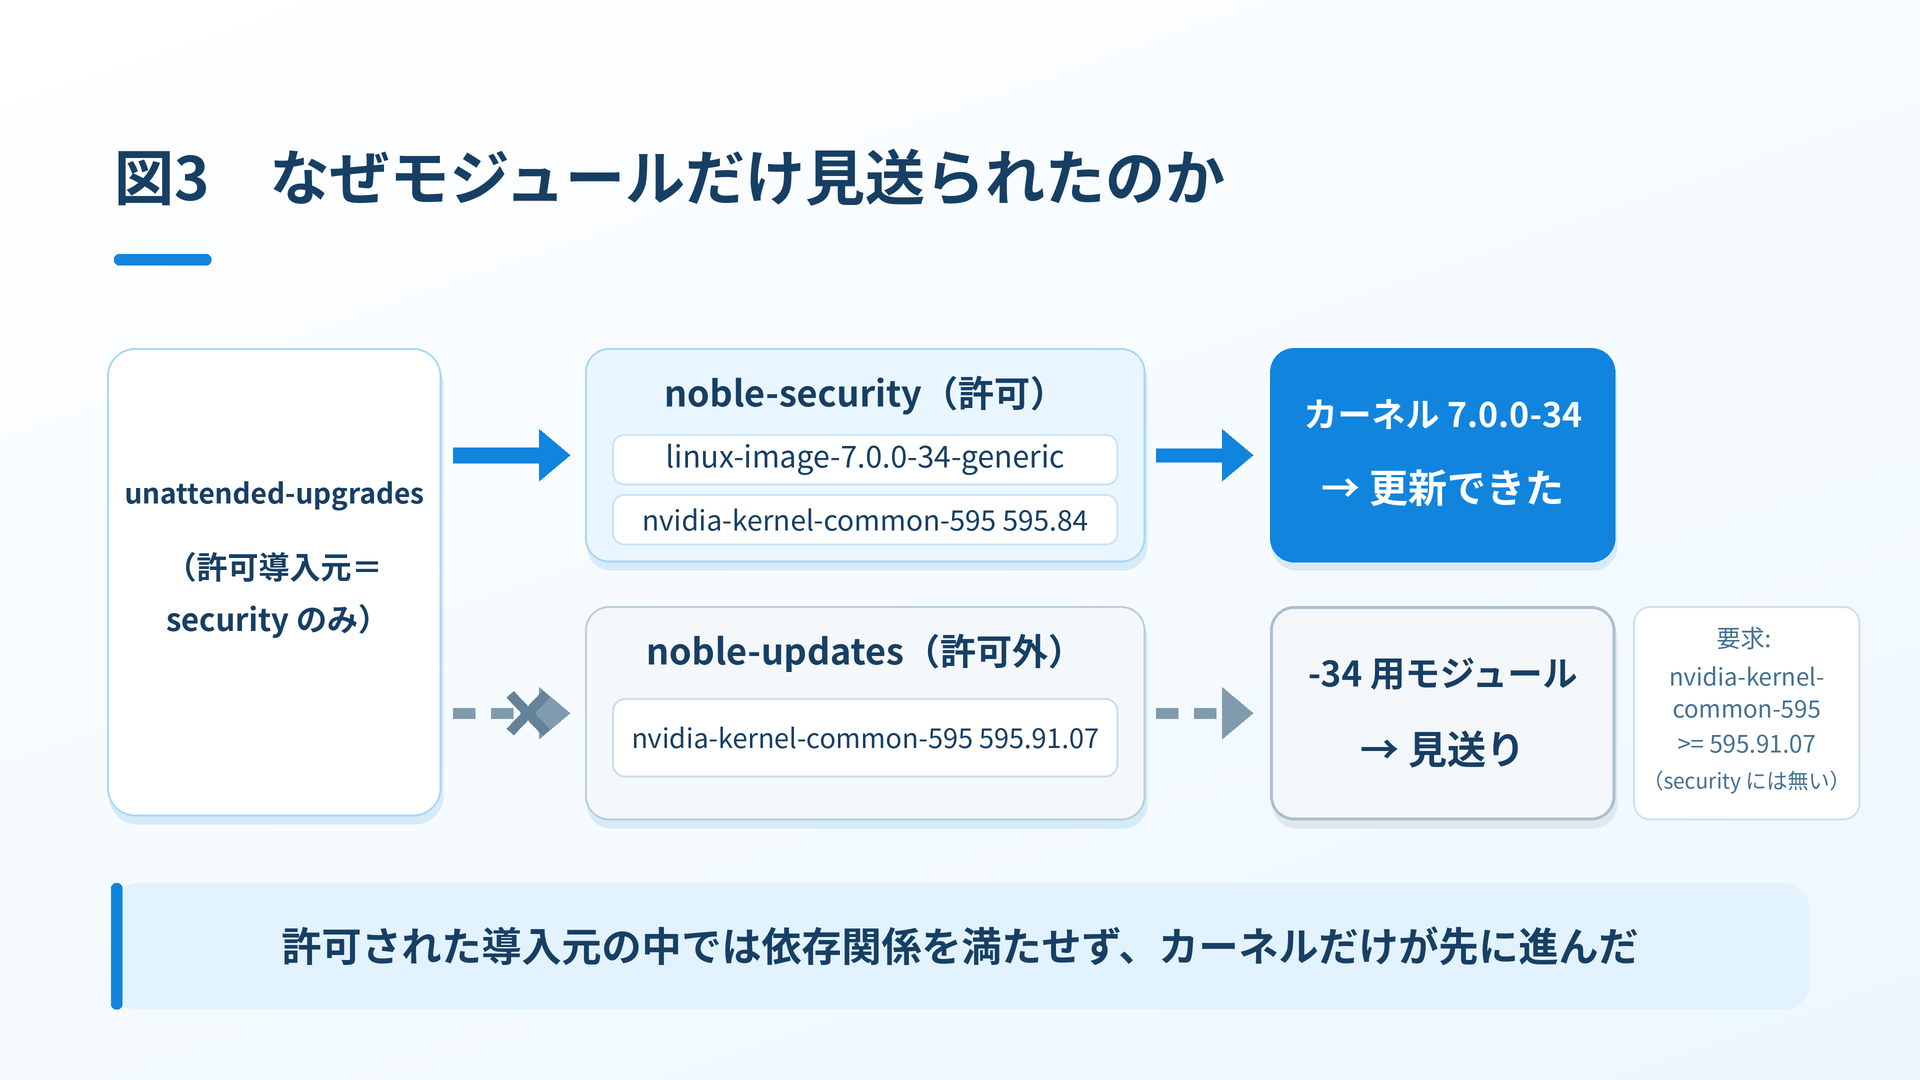
整理すると、原因の連鎖はこうです。
| 順 | 起きたこと | どこで確認できるか |
|---|---|---|
| 1 | カーネル 7.0.0-34 がセキュリティ更新として公開された | apt-cache policy linux-image-7.0.0-34-generic が noble-security を指す |
| 2 | -34 用の NVIDIA モジュールは、nvidia-kernel-common-595 595.91.07 を要求する形でビルドされていた | apt-cache show の Depends 行 |
| 3 | nvidia-kernel-common-595 595.91.07 は noble-updates にしか無い | apt-cache policy nvidia-kernel-common-595 |
| 4 | security のみ許可の unattended-upgrades は、モジュールを「依存関係を解決できない」として見送り、カーネルだけ更新した | unattended-upgrades.log の WARNING と「アップグレード予定のパッケージ」 |
| 5 | 再起動するまで旧カーネルで動き続けるので、表には出ない | uname -r は再起動まで -31 のまま |
| 6 | 翌日の再起動で -34 が立ち上がり、モジュールが無いので GPU が消えた | modprobe nvidia の Module not found |
なお、それまでの -29 から -31 では、モジュールが nvidia-kernel-common-595 595.84 を要求する形でビルドされていて、595.84 は noble-security にあったので一緒に入れられていました。-34 の回で「モジュールの再ビルドがドライバの新しい版に紐づいた」ことが、今回だけ崩れた理由とみられます。Ubuntu 側でなぜそのタイミングで紐づけが変わったのかまでは、公式の説明を見つけられていません(未確認)。
ちなみに、この機に自動再起動の設定は入れていません(Automatic-Reboot "false")。GPU 処理を勝手に落とされないためです。それが今回は「カーネルだけ上がった状態が、再起動するまで表に出ない」方向に効きました。設定として間違ってはいないのですが、次に再起動した瞬間に GPU が消える状態のまま走り続けていたわけです。
4. 不足していたモジュールを入れて復旧。今回は再起動も要らなかった
原因が分かれば復旧は難しくありません。足りないモジュールのメタパッケージを手で入れ、モジュールを読み込むだけです。手で apt-get install すれば許可導入元の制約はかからないので、nvidia-kernel-common-595 を含むドライバ一式も 595.91.07 に一緒に上がります。
$ sudo apt-get install linux-modules-nvidia-595-open-generic-hwe-24.04
(nvidia-driver-595-open ほかドライバ一式が 595.84 から 595.91.07 に上がり、
  linux-modules-nvidia-595-open-7.0.0-34-generic が新規に入る)

$ sudo modprobe nvidia
$ nvidia-smi --query-gpu=name,driver_version --format=csv,noheader
NVIDIA RTX A5000, 595.91.07
NVIDIA RTX A5000, 595.91.07
今回はモジュールを入れたあと modprobe でそのまま読み込めたので、再起動なしで GPU が戻りました。ここまでで事故そのものは 10 分ほどで収束しています。
問題はここからです。同じことが次のカーネル更新でも起きうる。
5. 課題は「自動更新の範囲」と「再起動前の確認」の 2 つ
今回の事故を分解すると、課題は 2 つに分かれます。
ひとつめは、自動更新がカーネルと NVIDIA モジュールを別々に扱えてしまうこと。ペアで動くべきものが、片方だけ更新される状態を許している。ここを何らかの形で塞ぐ必要があります。
ふたつめは、再起動する前に「次に立ち上がるカーネルに NVIDIA モジュールがあるか」を誰も確認していなかったこと。自動更新が何を入れたかは、再起動する人の頭の中にはありません。確認する手順が運用に無ければ、対策がどれだけ完璧でも、いつか別の理由で同じ穴に落ちます。
ふたつめは手順を 1 行足せば済むので後述するとして、ひとつめの塞ぎ方には選択肢が 3 つありました。
6. 再発防止の 3 案を比べる
検討したのは次の 3 つです。
| 案 | やること | 良い点 | 気になる点 |
|---|---|---|---|
| (1) カーネルとモジュールを自動更新から外す | apt-mark hold でカーネルとモジュールのメタパッケージを固定し、人が棚卸しのときにペアで上げる | この 2 つが別々に進む経路を止められる。動作が予測しやすい。設定は 1 行で、いつでも戻せる | カーネルのセキュリティ更新も止まる。上げ忘れないための棚卸しが要る |
| (2) 自動更新の対象に noble-updates を加える | unattended-upgrades の許可導入元に noble-updates を追加し、モジュールが要求するドライバも自動で入るようにする | 手作業なしで今後も追随する。今回のケースは、当時の候補版と依存関係なら防げた可能性が高い | 自動更新の対象が広がり、勝手に変わる範囲が増える。モジュールの公開がカーネルより遅れた場合は防げない |
| (3) DKMS 方式に切り替える | nvidia-dkms-595-open を使い、新しいカーネルが入った時点で機内でモジュールをビルドさせる | Ubuntu 側のモジュール公開に依存しなくなる | ドライバの入れ方そのものを変えるので、切り替え作業と再検証が要る。Secure Boot 有効ならモジュールの署名と鍵の登録も要る。ビルドに失敗する事故は別途あり得る |
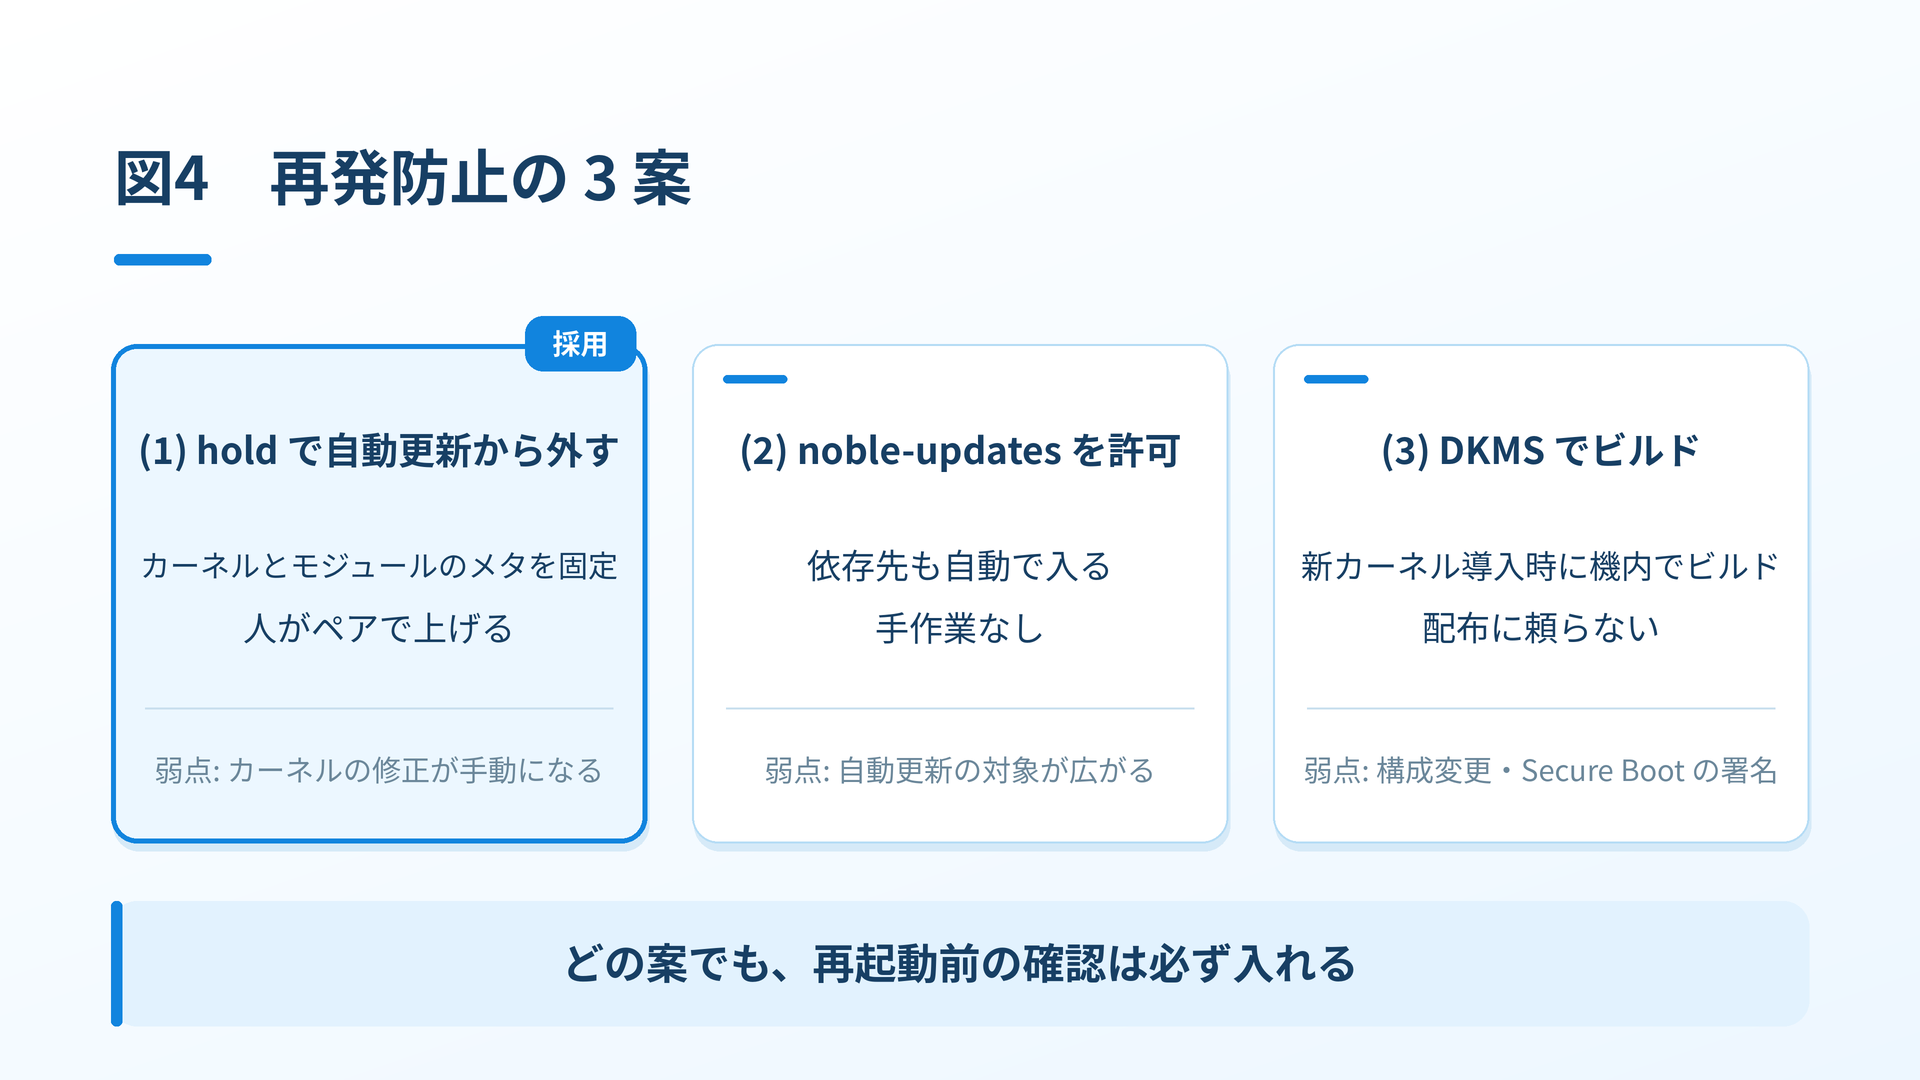
それぞれもう少し掘り下げます。
(1) の要点は「何が起きるか分かっている状態」を買うこと
hold は、apt にそのパッケージを更新させない印です。unattended-upgrades も hold を尊重するので、カーネルのメタパッケージとモジュールのメタパッケージの両方に印を付けておけば、どちらも勝手には上がりません。上げるときは人が両方を一緒に上げるので、今回のように片方だけが先に進む経路を止められます。固定するのはこの 2 つのメタパッケージであって、カーネルや NVIDIA 関連のパッケージ全部を一括で止める操作ではない点は押さえておいてください。
代わりに、カーネルのセキュリティ更新が自動では入らなくなります。ここは機の性格で判断が分かれるところで、インターネットに直接さらしているサーバーなら大きなマイナスです。弊社の GPU 機は社内 LAN 限定で外から到達できないので、この影響は小さいと判断しました。カーネル以外の更新は今までどおり自動で入ります。
(2) の要点は「自動更新の範囲を広げるかどうか」
今回のケースに限れば、noble-updates を許可していれば nvidia-kernel-common-595 595.91.07 も候補に入り、モジュールも一緒に入っていた可能性が高い。その意味では原因に一番まっすぐな対策です。
ただし noble-updates を許可すると、自動更新の対象がセキュリティ以外の更新(ライブラリ、ツール、ドライバ一式)まで広がります。GPU サーバーでドライバやライブラリが知らないうちに上がるのは、それはそれで別の事故の種です。加えて、この方式でも「カーネルが先に公開され、モジュールの公開が数日遅れる」パターンは防げません。今回は両方が同時に公開されていたので事故にならなかっただけで、構造的にペアを保証する仕組みではない。
(3) の要点は「配布に頼らず自分でビルドする」
DKMS は、新しいカーネルが入ったときにモジュールのソースをその場でビルドする仕組みです。Ubuntu がビルド済みモジュールをいつ公開するかに左右されなくなるので、追随性はいちばん高い。
一方で、いま入っている linux-modules-nvidia 系から nvidia-dkms 系へ入れ替える作業が必要になります。ドライバ構成を変える以上、再起動を伴う検証も要る。ビルドにはヘッダーとコンパイラが要り、カーネルの変更でビルドが通らなくなる事故もゼロではありません。さらに Secure Boot が有効な機では、自前でビルドしたモジュールに署名して鍵を登録する手順(MOK の登録)が要ります。この機は Secure Boot が有効で(mokutil --sb-state で SecureBoot enabled)、いまは Ubuntu が署名済みのビルド済みモジュールで動いているので、そこを崩す理由もありませんでした。安定運用中の機に対しては、直したい問題に比べて手術が大きすぎると感じました。
7. 弊社は (1) を採った
判断の軸は「GPU 機は動き続けることが最優先で、外部公開はしていない」の 2 点です。だから我々は、カーネル更新を人が意図したときにペアで行う (1) を採りました。
$ sudo apt-mark hold linux-image-generic-hwe-24.04 linux-modules-nvidia-595-open-generic-hwe-24.04

$ apt-mark showhold
containerd.io
docker-buildx-plugin
docker-ce
docker-ce-cli
docker-compose-plugin
linux-image-generic-hwe-24.04
linux-modules-nvidia-595-open-generic-hwe-24.04
Docker 系がすでに hold されているのは、この機の標準構成でバージョンを固定しているためで、今回の話とは別です。
hold したメタパッケージを人が上げるときは、hold を外し、先に -s(シミュレーション)で何が更新されるかを見てから、両方を一緒に更新し、また hold します。弊社ではこの機の計画停止や構成変更に合わせてこれを回す運用にしました。社内 LAN 限定とはいえカーネルの修正が遅れる状態は残るので、間隔が空きすぎないよう棚卸しの項目に入れています。
$ sudo apt-mark unhold linux-image-generic-hwe-24.04 linux-modules-nvidia-595-open-generic-hwe-24.04
$ sudo apt-get update
$ sudo apt-get install -s linux-image-generic-hwe-24.04 linux-modules-nvidia-595-open-generic-hwe-24.04   # 更新予定の一覧を確認
$ sudo apt-get install linux-image-generic-hwe-24.04 linux-modules-nvidia-595-open-generic-hwe-24.04
$ sudo apt-mark hold linux-image-generic-hwe-24.04 linux-modules-nvidia-595-open-generic-hwe-24.04
そして課題のふたつめ、再起動前の確認です。これは案の選択に関係なく入れました。見るのは「次に起動するカーネル」に NVIDIA モジュールが読み込める形で存在するかどうか、の 1 点です。
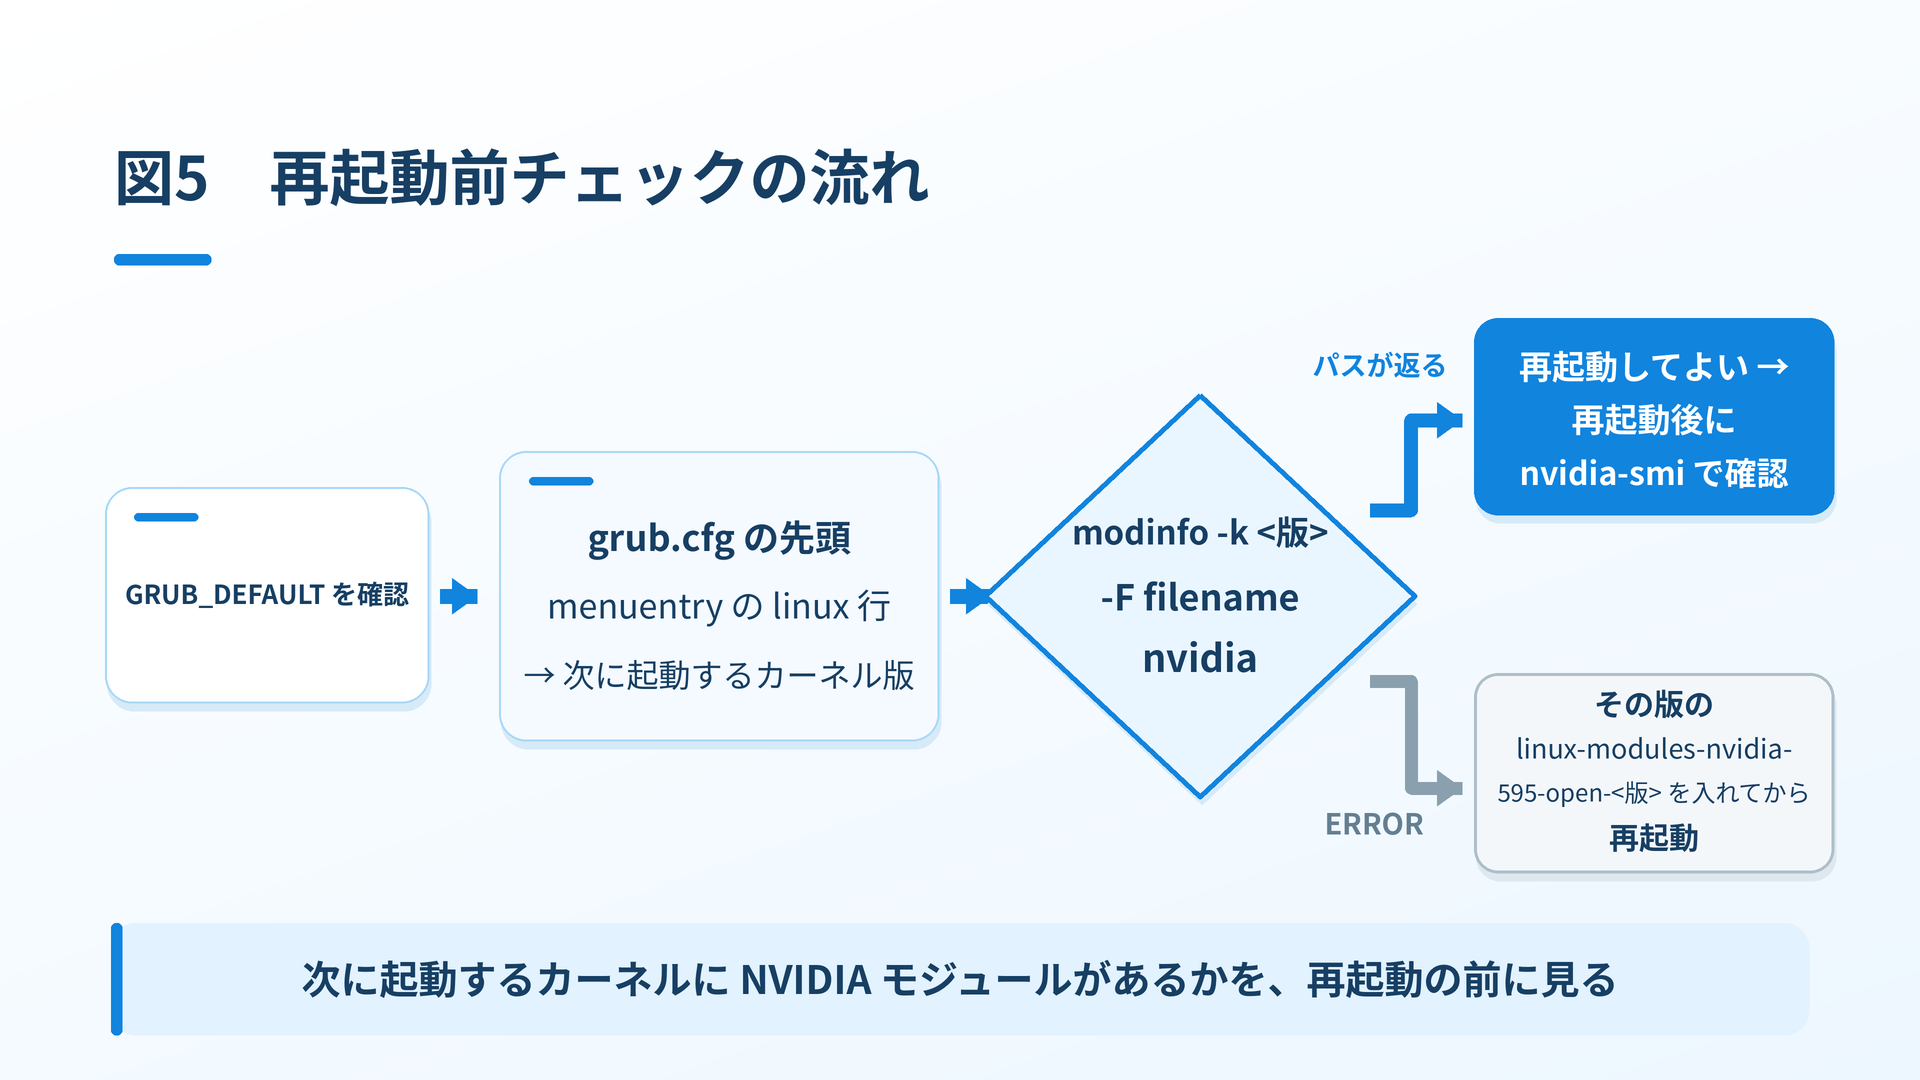
「次に起動するカーネル」は GRUB の既定項目で決まります。Ubuntu の既定は GRUB_DEFAULT=0 で、生成済みメニューの先頭項目が起動します。先頭項目がどのカーネルを指しているかは、grub.cfg の最初の menuentry にある linux 行を読めば分かります。「ディスク上でいちばん新しい版」を選ぶ方法では、この先頭項目と一致する保証がないので使いません。
$ grep ^GRUB_DEFAULT /etc/default/grub
GRUB_DEFAULT=0

$ sudo awk '/^menuentry/{c++} c==1 && /^[[:space:]]*linux[[:space:]]/ {print $2; exit}' /boot/grub/grub.cfg
/boot/vmlinuz-7.0.0-34-generic

$ target=7.0.0-34-generic          # 上の出力から版を読み取って指定する
$ modinfo -k "$target" -F filename nvidia
/lib/modules/7.0.0-34-generic/kernel/nvidia-595-open/nvidia.ko
GRUB_DEFAULT=saved にして前回の選択を記憶させている機では、grub-editenv list の saved_entry が指す項目を対象にしてください。grub-reboot で次回限りの起動項目を指定してある場合は、そちらが優先されるので(同じく grub-editenv list に next_entry として出ます)、その項目を対象にします。
modinfo -k は、指定したカーネル版のモジュールを実際に探しに行きます。パスが返れば、そのカーネル向けの nvidia モジュールがあるべき場所にある、という確認になります。読み込めることの保証までではないので、再起動後の nvidia-smi までが手順です。無ければこう返ります。
$ modinfo -k 7.0.0-28-generic -F filename nvidia
modinfo: ERROR: Module nvidia not found.
この例の -28 は、第 1 節で触れたとおりカーネル本体も NVIDIA モジュールも自動更新が削除済み(どちらも rc)で、ディレクトリに索引ファイルだけが残っている状態です。削除済みなのでモジュールが無いのは当然ですが、「ディレクトリはあるのにモジュールが無い」という見え方は、事故のときの -34 と同じです。
ERROR が出たら、その対象カーネル版のモジュールパッケージ linux-modules-nvidia-595-open-<対象版> を入れてから再起動する。対象がいちばん新しいカーネルなら、第 4 節のように HWE のメタパッケージを入れれば同じことです。再起動したら nvidia-smi で GPU が見えることまで確認する。弊社では GPU 機の再起動手順にこの確認を必須として組み込みました。
「なるべく新しいカーネルを自動で追いたい」のであれば、hold は付けずに (2) を選び、そのうえで再起動前の確認だけは必ず入れる、という組み合わせもあります。どちらを選ぶにせよ、再起動前の確認が最後の守りです。
まとめ。カーネル更新のあとに GPU 機を再起動するなら、モジュールの有無を先に見る
症状別に、どこを見て何をするかを表にしておきます。
| 状況 | 見る場所 | やること |
|---|---|---|
再起動後に nvidia-smi が動かない | modprobe nvidia のエラーに出るカーネル版と、ls /lib/modules/<版>/kernel/ | grep nvidia | 無ければその版の linux-modules-nvidia-<ver>-open-<カーネル版>(最新カーネルなら …-generic-hwe-24.04 のメタ)を入れ、modprobe nvidia で読み込む |
| なぜ片方だけ上がったのか知りたい | /var/log/unattended-upgrades/unattended-upgrades.log の WARNING と「アップグレード予定のパッケージ」 | 見送られたパッケージの apt-cache show の Depends と、依存先の apt-cache policy を突き合わせる。許可導入元の外にしか候補が無ければ今回と同じ型 |
| これから再起動する | grub.cfg の先頭 menuentry の linux 行が指すカーネル版に対する modinfo -k <版> -F filename nvidia | パスが返ることを見てから再起動し、再起動後に nvidia-smi で確認する。ERROR ならその版の linux-modules-nvidia-595-open-<版> を入れる |
自動更新は便利ですが、「ペアで動くもの」を別々に扱う場面があることは頭の片隅に置いておく価値があります。同じ症状で時間を溶かしている方の助けになれば幸いです。
それでは、また次回、お会いしましょう!
出典・参考
- unattended-upgrade(8) のマニュアル(Ubuntu Manpage)
- Ubuntu の自動セキュリティ更新の解説(Ubuntu Community Help Wiki)
- apt-mark(8) のマニュアル(Ubuntu Manpage)
- Ubuntu Server での NVIDIA ドライバ導入ガイド(Ubuntu 公式ドキュメント)