「Blackwell」は 1 つではなかった。NVIDIA の Compute Capability 番号のわかりにくさを整理する
こんにちは!
NVIDIA の GPU を扱っていると、sm_120 や sm_100 といった番号を見かけます。Compute Capability と呼ばれる番号です。
この番号、製品の世代名と対応しているように見えて、実はずれています。
きっかけは、2026年9月23日に公開された TensorRT-LLM の v1.3.0rc28 でした。リリースノートに「SM107」という記述があります。次世代の Rubin に対応した、という文脈です。
ここで引っかかります。Blackwell の GeForce は sm_120 です。次の世代の Rubin が、なぜ 107 という小さい番号なのでしょうか。
調べてみると、引っかかりの原因は Rubin ではありませんでした。「Blackwell」のほうが 1 つの Compute Capability ではなかったのです。
本記事では、この番号の読み方を整理します。過去記事の TensorRT 10 × Blackwell の移行ガイド で「Compute Capability が同じでも互換とは限らない」と書きましたが、今回はその一段上の話です。同じ製品名でも番号が分かれます。
数値はすべて NVIDIA の公式資料から引いています。確認できなかったことは第4部に書きました。
目次
第1部 「Blackwell」は 1 つの Compute Capability ではない
まず、NVIDIA 自身の定義を確認します。CUDA C++ Programming Guide の 12.8 版、2.6 節 Compute Capability にこう書かれています。
Devices with the same major revision number are of the same core architecture.
同じメジャー番号の製品は同じコアアーキテクチャ、という定義です。
マイナー番号についてはこうです。
The minor revision number corresponds to an incremental improvement to the core architecture, possibly including new features.
コアアーキテクチャへの小さな改良を表します。
現行の 13.4 版ではこの節が書き直され、Compute Capability は SM のバージョン番号にそのまま対応する、という説明になっています。12.0 の GPU の SM は sm_120 です。メジャー番号が違えば SM のバージョンが違い、後述のとおり cubin の互換もそこで切れます。
公式一覧を見ると Blackwell が散らばっている
この定義を頭に入れて、NVIDIA が公開している一覧を見ます。
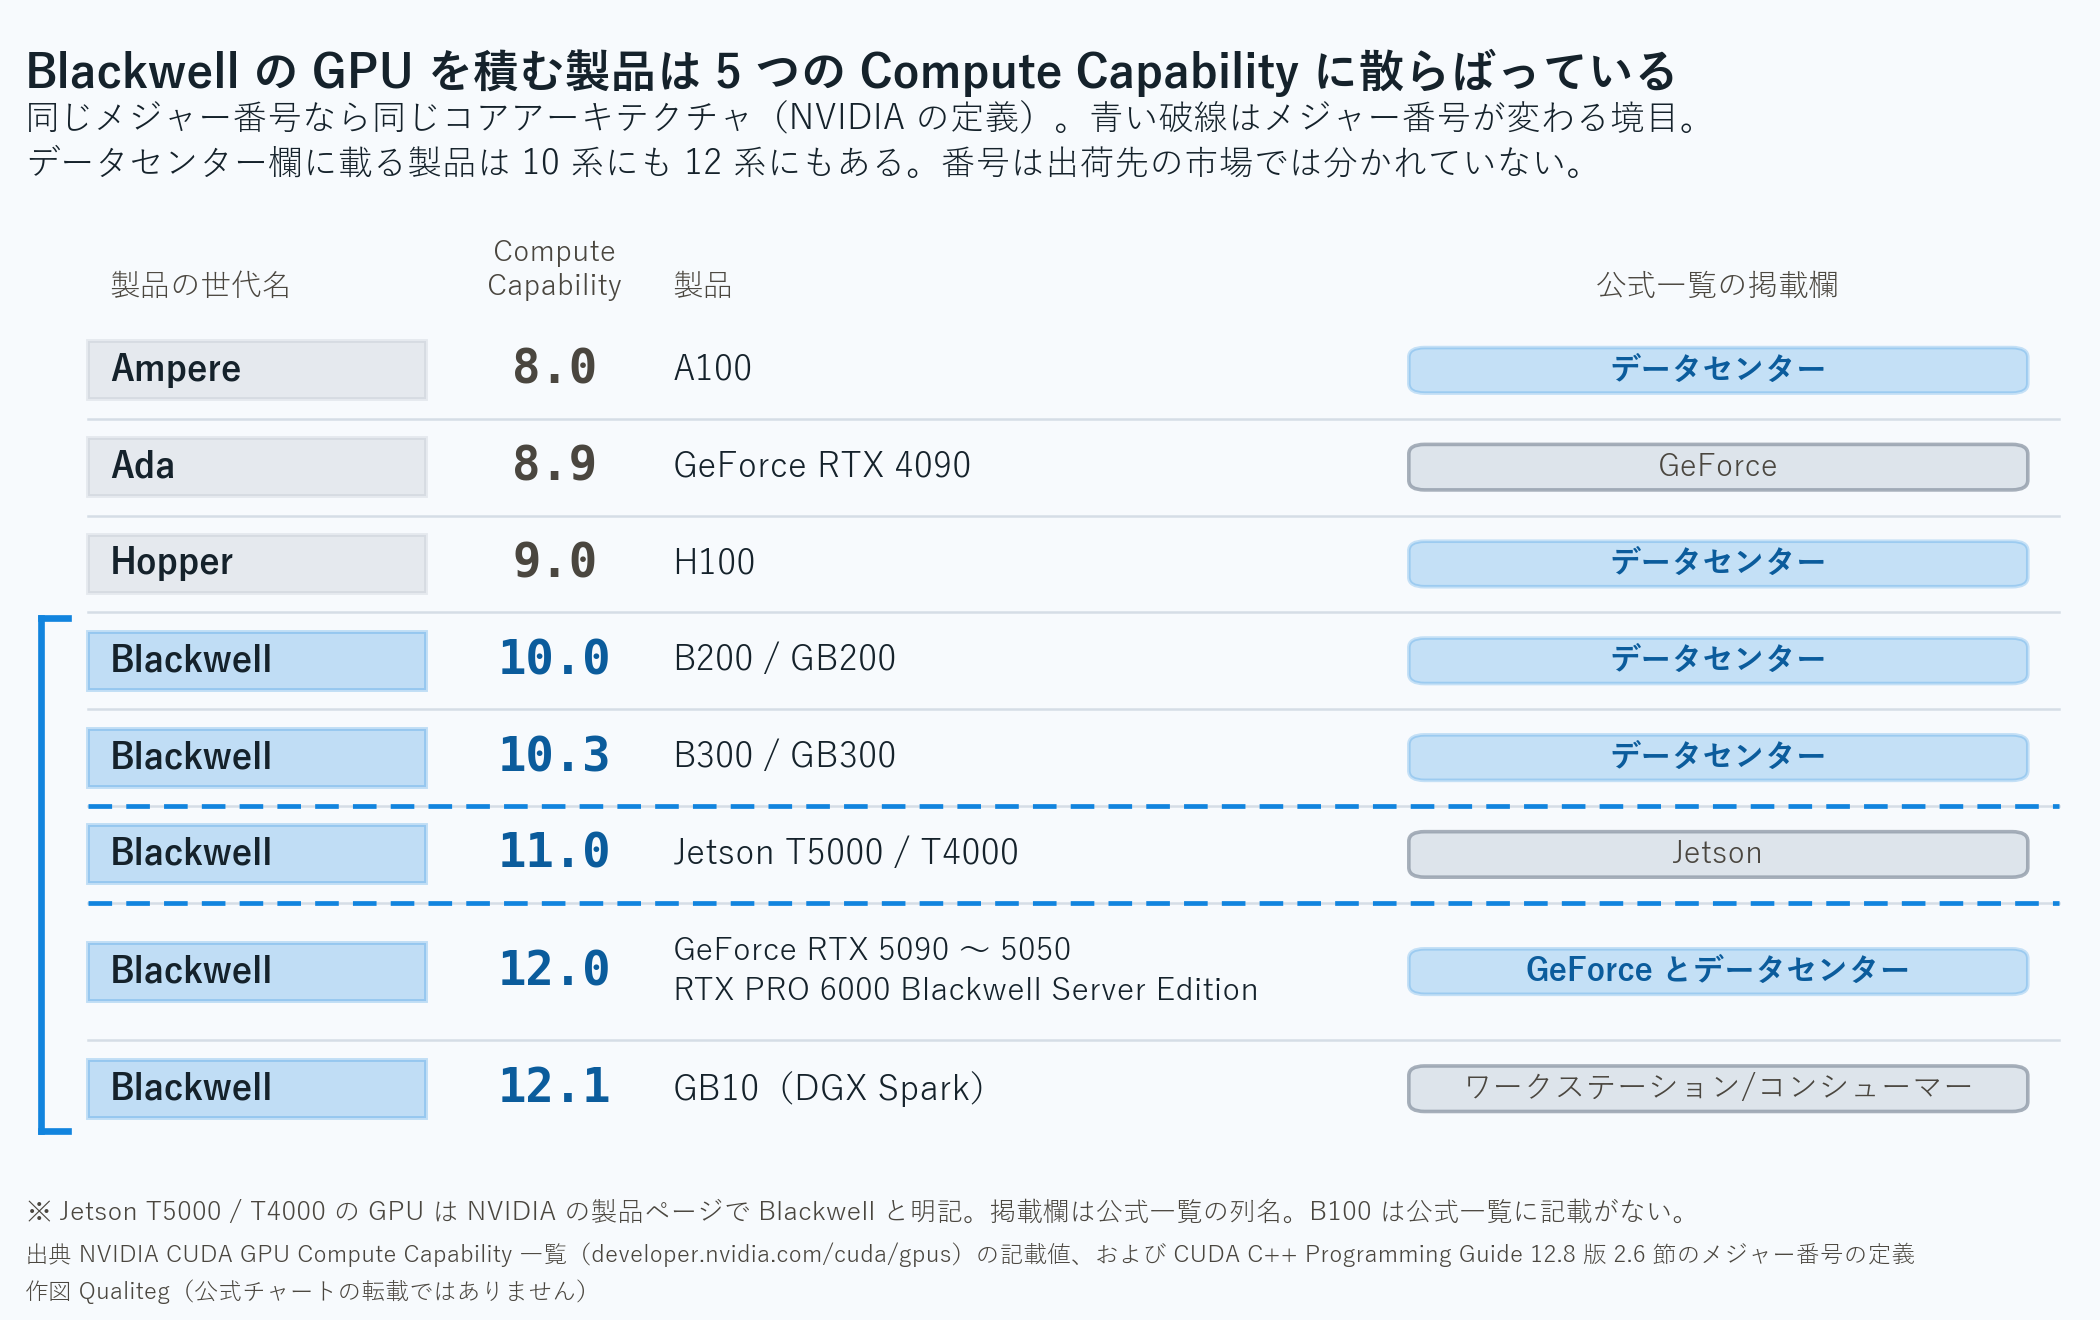
Ampere の A100 が 8.0、Ada の RTX 4090 が 8.9、Hopper の H100 が 9.0。ここまでは 1 つの世代名に 1 つのメジャー番号が対応しています。
Blackwell だけが違います。
Blackwell の GPU を積む製品は、10.0、10.3、11.0、12.0、12.1 の 5 つに散らばっています。
B200 と GB200 が 10.0。B300 と GB300 が 10.3。Jetson T5000 と T4000 が 11.0。GeForce RTX 5090 から 5050 までと RTX PRO の各製品が 12.0。GB10(DGX Spark)が 12.1 です。
Jetson T5000 と T4000 は、NVIDIA の製品ページで「Blackwell アーキテクチャの GPU」と明記されています。
メジャー番号だけ見ても 10、11、12 の 3 つに分かれています。メジャー番号が違うということは、CUDA から見ればバイナリ互換の境界が引かれているということです。
出荷先の違いではありません
ここで、ありがちな誤解を先につぶしておきます。
「10 番台がデータセンター向けで、12 番台が GeForce 向け」という説明を見かけますが、これは成り立ちません。
公式一覧の Data Center の欄には、12.0 の RTX PRO 6000 Blackwell Server Edition と RTX PRO 4500 Blackwell Server Edition が載っています。B200 や B300 と同じ欄に、12 系の製品があります。
番号を分けているのは、出荷先の市場ではありません。SM のバージョンが違い、cubin の互換の境界がそこにある、というだけです。
言い換えると、マーケティング上の世代名「Blackwell」と、CUDA 上の互換の区切りが一致していません。
Rubin の番号は 10.7
ここまで分かると、冒頭の疑問が解けます。
CUDA 13.4 のリリースノートに、はっきり書かれています。
Added support for the NVIDIA Rubin (compute capability 10.7) GPU architecture.
Rubin は 10.7 です。10 番台、つまり B200 や B300 と同じメジャー番号の系列に入ります。
TensorRT-LLM のリリースノートも同じ扱いをしています。
Align isSM100Family() with its SM100-109 C++ namesake
Run legacy fmha_v2 on the SM100 family (incl. SM107)
isSM100Family() が SM100 から SM109 までを含み、SM107 はその中に入ります。
つまり 107 と 120 は別の系列の番号です。並べて「107 のほうが古い」とは読めません。
第2部 番号が違うと何が起きるか
番号の分かれ方が分かったところで、実務でどう効くかを見ます。
現行の CUDA Programming Guide の 1.3.4.1 節 Binary Compatibility に、互換の規則が書かれています。
NVIDIA GPUs guarantee binary compatibility in certain circumstances. Specifically, within a major version of compute capability, GPUs with minor compute capability greater than or equal to the targeted version of cubin can load and execute that cubin.
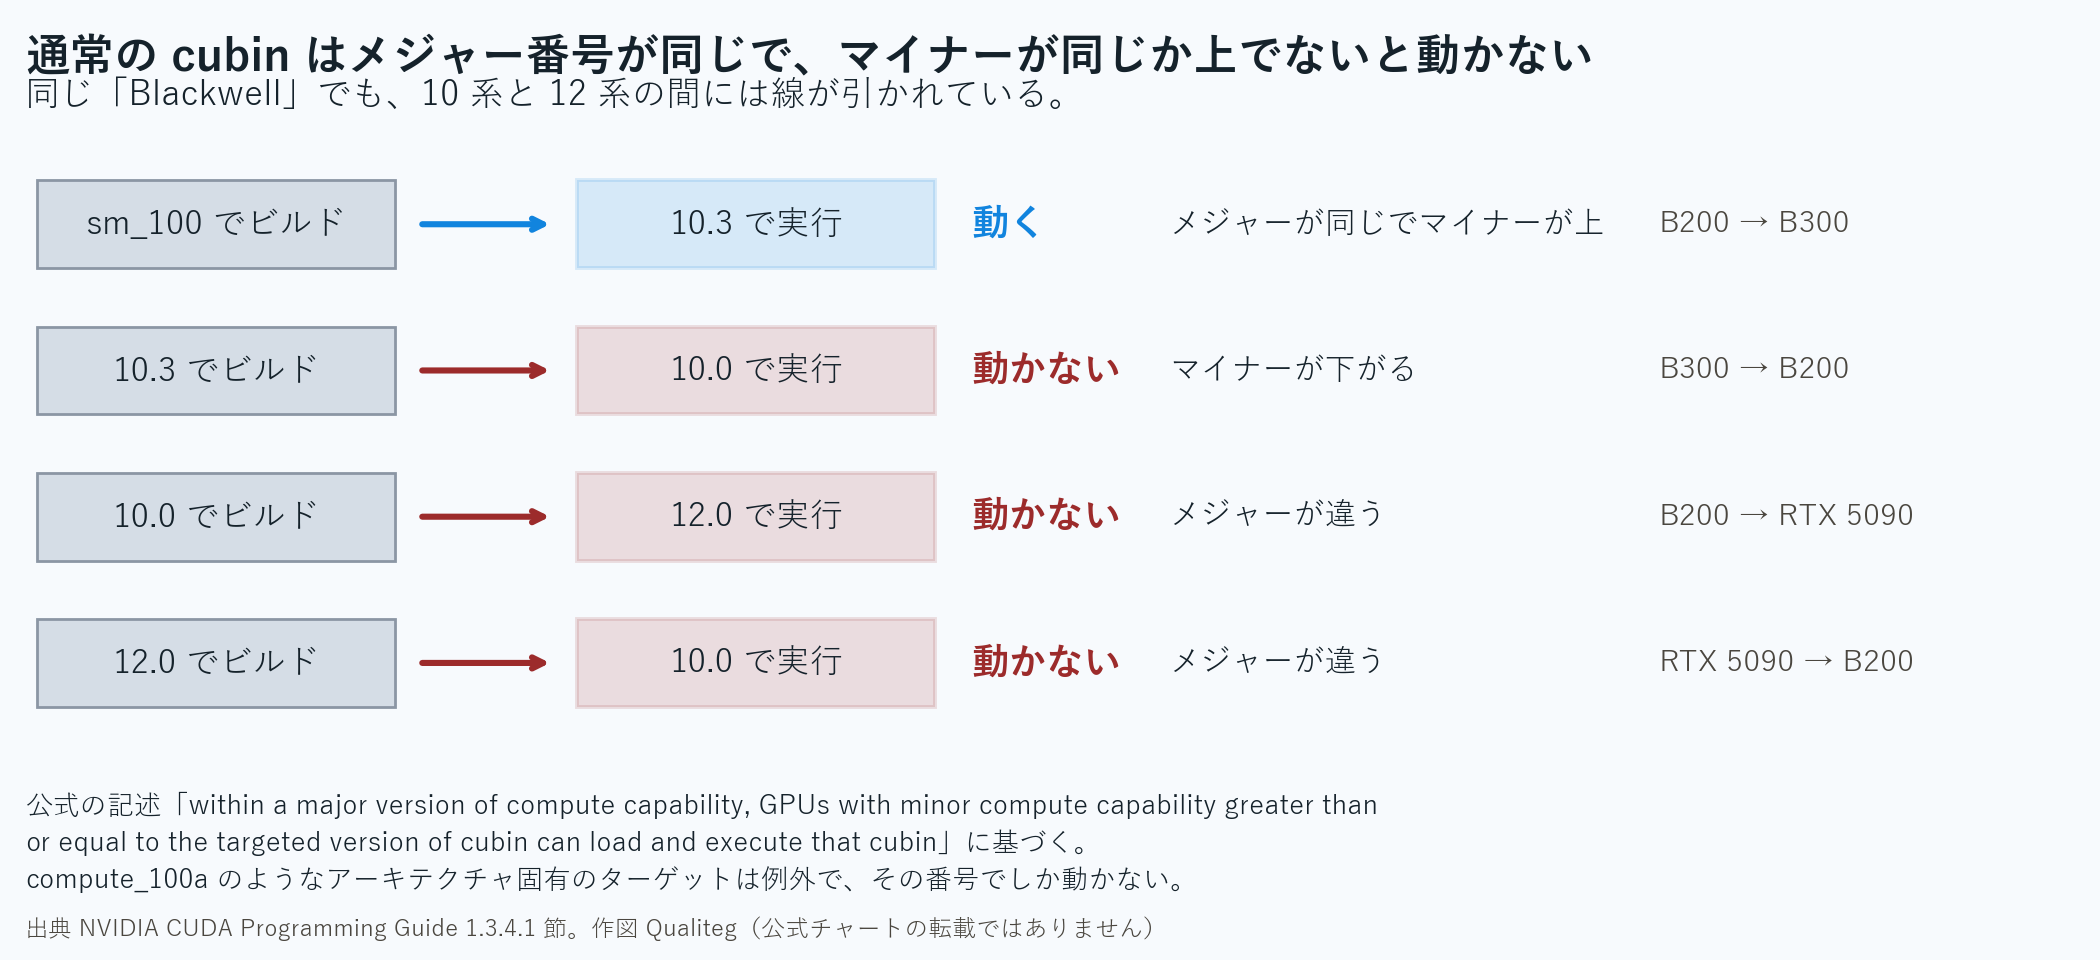
メジャー番号が同じで、マイナー番号が同じか上の GPU なら、その cubin を読み込んで実行できる、という意味です。同じ節に、8.6 向けの cubin は 8.9 では動くが 8.0 では動かない、という例も載っています。
Blackwell の中で線が引かれている
この規則を、さきほどの散らばりに当てはめます。
通常の sm_100 向けに作った cubin は 10.3 の B300 で動きます。メジャーが同じで、マイナーが上だからです。
逆に 10.3 向けのものは 10.0 の B200 では動きません。マイナーが下がるからです。
ただし、この規則が効くのは通常のターゲットだけです。compute_100a のようなアーキテクチャ固有のターゲットで作ったコードは 10.0 でしか動きません。compute_100f のようなファミリー固有のターゲットは 10.0、10.3、10.7 で動きます(現行ガイドの 5.1.2 節)。
そして 10 系と 12 系の間はメジャーが違うので、どちらの向きにも動きません。
B200 向けにビルドした cubin は RTX 5090 では動きません。逆も同じです。
同じ「Blackwell」という名前でも、この線をまたぐと通りません。
ビルド対象を間違えたときに何が起きるか
ここは注意が必要です。
ビルド対象を間違えると、そもそも起動しないこともあれば、PTX からの JIT コンパイルが働いて動いてしまうこともあります。
どちらになるかは、ビルド時に PTX を埋め込んだかどうかで変わります。-gencode の指定次第です。
ただし PTX があれば必ず動く、というわけでもありません。compute_100a のようなアーキテクチャ固有のターゲットには前方互換がありません。
そして、起動できたことは出力が正しいことを意味しません。当社は過去に「ビルドが通り、速度も出て、それでも出力が壊れていた」事例を書いています。起動時間と性能と出力は、実機で確かめてください。
TensorRT のエンジンは cubin とは別の話です
ひとつ補足します。
ここまでの互換の規則は CUDA の cubin の話です。TensorRT が作る「エンジン」は別の成果物で、互換の条件はもっと厳しくなります。
TensorRT のエンジンは、ビルドした環境の TensorRT のバージョンと GPU に強く結びつきます。Compute Capability が同じでも持ち回れないことがあります。
第3部 過去記事との関係
当社はこの周辺を何度か扱ってきました。今回の整理を踏まえて、それぞれの位置づけを書き直します。
機種単位の管理という結論は変わらない
TensorRT 10 × Blackwell の移行ガイド では、同じ sm_120 の別機種にエンジンを持ち回ったら本番で出力が壊れた、という経験を書きました。記事用の小さなモデルで再現を試みたときは、警告は 2 本出たものの出力は一致しています。
そこでの結論は「エンジンは Compute Capability 単位ではなく GPU 機種単位で管理する」でした。
今回わかったのは、その一段上でも同じことが起きているということです。
Compute Capability が同じでも機種が違えば別物。そして同じアーキテクチャ名でも Compute Capability が違う。二重に分かれています。
番号の一覧を持つ記事
NVIDIA GPU の Compute Capability 一覧 には、Rubin と Jetson T5000 / T4000 の行を足し、Blackwell が 1 つの番号に収まらないという説明に書き換えました。
PyTorch がサポートする GPU のバージョン には SM_107 の行を足しました。CUDA 13.4 のリリースノートには、13.4 の新機能と新しく対応したプラットフォームには R615 以降のドライバが必要と書かれています。
2026年 NVIDIA GPU 一発検索ツール では、SM_120 の製品 7 件が SM_100 に入っていた誤りを直し、Rubin を追加しました。
最後のものは、書いていて反省しました。自社のツールが、まさにこの記事の主題である取り違えをしていたわけです。RTX PRO 6000 Blackwell や GeForce RTX 5090 が、B200 と同じ SM_100 に並んでいました。
第4部 まだわかっていないこと
誠実に書いておきます。
Rubin の実機は当社にありません。 10.7 という番号は CUDA 13.4 のリリースノートに明記されているので、一次情報で確認できています。ただし実機での挙動は確かめていません。
製品別の一覧にはまだ Rubin の行がありません。 アーキテクチャの番号はリリースノートで分かりますが、どの製品が 10.7 になるかは、製品別の一覧が更新されるまで確定しません。
B100 の Compute Capability は公式一覧に記載がありませんでした。 B200 と GB200 は 10.0 と明記されています。
なぜ Jetson の Blackwell だけが 11 なのかは分かりません。 公式一覧では 11.0 が Jetson T5000 と T4000 で、製品ページは Blackwell アーキテクチャの GPU と明記しています。10 と 12 の間に入る理由を説明した一次情報は見つかりませんでした。
10 系と 12 系のハードウェアの違いについては、本記事では扱いません。 テンソルコアの命令セットやメモリ構成に差があるという解説は複数ありますが、一次情報での確認が取れていないため、本記事では番号と互換の話に絞りました。
まとめ
一言でまとめると「Compute Capability のメジャー番号は CUDA 上の互換の境界で、製品の世代名とは一致しない」ということです。
要点を 3 つに整理します。
NVIDIA の定義では、同じメジャー番号の製品は同じコアアーキテクチャです。ところが「Blackwell」という 1 つの名前の GPU を積む製品は、10.0、10.3、11.0、12.0、12.1 に散らばっています。世代名は CUDA 上の互換の区切りと一致しません。
番号を分けているのは出荷先ではありません。12.0 の RTX PRO 6000 Blackwell Server Edition は、公式一覧では B200 と同じデータセンターの欄にあります。
通常の cubin はメジャーが同じでマイナーが同じか上でないと動きません。10 系と 12 系の間では、どちらの向きにも通りません。
ビルド対象の指定は、アーキテクチャ名ではなく Compute Capability の番号で考えてください。「Blackwell 向けにビルドした」という言い方は、10 系、11 系、12 系のどれを指しているのか分かりません。
次回予告
Rubin の公式な Compute Capability が NVIDIA の一覧に載ったら、続報を書きます。あわせて、データセンター側と GeForce 側でどの命令が使えるかの違いも、一次情報が揃い次第まとめます。
それでは、また次回、お会いしましょう!
参考資料
- NVIDIA CUDA GPU Compute Capability 一覧(一次情報) https://developer.nvidia.com/cuda/gpus
- NVIDIA CUDA C++ Programming Guide 12.8 版 2.6 節 Compute Capability(一次情報。メジャー番号の定義の引用元) https://docs.nvidia.com/cuda/archive/12.8.0/cuda-c-programming-guide/index.html#compute-capability
- NVIDIA CUDA Programming Guide 1.3.4.1 節 Binary Compatibility(一次情報。cubin の互換規則の引用元) https://docs.nvidia.com/cuda/cuda-programming-guide/01-introduction/cuda-platform.html#binary-compatibility
- NVIDIA CUDA Programming Guide 5.1.2 節 Feature Availability(一次情報。アーキテクチャ固有とファミリー固有のターゲット) https://docs.nvidia.com/cuda/cuda-programming-guide/05-appendices/compute-capabilities.html#family-specific-features
- NVIDIA Jetson Thor 製品ページ(一次情報。T5000 / T4000 の GPU が Blackwell である根拠) https://www.nvidia.com/en-us/autonomous-machines/embedded-systems/jetson-thor/
- NVIDIA CUDA Toolkit 13.4 リリースノート(一次情報) https://docs.nvidia.com/cuda/cuda-toolkit-release-notes/
- NVIDIA/TensorRT-LLM v1.3.0rc28 リリースノート(一次情報) https://github.com/NVIDIA/TensorRT-LLM/releases/tag/v1.3.0rc28
- 当社記事 TensorRT 10 × Blackwell https://blog.qualiteg.com/tensorrt10-blackwell-silent-degradation-part2/
- 当社記事 NVIDIA GPU の Compute Capability 一覧 https://blog.qualiteg.com/nvidia-gpu-capability-level/
- 当社記事 PyTorch がサポートする GPU のバージョン https://blog.qualiteg.com/pytorch_and_supported_gpu_version/
- 当社記事 2026年 NVIDIA GPU 一発検索ツール https://blog.qualiteg.com/2026-nvidia-gpu-list-filtering-app/