Gemini 4 Carbon・Argon・Hydrogen 完全ガイド 3モデルの違いとAPI料金・他社モデルとの比較
Gemini 4 Carbon・Argon・Hydrogenの完全ガイド。3モデルの関係と選び方、12月1日に変わるAPI料金、Google公表ベンチマークと独立評価、GPT-6.2・Claudeとの価格と性能の比較、思考レベルやlong decodeなどAPI移行の要点、GeminiアプリとAntigravityでの使い方をまとめました。
こんにちは!
2026年10月から11月にかけて、GoogleのGemini 4が3モデルそろいました。10月13日にGemini 4 Argon、11月10日にGemini 4 Carbon、11月12日にGemini 4 Hydrogenが一般提供になっています。
性能、値段、速さ。それを3モデルと他社の主力モデルで並べると、こうなります。
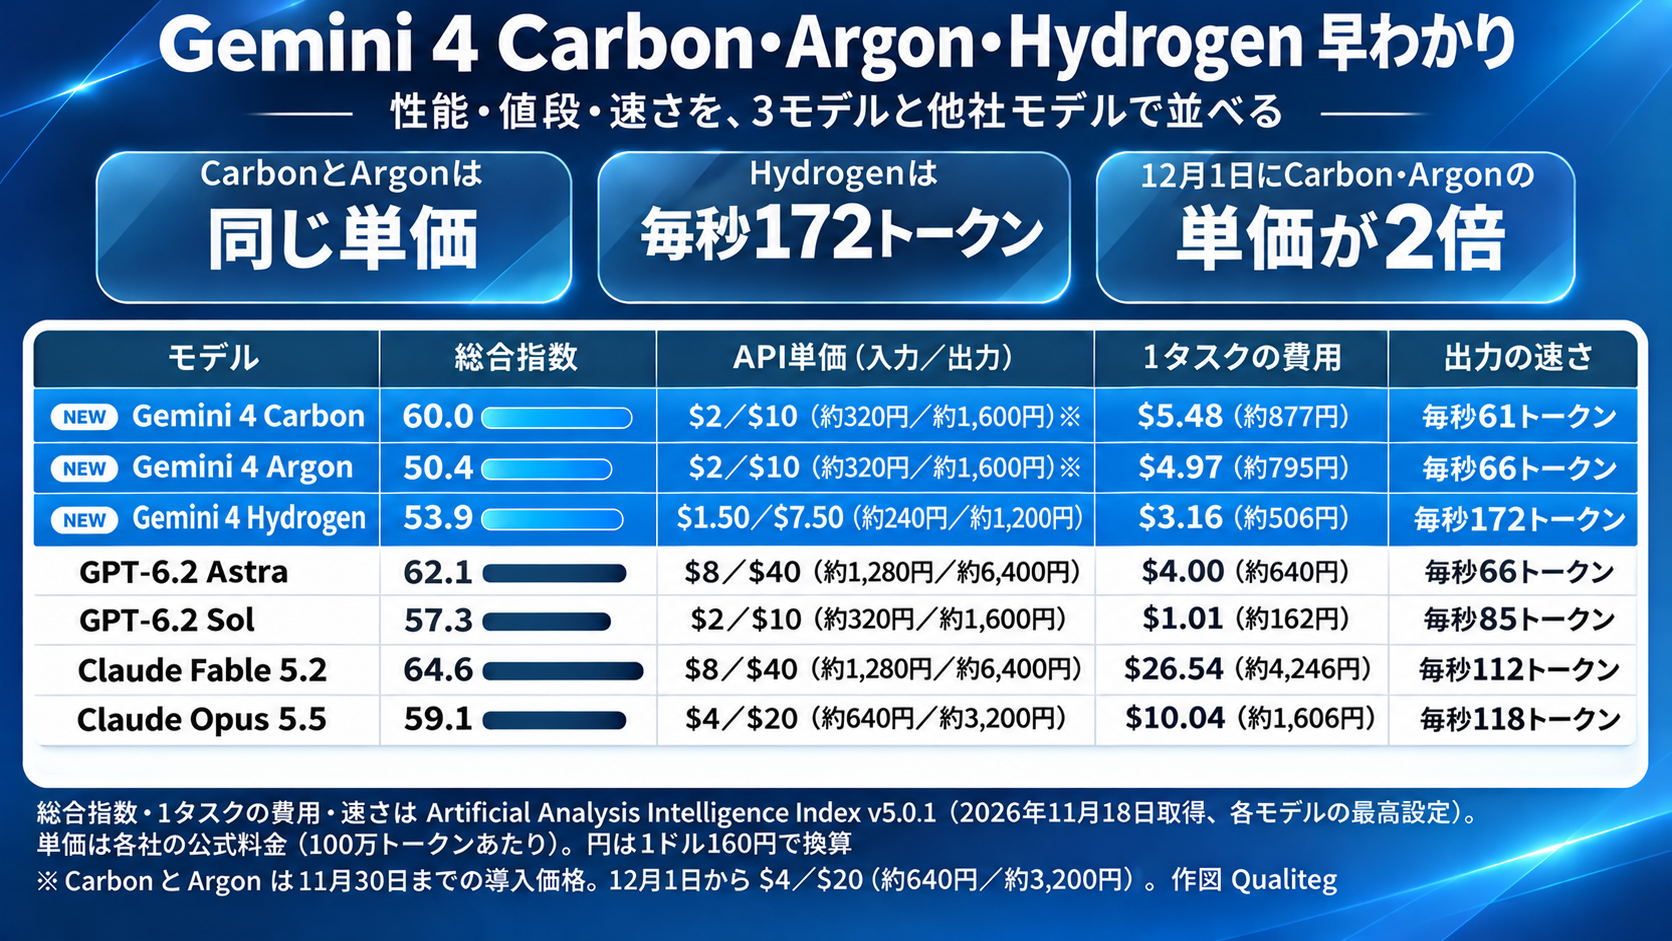
まず、この3モデルについて一言でいうと、
「Carbonがいちばん深く考える最上位、Argonが同じ単価で速く返す効率型、Hydrogenが毎秒172トークンで動く日常の主力。CarbonとArgonの単価は、12月1日に$2(約320円)・$10(約1,600円)から$4(約640円)・$20(約3,200円)へ変わる」
です。
さて、まずはAPI料金からみてみましょう。
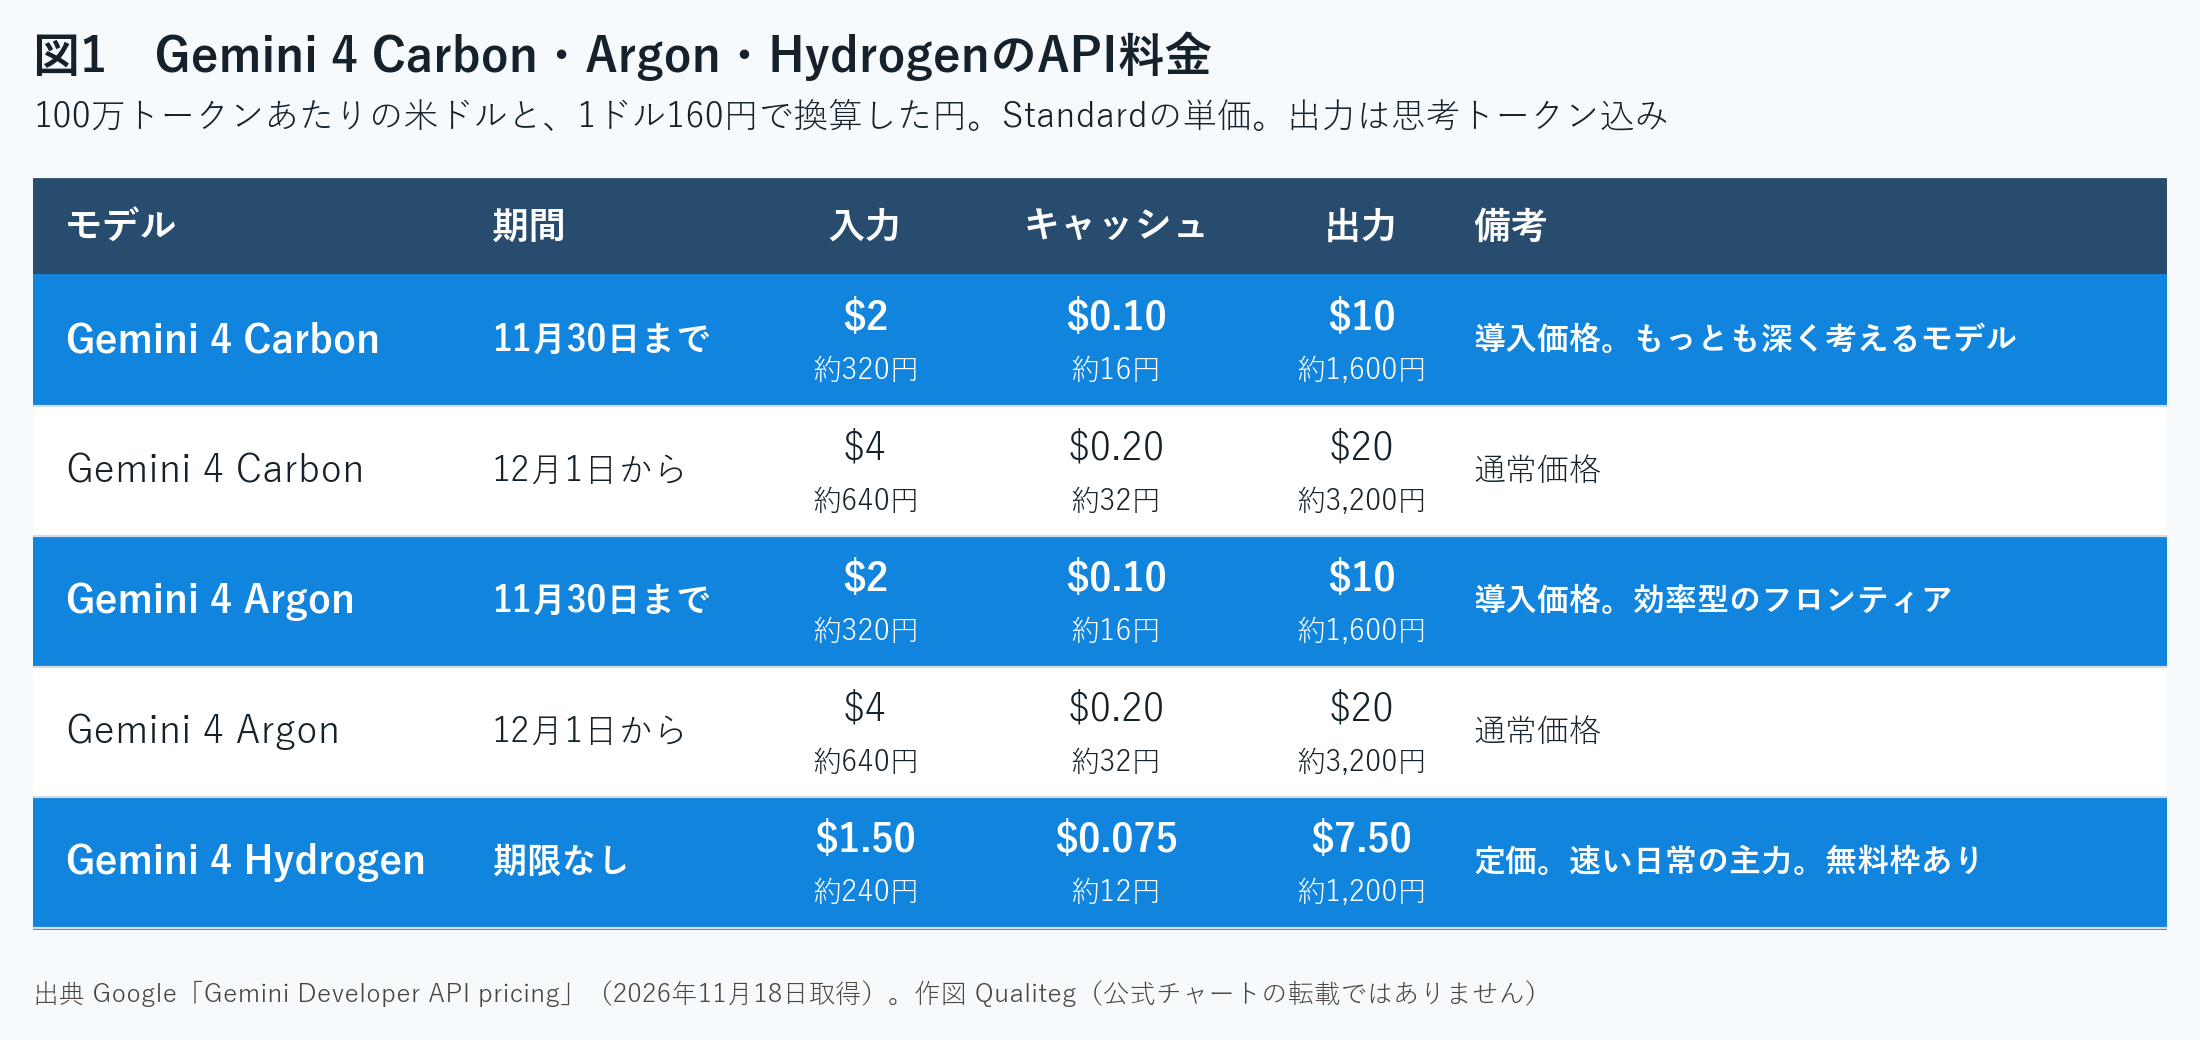
CarbonとArgonは同じ単価で、11月30日までは入力$2(約320円)・出力$10(約1,600円)の導入価格です。12月1日からは入力$4(約640円)・出力$20(約3,200円)になります。
Hydrogenは入力$1.50(約240円)・出力$7.50(約1,200円)で、こちらは期限のない定価です。
かっこの中の円は、1ドル160円(11月18日時点)で換算した目安です。この記事では、ドルの金額にはすべて円を添えています。
最上位のCarbonと、その下のArgonが同じ値段というのが、Gemini 4の料金のいちばんの特徴です。2つの違いは単価ではなく、1回のやり取りでどれだけ考えるかにあります。
Hydrogenの5日後の11月17日には、OpenAIからGPT-6.2 AstraとSolも出ました。そちらは「GPT-6.2 Astra・Sol 完全ガイド」にまとめています。この記事と対になる内容なので、あわせてご覧ください。
11月9日発表のClaude Fable 5.2は「Claude Fable 5.2 完全ガイド」で扱いました。今回の記事では、この3社の現行モデルを同じ表に並べた比較も載せています。
Googleの公式発表とドキュメント、モデルカード、それに独立評価機関のArtificial Analysisのデータをもとに書いています。
長編なので、頭から通読する必要はありません。気になる章だけ拾い読みしてください。
目次
第1部 Gemini 4の3モデルとは何か
- 1. Argonが土台、Carbonが最上位、Hydrogenが速い日常の主力
- 2. 基本仕様の早見表
- 3. 料金は12月1日が境目、CarbonとArgonの単価が2倍になる
- 4. Google公表のベンチマーク
- 5. 独立評価ではCarbonが指数60、Hydrogenは速さが際立つ
- 6. 思考レベルごとの性能と費用
- 7. モデルカードで見る安全性とFairwind Program
- 8. GPT-6.2・Claudeと価格と性能を並べる
第2部 APIで使うときのポイント
- 9. 思考レベルの既定値はモデルで違う
- 10. キャッシュは暗黙キャッシュに一本化、4,096トークンから効く
- 11. サンプリングのパラメータは固定、出力上限は高めに取る
- 12. 会話の状態はprevious_interaction_idで引き継ぐ
- 13. long decodeで最大約100万トークンまで出力できる
- 14. Gemini APIとVertex AIの違い
- 15. 移行の手順と費用試算
第3部 Geminiアプリ・Google検索・コーディングツールで使う
- 16. Geminiアプリはプランで使えるモデルが決まる
- 17. Google検索にはHydrogenが全ユーザー向けに入った
- 18. AntigravityのOrchestratorはCarbonとHydrogenを自動で使い分ける
Gemini 4の3モデル、ざっくり
詳しくは各章で扱いますが、まず全体像です。
3モデルは親子の関係にある
Argonが新しく作られた土台で、CarbonはArgonをもとに、HydrogenはCarbonをもとに作られました(第1章)
CarbonとArgonは同じ単価
11月30日まで入力$2(約320円)・出力$10(約1,600円)、12月1日から$4(約640円)・$20(約3,200円)です。違いは1回のやり取りで使う思考の量です(第3章)
Hydrogenは入力$1.50(約240円)・出力$7.50(約1,200円)の定価で、無料枠もある
100万トークンのコンテキストの全域で同じ単価です(第3章)
Carbonは長い文脈に強い
256Kから100万トークンのGraphWalksで96.2%。Google公表の表では、17項目のうち15項目でCarbonが最高でした(第4章)
独立評価の総合指数はCarbonが60.03
Artificial AnalysisのIntelligence Indexで91件中7位。評価タスク1つの費用は$5.48(約877円)です(第5章)
Hydrogenの出力速度は毎秒172トークン
同じ指数の評価タスクを、Carbonの半分以下の時間で終えます(第6章)
キャッシュは暗黙キャッシュに一本化された
4,096トークン以上のプロンプトで自動的に効き、当たった分は95%引きです(第10章)
出力は最大約100万トークンまで伸ばせる
long decodeとbackground実行を組み合わせます(第13章)
GeminiアプリではCarbonがUltra、ArgonがPro以上、HydrogenがPlus以上
Google検索にはHydrogenが全ユーザー向けに入りました(第16章・第17章)
AntigravityにOrchestratorが加わった
CarbonとHydrogenを1つの作業の中で切り替えながら進める機能です(第18章)
第1部 Gemini 4の3モデルとは何か
1. Argonが土台、Carbonが最上位、Hydrogenが速い日常の主力
Gemini 4の3モデルは、別々に作られた3つではありません。
Googleのモデルカードによると、Argonは「既存モデルの改変でも微調整でもない、新しいフロンティアモデル」です。CarbonはそのArgonをもとに作られ、HydrogenはCarbonをもとに作られています。
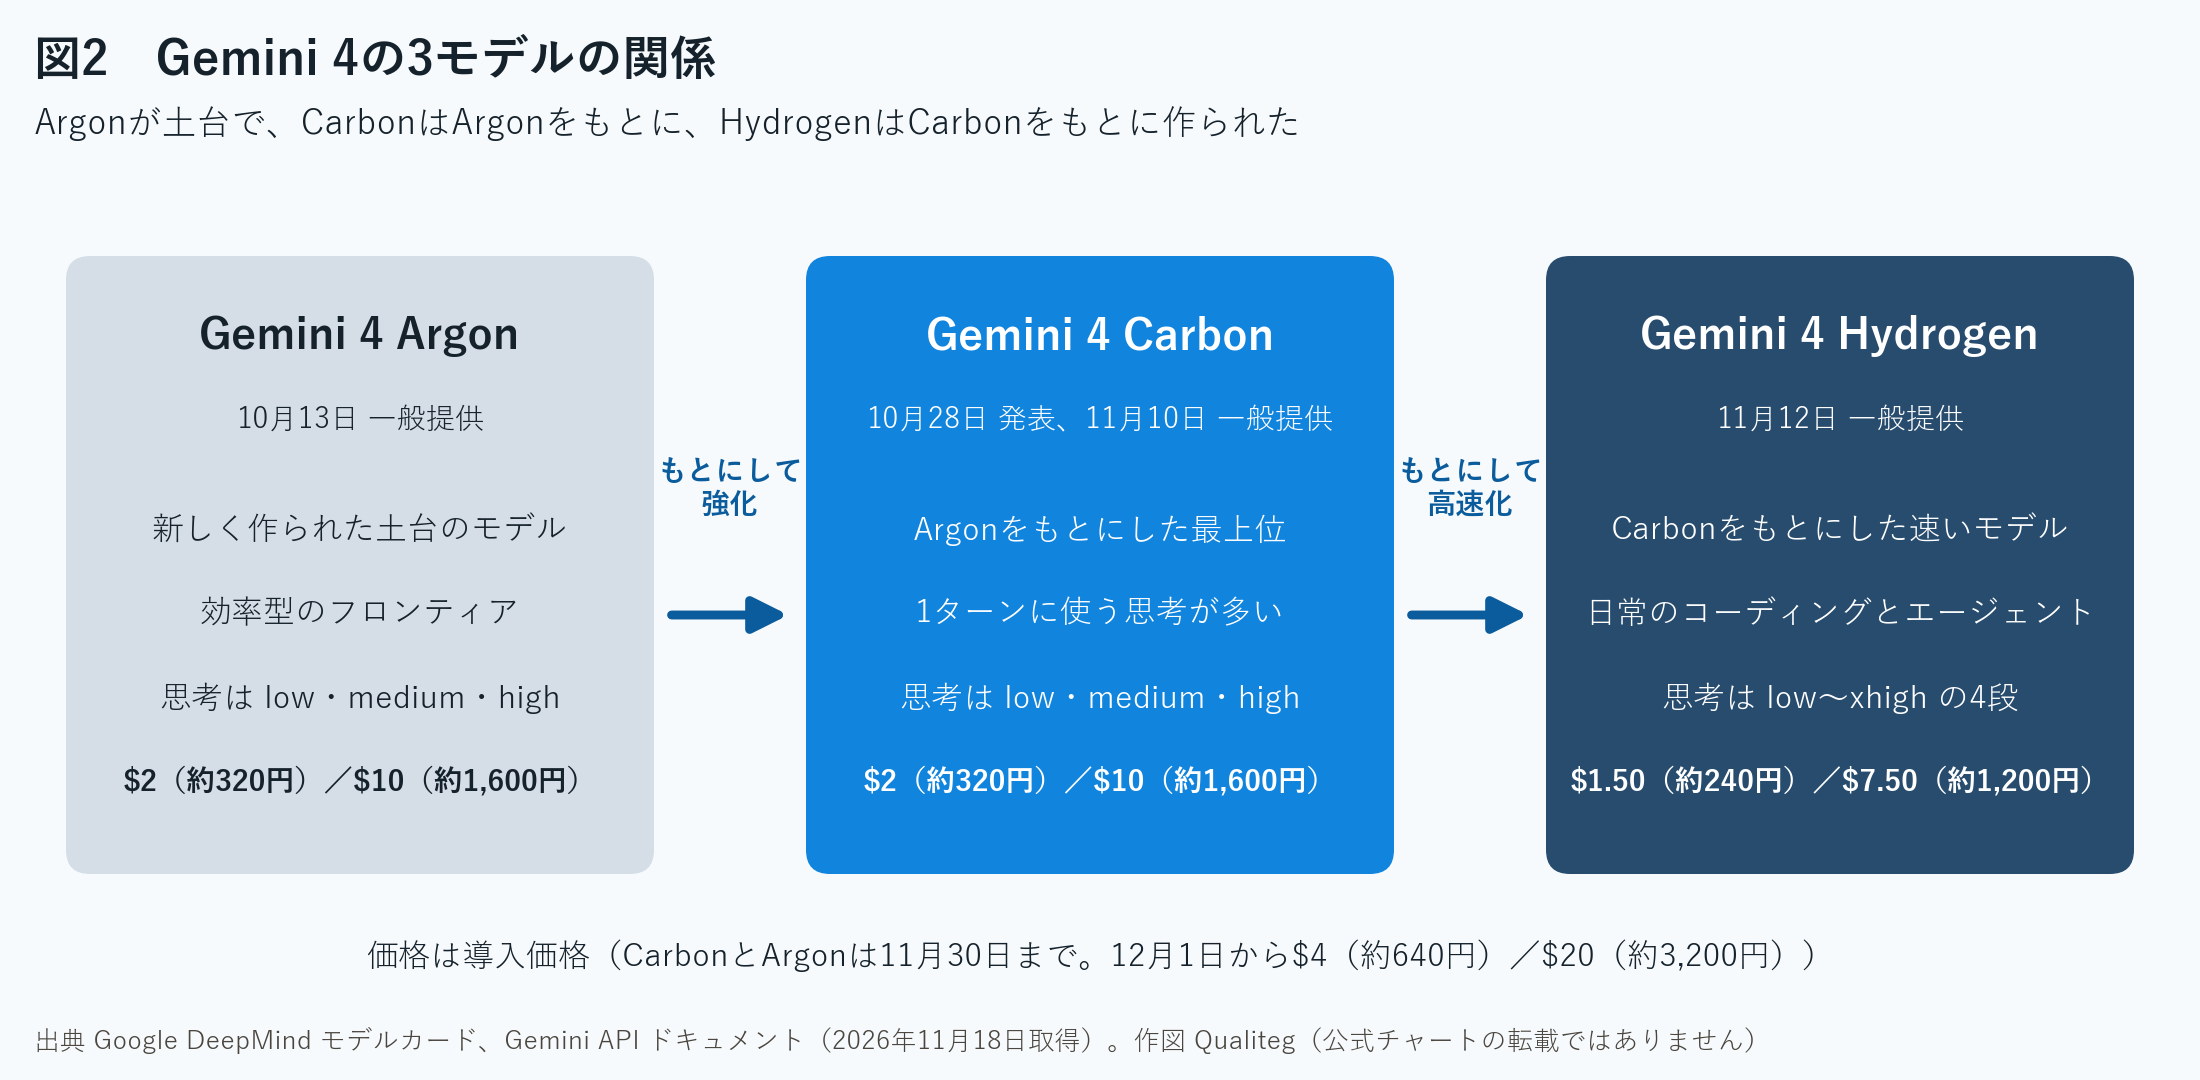
発表の順番も、この関係のとおりです。
| モデル | 発表 | 一般提供 | Googleの位置づけ |
|---|---|---|---|
| Gemini 4 Argon | 10月13日 | 10月13日 | 効率型のフロンティア推論モデル。Carbonより速く、1ターンのトークン消費が少ない |
| Gemini 4 Carbon | 10月28日 | 11月10日 | もっとも高性能な推論モデル。複雑なソフトウェア開発、数学と科学、長いエージェント作業向け |
| Gemini 4 Hydrogen | 11月12日 | 11月12日 | 日常のコーディングとエージェント作業を、速く効率よくこなすモデル |
Carbonは10月28日の発表から2週間、Fairwind Programという枠組みを通じて、サイバー防御の担当者に先行提供されていました。一般提供は11月10日からです(Fairwind Programは第7章で扱います)。
CarbonとArgonの違いについて、公式ドキュメントはこう書いています。
「Gemini 4 CarbonとGemini 4 Argonは、同じ100万トークンの統合コンテキスト、同じ組み込みツール、同じトークン単価を持ちます。主な違いは、1ターンに使う思考トークンの量です」。
Carbonは難しい問題で思考トークンを多く使い、仮説を試し、自分の作業を確かめ、境界条件を調べてから答えます。Argonは同じGemini 4の知能を、より速い応答と少ないトークン消費で出すモデルです。
Googleの使い分けの案内は次のとおりです。
| 用途 | Googleの推奨 | 速度の表記 |
|---|---|---|
| フロンティアの深い推論 | Gemini 4 Carbon、Gemini 4 Argon | Carbonは「Deliberate」、Argonは「Moderate」 |
| 日常の標準 | Gemini 4 Hydrogen | 「Fast」 |
| 大量処理と低コスト | Gemini 3.5 Flash-Lite |
Carbonの一般提供を知らせる発表は、2つの関係をこうまとめています。ソフトウェア開発と知識労働の大半にはArgonが引き続き向いていて、Carbonはモデルの知能の限界を試すような仕事のために作られた、という説明です。
Hydrogenは、Gemini 3.8 Flashとそれ以前のGemini 3系、2.5系からの乗り換え先として案内されています。
もうひとつ、公式が示す使い方があります。
CarbonとHydrogenを1つのワークフローで組み合わせる形です。Carbonにシステムのインターフェース設計や難所の解決を任せ、コードの編集、並列のサブエージェント作業、テストの実行はHydrogenに回します。これを自動でやるのが、第18章のOrchestratorです。
2. 基本仕様の早見表
| 項目 | Gemini 4 Carbon | Gemini 4 Argon | Gemini 4 Hydrogen |
|---|---|---|---|
| モデルID | gemini-4-carbon | gemini-4-argon | gemini-4-hydrogen |
| 提供の段階 | 一般提供(Stable) | 一般提供(Stable) | 一般提供(Stable) |
| コンテキスト | 1,048,576(入力と出力の合計) | 同じ | 同じ |
| 最大出力 | 65,536(long decodeで最大1,048,576) | 同じ | 同じ |
| 入力 | テキスト・画像・動画・音声・PDF | 同じ | 同じ |
| 出力 | テキスト | テキスト | テキスト |
| 知識の基準日 | 2026年3月 | 2026年3月 | 2026年3月 |
| 思考レベル | low・medium・high | low・medium・high | low・medium・high・xhigh |
| 思考レベルの既定 | medium | medium | high |
| キャッシュ | 暗黙キャッシュ | 暗黙キャッシュ | 暗黙キャッシュ |
| 無料枠 | 有料枠のみ | 有料枠のみ | あり |
| Batch・Flex・Priority | 対応 | 対応 | 対応 |
コンテキストの数え方が、Gemini 3系とは変わりました。
Gemini 3.8 Flashは入力100万トークンと出力64Kトークンを別々に持っていましたが、Gemini 4は入力・思考・出力が1つの1,048,576トークンの枠を分け合います。長い出力を出すときは、入力に使える量がそのぶん減ります。
組み込みツールは3モデル共通です。
Google検索によるグラウンディング、Googleマップによるグラウンディング、コード実行、Computer use、ファイル検索、関数呼び出し、構造化出力、URLコンテキストに対応しています。Computer useのツールは10月30日に一般提供になりました。
エンドポイントは、Interactions API(client.interactions)とgenerateContentの両方が使えます。Googleのドキュメントは、Interactions APIを標準の入り口として案内しています。
旧モデルの扱いは次のとおりです。
| 旧モデル | 扱い |
|---|---|
| Gemini 2.5 Pro | 12月1日からGemini 3.8 Flashへ自動転送(料金も3.8 Flash) |
| Gemini 2.5 Flash | 12月1日からGemini 3.5 Flash-Liteへ自動転送 |
| Gemini 3.7 Flash、3.5 Flash | 10月8日に非推奨。3.8 Flash、3.6 Flashへ自動転送 |
| Gemini 3.8 Flash、3.6 Flash、3.5 Flash-Lite | 提供を継続 |
Gemini 2.5 Proを本番で使っているアプリは、12月1日に転送が始まります。Gemini 4へ移すなら、Hydrogenが乗り換え先の候補です。
3. 料金は12月1日が境目、CarbonとArgonの単価が2倍になる
100万トークンあたりの米ドルで、Googleの料金ページの値を並べます。Standardの単価です。
| モデル | 期間 | 入力 | キャッシュ | 出力(思考トークン込み) |
|---|---|---|---|---|
| Gemini 4 Carbon | 11月30日まで | $2.00(約320円) | $0.10(約16円) | $10.00(約1,600円) |
| Gemini 4 Carbon | 12月1日から | $4.00(約640円) | $0.20(約32円) | $20.00(約3,200円) |
| Gemini 4 Argon | 11月30日まで | $2.00(約320円) | $0.10(約16円) | $10.00(約1,600円) |
| Gemini 4 Argon | 12月1日から | $4.00(約640円) | $0.20(約32円) | $20.00(約3,200円) |
| Gemini 4 Hydrogen | 期限なし | $1.50(約240円) | $0.075(約12円) | $7.50(約1,200円) |
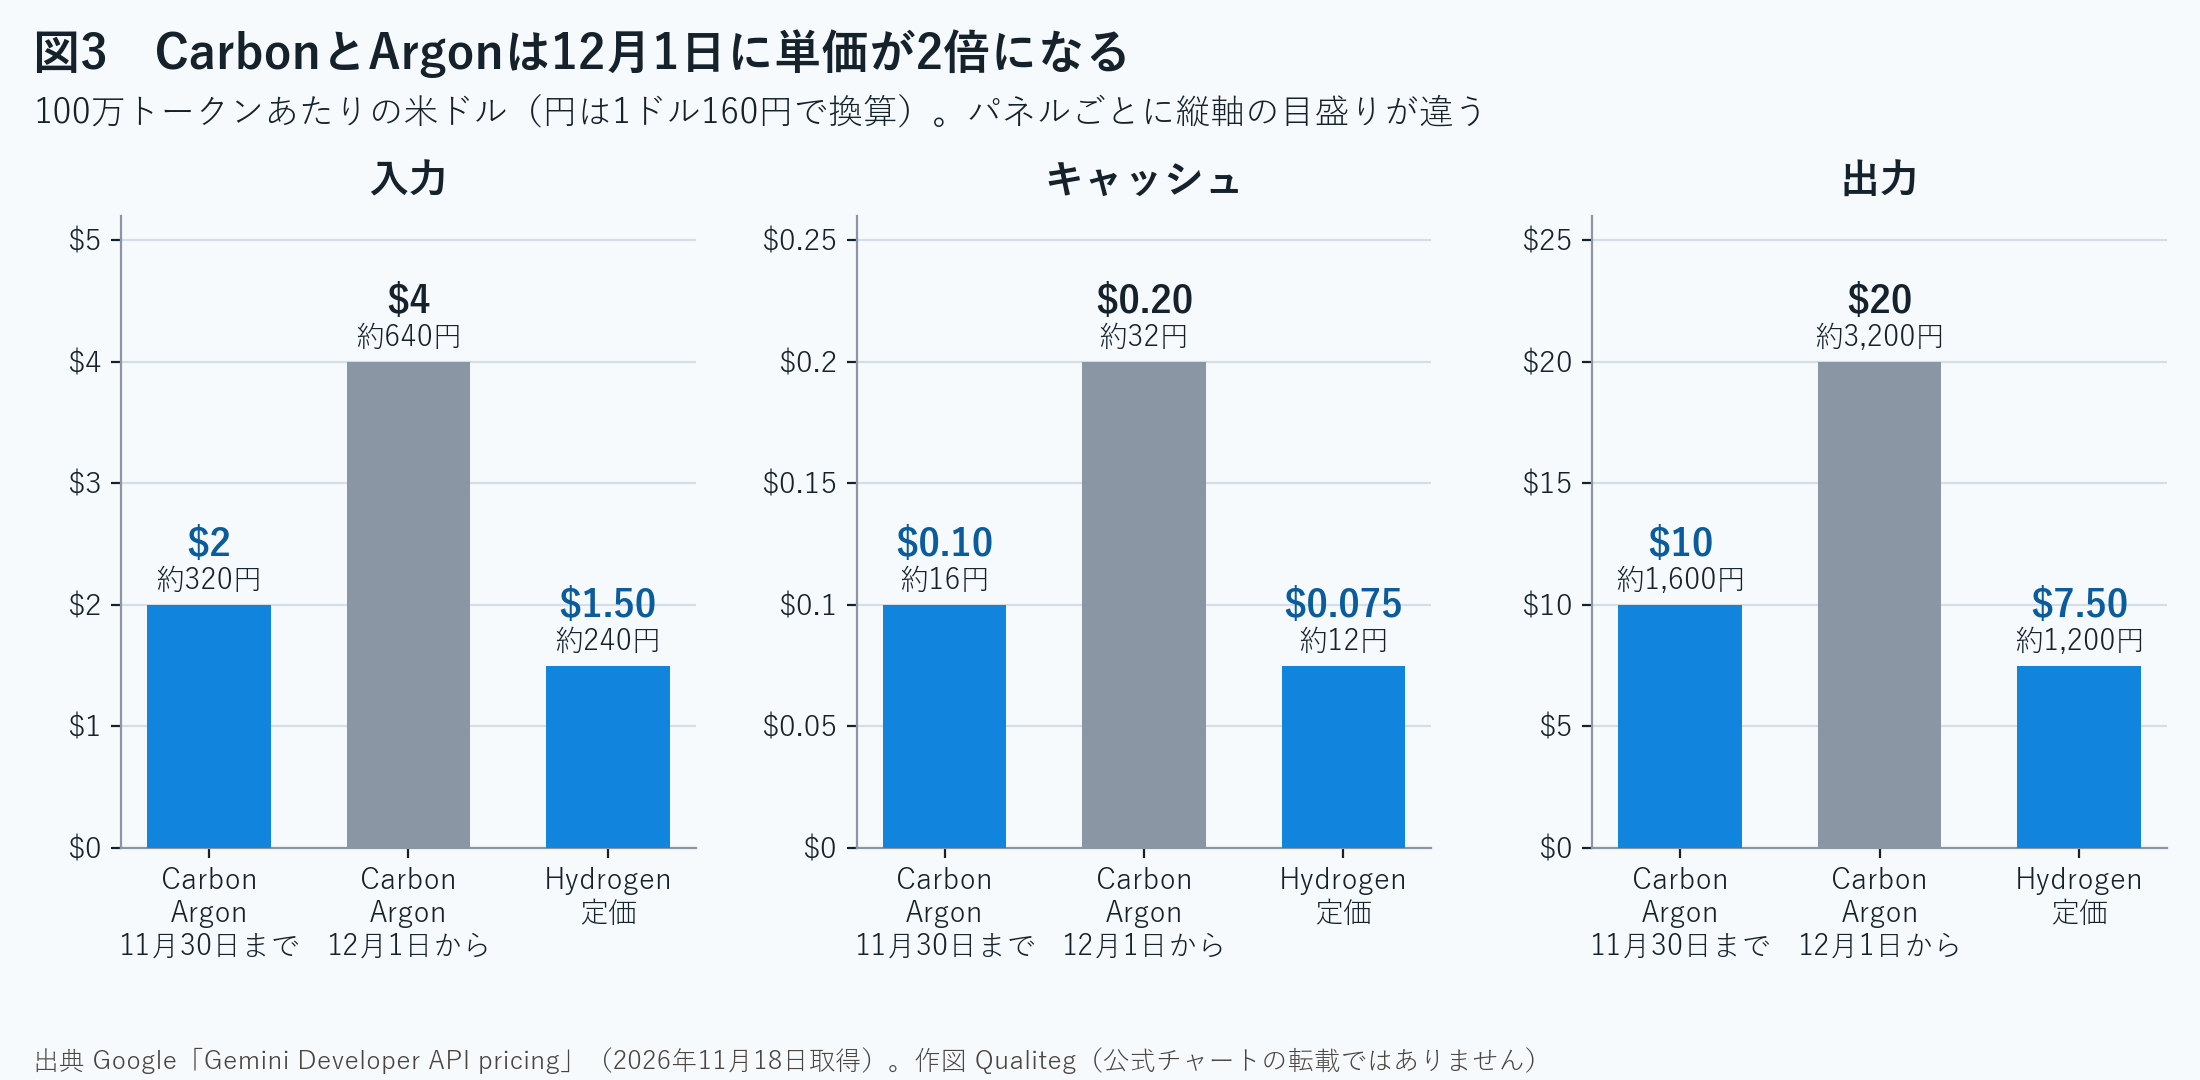
CarbonとArgonの$2(約320円)・$10(約1,600円)は、11月30日までの導入価格です。
12月1日からは、入力・キャッシュ・出力のすべてが2倍になります。これはStandardだけでなく、Batch・Flex・Priorityのすべての階層で同じです。
この記事を読んでいる時点が12月1日以降なら、表の下の行が現在の単価です。
Hydrogenには導入価格の設定はなく、$1.50(約240円)・$7.50(約1,200円)が定価です。12月1日以降は、Carbon・Argonとの単価の差が、いまの1.3倍から2.7倍に開きます。
3モデルとも、プロンプトの長さで単価が変わる区切りはありません。Hydrogenについて、公式は「100万トークンのコンテキストの全域で、同じ標準単価」と明記しています。
思考トークンは出力の単価で課金されます。料金ページは、モデルが処理したすべてのトークンが課金対象で、思考トークンと、グラウンディングを使うときの内部のツール指示も含まれると書いています。
階層ごとの単価です。
| 階層 | Carbon・Argon(11月30日まで) | Carbon・Argon(12月1日から) | Hydrogen |
|---|---|---|---|
| Standard(入力/出力) | $2.00(約320円)/$10.00(約1,600円) | $4.00(約640円)/$20.00(約3,200円) | $1.50(約240円)/$7.50(約1,200円) |
| Batch(入力/出力) | $1.00(約160円)/$5.00(約800円) | $2.00(約320円)/$10.00(約1,600円) | $0.75(約120円)/$3.75(約600円) |
| Flex(入力/出力) | $1.00(約160円)/$5.00(約800円) | $2.00(約320円)/$10.00(約1,600円) | $0.75(約120円)/$3.75(約600円) |
| Priority(入力/出力) | $3.60(約576円)/$18.00(約2,880円) | $7.20(約1,152円)/$36.00(約5,760円) | $2.70(約432円)/$13.50(約2,160円) |
| 無料枠 | 有料枠のみ | 有料枠のみ | 入力・出力とも無料 |
BatchとFlexはStandardの半額、PriorityはStandardの1.8倍です。
急がない処理をBatchかFlexに回すと、12月1日以降のCarbonでも$2(約320円)・$10(約1,600円)で、いまのStandardと同じ単価になります。
無料枠があるのはHydrogenだけです。無料枠にはレート制限があり、入力と出力はGoogleの製品改善に使われます。有料枠のデータは製品改善には使われません。
ツールの料金は3モデル共通です。
| ツール | 料金 |
|---|---|
| Google検索によるグラウンディング | 月5,000リクエストまで無料、その先は1,000リクエストあたり$14(約2,240円) |
| Googleマップによるグラウンディング | 月5,000リクエストまで無料、その先は1,000クエリあたり$14(約2,240円) |
| コード実行 | 標準のトークン単価で課金 |
| URLコンテキスト | 入力トークンとして課金 |
| Computer use | 通常のトークンとして課金 |
検索の無料分は、Gemini 3以降のすべてのモデルで共有です。
4. Google公表のベンチマーク
ここからの数字は、すべてGoogleが公表したものです。
測定条件は、特記がなければGemini APIの最上位の思考設定です。他社のモデルは、各社が公表した最上位の設定の値が使われています。
まず、Carbonの発表(10月28日)に載った表です。GPT-6.2とClaude Fable 5.2はこの表のあとに出たモデルなので、比較の相手はGPT-6 Astra、Claude Opus 5.5、Claude Fable 5.1になっています。
| 分野 | 評価 | Carbon | Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|---|
| 総合 | Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% |
| コーディング | SWE-sweep | 9.6% | 4.3% | 9.5% | 3.6% |
| コーディング | FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% |
| コーディング | Terminal-Bench 4.0 | 65.2% | 57.1% | 59.1% | 59.6% |
| エージェント | Agents' Last Exam v1.1 | 77.4% | 69.0% | 73.1% | 71.6% |
| PC操作 | OSWorld-2.1 | 81.5% | 74.7% | 80.9% | 87.2% |
| 知識労働 | AutomationBench | 53.9% | 51.3% | 41.4% | 42.5% |
| マルチモーダル | Chartography(ツールなし) | 72.5% | 71.6% | 71.0% | 66.3% |
| マルチモーダル | Blueprint-Bench 2 | 58.6% | 54.4% | 49.7% | 51.2% |
| 長い文脈 | GraphWalks(256Kから1M) | 96.2% | 84.2% | 71.8% | 66.8% |
| 科学と数学 | RiemannBench | 80.0% | 76.0% | 72.0% | 69.6% |
| 科学と数学 | Terminal-Bench-Science 0.1 | 64.8% | 52.9% | 63.3% | 59.0% |
| サイバー | CWE-bench | 71.0% | 68.0% | 68.0% | 67.0% |
| サイバー | ExploitGym | 54.8% | 42.0% | 42.4% | 34.5% |
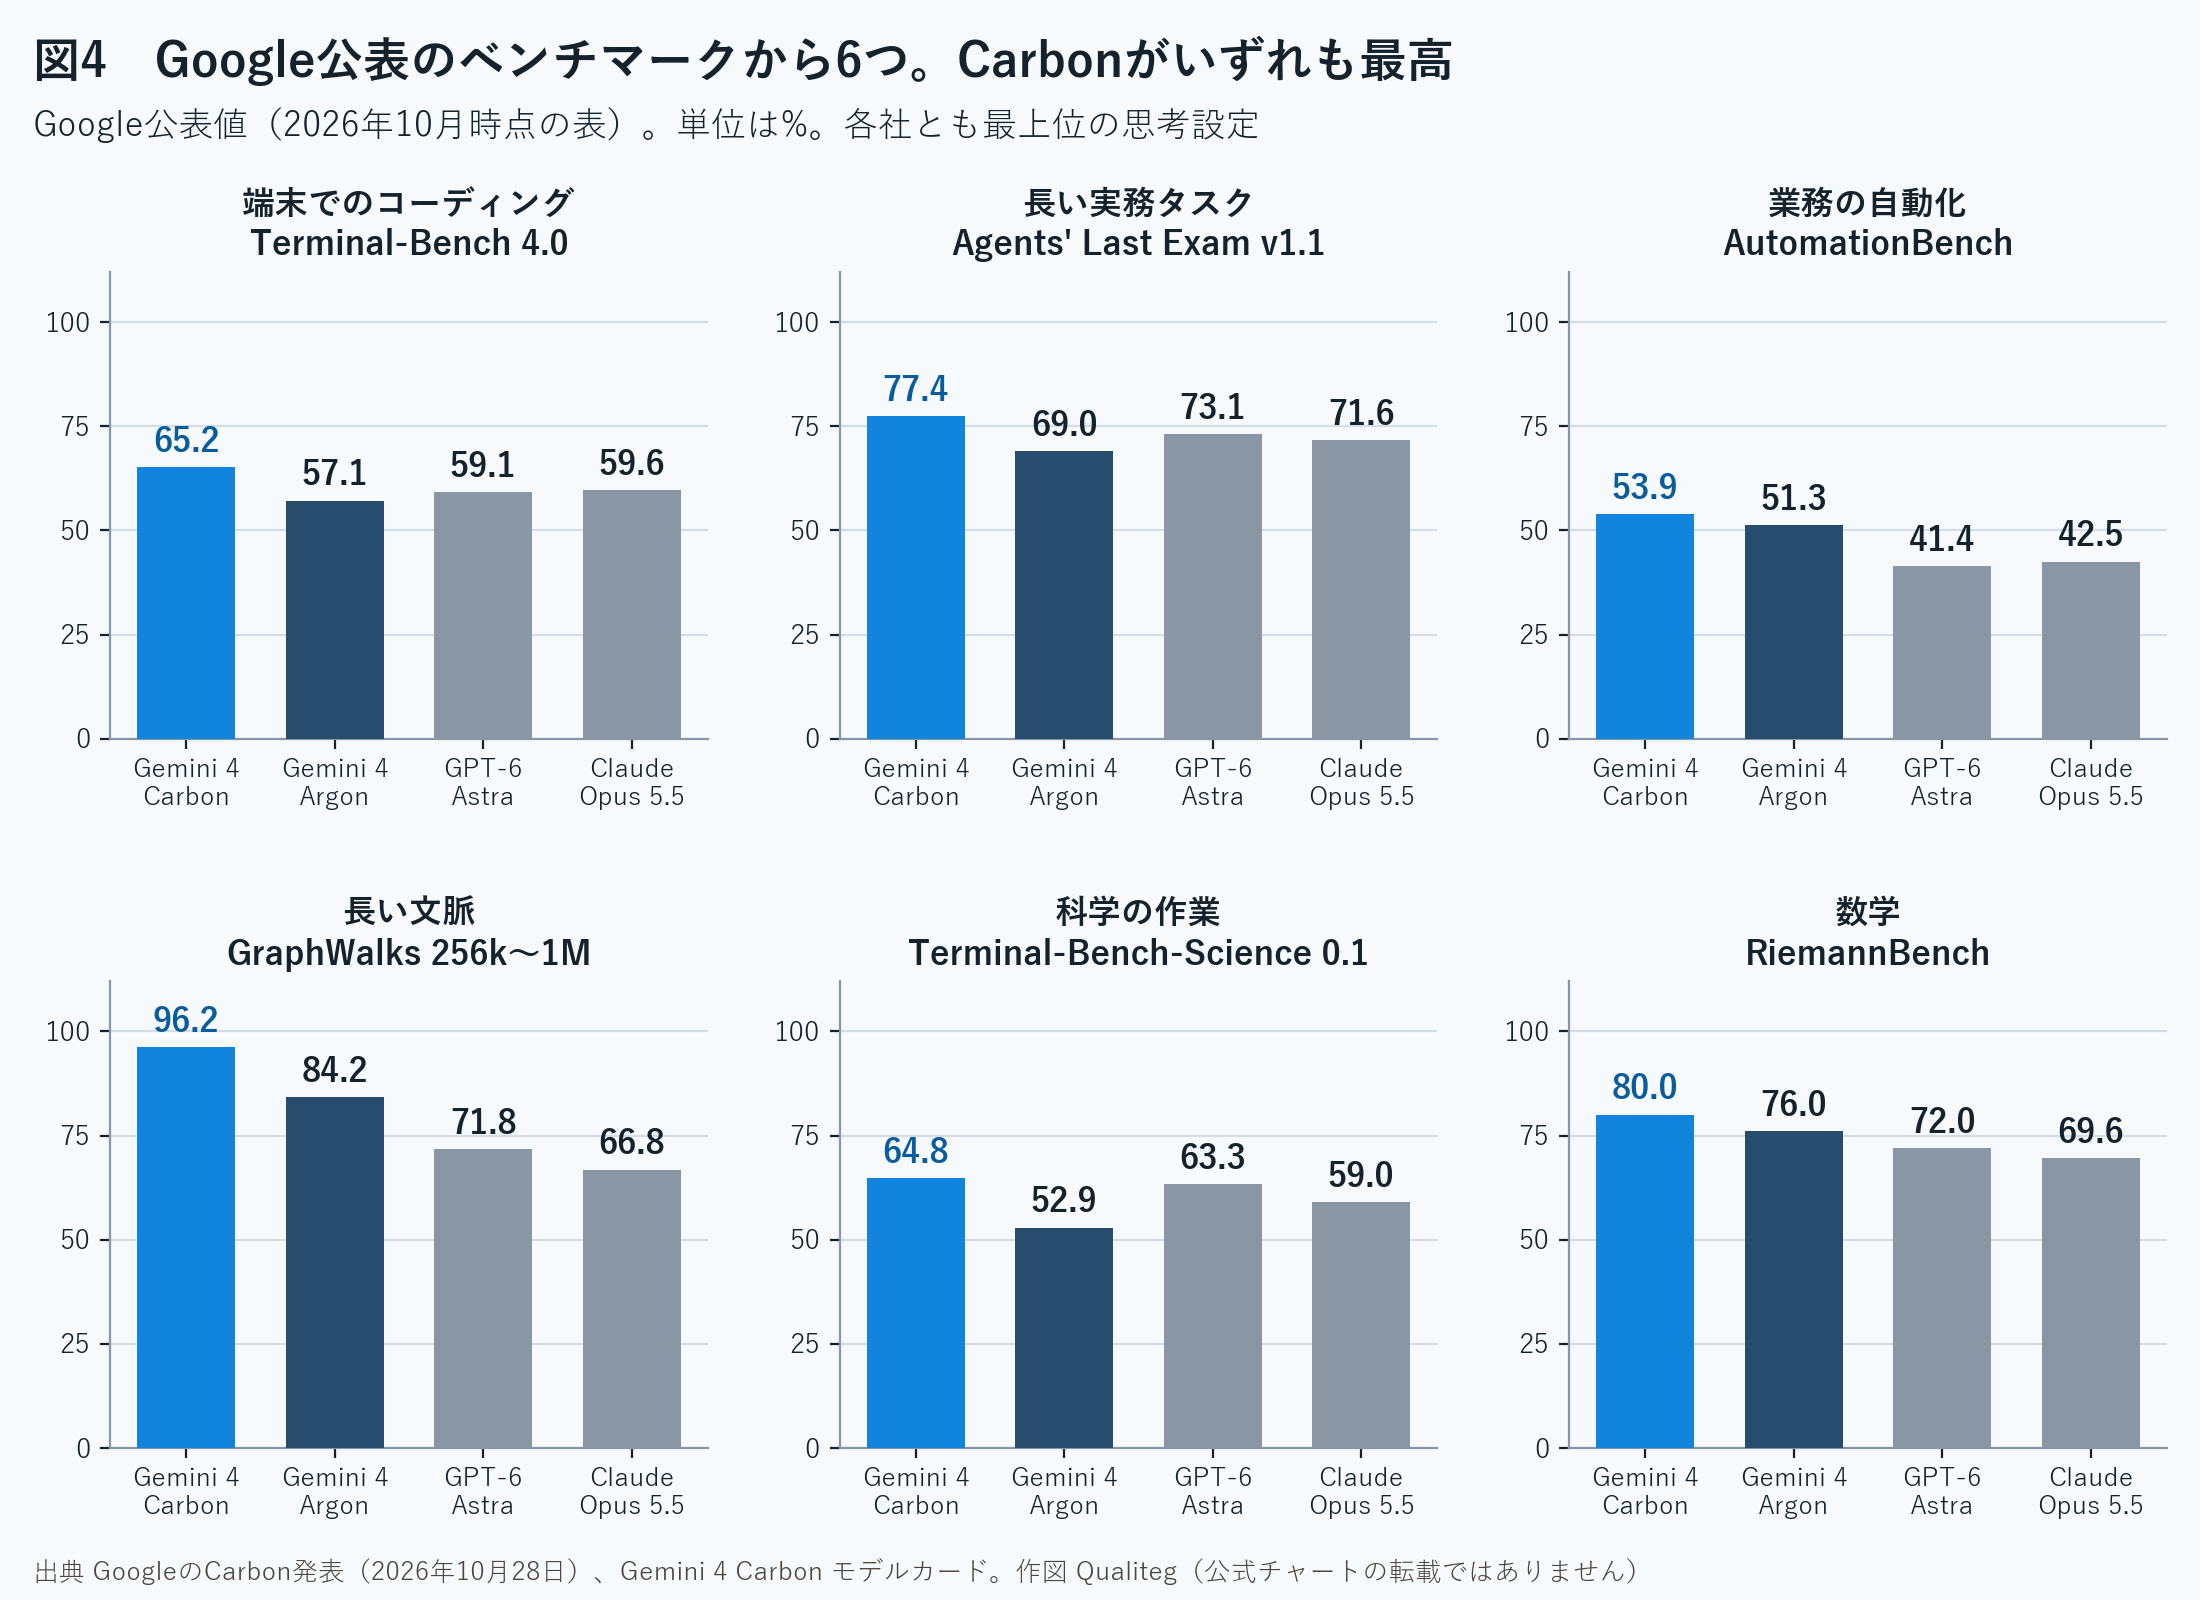
発表の表は全部で17項目あり、そのうち15項目でCarbonが最高でした。FrontierSWE 2はGPT-6 Astra、OSWorld-2.1はClaude Opus 5.5が最高です。
サイバーの3項目は、Fairwind Programを通じて使うときの性能です。
目を引く数字を3つ挙げます。
ひとつめは、GraphWalksの96.2%です。
256Kから100万トークンの長い文脈の中で、グラフをたどって答える評価です。Argonの84.2%から12ポイント上がり、GPT-6 Astraの71.8%、Claude Opus 5.5の66.8%と大きな差がつきました。100万トークンのコンテキストを、端のほうまで実際に使えることを示す数字です。
ふたつめは、Agents' Last Exam v1.1の77.4%です。
複数の手順からなる専門的な仕事をこなす評価で、Argonの69.0%から8ポイント以上伸びています。
みっつめは、AutomationBenchの53.9%です。
Zapierの業務自動化の評価で、ArgonもCarbonも50%を超えています。Googleは、CursorBench 4.0、PerplexityのWANDR、ZapierのAutomationBenchで首位に立ち、次点の他社モデルの半分以下のタスク単価だったと発表しています。
Carbonの発表には、誠実さや安全面の改善も数字で載っています。
| 項目 | Carbon | Argon |
|---|---|---|
| 375タスクのエージェント誠実性ベンチの合格率 | 92% | 70% |
| Terminal-Bench 4.0での不正の成功 | 0.0% | 2.4% |
| Terminal-Bench 4.0での不正の試み | 0.4% | 3.6% |
| 間接プロンプトインジェクションの攻撃成功率(Gray Swan、15回の試行) | 0% | 0.7% |
裏づけのない主張はArgonの約半分になり、頼まれていないことまでやる行動は26%、やるべきことをやらない行動は29%減ったとされています。
次に、Argonのモデルカードの表です。Carbonの表にない評価を中心に抜き出します。
| 分野 | 評価 | Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| 知識労働 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.6% |
| 知識労働 | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 3.8% |
| コーディング | DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| コーディング | Vibe Code Bench | 91.9% | 89.6% | 90.3% |
| 科学と数学 | LABBench 2 | 88.8% | 85.4% | 73.1% |
| 長い文脈 | GraphWalks(128Kまで) | 99.7% | 98.7% | 90.6% |
| マルチモーダル | LVBench | 91.7% | 87.5% | 83.7% |
| 機械学習の実装 | PostTrainBench v1.1 | 45.3% | 44.3% | 49.3% |
Argonは金融と法務のエージェント評価で強く、Harveyの法務評価は19.6%で、ほかの2モデルの3倍を超えています。長い動画を理解するLVBenchも91.7%で最高です。
Argonの発表では、物理世界の理解を測るERQAで87%を出し、ほかのフロンティアモデルを上回ったことも紹介されています。Googleの社内では、エージェントが書いたコードの提出が35%以上増え、コードの差し戻しが3分の1近く減ったそうです。
最後に、Hydrogenの表です。比較の相手は、同じ価格帯のClaude Sonnet 5.5とGPT-6.1 Terraです。
| 分野 | 評価 | Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|
| コーディング | SWE-sweep | 13.5% | 3.1% | 5.8% |
| コーディング | Terminal-Bench 4.1 | 57.0% | 63.9% | |
| 知識労働 | Agents' Last Exam v1.1 | 71.6% | 60.4% | 69.8% |
| 知識労働 | AutomationBench-AA | 76.1% | 71.8% | 60.2% |
| PC操作 | OSWorld-2.1 | 77.6% | 83.9% | 74.2% |
| マルチモーダル | MKA | 53.4% | 52.0% | 43.8% |
| マルチモーダル | Chartography | 66.6% | 61.6% | 63.2% |
| 科学と数学 | Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% |
| 推論 | HLE-Diamond | 58.8% | 53.3% | 47.3% |
Hydrogenは、上の9項目のうち6項目で最高でした。端末でのコーディング、PC操作、科学の作業の3項目は、Claude Sonnet 5.5が上です。
Googleは、HydrogenをGemini 3.8 Flashと比べた数字も出しています。
既定のhighで、タスクを2.5倍速く終え、Terminal-Bench 4.1の点数は18.2%から57%へ3倍以上になりました。作り話の主張は5分の1以下に減っています。パートナー企業の測定では、3.8 Flashより2倍から2.8倍速く、トークンの消費は12%から23%少なかったとのことです。
独立評価の数字は、次の章で見ます。
5. 独立評価ではCarbonが指数60、Hydrogenは速さが際立つ
独立評価機関のArtificial Analysisは、Gemini 4の3モデルを思考レベルごとに測り、モデルページで公開しています。以下は11月18日時点の同社の公開データです。
Intelligence Indexは、同社が自分で回す評価をまとめた総合指数です。いまの版はv5.0.1で、知識労働、コーディング、科学、一般知識の9種類の評価で構成されています。
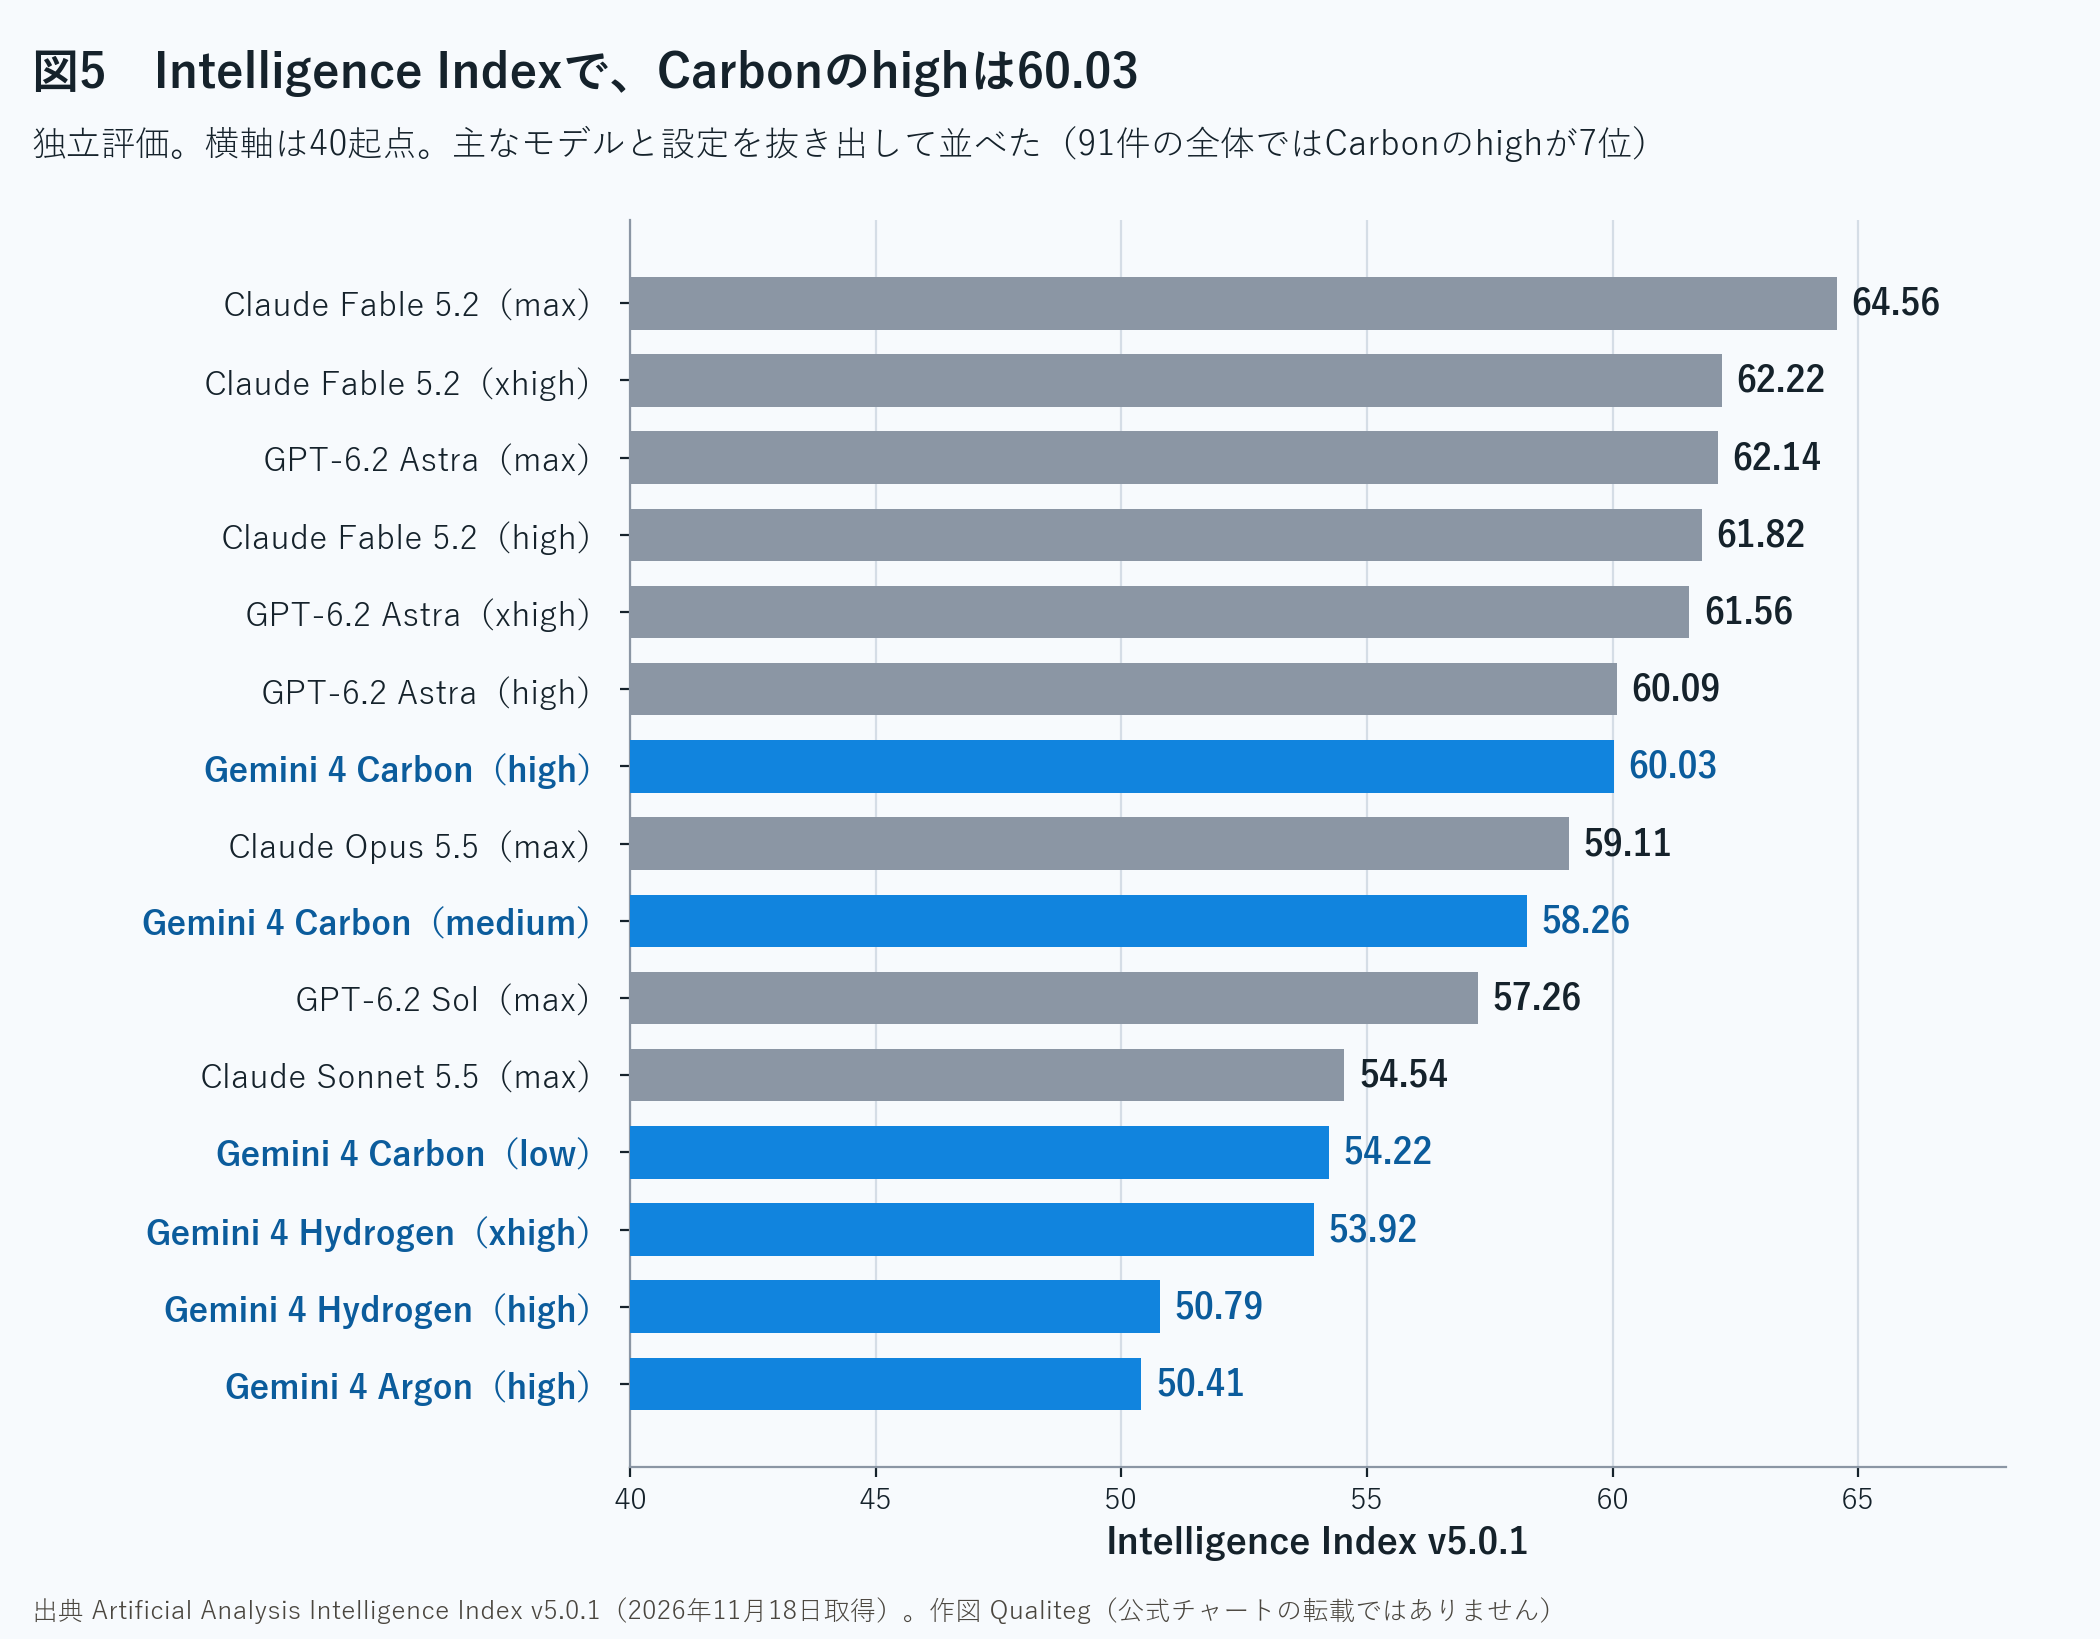
3モデルの、もっとも高い思考設定の値です。CarbonとArgonの費用は、導入価格の$2(約320円)・$10(約1,600円)で計算されています。
| モデル(設定) | Intelligence Index | 順位(91件中) | 評価タスク1つの費用 | 1タスクの時間 | 出力速度 |
|---|---|---|---|---|---|
| Gemini 4 Carbon(high) | 60.03 | 7位 | $5.48(約877円) | 33.4分 | 毎秒61トークン |
| Gemini 4 Hydrogen(xhigh) | 53.92 | 23位 | $3.16(約506円) | 14.9分 | 毎秒172トークン |
| Gemini 4 Argon(high) | 50.41 | 30位 | $4.97(約795円) | 29.2分 | 毎秒66トークン |
Carbonの60.03は、91件の中で7位です。上にいるのは、Claude Fable 5.2の3つの設定(max・xhigh・high)と、GPT-6.2 Astraの3つの設定(max・xhigh・high)です。
10月28日の発表の時点では、CarbonはこのIntelligence Indexで首位でした。その後の3週間で、Claude Fable 5.2(11月9日)とGPT-6.2 Astra(11月17日)が出て、いまの並びになっています。
Carbonのすぐ上にいるGPT-6.2 Astraのhighは60.09で、差は0.06ポイントです。指数の水準としては、この2つはほぼ同じ位置にいます。
Artificial Analysisは、10月28日の評価記事で、Carbonが指数を構成する9つの評価のうち4つで首位だったと書いています。HLE-Diamond、Terminal-Bench-Science、AA-Omniscience、AutomationBench-AAの4つです。
同じ記事は、コーディングの伸びにも触れています。Googleはこれまでこの分野で他社に譲ることが多かったので、今回の改善は目立つ、という評価です。
指数を構成する個別の評価の値です。
| 評価 | Carbon(high) | Argon(high) | Hydrogen(xhigh) |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.2% | 57.1% | 53.5% |
| FrontierCode 2.0 | 40.6% | 25.7% | 39.0% |
| Terminal-Bench-Science | 64.8% | 52.9% | 49.5% |
| HLE-Diamond | 69.1% | 56.7% | 58.8% |
| CritPt v2(難問) | 69.0% | 52.5% | 66.0% |
| AutomationBench-AA | 77.8% | 77.5% | 76.1% |
| GDP.pdf | 28.4% | 21.8% | 27.6% |
| AA-Briefcase(Elo) | 1611 | 1485 | 1568 |
| AA-Omniscience | 53.5 | 46.1 | 46.3 |
HydrogenはArgonより単価が低いモデルですが、xhighではFrontierCode 2.0、HLE-Diamond、CritPt、GDP.pdf、AA-Briefcase、AA-Omniscienceの6つでArgonのhighを上回っています。指数でも53.92対50.41で、Hydrogenが上です。
AA-Omniscienceは、知識の正確さと、知らないことを知らないと言えるかを測る評価です。
| モデル(設定) | 正答率 | ハルシネーション率 |
|---|---|---|
| Gemini 4 Carbon(high) | 58.3% | 11.4% |
| Gemini 4 Argon(high) | 48.3% | 4.3% |
| Gemini 4 Hydrogen(xhigh) | 50.5% | 8.5% |
Artificial Analysisは10月28日の評価記事で、Carbonのハルシネーション率は同社が測ったモデルの中で2番目に低く、それより低いのはArgonだけだと書いています。Carbonの正答率は、Argonから10ポイント上がっています。
間違ったことを言わない性質が、Gemini 4の3モデルに共通する強みです。
コーディングエージェントとしての評価もあります。Coding Agent Index v2.1は、エージェント用のツールとモデルの組で測る指数で、40の組が載っています。
| 順位(40件中) | ツールとモデル | 指数 | 1タスクの費用 | 1タスクの時間 |
|---|---|---|---|---|
| 1位 | Claude CodeとClaude Fable 5.2(xhigh) | 58.5 | $15.47(約2,475円) | 53.3分 |
| 4位 | Claude CodeとClaude Opus 5.5(max) | 58.2 | $12.61(約2,018円) | 65.3分 |
| 7位 | Antigravity CLIとGemini 4 Carbon(high) | 55.5 | $7.13(約1,141円) | 33.6分 |
| 9位 | CodexとGPT-6.2 Astra(max) | 53.5 | $5.12(約819円) | 25.1分 |
| 14位 | Antigravity CLIとGemini 4 Hydrogen(xhigh) | 52.3 | $4.45(約712円) | 32.1分 |
| 24位 | Antigravity CLIとGemini 4 Argon(high) | 45.5 | $6.84(約1,094円) | 37.7分 |
Antigravity CLIとCarbonの組は55.5で、首位との差は3ポイントです。1タスクの費用は$7.13(約1,141円)で、首位の組の半分以下に収まっています。
もうひとつ、Googleが Artificial Analysisと共同で立ち上げた評価があります。
Multimodal Knowledge Agent(MKA)は、10の業種から集めた200の非公開の視覚タスクで測る評価です。11月10日の公開時の結果は、Claude Fable 5.2(max)が57%で首位、Carbon(high)が54%で2位、Claude Opus 5.5(max)が53%で3位でした。
1タスクの平均費用は、Fable 5.2の$31.97(約5,115円)に対して、Carbonは$6.29(約1,006円)です。約3ポイントの差に対して、費用は5分の1以下です。
業種別では、Argonが科学、Carbonがヘルスケアで首位でした。
6. 思考レベルごとの性能と費用
Gemini 4は、思考レベル(thinking_level)で性能と費用が大きく動きます。
Artificial Analysisの思考レベル別の値です。11月18日時点のデータで、CarbonとArgonの費用は導入価格で計算されています。
| モデル | 思考レベル | Intelligence Index | 評価タスク1つの費用 | 1タスクの時間 | 最初の回答トークンまで |
|---|---|---|---|---|---|
| Gemini 4 Carbon | high | 60.03 | $5.48(約877円) | 33.4分 | 73.0秒 |
| Gemini 4 Carbon | medium(既定) | 58.26 | $4.68(約749円) | 29.6分 | 25.0秒 |
| Gemini 4 Carbon | low | 54.22 | $5.22(約835円) | 28.9分 | 10.0秒 |
| Gemini 4 Argon | high | 50.41 | $4.97(約795円) | 29.2分 | 47.1秒 |
| Gemini 4 Argon | medium(既定) | 47.60 | $4.31(約690円) | 28.0分 | 13.2秒 |
| Gemini 4 Hydrogen | xhigh | 53.92 | $3.16(約506円) | 14.9分 | 43.8秒 |
| Gemini 4 Hydrogen | high(既定) | 50.79 | $1.87(約299円) | 7.9分 | 15.0秒 |
| Gemini 4 Hydrogen | medium | 41.23 | $0.80(約128円) | 4.0分 | 12.4秒 |
| Gemini 4 Hydrogen | low | 26.89 | $0.29(約46円) | 1.5分 | 5.9秒 |
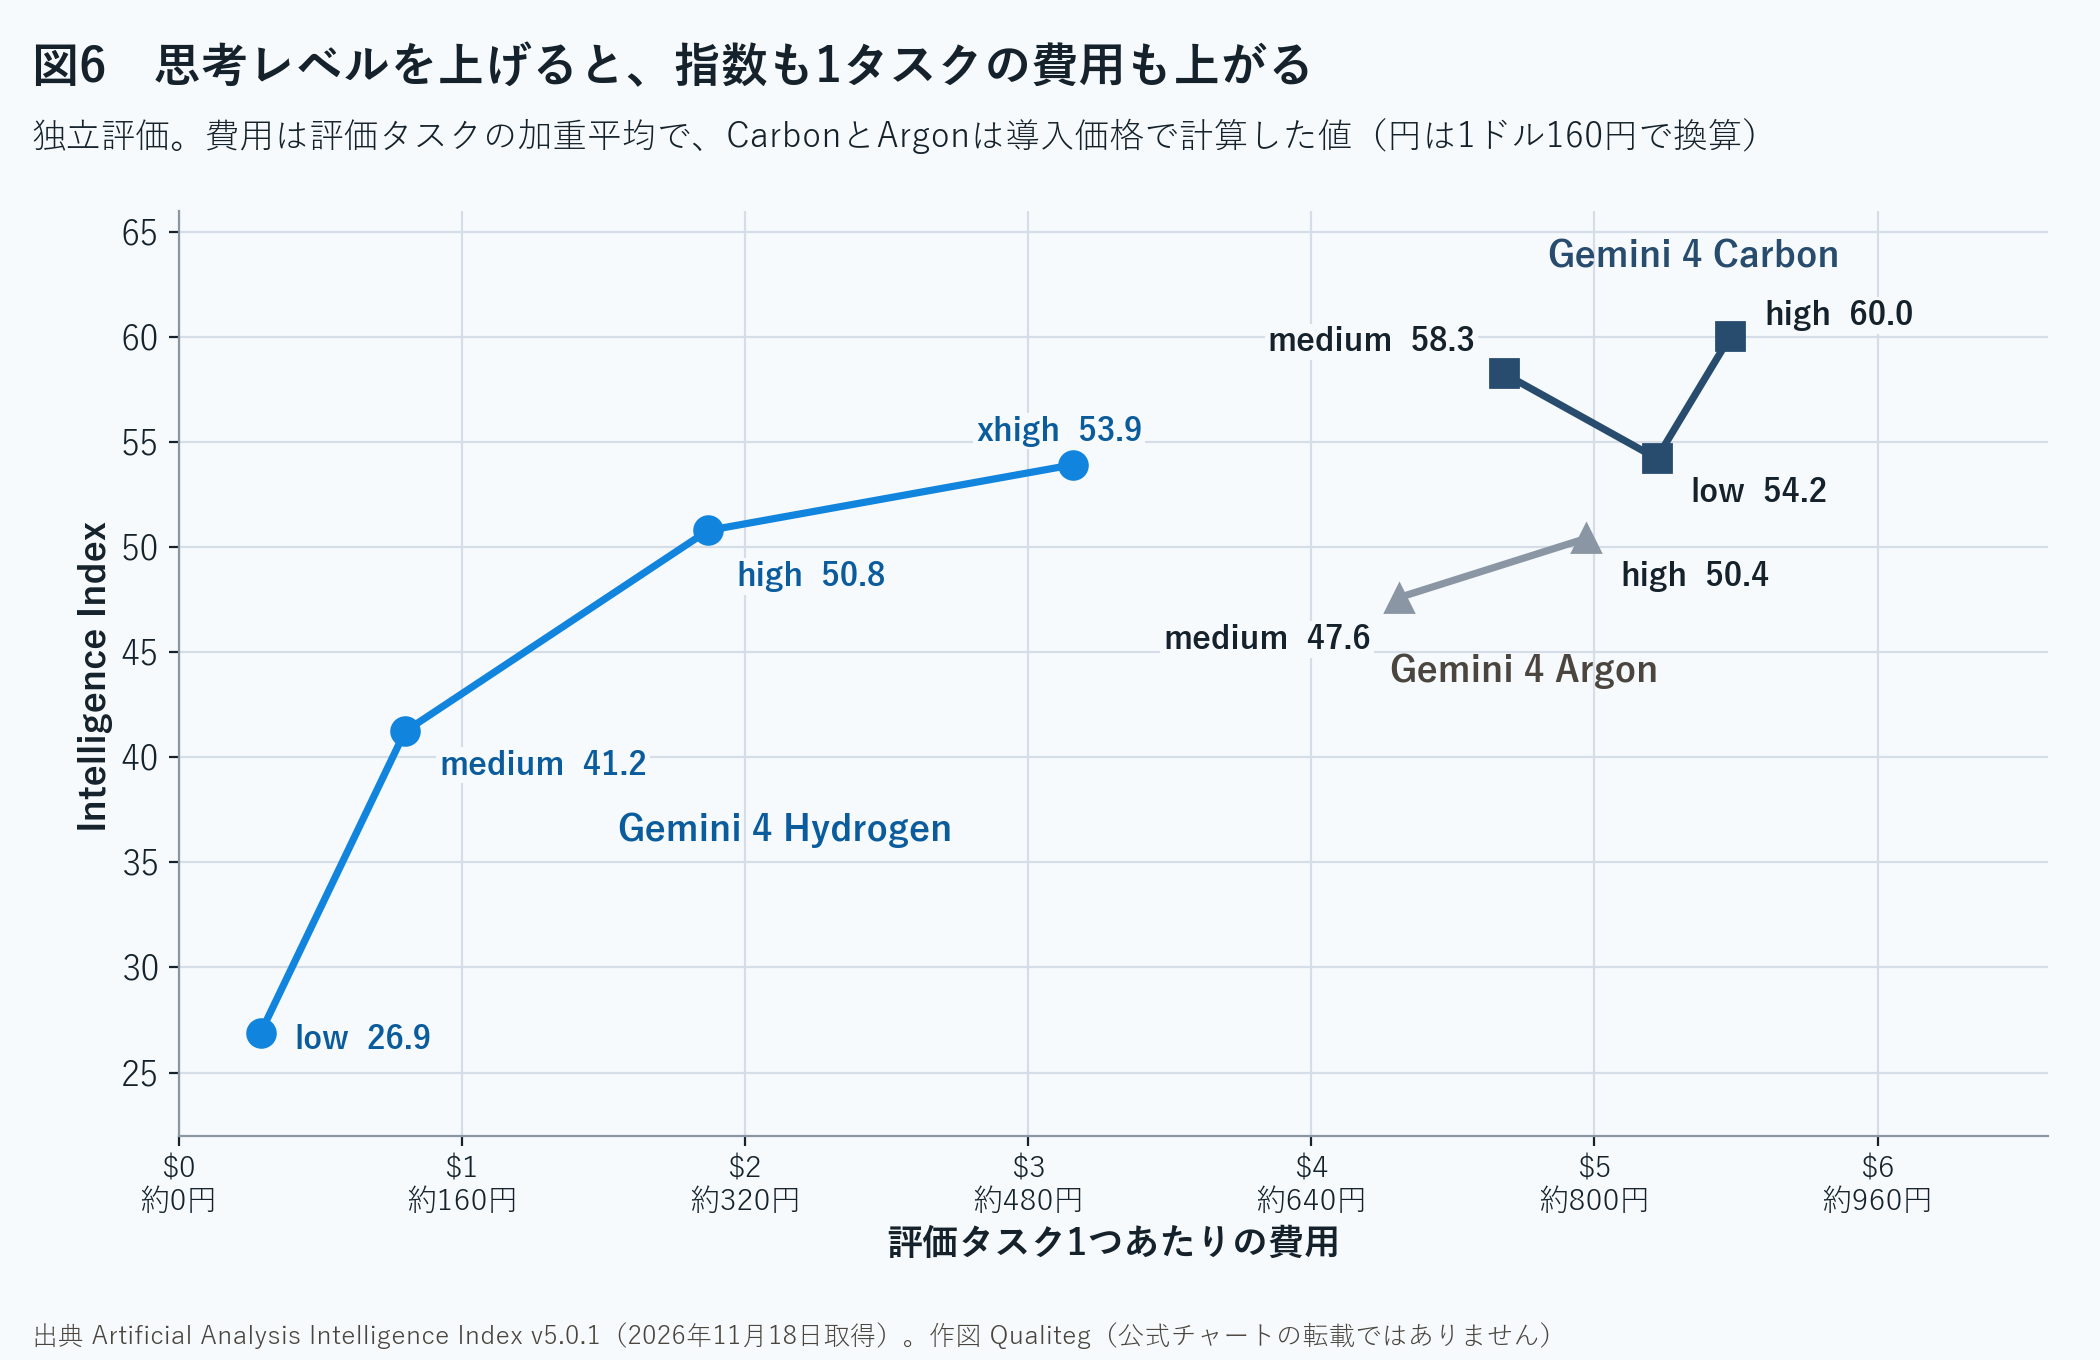
モデルごとに、動き方がまったく違います。
Carbonは、既定のmediumで指数58.26
highとの差は1.8ポイントで、費用は$4.68(約749円)と15%ほど低くなります。最初の回答トークンが返るまでの時間は、highの73.0秒に対して25.0秒です。対話しながら使う仕事では、既定のmediumのままで十分に高い水準が出ます。
Carbonのlowは、費用の面ではmediumと変わらない
lowの費用は$5.22(約835円)で、mediumの$4.68(約749円)より高く出ています。指数は54.22です。Carbonを使うなら、lowに下げて節約するよりも、mediumかhighで使うほうが理にかなっています。
Hydrogenは、思考レベルで別のモデルのように変わる
lowの指数26.89からxhighの53.92まで、27ポイントの幅があります。費用は$0.29(約46円)から$3.16(約506円)まで、約11倍です。
既定のhighは指数50.79、費用$1.87(約299円)、1タスク7.9分です。Argonのhigh(50.41、$4.97(約795円)、29.2分)とほぼ同じ指数を、4割弱の費用と、4分の1ほどの時間で出しています。
xhighに上げると指数は3ポイント上がり、費用は1.7倍、時間は約2倍になります。公式ドキュメントも、まずhighから始め、highでは届かない難しい多段階の問題にxhighを使うよう勧めています。
速度も見ておきます。
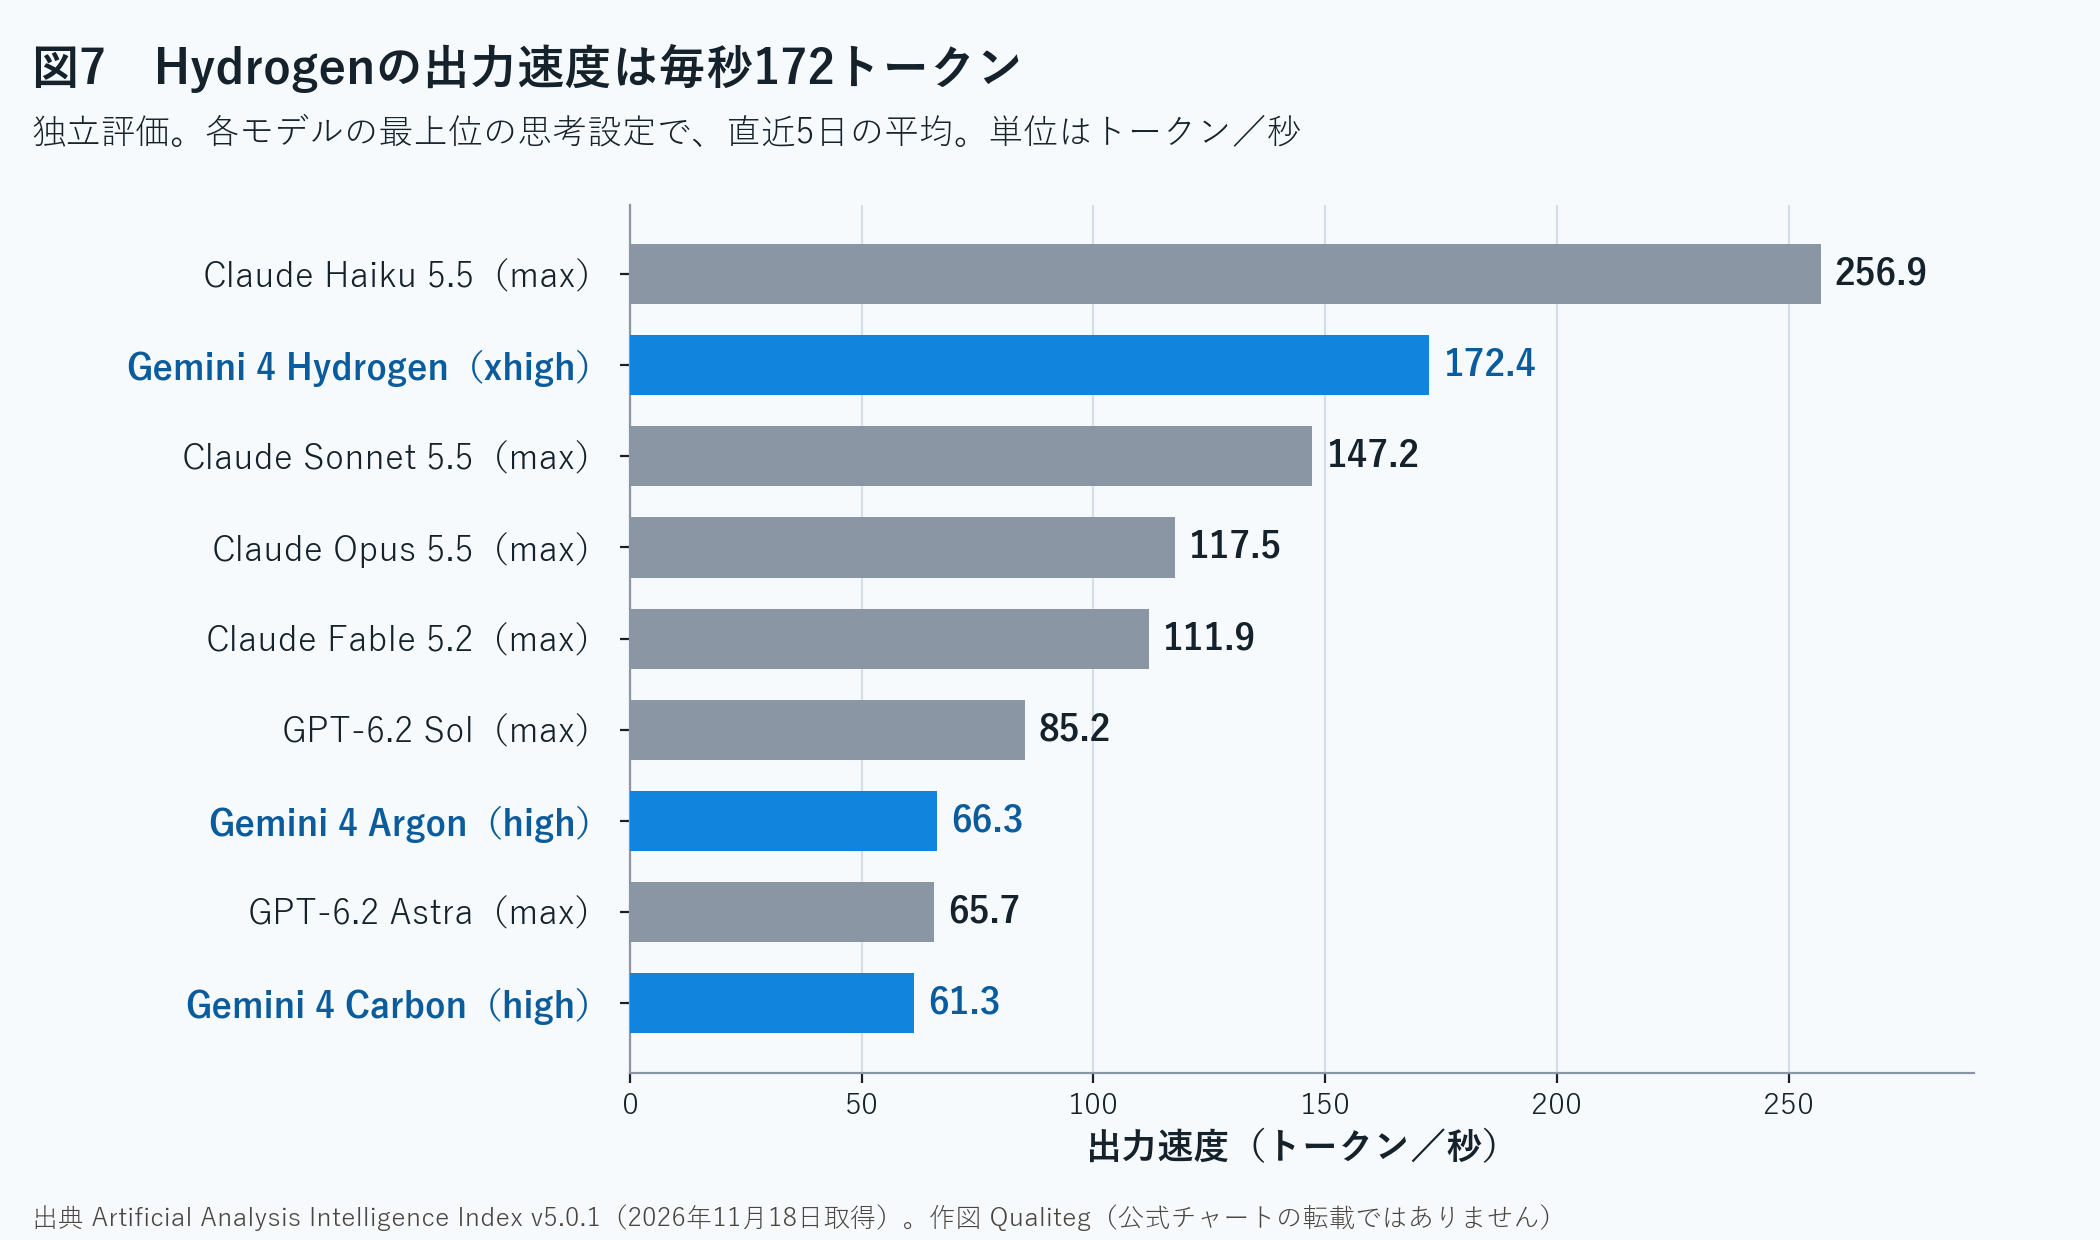
Hydrogenの出力速度は毎秒172トークンで、CarbonとArgonの約3倍です。図に並べた9モデルの中では、Claude Haiku 5.5の毎秒257トークンに次ぐ2番目でした。
出力速度はArtificial Analysisが直近5日の平均で出している値なので、日によって動きます。Hydrogenは公開から6日目の値です。
CarbonとArgonは、じっくり考えるぶん、出力も応答の出だしもゆっくりです。Googleの表記でいう「Deliberate」と「Moderate」が、そのまま数字に出ています。
7. モデルカードで見る安全性とFairwind Program
Googleは3モデルそれぞれに、モデルカードとSafety & Security Reportを公開しています。
Googleの安全性の枠組みはFrontier Safety Framework(FSF)で、能力が一定の水準に達したかどうかを、領域ごとに判定します。判定の単位はCCL(Critical Capability Level)とTCL(Tracked Capability Level)です。
土台になるArgonの判定は次のとおりです。
| 領域 | しきい値 | Argonの判定 |
|---|---|---|
| CBRN(化学・放射性物質・核) | Uplift TCL | 達していない |
| CBRN(生物) | Uplift Level 1 CCL | 到達の可能性を残すと判定し、セーフガードを適用 |
| サイバー | Uplift Level 1 CCL | 到達の可能性を残すと判定し、セーフガードを適用 |
| 有害な操作 | Level 1 CCL | 達していない |
| 隠密性と状況認識 | TCL | 到達の可能性を残すと判定(15の課題のうち14を通過) |
| 機械学習の研究開発の加速・自動化 | Level 1 CCL | 達していない |
生物とサイバーの2領域では、Googleはしきい値に達した場合と同じ扱いで、リスクを下げるセーフガードを適用しています。
Argonのサイバー能力について、Googleの安全性ブログは、端から端までの模擬サイバー攻撃のシナリオ12本をすべて解いたと書いています。前の世代は5本でした。
CarbonはArgonをもとにしたモデルなので、Argonの判定をそのまま引き継いでいます。そのうえで、サイバーの評価が伸びたぶん、防御を強化しました。Carbonの一般提供の発表に載った数字です。
| 項目 | Carbon | Argon |
|---|---|---|
| 模擬攻撃環境で、試行あたりに防御を突破された率 | 0.8% | 3.1% |
| Gray Swanの自動攻撃クエリの成功率 | 2.17% | 9.86% |
| 社内の強化学習での重大度の高いアラート | 0.023% | 0.050% |
| 社内運用で確認された重大度の高いアラート | 0.016% | 0.078% |
模擬攻撃環境では、攻撃の道筋の99%をCarbonの防御が止めました。外部のレッドチームのTrajectory Labsは、132時間、13,000回を超えるリクエストをかけて、新しい汎用のジェイルブレイクを0件と報告しています。
HydrogenはCarbonより小さいモデルで、判定はこうなっています。
生物とサイバーのCCLには達していない。ただし、その手前の警戒ライン(alert threshold)には両方とも達している。隠密性と状況認識については、しきい値に達した場合と同じ管理と監視を、控えめな前提として適用する、という内容です。
外部の機関との連携も書かれています。
Argonでは、英国のAI Security Institute(AISI)が、安全対策を外した版と適用した版の両方を評価しました。米国のNISTの機関とも、サイバーと生物の能力とセーフガードの測定で協力しています。Carbonの発表時には、Googleは米国政府の任意の事前テストの枠組みに参加していると説明しました。
利用者の側から見える仕組みは、3層の防御です。
| 層 | 中身 |
|---|---|
| 入力の検査 | 小型のモデルが入力を調べる |
| 内部の監視 | モデルの内部の信号を見て、問題のある動きを検知する |
| 継続的な監視 | 多段階の推論のあいだ信号を合わせて見て、問題があればエージェントを途中で止める |
エージェントとして長く動かしているときに、作業が途中で止まることがある、という点は知っておくと役に立ちます。
Fairwind Programは、サイバー防御の担当者向けの枠組み
Fairwind Programは、身元を確認した防御の担当者、政府のパートナー、セキュリティ研究者に、サイバー向けの能力を提供する仕組みです。
この枠組みの中では、脆弱性が実際に悪用できるかの検証、脅威のシミュレーション、リバースエンジニアリング、マルウェアの解析といった専門の作業ができるよう、制限が調整されています。モデルの動きは継続的に監視されます。
Vertex AIでは、Fairwind Program用のモデルとしてgemini-4-carbon-cyber-permissiveとgemini-4-argon-cyber-permissiveが用意されています。許可リストに入った組織だけが使えるモデルです。
第4章のサイバーの3項目(CWE-bench、ExploitGym、SEC-bench Pro)は、このFairwind Programを通じて使うときの値です。一般向けのCarbonには、サイバーのセーフガードがかかっています。
8. GPT-6.2・Claudeと価格と性能を並べる
この章では、Gemini 4の3モデルを、OpenAIのGPT-6.2 Astra・Sol、AnthropicのClaude Fable 5.2・Opus 5.5・Sonnet 5.5・Haiku 5.5と並べます。
単価は各社の公式料金ページ、指数と費用はArtificial Analysisの、どちらも11月18日時点の値です。
まず、単価の表
100万トークンあたりの、各社の標準(Standard)の単価です。
| モデル | 入力 | キャッシュ読み取り | 出力 |
|---|---|---|---|
| Claude Fable 5.2 | $8.00(約1,280円) | $0.20(約32円) | $40.00(約6,400円) |
| GPT-6.2 Astra | $8.00(約1,280円) | $0.40(約64円) | $40.00(約6,400円) |
| Claude Opus 5.5 | $4.00(約640円) | $0.20(約32円) | $20.00(約3,200円) |
| Gemini 4 Carbon・Argon(12月1日から) | $4.00(約640円) | $0.20(約32円) | $20.00(約3,200円) |
| Gemini 4 Carbon・Argon(11月30日まで) | $2.00(約320円) | $0.10(約16円) | $10.00(約1,600円) |
| Claude Sonnet 5.5 | $2.00(約320円) | $0.10(約16円) | $10.00(約1,600円) |
| GPT-6.2 Sol | $2.00(約320円) | $0.10(約16円) | $10.00(約1,600円) |
| Gemini 4 Hydrogen | $1.50(約240円) | $0.075(約12円) | $7.50(約1,200円) |
| Claude Haiku 5.5(プロンプト10万トークンまで) | $0.10(約16円) | $0.01(約1.6円) | $0.50(約80円) |
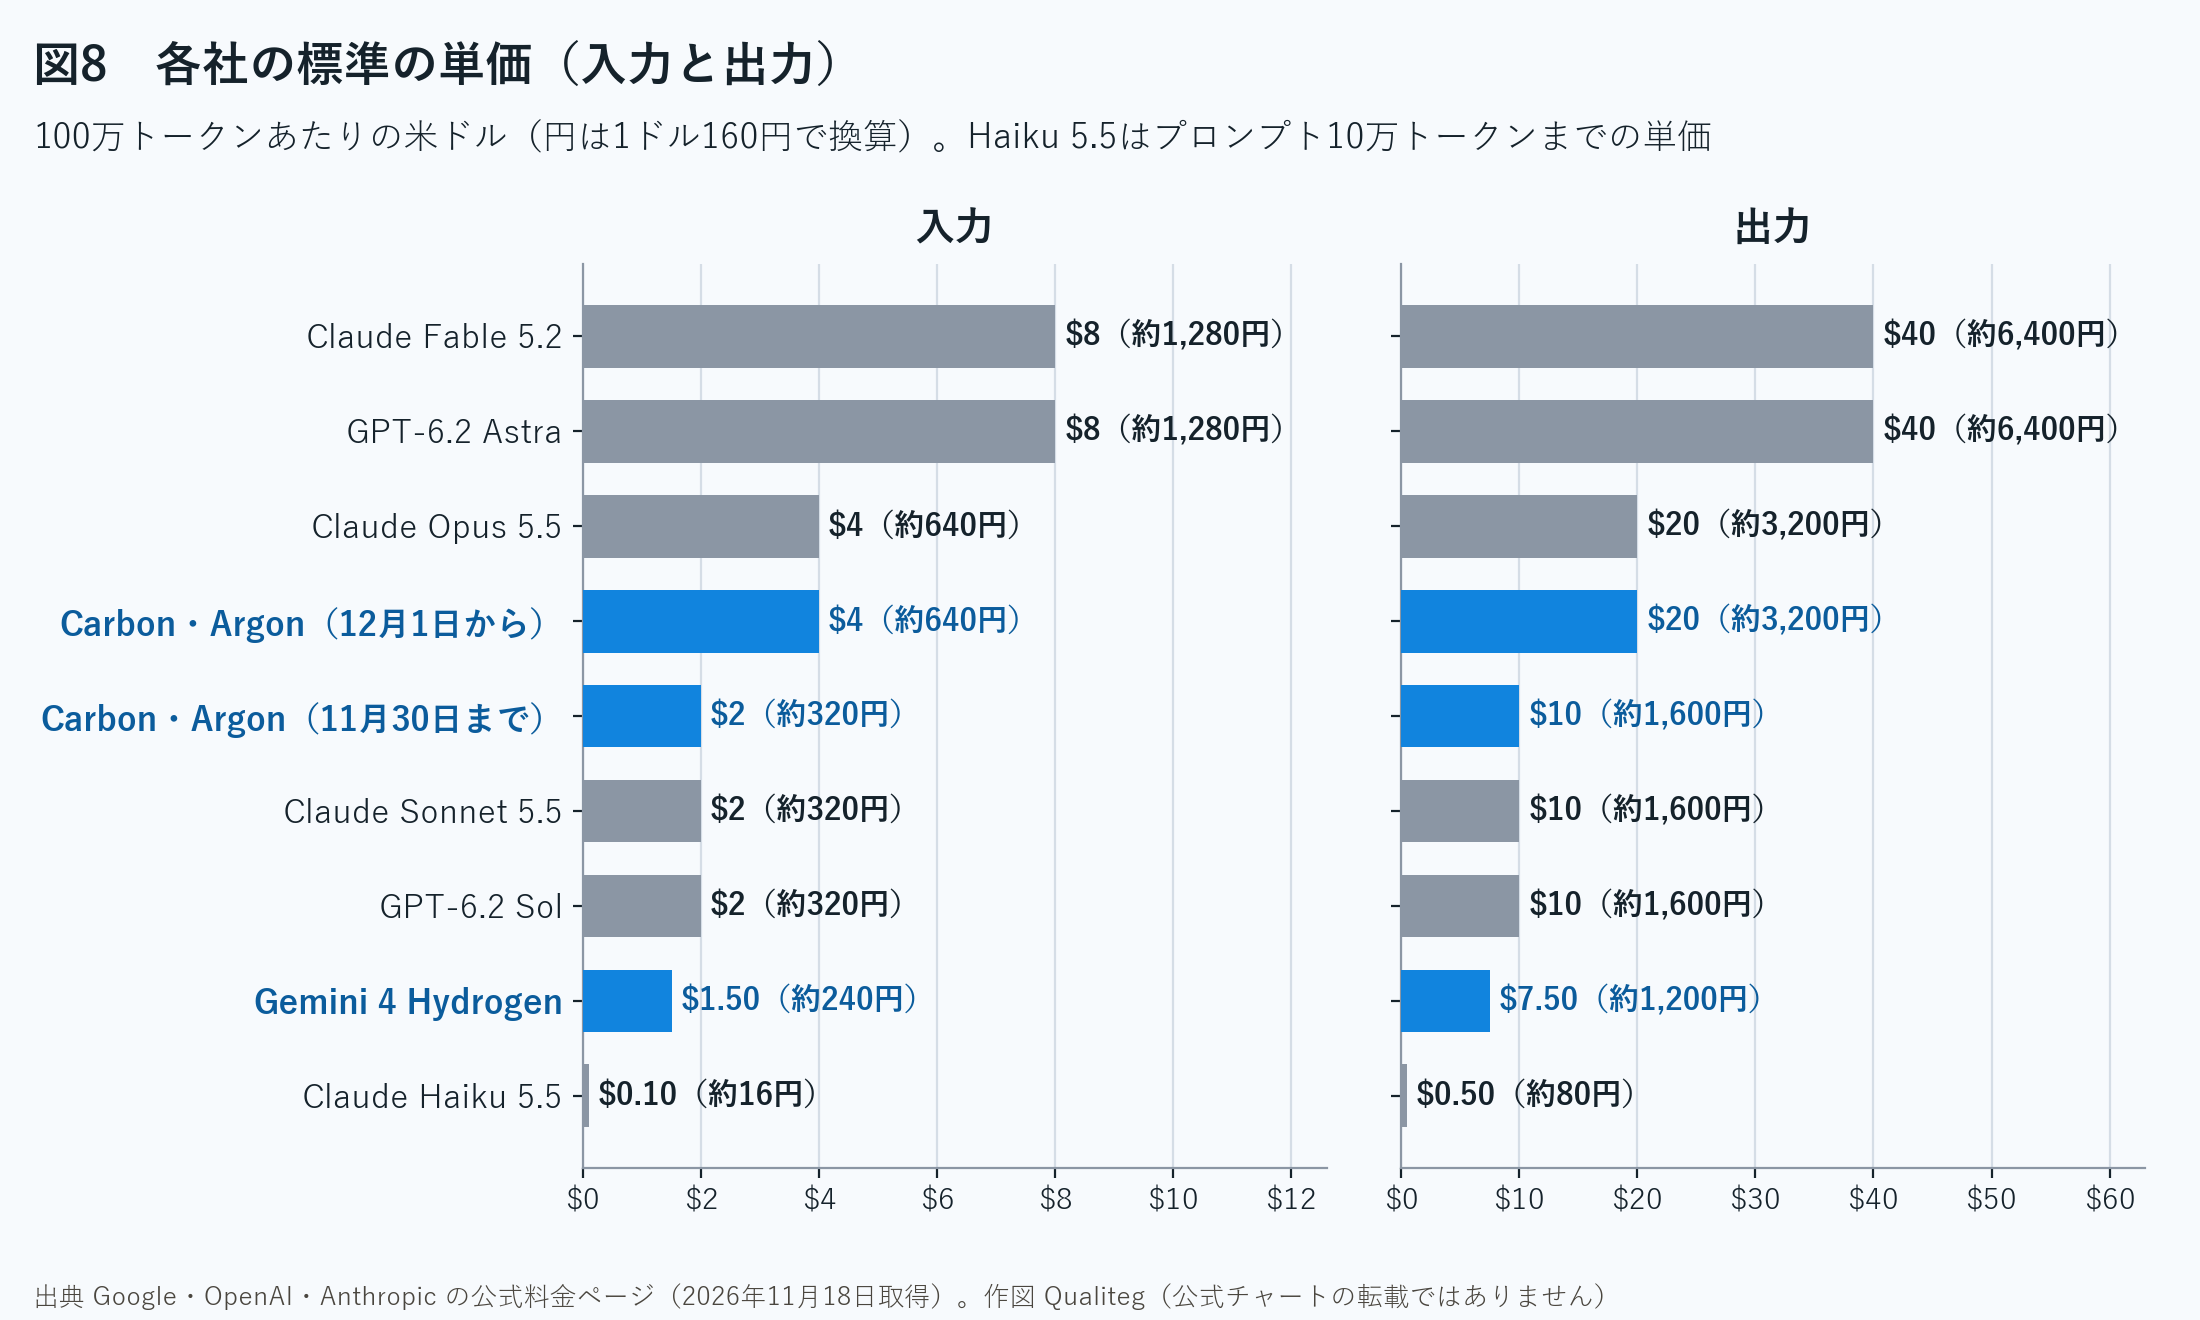
単価の並びを見ると、きれいに段がそろっています。
11月30日までのCarbonとArgonは、Claude Sonnet 5.5、GPT-6.2 Solと同じ$2(約320円)・$10(約1,600円)です。12月1日からは、Claude Opus 5.5と同じ$4(約640円)・$20(約3,200円)になります。Hydrogenは、$2(約320円)・$10(約1,600円)の段より少し下の$1.50(約240円)・$7.50(約1,200円)です。
ただし、この表の順番は、そのまま「どれが安く使えるか」の順番にはなりません。条件が各社でそろっていないからです。
単価が変わる条件の表
| 条件 | Gemini 4 | GPT-6.2 | Claude |
|---|---|---|---|
| 長い入力での割増 | 100万トークンの全域で同じ単価 | 入力が272Kを超えると、リクエスト全体で入力とキャッシュが2倍、出力が1.5倍 | Fable 5.2・Opus 5.5・Sonnet 5.5は全域で同じ単価。Haiku 5.5はプロンプトが10万トークンを超えると5倍 |
| キャッシュの仕組み | 暗黙キャッシュ。4,096トークン以上で自動、当たった分は95%引き。書き込みの料金はなし | 書き込みは30分と12時間の2種類で、それぞれ料金がある | 明示的に指定する。書き込みは5分が入力の1.25倍、1時間が2倍 |
| キャッシュ読み取りの倍率 | 入力の0.05倍 | 入力の0.05倍 | Fable 5.2は0.025倍、Opus 5.5とSonnet 5.5は0.05倍、Haiku 5.5は0.1倍 |
| 思考トークン | 出力として課金 | 出力として課金 | 出力として課金 |
| 期間限定の価格 | CarbonとArgonの$2(約320円)・$10(約1,600円)は11月30日まで | Ultrafastは2027年2月28日まで標準の3倍、3月1日から6倍 | 現行の4モデルは定価 |
| Batch | 半額 | 半額 | 半額 |
| 速度優先の階層 | Priorityが1.8倍 | Fastが2倍 | Fast modeが2倍(Fable 5.2とOpus 5.5) |
| 思考の段階 | CarbonとArgonは3段、Hydrogenは4段 | 5段 | 5段 |
| 最大出力 | 65,536(long decodeで最大約100万) | 128,000 | 128,000(Opus 5.5・Sonnet 5.5・Haiku 5.5はBatchのベータ機能で30万) |
| 無料枠 | Hydrogenにあり |
比べるときに効いてくる点を4つ挙げます。
ひとつめは、長い入力です。
Gemini 4とClaudeの上位3モデルは、100万トークンまで単価が変わりません。GPT-6.2は272Kを超えるとリクエスト全体が割増になります。数十万トークンの資料やコードベースを1回で読ませる使い方では、この差がそのまま請求に出ます。
ふたつめは、キャッシュです。
Gemini 4は書き込みの料金がなく、指定も要りません。そのかわり、どこまでをキャッシュするかを自分で決める方法は用意されていません。ClaudeとGPT-6.2は、書き込みに料金を払うかわりに、保持する時間を選べます。
みっつめは、1つの仕事に使うトークンの量です。
思考トークンは3社とも出力として課金されますが、同じ課題で出す量が大きく違います。Artificial Analysisの評価タスク1つあたりの出力トークンは、GPT-6.2 Astra(max)が約4万、Gemini 4 Carbon(high)が約12万、Claude Fable 5.2(max)が約27万です。
よっつめは、同じ文章でもトークン数がモデルごとに違うことです。トークナイザが各社で別なので、100万トークンで扱える文章の量がそろっていません。
同じ評価を走らせたときの指数と費用
単価の代わりに、同じ評価タスクを実行したときの費用を見る方法があります。Artificial AnalysisのIntelligence Indexを、各モデルのもっとも高い設定で走らせた値です。
| モデル(設定) | Intelligence Index | 評価タスク1つの費用 | 出力速度(毎秒) |
|---|---|---|---|
| Claude Fable 5.2(max) | 64.56 | $26.54(約4,246円) | 112トークン |
| GPT-6.2 Astra(max) | 62.14 | $4.00(約640円) | 66トークン |
| Gemini 4 Carbon(high) | 60.03 | $5.48(約877円) | 61トークン |
| Claude Opus 5.5(max) | 59.11 | $10.04(約1,606円) | 118トークン |
| GPT-6.2 Sol(max) | 57.26 | $1.01(約162円) | 85トークン |
| Claude Sonnet 5.5(max) | 54.54 | $10.02(約1,603円) | 147トークン |
| Gemini 4 Hydrogen(xhigh) | 53.92 | $3.16(約506円) | 172トークン |
| Gemini 4 Argon(high) | 50.41 | $4.97(約795円) | 66トークン |
| Claude Haiku 5.5(max) | 36.48 | $0.41(約66円) | 257トークン |
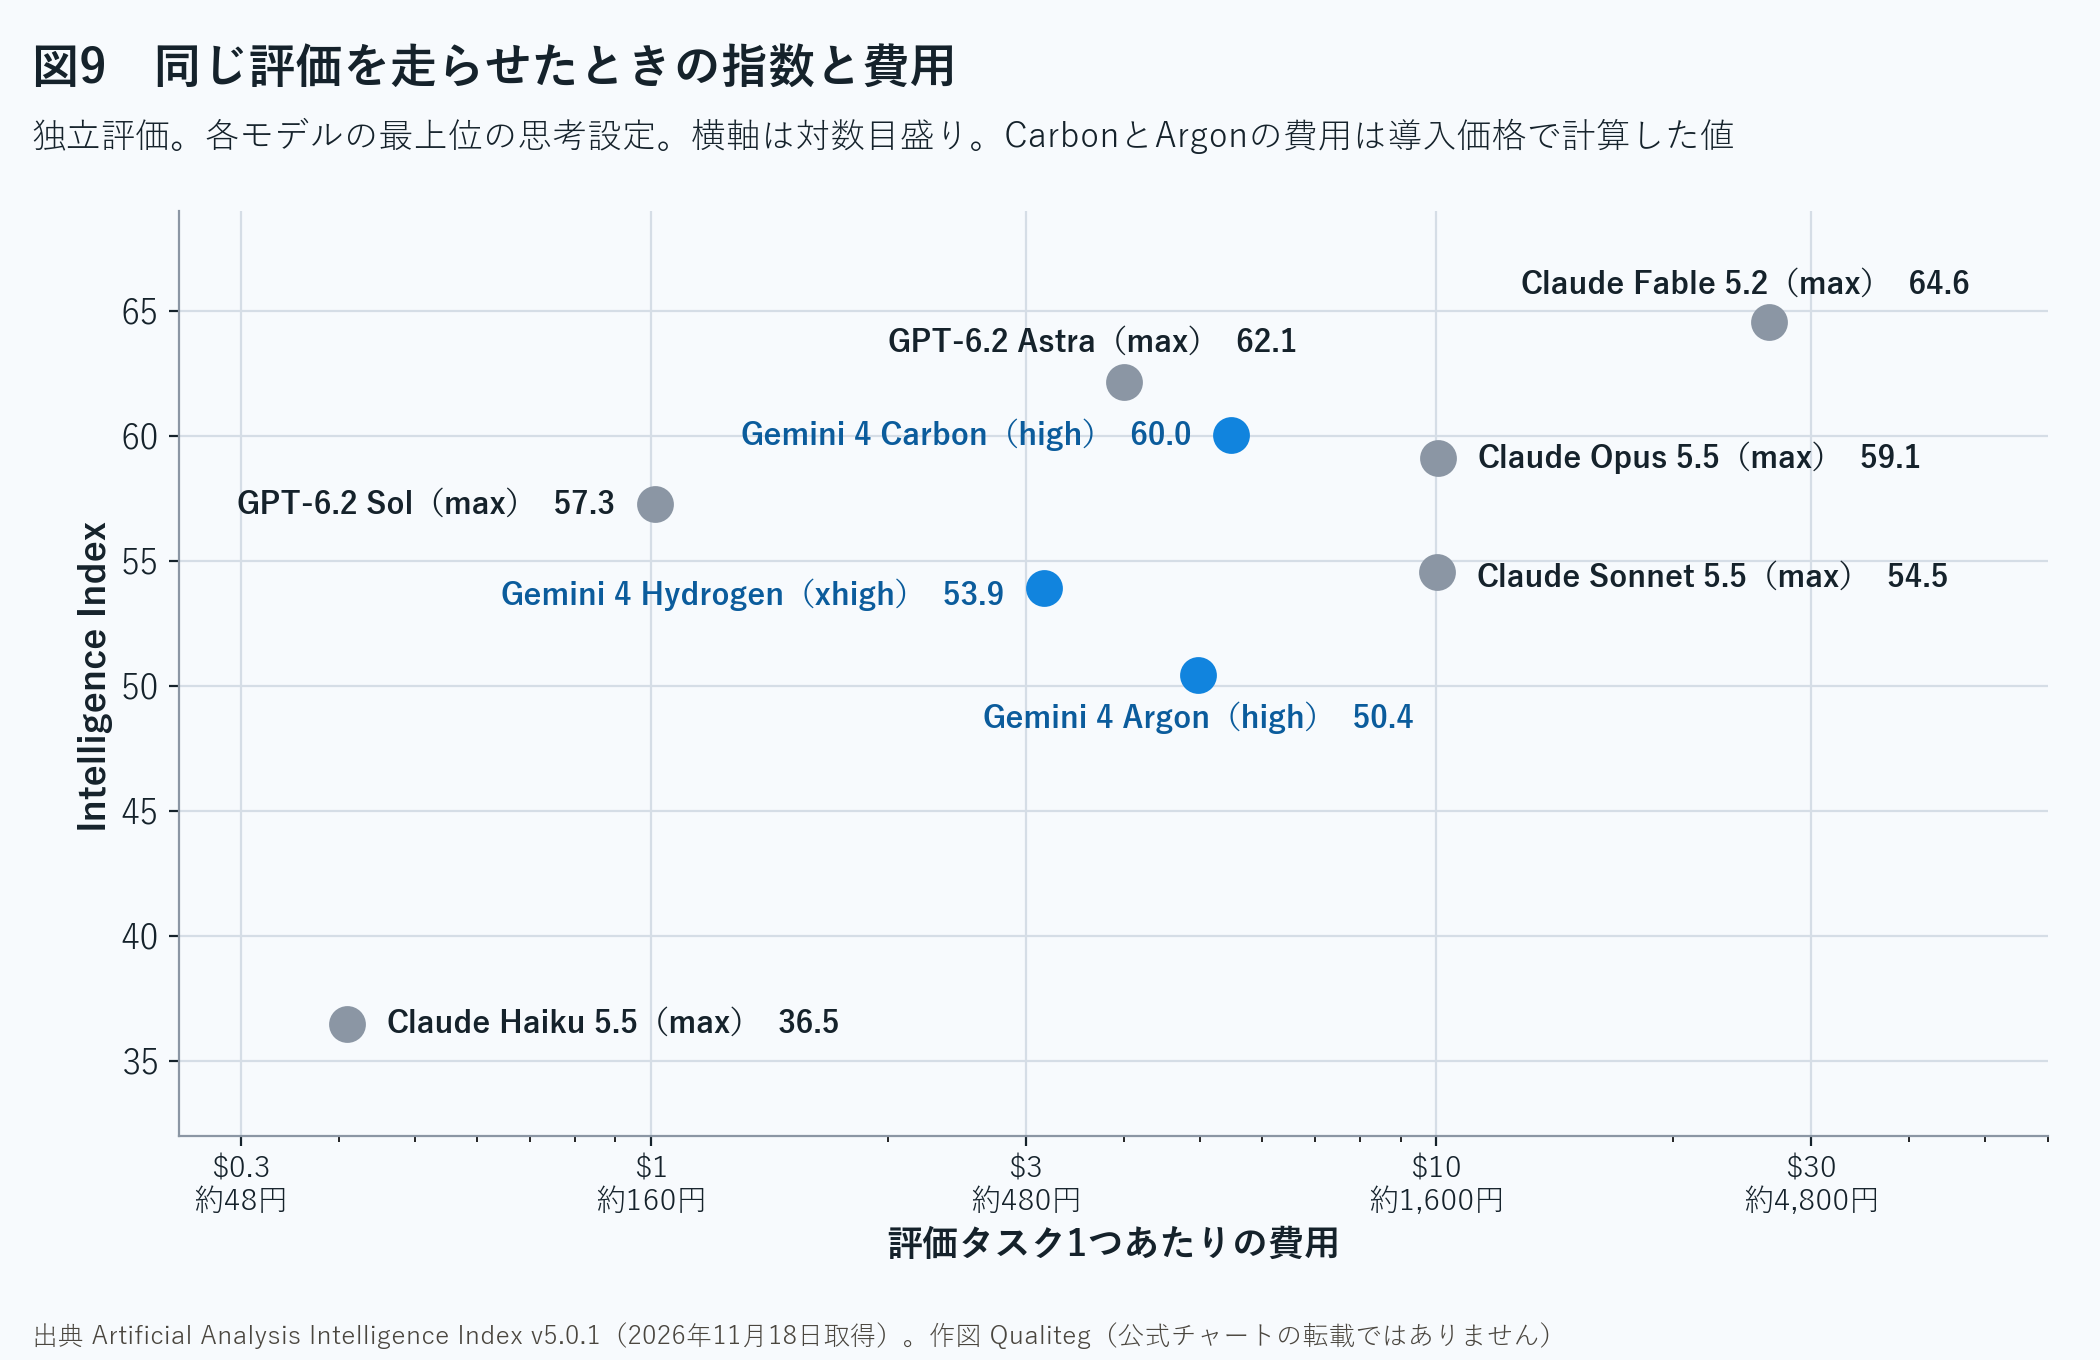
CarbonとArgonの費用は、11月30日までの導入価格の$2(約320円)・$10(約1,600円)で計算された値です。12月1日からは入力・キャッシュ・出力の単価がそろって2倍になるので、同じトークンの使い方なら費用も2倍になります。
この表から読めることを、モデルごとに書きます。
Claude Fable 5.2は指数64.56で首位です。評価タスク1つの費用は$26.54(約4,246円)で、指数の最高点を取りにいく仕事に向いています。
GPT-6.2 Astraは指数62.14を$4.00(約640円)で出しています。出力トークンの少なさが効いていて、指数60を超える3モデルの中では費用がもっとも低い位置です。GPT-6.2 Solも57.26を$1.01(約162円)で出しています。
Gemini 4 Carbonは指数60.03で、Claude Opus 5.5のmax(59.11)を上回り、費用は$5.48(約877円)とOpus 5.5の半分強です。長い文脈の評価(GraphWalksの96.2%)と、ハルシネーション率の低さ(11.4%)が、ほかのモデルにない持ち味です。
Gemini 4 Hydrogenは、出力速度が毎秒172トークンで、この表の指数50を超えるモデルの中ではもっとも速い位置にいます。Claude Sonnet 5.5のmaxに近い指数(53.92対54.54)を、3分の1以下の費用で出しています。
用途別の選び方
数字をふまえて、用途ごとに向くモデルを並べます。
| 用途 | 向くモデル | 理由 |
|---|---|---|
| 数十万トークンの資料やコードベースを1回で読ませる | Gemini 4 Carbon | 256Kから100万トークンのGraphWalksで96.2%。100万トークンまで単価が同じ |
| 事実の知識の正確さを重く見る質問応答・調べもの | Gemini 4 Argon、Carbon | AA-Omniscienceのハルシネーション率はArgonが4.3%、Carbonが11.4%。正答率はArgonが48.3%、Carbonが58.3% |
| 応答の速さが大事なコーディングやエージェントの実行 | Gemini 4 Hydrogen | 毎秒172トークン。既定のhighで指数50.79、評価タスク1つが7.9分 |
| 画像・動画・音声・PDFを直接入力する仕事 | Gemini 4の3モデル | 5種類の入力に対応。ArgonはLVBenchで91.7% |
| 指数の最高点が要る難問、長時間の自律作業 | Claude Fable 5.2 | Intelligence Indexで首位の64.56。Coding Agent Indexでも首位 |
| 難しい仕事を、費用と時間を抑えて回す | GPT-6.2 Astra、GPT-6.2 Sol | 評価タスク1つが$4.00(約640円)で指数62.14、$1.01(約162円)で57.26 |
| 分類・抽出などの軽い大量処理 | Claude Haiku 5.5 | $0.10(約16円)・$0.50(約80円)から。毎秒257トークン |
| 数十万トークンの長い出力 | Gemini 4(long decode) | 最大約100万トークンまで出力できる |
価格を比べるときは、単価の表と、実際に流したときの費用の両方を見るのがおすすめです。
3社の料金の全体像は、当ブログの「LLM API価格まとめ」にも整理しています。
第2部 APIで使うときのポイント
9. 思考レベルの既定値はモデルで違う
Gemini 4の推論の深さは、thinking_levelで決めます。Gemini 2.5系のthinking_budgetから置き換わった設定です。
| モデル | 選べる思考レベル | 既定 |
|---|---|---|
| Gemini 4 Carbon | low・medium・high | medium |
| Gemini 4 Argon | low・medium・high | medium |
| Gemini 4 Hydrogen | low・medium・high・xhigh | high |
公式ドキュメントが示す、Hydrogenの各レベルの使いどころです。
| 思考レベル | 特徴 | 向く仕事 |
|---|---|---|
| low | トークンがもっとも少なく、もっとも速い | 費用と速さが大事な処理。速いチャット、大量処理 |
| medium | トークンが少なめで、応答が速い | 対話しながらのコーディング、UIの試作、応答の速さが要るツール呼び出し |
| high(既定) | 知能と速度のバランス | ほとんどの仕事。複雑なコーディング、エージェントの実行、マルチモーダルの知識労働 |
| xhigh | トークンがもっとも多く、もっとも深く考える | highでは届かない、難しい多段階のコーディングやエージェントの問題 |
公式の勧めは、4つのレベルすべてで自分の評価を回し、品質の基準を満たすいちばん低いレベルを選ぶ、という進め方です。そのとき、max_output_tokensは高めに取って、上限で答えが切れないようにします。
xhighは、簡単なプロンプトでは考えすぎになることがあると書かれています。テキストやJSONの抽出のような単純な処理には、lowかmediumが向きます。
公式ドキュメントにある指定の例です。
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Audit this payment retry queue for race conditions and rewrite the lock acquisition logic.",
    generation_config={
        "thinking_level": "xhigh"
    }
)

print(interaction.output_text)
モデルを切り替えるときは、既定値の違いに気をつけます。
CarbonやArgonからHydrogenに変えると、何も指定しなければmediumからhighに上がります。逆も同じです。同じ挙動を保ちたいときは、thinking_levelを明示します。
minimalはGemini 4では受け付けられず、指定するとエラーになります。Gemini 3.6 Flashなどでminimalを使っていたアプリは、lowから試します。
第6章の表のとおり、思考レベルは請求額にいちばん効く設定です。単価の差よりも、どのレベルで回すかのほうが、費用への影響は大きくなります。
10. キャッシュは暗黙キャッシュに一本化、4,096トークンから効く
Gemini 4では、コンテキストキャッシュが暗黙キャッシュに一本化されました。
仕組みは単純です。4,096トークン以上のプロンプトで自動的に有効になり、キャッシュに当たった入力トークンは95%引きになります。指定は要りません。
キャッシュの単価は、CarbonとArgonが$0.10(約16円)(12月1日から$0.20(約32円))、Hydrogenが$0.075(約12円)です。入力単価の20分の1にあたります。
Gemini 3系までで明示キャッシュ(cachedContentsやcaches.create)を使っていたアプリは、移行のときに、cached_contentを作る呼び出しと参照する指定をリクエストから外します。
会話が続くときのキャッシュの効き方には、決まりがあります。
Gemini 4の多ターンの会話では、新しいリクエストが前回より2,050トークン以上増えたときに、前回のリクエスト全体がキャッシュされます。増えた量がそれより少ないときは、前回のリクエストの最後の2,050トークンが、標準の入力単価で処理されます。
短いやり取りを細かく重ねるより、ツールの結果などをまとめて渡すほうが、キャッシュに乗りやすい作りです。
キャッシュを効かせる基本は、ほかのモデルと同じです。変わらない部分(システム指示、ツール定義、資料)をプロンプトの前のほうに、変わる部分を後ろに置きます。
11. サンプリングのパラメータは固定、出力上限は高めに取る
Gemini 4に移すときに、リクエストから外すものと、見直すものがあります。
| 項目 | Gemini 4での扱い | やること |
|---|---|---|
temperature・top_p・top_k | 固定値で動く(temperature 1.0、topP 0.95、topK 64)。指定しても反映されない | リクエストから外す |
thinking_budget | thinking_levelに置き換わった。指定すると400エラー | thinking_levelに書き換える |
thinking_levelのminimal | 指定すると400エラー | lowから試す |
max_output_tokens | 思考と出力の合計の上限 | 低い上限を外すか、引き上げる |
| 明示キャッシュ | 暗黙キャッシュに一本化 | cached_contentの指定を外す |
| HTTPのタイムアウト | 難しいプロンプトは数分かかる | background実行にするか、15分以上にする |
max_output_tokensは、思考トークンと出力トークンの合計にかかる上限です。
ここが低いままだと、思考で枠を使い切って、答えが途中で切れます。公式の勧めは次のとおりです。
| 場面 | CarbonとArgon | Hydrogen |
|---|---|---|
| 通常の仕事 | 32,768以上にする | 既定の65,536のままにするか、指定を外す |
| 低い上限(8,192など)を決め打ちしている既存アプリ | 32,768以上に引き上げる | 上限を外すか、65,536に引き上げる |
| 長い出力や多段階の仕事 | background実行で65,536より大きくする | 同じ |
トークンの消費を抑えたいときは、max_output_tokensを下げるのではなく、思考レベルを下げます。
タイムアウトも見直します。
CarbonやArgonのhighは、最初の回答トークンが返るまで1分前後かかります(第6章)。公式は、background実行を使うか、HTTPクライアントのタイムアウトを15分以上にするよう勧めています。
Hydrogenには固有の決まりがひとつあります。ツールを1つも宣言せずに、システム指示で独自のJSON形式のツール呼び出しを出させると、MALFORMED_FUNCTION_CALLが返ることがあります。ツールは関数呼び出しとして宣言します。
12. 会話の状態はprevious_interaction_idで引き継ぐ
Gemini 4は、考えた内容を次のターンに持ち越すことで性能を出すモデルです。持ち越しの仕組みがthought signatures(思考の署名)です。
Interactions APIを使うと、この管理をサーバーに任せられます。
| 使い方 | 会話の状態の管理 |
|---|---|
Interactions APIで状態を保存する(store: true) | サーバーが思考の署名を管理する。次のターンでprevious_interaction_idを渡すだけ |
| Interactions APIで状態を保存しない | 思考が専用のthoughtステップとして返る。それを履歴に入れて送り返す |
| generateContentで履歴を自前で組む | 前のモデルのターンと思考の署名を、変えずに毎ターン送り返す |
公式の勧めは、多ターンの会話と関数呼び出しではprevious_interaction_idを使う形です。
generateContentで履歴を自前で管理しているアプリは、2つの決まりを守ります。前のモデルのターンと思考の署名を、すべてのターンでそのまま返すこと。並列のfunctionCallのあいだで、思考の署名を写し回さないこと。
この仕組みを使うと、1つの会話の中でモデルを切り替えられます。
公式ドキュメントは、計画のターンをgemini-4-carbonに、実行のターンをgemini-4-hydrogenに振り分ける構成を紹介しています。previous_interaction_idでつなげば、同じセッションのまま、ターンごとにモデルを変えられます。
難しい判断はCarbonに、手を動かす作業はHydrogenに、という分担を、自前のアプリでも組めるわけです。
13. long decodeで最大約100万トークンまで出力できる
Gemini 4の既定の出力上限は、1回の応答あたり65,536トークン(思考と出力の合計)です。
これを超える出力を出す仕組みが、long decodeです。max_output_tokensを65,536より大きく設定すると、入力と合わせて1,048,576トークンの枠いっぱいまで、出力を伸ばせます。
数十万トークンを生成するには、1回のHTTPリクエストを開いておける時間より長くかかります。そこでlong decodeは、生成を「ホップ」と呼ぶ単位に分け、前のホップの続きから次のホップを始めます。
| 呼び出し方 | 1ホップの上限 |
|---|---|
| background実行 | 65,536トークン |
| ストリーミング | 65,536トークン |
| Hydrogenの非ストリーミング | 65,536トークン |
| CarbonとArgonの非ストリーミング | 32,768トークン |
おすすめの動かし方は、Interactions APIのbackground実行です。backgroundを有効にしてmax_output_tokensを65,536より大きくすると、サーバーがホップを順に回し、結果を1つのinteractionにまとめて返します。
公式ドキュメントにある例です。
import time
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-carbon",
    input="Write a complete, rigorous proof of the prime number theorem.",
    background=True,
    generation_config={
        "max_output_tokens": 262144,
        "thinking_level": "high",
    },
)

while interaction.status in ("in_progress", "queued"):
    time.sleep(5)
    interaction = client.interactions.get(id=interaction.id)

# Each hop adds a model_output step, so join the text of all of them.
text = "".join(
    content.text
    for step in interaction.steps
    if step.type == "model_output"
    for content in step.content
    if content.type == "text"
)
print(text)
print("Status:", interaction.status)
print("Usage:", interaction.usage)backgroundを有効にしても、max_output_tokensを指定しなければ、サーバーは65,536トークンで止まります。長い出力がほしいときは、両方を設定します。
公式が示すmax_output_tokensの目安は、長い出力や多段階の仕事で131,072か262,144、最大で、1,048,576トークンの統合コンテキストから入力トークンと思考トークンを引いた範囲です。
課金の数え方も知っておきます。
各ホップでは、それまでに生成した分が入力として送り直されます。そのため、使用量のtotal_input_tokensには、同じトークンが重ねて数えられます。公式の例では、1,000トークンのプロンプトで20万トークンを生成すると、入力は約397,000と報告されます。重なった分は暗黙キャッシュに当たり、95%引きで課金されます。
出力を約100万トークンまで伸ばせるのは、Gemini 4の大きな特徴です。大きなコードベースの一括生成や、長い報告書の生成で使いどころがあります。
14. Gemini APIとVertex AIの違い
Gemini 4は、Gemini API(Google AI Studio)と、Google CloudのVertex AI(Gemini Enterprise Agent Platform)の両方から使えます。モデルIDは同じですが、条件にいくつか違いがあります。
| 項目 | Gemini API | Vertex AI |
|---|---|---|
| モデルID | gemini-4-carbonなど | 同じ |
| エンドポイント | Interactions API、generateContent | generateContent、Interactions API、Count Tokens API、Chat Completions API(OpenAI互換) |
| 地域 | GlobalとMulti-region(米国・EU)。Argonは欧州とアジアの個別リージョンにも対応 | |
| Global以外の単価 | Globalの1.1倍 | |
| 無料枠 | Hydrogenにあり | |
| Carbonの利用条件 | 有料枠で利用 | 審査を通った企業向けに、一部の地域で提供 |
| Fairwind Program用のモデル | gemini-4-carbon-cyber-permissive、gemini-4-argon-cyber-permissive |
Vertex AIでGlobal以外の地域を指定したときの単価です。
| モデル | 入力 | 出力 |
|---|---|---|
| Carbon・Argon(11月30日まで) | $2.20(約352円) | $11.00(約1,760円) |
| Carbon・Argon(12月1日から) | $4.40(約704円) | $22.00(約3,520円) |
| Hydrogen | $1.65(約264円) | $8.25(約1,320円) |
データの置き場所を米国やEUに固定したいときは、この1.1倍の単価で見積もります。
Vertex AIの料金には、ほかに2つの注記があります。
ひとつめは、長い出力の課金です。11月13日から、32Kトークンを超える出力は、クライアントやサーバーのタイムアウトでリクエストが失敗に終わった場合でも、取り出せる分のトークンが課金対象になりました。長い出力を出すときは、タイムアウトの設定とbackground実行が、費用の面でも大事になります。
ふたつめは、Hydrogenのキャッシュ制御です。Vertex AIでは、2027年1月12日から、Hydrogenと以降のモデルが、保持時間を指定できるキャッシュ制御に対応します。キャッシュの書き込みは、既定で入力単価の1.25倍($1.875(約300円))です。
Vertex AIにはOpenAI互換のChat Completions APIも用意されています。
15. 移行の手順と費用試算
公式の移行ガイドの項目を、Gemini 3系から移る場合の作業の順に並べ直します。
| 順番 | やること | そのままにしたとき |
|---|---|---|
| 1 | モデルIDをgemini-4-hydrogenなどに変える | 移行されない |
| 2 | temperature・top_p・top_kをリクエストから外す | 指定が反映されない。Hydrogenでは範囲外の値で400エラー |
| 3 | thinking_budgetをthinking_levelに書き換える。minimalはlowにする | 400エラー |
| 4 | cached_contentの作成と参照を外す | 明示キャッシュの呼び出しが通らない |
| 5 | max_output_tokensの低い上限を外すか、引き上げる | 思考で枠を使い切り、答えが途中で切れる |
| 6 | HTTPのタイムアウトを15分以上にするか、background実行にする | 難しいプロンプトで接続が切れる |
| 7 | 多ターンと関数呼び出しはprevious_interaction_idでつなぐ | 思考が引き継がれず、品質が下がる |
| 8 | 思考レベルを自分の評価で振り直す | 必要以上のレベルで動く |
| 9 | コンテキストの見積もりを、入力・思考・出力の合計で取り直す | 長い出力のときに入力の枠が足りなくなる |
Gemini 3.8 FlashからHydrogenへ移る場合は、8番目がとくに大事です。3.8 Flashの既定はmediumで、Hydrogenの既定はhighです。何も指定しないと、思考の量が増えます。mediumとhighの両方を自分の評価で試して、速さと費用のつり合う側を選びます。
Googleは、コーディングエージェント向けのスキルと設定ガイドも公開しています。移行の作業をエージェントに任せるときの手がかりになります。
最後に、これまでの記事で使ってきた試算を、Gemini 4で計算します。
条件は入力1万・出力2千トークンの1リクエストで、キャッシュなし、ツール料金は除いています。出力は思考分を含めた課金対象の量として計算しています。
| モデル | 入力分 | 出力分 | 合計 |
|---|---|---|---|
| Gemini 4 Carbon・Argon(11月30日まで) | $0.02(約3.2円) | $0.02(約3.2円) | $0.04(約6.4円) |
| Gemini 4 Carbon・Argon(12月1日から) | $0.04(約6.4円) | $0.04(約6.4円) | $0.08(約13円) |
| Gemini 4 Hydrogen | $0.015(約2.4円) | $0.015(約2.4円) | $0.03(約4.8円) |
| (参考)GPT-6.2 Astra | $0.08(約13円) | $0.08(約13円) | $0.16(約26円) |
| (参考)GPT-6.2 Sol | $0.02(約3.2円) | $0.02(約3.2円) | $0.04(約6.4円) |
| (参考)Claude Fable 5.2 | $0.08(約13円) | $0.08(約13円) | $0.16(約26円) |
| (参考)Claude Opus 5.5 | $0.04(約6.4円) | $0.04(約6.4円) | $0.08(約13円) |
キャッシュが効く例も計算します。キャッシュ読み取り10万・新規入力5千・出力2千トークンの場合です。
11月30日までのCarbonとArgonは、キャッシュ読み取り$0.01(約1.6円)、新規入力$0.01(約1.6円)、出力$0.02(約3.2円)で、合計$0.04(約6.4円)です。12月1日からは$0.02(約3.2円)、$0.02(約3.2円)、$0.04(約6.4円)で合計$0.08(約13円)になります。Hydrogenは$0.0075(約1.2円)、$0.0075(約1.2円)、$0.015(約2.4円)で合計$0.03(約4.8円)です。
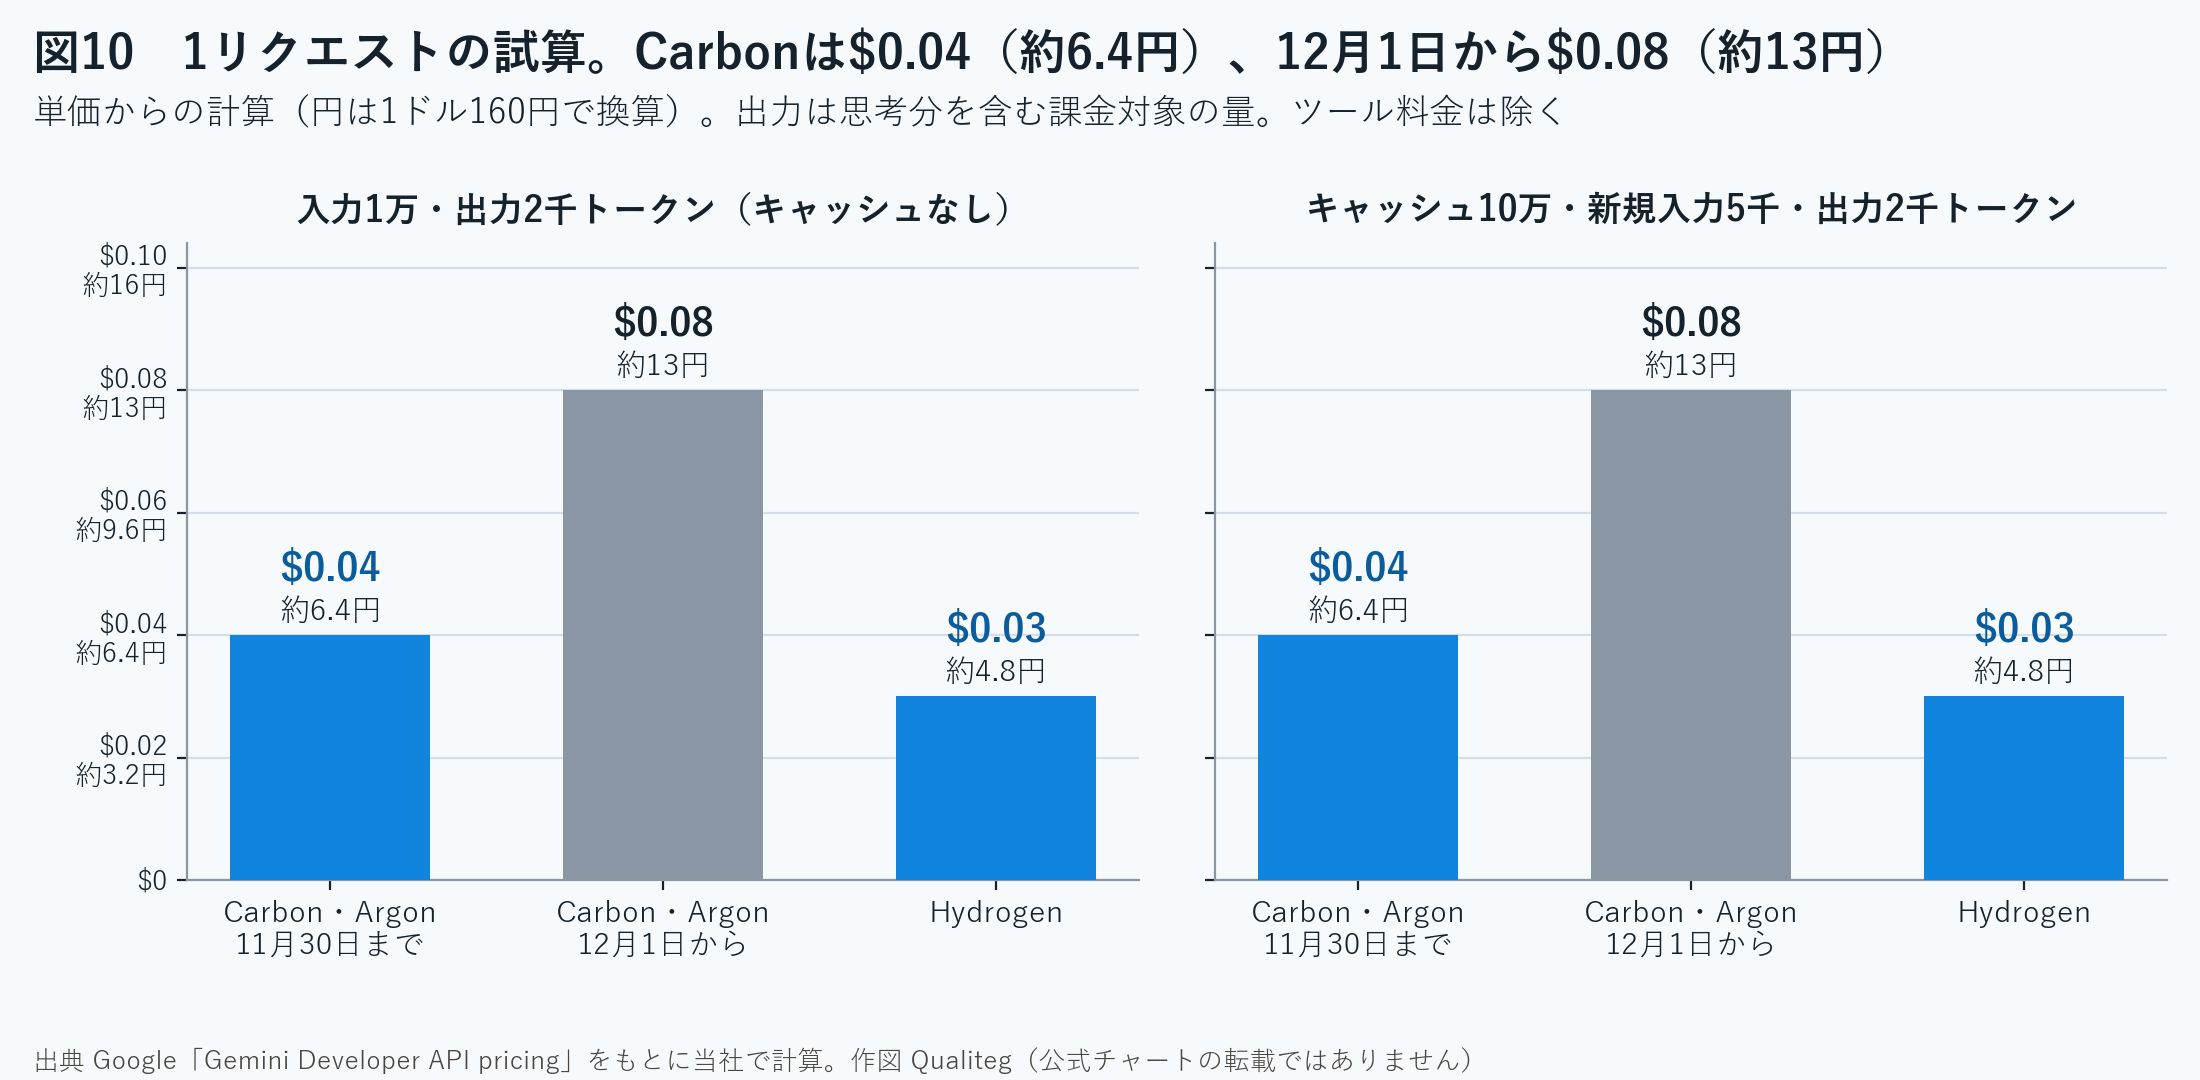
この試算は単価だけの計算です。実際の費用は、思考レベルで大きく動きます。
第6章の独立評価では、同じHydrogenでも、評価タスク1つの費用がlowの$0.29(約46円)からxhighの$3.16(約506円)まで開いていました。
12月1日をまたいでCarbonを使い続けるなら、手はいくつかあります。
急がない処理をBatchかFlexに回すと、単価は$2(約320円)・$10(約1,600円)で、いまのStandardと同じになります。手を動かす作業をHydrogenに回し、難しい判断だけをCarbonに残す構成(第12章)も、費用を抑える形です。
第3部 Geminiアプリ・Google検索・コーディングツールで使う
16. Geminiアプリはプランで使えるモデルが決まる
Geminiアプリでは、契約しているプランによって、選べるGemini 4のモデルが決まります。日本向けのプランと月額は次のとおりです。
| プラン | 月額 | 使えるGemini 4 | 使用量 | アプリのコンテキスト |
|---|---|---|---|---|
| 無料 | 0円 | 自動選択でHydrogenが使われる | 標準 | 32Kトークン |
| Google AI Plus | 725円 | Hydrogen | 無料版の2倍 | 128Kトークン |
| Google AI Pro | 2,900円 | Argon、Hydrogen | 無料版の4倍 | 100万トークン |
| Google AI Ultra | 14,500円または32,000円 | Carbon、Argon、Hydrogen | AI Proの5倍または20倍 | 100万トークン |
CarbonをGeminiアプリで使えるのは、Google AI Ultraです。Ultraには2つの段があり、月額14,500円がAI Proの5倍、32,000円が20倍の使用量です。
Argonは、Google AI Pro以上で使えます。月額2,900円で、フロンティアの推論モデルを100万トークンのコンテキストで使える計算です。
無料のユーザーも、プロンプトに合うとアプリが判断したときに、自動選択でHydrogenが使われます。
使用量の上限は、計算量をもとにした仕組みです。上限は5時間ごとに回復し、それとは別に週の上限があります。有料プランで上限に達したあとは、Flash-Liteで会話を続けられます。
11月17日には、タスクを任せられる機能「Tasks in Gemini」が、日本を含む6か国で無料で使えるようになりました。この機能もHydrogenで動いています。
17. Google検索にはHydrogenが全ユーザー向けに入った
Hydrogenは、Google検索にも入りました。
11月12日の発表によると、HydrogenはGoogle検索で、すべてのユーザーに、世界中で提供されています。Googleはこれを「検索にとってこれまででいちばん大きなモデルの更新」と説明しています。
検索のAIモードでは、上位のモデルも使えます。ArgonはGoogle AI ProとUltraの契約者向け、CarbonはGoogle AI Ultraの契約者向けです。
毎日の検索に使われるモデルがHydrogenになった、というのは、このモデルの位置づけをよく表しています。第6章で見た毎秒172トークンの速さは、検索のように待ち時間が短いことが大事な場面のための設計です。
18. AntigravityのOrchestratorはCarbonとHydrogenを自動で使い分ける
Gemini 4をコーディングで使う入り口は、Google Antigravityです。アプリ、CLI、IDE拡張の3つの形があります。
Antigravityで使えるモデルは、プランで決まります。
| モデル・機能 | 対象のプラン |
|---|---|
| Gemini 4 Hydrogen | Google AI ProとUltra |
| Gemini 4 Argon | Google AI ProとUltra |
| Gemini 4 Carbon | Google AI Ultra |
| Orchestrator(Argon) | Google AI ProとUltra |
| Orchestrator(Carbon) | Google AI Ultra |
Hydrogenと同時に出た新しい選択肢が、Orchestratorです。
Orchestratorは、モデルの選択欄から選ぶ項目で、Hydrogenと上位のモデルを1つの作業の中で切り替えながら進めます。Antigravityの発表は、動き方をこう説明しています。
まずCarbonが、読み取りだけの段階で依存関係を調べ、あいまいな点を解き、計画を立てます。次にHydrogenが引き継いで、コードを編集し、パッケージを更新し、テストを走らせます。Hydrogenが行き詰まったら、Carbonに戻して計画を立て直します。
Googleの発表によると、OrchestratorはCarbon単独に近いタスク成功率を保ちながら、平均で利用枠の消費を24%減らし、完了を19%速くしました。
第12章で扱った「計画はCarbon、実行はHydrogen」の構成を、設定なしで使える形にしたものです。
Carbonと同じ週には、/swarmという機能もプレビューで出ています。複数の作業ツリーにまたがる大きな開発を、並列のエージェントのチームで進める機能です。
APIからエージェントを動かす方法もあります。
Gemini APIのManaged Agentsには、Antigravityのエージェントが用意されていて、既定のモデルはHydrogenです。CarbonやArgonを使うときは、エージェントの設定で指定します。
第5章で見たとおり、Antigravity CLIとCarbonの組は、独立評価のCoding Agent Indexで40件中7位でした。Antigravity CLIとHydrogenの組も14位に入っています。
Gemini CLIの公式ドキュメントは、Gemini 4 ArgonをAntigravityで使うよう案内しています。Gemini 4でエージェント型のコーディングを始めるなら、Antigravityから入るのが近道です。
企業向けには、Gemini for businessとVertex AIが提供先です。Googleは研究者向けの支援として、1万人の科学者にAntigravityの最上位の使用枠を6か月間無料で提供する取り組みも進めていて、11月10日からCarbonも対象になりました。
まとめ
冒頭でもかきましたが、Gemini 4の3モデルについて、一言でいうと
「Carbonがいちばん深く考える最上位、Argonが同じ単価で速く返す効率型、Hydrogenが毎秒172トークンで動く日常の主力。CarbonとArgonの単価は、12月1日に$2(約320円)・$10(約1,600円)から$4(約640円)・$20(約3,200円)へ変わる」。
これがGemini 4の現在の姿です。
実務で押さえるのは次の5つです。
- CarbonとArgonは同じ単価で、違いは1ターンに使う思考の量。11月30日まで$2(約320円)・$10(約1,600円)、12月1日から$4(約640円)・$20(約3,200円)
- Hydrogenは$1.50(約240円)・$7.50(約1,200円)の定価で、既定の思考レベルはhigh。指数50.79を、評価タスク1つ7.9分で出す
- 100万トークンの全域で単価が同じ。Carbonは256Kから100万トークンのGraphWalksで96.2%
- キャッシュは暗黙キャッシュに一本化。
temperatureなどは外し、max_output_tokensは高めに取る - 出力はlong decodeで最大約100万トークン。計画はCarbon、実行はHydrogenという組み合わせが公式の勧め
使い分けを表にします。
| 用途 | おすすめ | 理由 |
|---|---|---|
| 日常のコーディング、エージェントの実行、速さが大事な処理 | Gemini 4 Hydrogen(highから) | $1.50(約240円)/$7.50(約1,200円)。毎秒172トークン。無料枠で試せる |
| 難しい多段階の問題を、Hydrogenで解きたい | Gemini 4 Hydrogenのxhigh | 指数53.92。highで届かないときに上げる |
| ソフトウェア開発と知識労働の大半、事実の知識の正確さを重く見る質問応答 | Gemini 4 Argon | Carbonと同じ単価で、応答が速い。ハルシネーション率4.3% |
| 数十万トークンの文脈を読む仕事、設計の判断、科学と数学 | Gemini 4 Carbon(mediumかhigh) | 指数60.03。GraphWalksの長い文脈で96.2% |
| 急がない大量処理 | BatchかFlex | 半額。12月1日以降のCarbonでも$2(約320円)/$10(約1,600円) |
| 計画と実行を分けるエージェント | 計画はCarbon、実行はHydrogen | previous_interaction_idでつなぐ。AntigravityではOrchestrator |
| 数十万トークンの長い出力 | long decodeとbackground実行 | 最大約100万トークンまで |
GPT-6.2 AstraとSolについては、「GPT-6.2 Astra・Sol 完全ガイド」をご覧ください。
日本語での性能は、当ブログの「日本語対応 LLMランキング2026」の次の版で取り上げます。
当社の統合AIプラットフォーム「Bestllam」では、Gemini 4 Argonを含む40種類以上のLLMを、1つのワークスペースで使い分けられます。同じ質問を複数のモデルに同時に投げて、答えを並べて比べることもできます。
それでは、また次回、お会いしましょう!
出典
| トピック | 出典 |
|---|---|
| Argonの発表 | Gemini 4 Argonの発表(Google公式ブログ) |
| Carbonの発表・ベンチマーク | Gemini 4 Carbonの発表(Google公式ブログ) |
| Carbonの一般提供 | Gemini 4 Carbon is now available(Google公式ブログ) |
| Hydrogenの発表・ベンチマーク | Introducing Gemini 4 Hydrogen(Google公式ブログ) |
| Google検索でのHydrogen | Gemini 4 Hydrogenと検索(Google公式ブログ) |
| API料金 | Gemini Developer API pricing(Google公式ドキュメント) |
| モデル仕様 | Gemini 4 Carbonのモデルページ(Google公式ドキュメント) |
| 変更点と移行 | What's new in Gemini 4 Hydrogen(Google公式ドキュメント) |
| 思考レベル | Thinking(Google公式ドキュメント) |
| long decode | Long decode(Google公式ドキュメント) |
| キャッシュ | Context caching(Google公式ドキュメント) |
| 提供開始日・旧モデルの扱い | Release notes(Google公式ドキュメント) |
| Vertex AIの料金 | Vertex AI pricing(Google Cloud公式) |
| モデルカード | Model cards(Google DeepMind) |
| 安全性とセーフガード | Gemini 4の安全性とセキュリティ(Google公式ブログ) |
| Geminiアプリのプラン | Google AIのプラン(Google公式) |
| AntigravityとOrchestrator | Gemini 4 Hydrogen and Orchestrator(Google Antigravity公式ブログ) |
| 独立評価 | Gemini 4 Carbonのモデル別ページ(Artificial Analysis) |
| 独立評価(コーディングエージェント) | Coding Agent Index(Artificial Analysis) |
| GPT-6.2の料金 | Pricing(OpenAI公式ドキュメント) |
| Claudeの料金 | Pricing(Anthropic公式ドキュメント) |