Claude Fable 5.2 完全ガイド モデル仕様とAPI・Claude Code運用ポイント
Claude Fable 5.2の完全ガイド。Fable 5.1より20%安い料金と最大30%の高速化、独立評価の総合指数で上位3つを占めた性能、履歴の書き換えチェックなどAPI移行の要点、Claude Codeでの既定effortとFast modeまで解説。
こんにちは!
2026年11月9日(米国時間)、AnthropicからClaude Fable 5.2とClaude Mythos 5.2が発表されました。9月のFable 5.1から約2か月での更新です。
まず、このモデルについて一言でいうと、
「Fable 5.2は、Fable 5.1より20%安く、最大30%速くなり、独立評価の総合指数で上位3つを占めた。APIでは、会話の履歴を書き換えない作りが全アカウントの前提になった」
です。
さて、まずはAPI料金からみてみましょう。
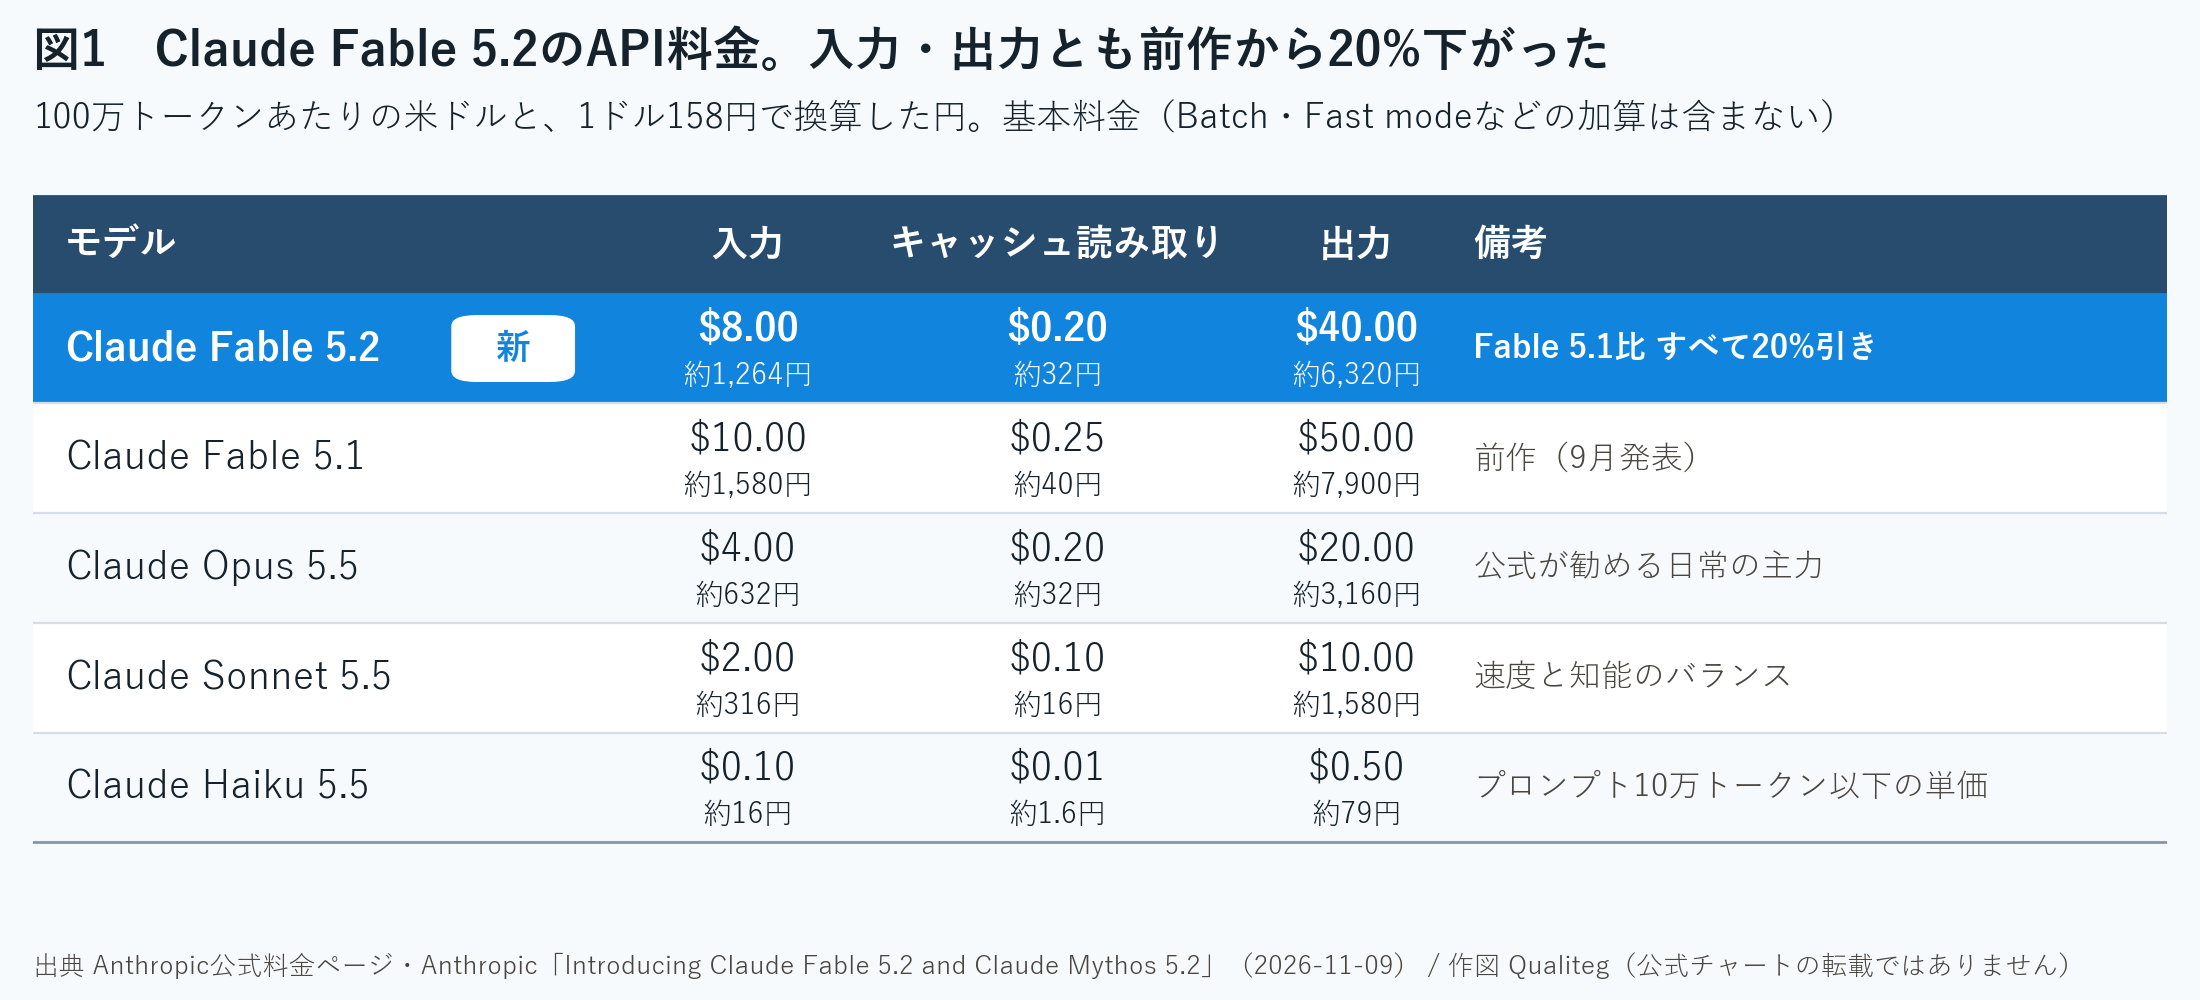
Fable 5.2は入力$8(約1,264円)・出力$40(約6,320円)で、Fable 5.1の$10(約1,580円)・$50(約7,900円)から20%下がりました。キャッシュ読み取りも$0.25(約40円)から$0.20(約32円)へ、同じく20%の値下げです。
かっこの中の円は、1ドル158円(11月10日時点)で換算した目安です。この記事では、ドルの金額にはすべて円を添えています。
最上位のモデルが、性能を上げながら単価を下げてきました。Fable 5とFable 5.1はどちらも$10(約1,580円)・$50(約7,900円)だったので、Fableの入力と出力の単価が下がるのは今回が初めてです。
当ブログでは7月に「Claude Fable5 完全ガイド」を、9月に「Claude Opus 5.5 完全ガイド」を書きました。この記事はその続編です。
Opus 5.5の記事では、Opus 5.5を「Fable 5.1級を狙う性能を、安い単価で出してきたモデル」と紹介しました。今回のFable 5.2は、そのOpus 5.5をほとんどの評価で上回っています。
Anthropicの公式発表とドキュメント、システムカード、それに独立評価機関のArtificial Analysisのデータをもとに書いています。
長編なので、頭から通読する必要はありません。気になる章だけ拾い読みしてください。
目次
第1部 Claude Fable 5.2とは何か
- 1. Fable 5.2とMythos 5.2は同じモデル
- 2. 基本仕様の早見表
- 3. 料金は入力・出力・キャッシュ読み取りがそろって20%引き
- 4. Anthropicの公表ベンチマークは16件中14件で最高
- 5. 独立評価ではIntelligence Indexの上位3つを占めた
- 6. effort別に見ると、highが性能と費用のバランスに優れる
- 7. システムカードで見る安全性とセーフガード
第2部 APIで使うときのポイント
- 8. 履歴の書き換えチェックが全アカウントに広がった
- 9. thinkingブロックを読めるのはFable 5.2とMythos 5.2だけ
- 10. computer useはツールセットへ、advisorは組み合わせをそろえる
- 11. effortはhighから始め、xhighは効果を測れた仕事に使う
- 12. プロンプトを持ち越すときに見直す挙動
- 13. 移行の手順と費用試算
第3部 Claude Codeで使うFable 5.2
- 14. v2.1.321でfableエイリアスがFable 5.2になった
- 15. Claude Codeでの既定effortはmedium
- 16. Fast modeは$16(約2,528円)/$80(約12,640円)、Fable 5.2の上で/fastを実行する
- 17. 分類器でモデルが切り替わるときの挙動
- 18. プラン別の使える量・ローンチ特典・日常の使い分け
Fable 5.1からのアップデート、ざっくり
詳しくは各章で扱いますが、まず全体像です。
単価が20%下がった
入力$8(約1,264円)・出力$40(約6,320円)、キャッシュ読み取り$0.20(約32円)です(第3章)
出力の生成が最大30%速くなった
公式のモデル一覧でも、相対レイテンシの表記がSlowerからModerateに変わりました(第2章)
公表ベンチマークは16件中14件で最高
SWE-bench Proは93.0%、実在のフリーランス案件をこなせる率は41.3%で、Opus 5.5のほぼ倍です(第4章)
独立評価の総合指数で上位3つを占めた
Artificial AnalysisのIntelligence Indexで、max・xhigh・highが1位から3位です(第5章)
本気を出さなくてもOpus 5.5の本気に並び、本気を出すと引き離す
5段階の3番目のhighで、Opus 5.5が最高設定のmaxで出した点数に届き、費用は約半分です。難しくて長い仕事になると差が開き、実在のフリーランス案件をこなせる率は41.3%対21.3%、独立評価の総合指数は最高設定どうしで65対59です(第6章)
セーフガードによるブロックが約55%減った
Fable 5.1と比べた、公式の初期テストの値です(第7章)
履歴の書き換えチェックが全アカウントに適用された
Fable 5.1では新しいアカウントだけでした(第8章)
Fast modeが使えるようになった
最大2.5倍の速度で、$16(約2,528円)/$80(約12,640円)です(第16章)
Claude Codeはv2.1.321で対応
fableエイリアスがFable 5.2を指し、既定のeffortはmediumです(第14章・第15章)
ProとTeam標準席でも1週間はFableが利用枠に入る
11月16日までのローンチ特典です(第18章)
第1部 Claude Fable 5.2とは何か
1. Fable 5.2とMythos 5.2は同じモデル
公式発表は、2つのモデルの関係をこう説明しています。
「Claude FableとClaude Mythosは同じモデルです。Fableにはサイバーセキュリティと生物の強いセーフガードがあり、そのおかげですべての利用者に提供できます」。
Mythos 5.2は、同じモデルからその領域のセーフガードを緩めた構成です。使えるのは、Cyber Verification ProgramやLife Sciences Verification Programの審査を通った組織に限られます。
| モデル | 位置づけ | API単価(入力/出力) | 使える人 |
|---|---|---|---|
| Claude Fable 5.2 | 要求の厳しい推論と長期のエージェント作業 | $8(約1,264円)/$40(約6,320円) | Claude APIの全顧客 |
| Claude Mythos 5.2 | Fable 5.2と同じ能力 | $8(約1,264円)/$40(約6,320円) | 審査を通った組織 |
| Claude Opus 5.5 | 長時間のエージェント型コーディングと知識労働 | $4(約632円)/$20(約3,160円) | 全顧客 |
| Claude Sonnet 5.5 | 速度と知能のバランス | $2(約316円)/$10(約1,580円) | 全顧客 |
| Claude Haiku 5.5 | 大量処理と低レイテンシ | $0.10(約16円)/$0.50(約79円)から | 全顧客 |
公式が勧める使い分けは、Opus 5.5のときと同じ形です。
ほとんどのコーディングと知識労働は、日常の主力であるOpus 5.5から始める。Opus 5.5の高いeffortでも評価が届かないときに、Fable 5.2へ上げる。軽い仕事はSonnet 5.5やHaiku 5.5へ下げる。
Fable 5.2に向く仕事として、公式は「もっとも野心的で、ゴールの決まっていない技術的な仕事」を挙げています。モデルページの例は、数時間にわたるエージェントのセッション、多段階の深い調査、分析から文書・表計算・スライドの完成まで通す作業です。
もうひとつ、公式が示す使い方があります。
Fable 5.2をAdvisor(相談役)やOrchestrator(指揮役)に置く形です。Haiku・Sonnet・Opusが難しい問題だけFable 5.2に相談する、あるいはFable 5.2が簡単な作業を小さいモデルに任せる。全部をFable 5.2で回さずに、要所だけに使う設計です。
発表に並ぶ事例は、規模の大きいものが中心です。
1,000を超えるサブエージェントを8日間動かして、ノートPCで起動するOSの試作を書き上げた。本番サービスをPythonからRustに移し、起動が約26倍速くなった。1,000エージェントのチームが、フェルマーの最終定理の証明を30時間で形式化した。
2. 基本仕様の早見表
| 項目 | Claude Fable 5.2 | Claude Fable 5.1(前作) |
|---|---|---|
| モデルID | claude-fable-5-2 | claude-fable-5-1 |
| Amazon BedrockのID | anthropic.claude-fable-5-2 | anthropic.claude-fable-5-1 |
| コンテキスト | 1M | 1M |
| 最大出力 | 128K | 128K |
| 知識の基準日 | 2026年6月 | 2026年6月 |
| thinking | 常時オン(adaptive) | 常時オン(adaptive) |
| effortの既定(API) | high | high |
| 相対レイテンシ | Moderate | Slower |
| 入出力 | テキスト・画像からテキスト | 同じ |
| トークナイザ | Opus 4.7で導入されたもの | 同じ |
| 提供終了 | 2027年11月9日より前にはしない | 2027年9月1日より前にはしない |
| データ保持 | 30日の保持が要件 | 30日の保持が要件 |
| Priority Tier | 対象外 | 対象外 |
| レート制限 | Fable 5.2だけの独立した枠 | Fable 5と共有の枠 |
提供先はClaude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud(Google管理とAnthropic管理の両方)、Microsoft Foundryです。
仕様の数字は、ほぼFable 5.1のままです。コンテキスト長・最大出力・トークナイザが同じなので、トークン数の見積もりはそのまま使えます。
変わったのは速度です。
公式発表は、出力の生成がFable 5.1より最大30%速いとしています。モデル一覧の相対レイテンシも、Fable 5.1のSlowerからModerateになり、Opus 5.5と同じ表記に並びました。
レート制限の枠も変わりました。
Fable 5.1とFable 5は1つの枠を共有していますが、Fable 5.2は独立した枠を持ちます。Fable 5.1から移すとき、既存の枠の使用量とは別に数えられます。
| ティア | Fable 5.2(RPM/入力TPM/出力TPM) | Opus 5.5(同) |
|---|---|---|
| Start | 4,000/500,000/100,000 | 4,000/2,000,000/400,000 |
| Build | 10,000/1,500,000/300,000 | 10,000/5,000,000/1,000,000 |
| Scale | 13,000/4,000,000/800,000 | 13,000/10,000,000/2,000,000 |
トークンの上限はOpus 5.5より小さめです。Opus 5.5からFable 5.2へ本番の流量を移すなら、先にこの表で枠を見ておくと安心です。
データ保持の扱いは、Fable 5.1と同じです。
Fable 5.2は30日のデータ保持が要件で、保持なしの組織やワークスペースからのリクエストは、Claude APIでは400エラーになります。
ここに今回、Enterprise Frontier Safeguards(EFS)という仕組みが加わりました。安全監視を顧客側のインフラで動かす形で、ゼロデータ保持(ZDR)と両立します。公式発表によると非公開ベータの段階で、対象のEnterprise顧客は、EFSを入れるまでのあいだZDRのままFable 5.2を使い続けられます。
3. 料金は入力・出力・キャッシュ読み取りがそろって20%引き
100万トークンあたりの米ドルで、公式料金ページの値を並べます。書き込みはキャッシュ書き込みの単価です。
| モデル | 入力 | 5分書き込み | 1時間書き込み | キャッシュ読み取り | 出力 |
|---|---|---|---|---|---|
| Claude Fable 5.2 | $8(約1,264円) | $10(約1,580円) | $16(約2,528円) | $0.20(約32円) | $40(約6,320円) |
| Claude Fable 5.1 | $10(約1,580円) | $12.50(約1,975円) | $20(約3,160円) | $0.25(約40円) | $50(約7,900円) |
| Claude Fable 5 | $10(約1,580円) | $12.50(約1,975円) | $20(約3,160円) | $1.00(約158円) | $50(約7,900円) |
| Claude Opus 5.5 | $4(約632円) | $5(約790円) | $8(約1,264円) | $0.20(約32円) | $20(約3,160円) |
| Claude Sonnet 5.5 | $2(約316円) | $2.50(約395円) | $4(約632円) | $0.10(約16円) | $10(約1,580円) |
| Claude Haiku 5.5(プロンプト10万トークン以下) | $0.10(約16円) | $0.125(約20円) | $0.20(約32円) | $0.01(約1.6円) | $0.50(約79円) |
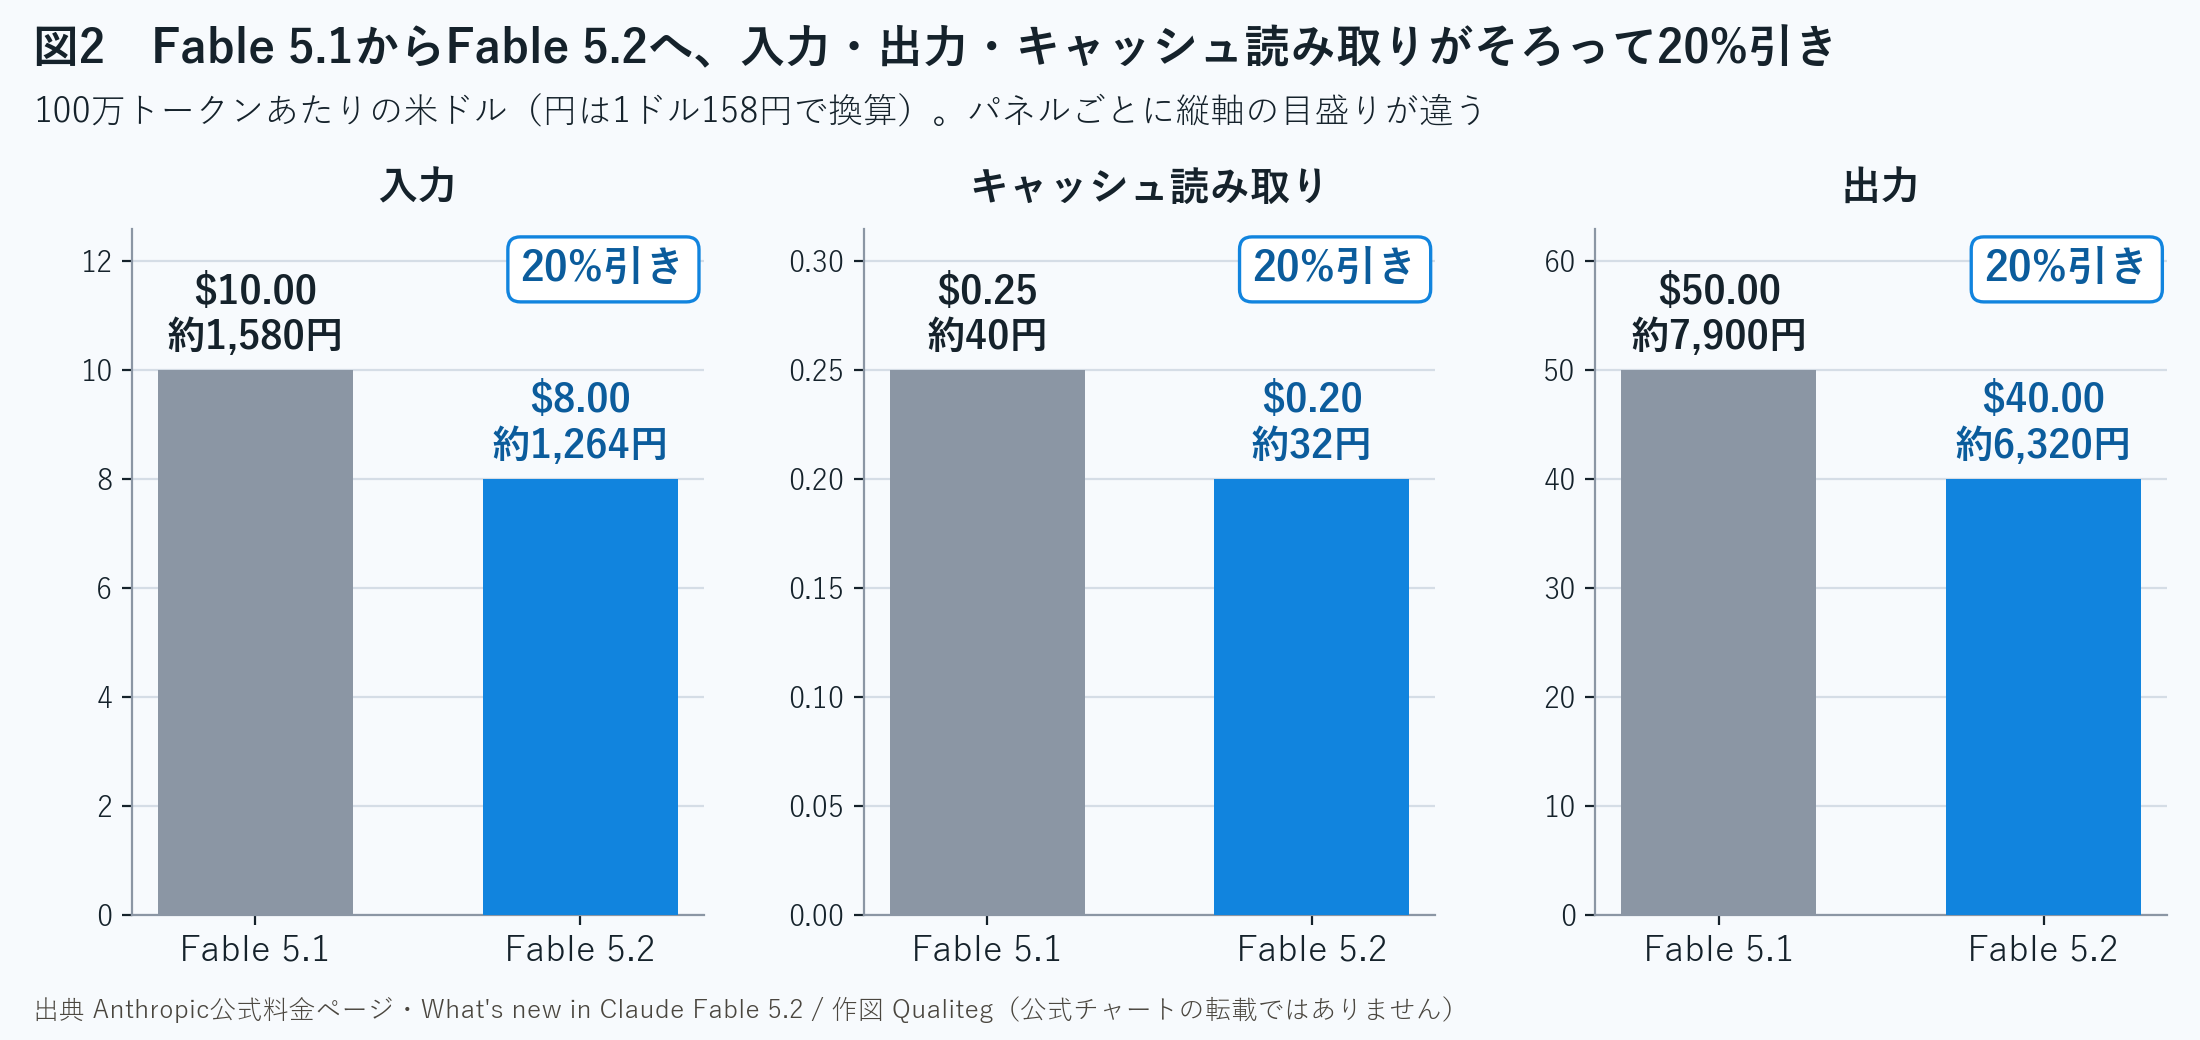
Opus 5.5のときは、キャッシュ読み取りだけが60%引きと大きく下がりました。今回は、すべての項目が同じ20%引きです。
キャッシュ読み取りの単価は、入力単価の0.025倍のままです。Opus 5.5とSonnet 5.5は0.05倍、ほかのモデルは0.1倍なので、Fableの系列がいちばん低い倍率になっています。
キャッシュ読み取りの単価は、Fable 5.2もOpus 5.5も$0.20(約32円)で同じです。
エージェント作業は、同じ指示やツール定義、過去のやり取りを毎ターン読み直します。その読み直しの部分だけを見れば、Fable 5.2に上げても単価は変わりません。差が出るのは、新しく入る入力と出力です。
Fable 5から直接移る場合は、キャッシュ読み取りが$1.00(約158円)から$0.20(約32円)へ、80%下がります。
その他の単価です。
| 項目 | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|
| Batch API(入力/出力) | $4(約632円)/$20(約3,160円) | $5(約790円)/$25(約3,950円) |
| Fast mode(入力/出力) | $16(約2,528円)/$80(約12,640円) | 提供なし |
| 1Mコンテキストの割増 | なし(全域が標準料金) | なし |
| データレジデンシー(inference_geo "us") | 1.1倍 | 1.1倍 |
Batch APIのFable 5.2は$4(約632円)/$20(約3,160円)で、標準のOpus 5.5と同じ単価になります。急がない大量処理なら、Opus 5.5の値段でFable 5.2を回せる計算です。
Fast modeは今回の新しい選択肢です。Claude Codeでの使い方は第16章で扱います。
Fable 5.1からの変化を、項目ごとに1枚にまとめます。
| 項目 | Fable 5.1 | Fable 5.2 | 変化 |
|---|---|---|---|
| 入力 | $10(約1,580円) | $8(約1,264円) | 20%引き |
| 出力 | $50(約7,900円) | $40(約6,320円) | 20%引き |
| キャッシュ読み取り | $0.25(約40円) | $0.20(約32円) | 20%引き |
| 5分キャッシュ書き込み | $12.50(約1,975円) | $10(約1,580円) | 20%引き |
| 1時間キャッシュ書き込み | $20(約3,160円) | $16(約2,528円) | 20%引き |
| Batch API(入力/出力) | $5(約790円)/$25(約3,950円) | $4(約632円)/$20(約3,160円) | 20%引き |
| Fast mode(入力/出力) | 提供なし | $16(約2,528円)/$80(約12,640円) | 新規 |
| 出力の生成速度 | 基準 | 最大30%速い | 高速化 |
他社のハイエンドモデルと価格を並べるとき
OpenAIのGPT-6 Astra、GoogleのGemini 4 Argonと、公式の料金表の値を並べます。11月10日時点の、各社の標準(Standard)の単価です。
| モデル | 入力 | キャッシュ読み取り | 出力 | 単価が変わる条件 |
|---|---|---|---|---|
| Claude Fable 5.2 | $8.00(約1,264円) | $0.20(約32円) | $40.00(約6,320円) | 1Mコンテキストの全域で同じ単価 |
| GPT-6 Astra | $10.00(約1,580円) | $1.00(約158円) | $50.00(約7,900円) | 入力が272Kを超えると$20.00(約3,160円)/$2.00(約316円)/$75.00(約11,850円) |
| Gemini 4 Argon | $2.00(約316円) | $0.10(約16円) | $10.00(約1,580円) | 12月1日から$4.00(約632円)/$0.20(約32円)/$20.00(約3,160円) |
単価だけを見ると、Gemini 4 Argonがいちばん低く、Fable 5.2はGPT-6 Astraより2割低い位置です。
ただし、この表の順番は、そのまま「どれが安く使えるか」の順番にはなりません。理由は4つあります。
ひとつめは、同じ文章でもトークン数がモデルごとに違うことです。トークナイザが各社で別なので、100万トークンで扱える文章の量がそろっていません。
ふたつめは、1つの仕事に使うトークンの量が違うことです。考える量、ツールを呼ぶ回数、回答の長さがモデルとeffortで変わります。
みっつめは、課金の区切りが違うことです。GPT-6 Astraは入力が272Kを超えると単価が上がります。Gemini 4 Argonは12月1日に単価が変わる予定です。Fable 5.2は1Mの全域が同じ単価です。長い文脈を読ませる使い方では、この区切りが効いてきます。
よっつめは、キャッシュの仕組みが違うことです。Fable 5.2とGPT-6 Astraにはキャッシュ書き込みの料金があり、Gemini 4 Argonは料金表の上では暗黙的キャッシュだけの対応です。同じ文脈を読み直すエージェント作業では、読み取りの単価($0.20(約32円)、$1.00(約158円)、$0.10(約16円))に加えて、どれだけキャッシュに当たるかで費用が決まります。
単価の代わりに、同じ評価タスクを実行したときの費用を見る方法があります。第5章で扱うArtificial Analysisの値を、先に3行だけ引きます。
| モデル(effort) | 出力の単価 | 評価タスク1つの実行費用 | Intelligence Index |
|---|---|---|---|
| Claude Fable 5.2(high) | $40.00(約6,320円) | $9.08(約1,435円) | 62 |
| GPT-6 Astra(max) | $50.00(約7,900円) | $6.24(約986円) | 57 |
| Gemini 4 Argon(high) | $10.00(約1,580円) | $9.95(約1,572円) | 50 |
出力の単価は$10(約1,580円)から$50(約7,900円)まで5倍の幅がありますが、同じ評価タスクの実行費用は$6.24(約986円)から$9.95(約1,572円)に収まっています。単価の順番と、実行費用の順番も一致していません。
価格を比べるときは、単価の表と、実際に流したときの費用の両方を見るのがおすすめです。
4. Anthropicの公表ベンチマークは16件中14件で最高
ここからの数字は、すべてAnthropicが公表したものです。
測定条件は、特記がなければ各モデルの最高effort、5回の平均です。Claudeの各モデルは、本番のセーフガードを有効にしたまま測っています。
| 評価 | Fable 5.2 | Opus 5.5 | Fable 5.1 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% | 32.4% | 42.8% | 41.1% |
| FrontierSWE v2 | 69.9% | 62.3% | 56.3% | 65.5% | 61.2% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% | 52.6% | 68.1% | 64.8% |
| AutomationBench | 51.4% | 42.5% | 31.4% | 41.4% | 53.9% |
| WANDR(relaxed) | 82.1% | 72.3% | 68.7% | – | – |
| OSWorld 2.1(offline・partial) | 89.3% | 87.2% | 83.5% | 79.5% | 81.5% |
| RoboDojo Sim | 64.9% | 39.4% | 27.6% | 29.8% | – |
| AA-Briefcase v1.1(ルーブリック) | 66.1% | 61.2% | 61.5% | 52.0% | 61.8% |
| AA-Briefcase v1.1(Elo) | 1785 | 1800 | 1669 | 1569 | 1611 |
| Remote Labor Index | 41.3% | 21.3% | 17.9% | 20.8% | – |
| Humanity's Last Exam(ツールあり) | 74.2% | 67.7% | 65.6% | 57.2% | – |
| Chartography(ツールなし) | 73.4% | 64.4% | 44.8% | 71.0% | 72.5% |
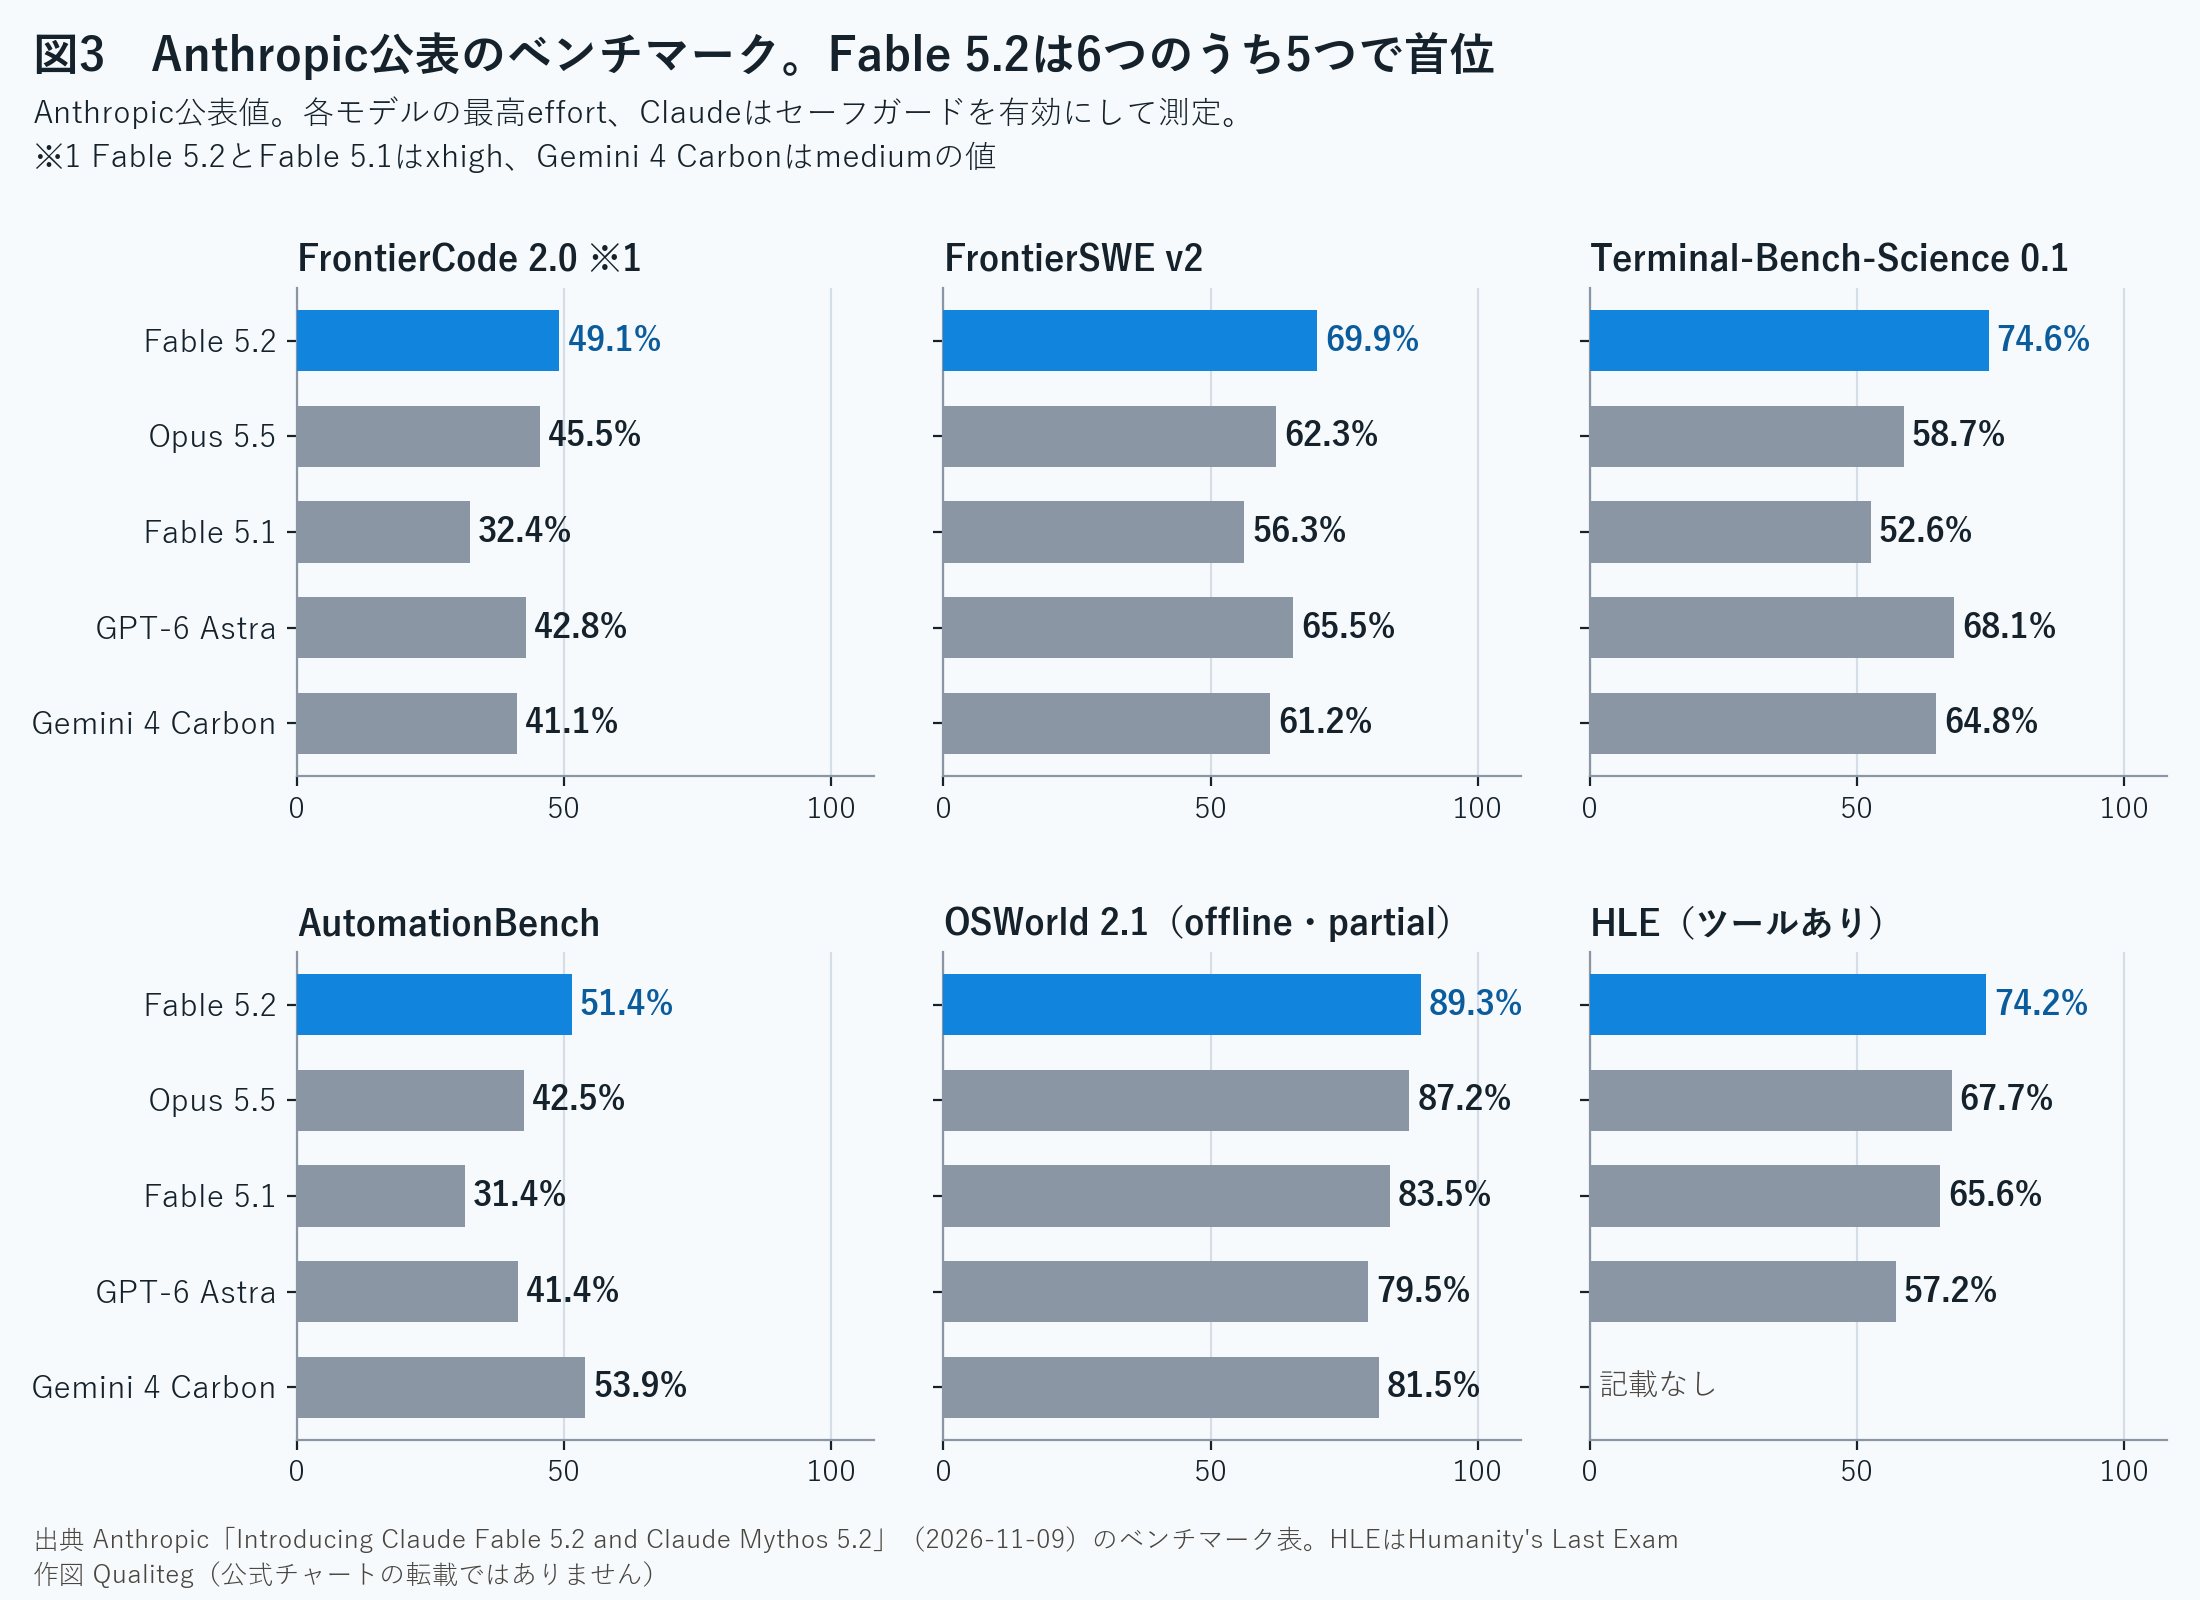
FrontierCode 2.0は、Fable 5.2とFable 5.1がxhigh、Gemini 4 Carbonがmediumの値です。Remote Labor Indexは、Fable 5.2がhighの値です。
「16件中14件」は、システムカードの要約表(Table 8.1.A)の集計です。この表には、セーフガードを有効にしたFable 5.2の結果が16件並び、Fable 5.1・Opus 5.5・GPT-6 Astraと比べて、そのうち14件でFable 5.2が最高でした。Opus 5.5が上だったのは、GDPval-AA(1831対1866)とAA-BriefcaseのElo(1785対1800)の2件です。
同じ表には、Mythos 5.2で測った2件(タンパク質のバインダー設計とCVE Rediscovery)も載っていて、こちらもMythos 5.2が最高でした。上の表と下の表は、この要約表と公式発表の表から主なものを抜き出したものです。
目を引く数字を3つ挙げます。
ひとつめは、Remote Labor Indexの41.3%です。
これは実在のフリーランス案件240件を解かせ、成果物が人間の専門家と同等以上かを人間が判定する評価です。Fable 5.2は240件中99件が合格で、Opus 5.5の21.3%、GPT-6 Astraの20.8%のほぼ倍になりました。しかもmaxではなく、highでの値です。
ふたつめは、RoboDojo Simの64.9%です。
カメラ画像から2本腕のロボットを操作するシミュレーションで、GPT-6 Astraの29.8%、Fable 5.1の27.6%の2倍を超えました。ロボット操作のための専用の訓練をしていないモデルの値です。
みっつめは、Chartographyのツールなしで、Fable 5.1の44.8%から73.4%へ上がったことです。図やグラフをコードで切り抜かずに、そのまま読む力が大きく伸びています。
システムカードには、発表の表にない値も載っています。
| 評価 | Fable 5.2 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|
| SWE-bench Pro | 93.0% | 89.9% | 81.2% |
| SWE-bench Multilingual | 96.6% | 93.9% | 89.1% |
| SWE-bench Multimodal | 74.1% | 61.4% | 54.7% |
| Humanity's Last Exam(ツールなし) | 73.2% | 64.4% | 60.9% |
| Terminal-Bench 4.0 | 67.6% | 66.4% | 55.8% |
| CursorBench 4.0 | 60.0% | 57.8% | 51.8% |
| BenchCAD 2.1(ツールあり) | 83.5 | 65.3 | 44.4 |
| GDPval-AA v2.1(Elo) | 1831 | 1866 | 1763 |
Terminal-Bench 4.0の67.6%と66.4%は、差が標準誤差(±1.8と±2.6)の内側です。この評価では、Fable 5.2とOpus 5.5は同じ水準と読むのが妥当です。
ハードウェア設計を測るBenchCAD 2.1は、100点満点の部分点つきの採点です。発表には、1段落の指示から3つの電子機器(音声アシスタントのハブ、USBスピーカーフォン、携帯型のバーチャルペット)を設計した事例も載っています。4層基板の配線、筐体のCAD、ソフトウェアまで書き、製造した3台は電気的な修正なしで動いたそうです。
発表に掲載された利用企業のコメントも、長い仕事を任せた話が中心です。
Uberは「10〜12時間のセキュリティ監査を任せたら、約170のレビュー用エージェントを送り出し、報告書と修正のプルリクエストと方針の提案を持って帰ってきた」。Cognitionは「知らないことを知らないと言う。前の見積もりが間違っていたと自分から言い、測るまで数字を出さなかった」と書いています。
独立評価の数字は、次の章で見ます。
5. 独立評価ではIntelligence Indexの上位3つを占めた
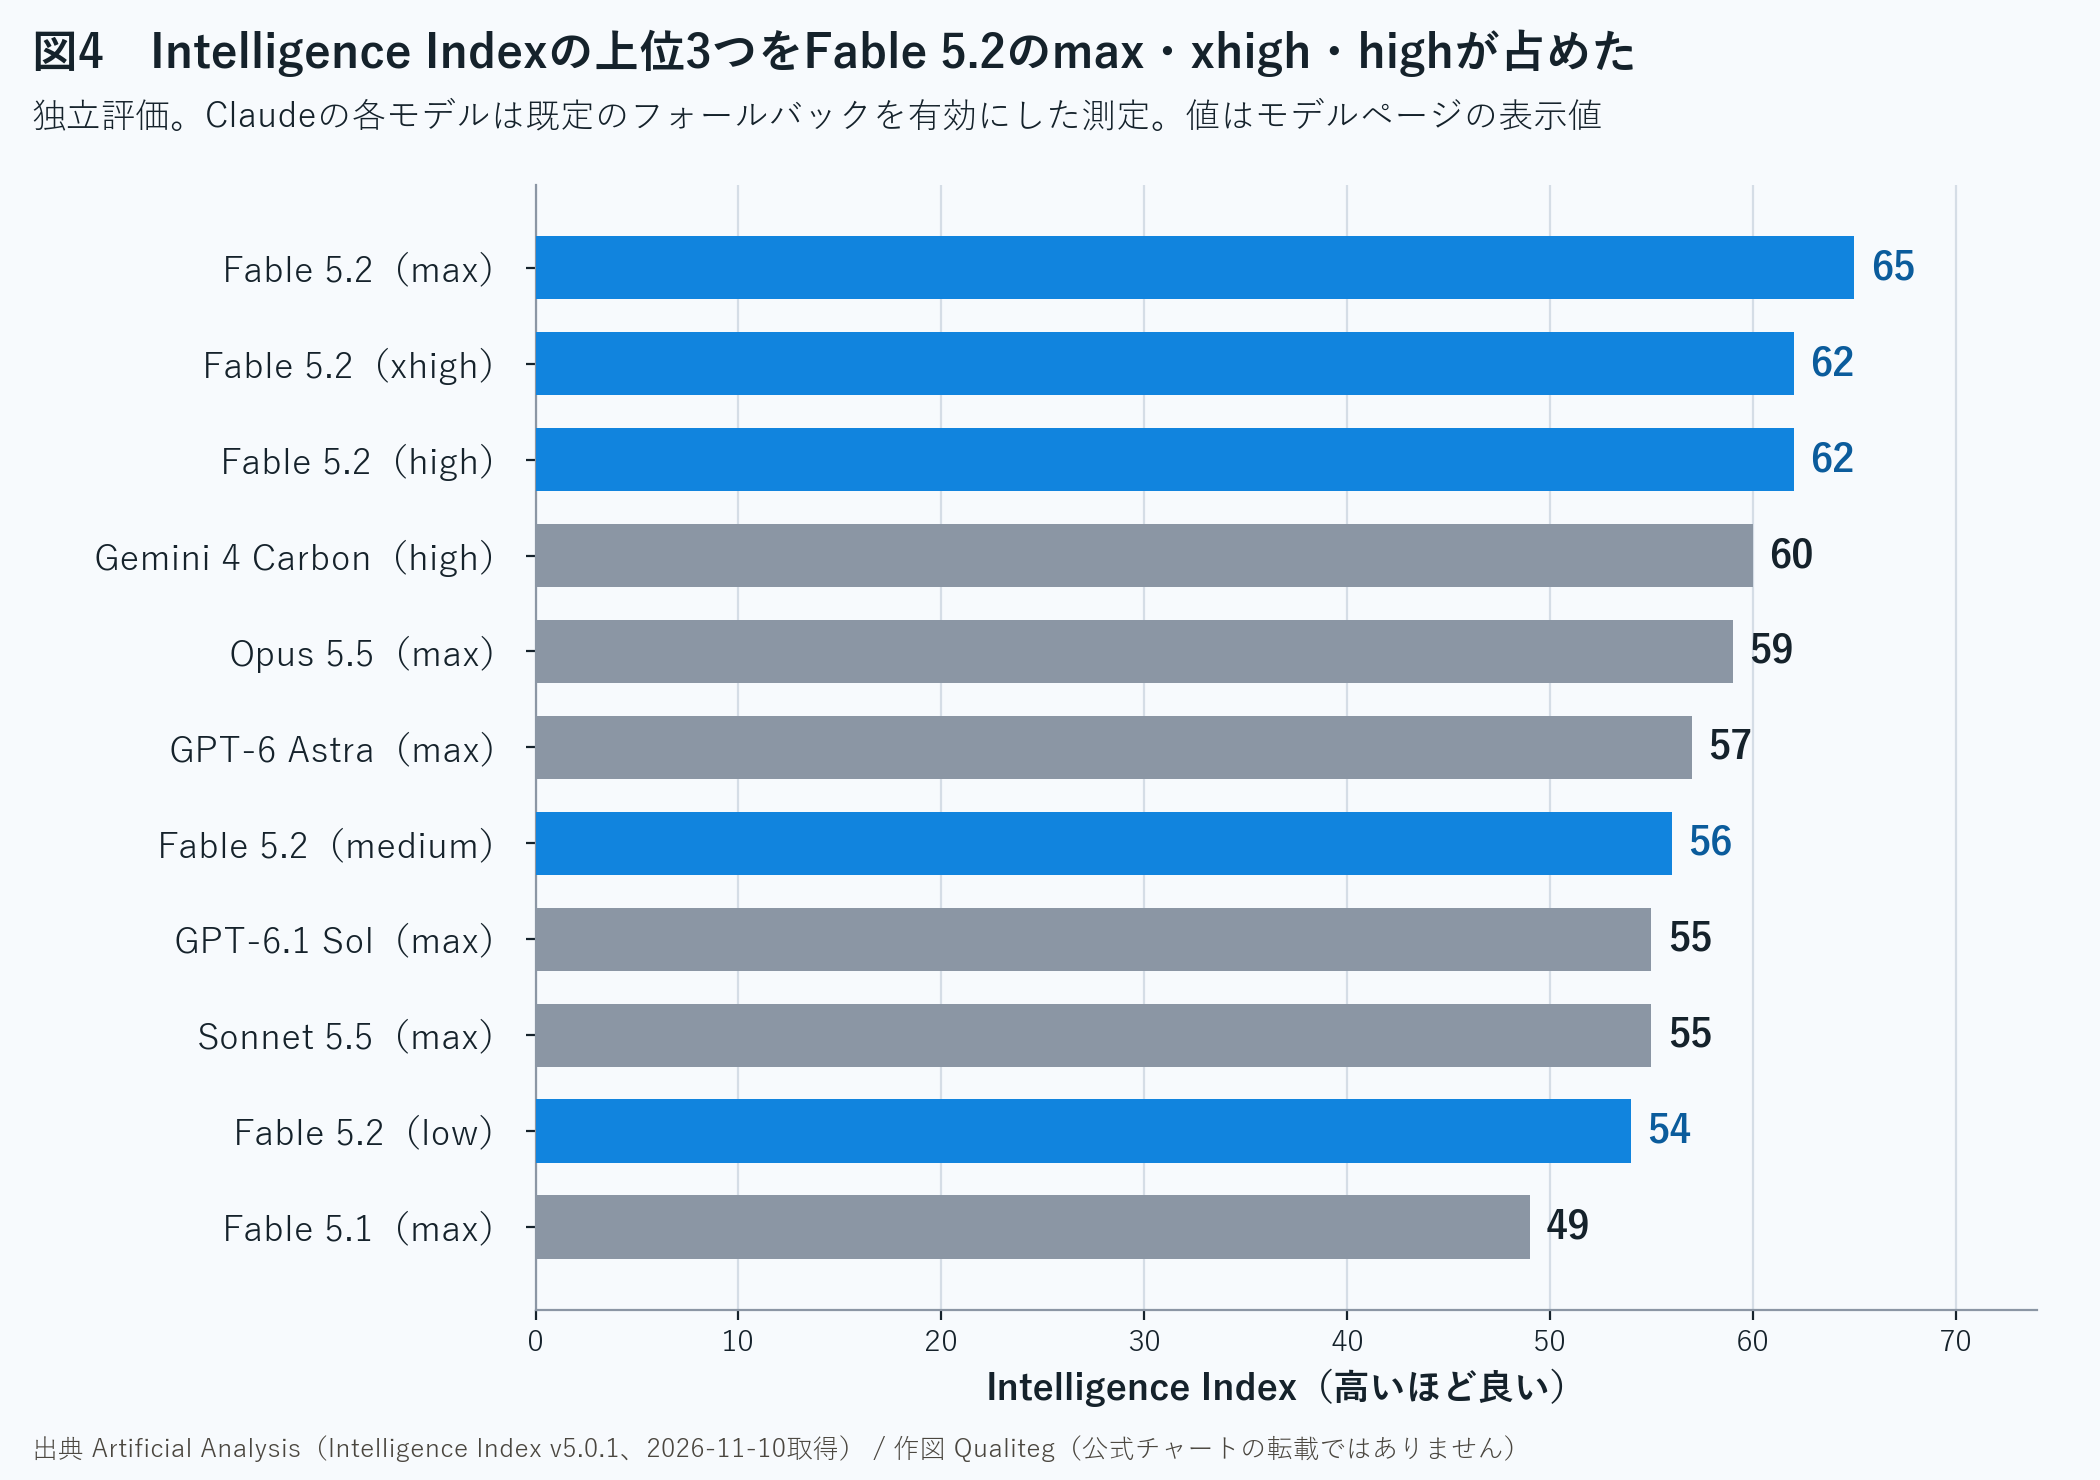
独立評価機関のArtificial Analysisは、Fable 5.2の5つのeffortすべてを測り、モデルページで公開しています。以下は11月10日時点の同社の公開データです。
Intelligence Indexは、同社が自分で回す評価をまとめた総合指数です。10月27日にv5へ移行し、いまは9種類の評価で構成されています。
| モデル(effort) | Intelligence Index | 1タスクの実行費用 | 1タスクの所要時間 |
|---|---|---|---|
| Fable 5.2(max) | 65 | $26.54(約4,193円) | 45.0分 |
| Fable 5.2(xhigh) | 62 | $14.83(約2,343円) | 26.3分 |
| Fable 5.2(high、APIの既定) | 62 | $9.08(約1,435円) | 17.7分 |
| Gemini 4 Carbon(high) | 60 | $7.76(約1,226円) | 27.2分 |
| Opus 5.5(max) | 59 | $10.04(約1,586円) | 25.1分 |
| GPT-6 Astra(max) | 57 | $6.24(約986円) | 22.6分 |
| Fable 5.2(medium、Claude Codeの既定) | 56 | $3.80(約600円) | 8.3分 |
| GPT-6.1 Sol(max) | 55 | $1.27(約201円) | 20.2分 |
| Sonnet 5.5(max) | 55 | $10.02(約1,583円) | 31.5分 |
| Fable 5.2(low) | 54 | $3.10(約490円) | 6.5分 |
| Fable 5.1(max) | 49 | $12.99(約2,052円) | 22.7分 |
実行費用と所要時間は、Intelligence Indexの評価タスク1つあたりの加重平均です。Claudeの各モデルは、Anthropicの既定のフォールバックを有効にした構成で測定されています。
9月のOpus 5.5の記事では、Opus 5.5(max)の指数を58と書きました。あれは旧版の指数の値です。v5では評価の入れ替えがあり、同じOpus 5.5(max)が59になっています。この記事の数字は、すべてv5の値でそろえています。
表から読めることを3つ挙げます。
ひとつめは、前作からの伸びです。
Fable 5.1(max)の49に対して、Fable 5.2(max)は65です。いちばん低いlowでも54で、Fable 5.1のmaxを上回ります。費用は$3.10(約490円)対$12.99(約2,052円)で、4分の1以下です。
ふたつめは、APIの既定であるhighの位置です。
Fable 5.2のhighは指数62で、Opus 5.5のmax(59)より高く、費用は$9.08(約1,435円)対$10.04(約1,586円)、所要時間は17.7分対25.1分です。Artificial Analysisの評価条件では、総合指数・費用・所要時間の3つがそろって良くなっています。Opus 5.5をmaxで回している仕事では、Fable 5.2のhighが有力な移行先になります。
みっつめは、Claude Codeの既定であるmediumの位置です。
mediumは指数56で、GPT-6 Astraのmax(57)とほぼ同じ水準です。費用は$3.80(約600円)対$6.24(約986円)、所要時間は8.3分対22.6分です。
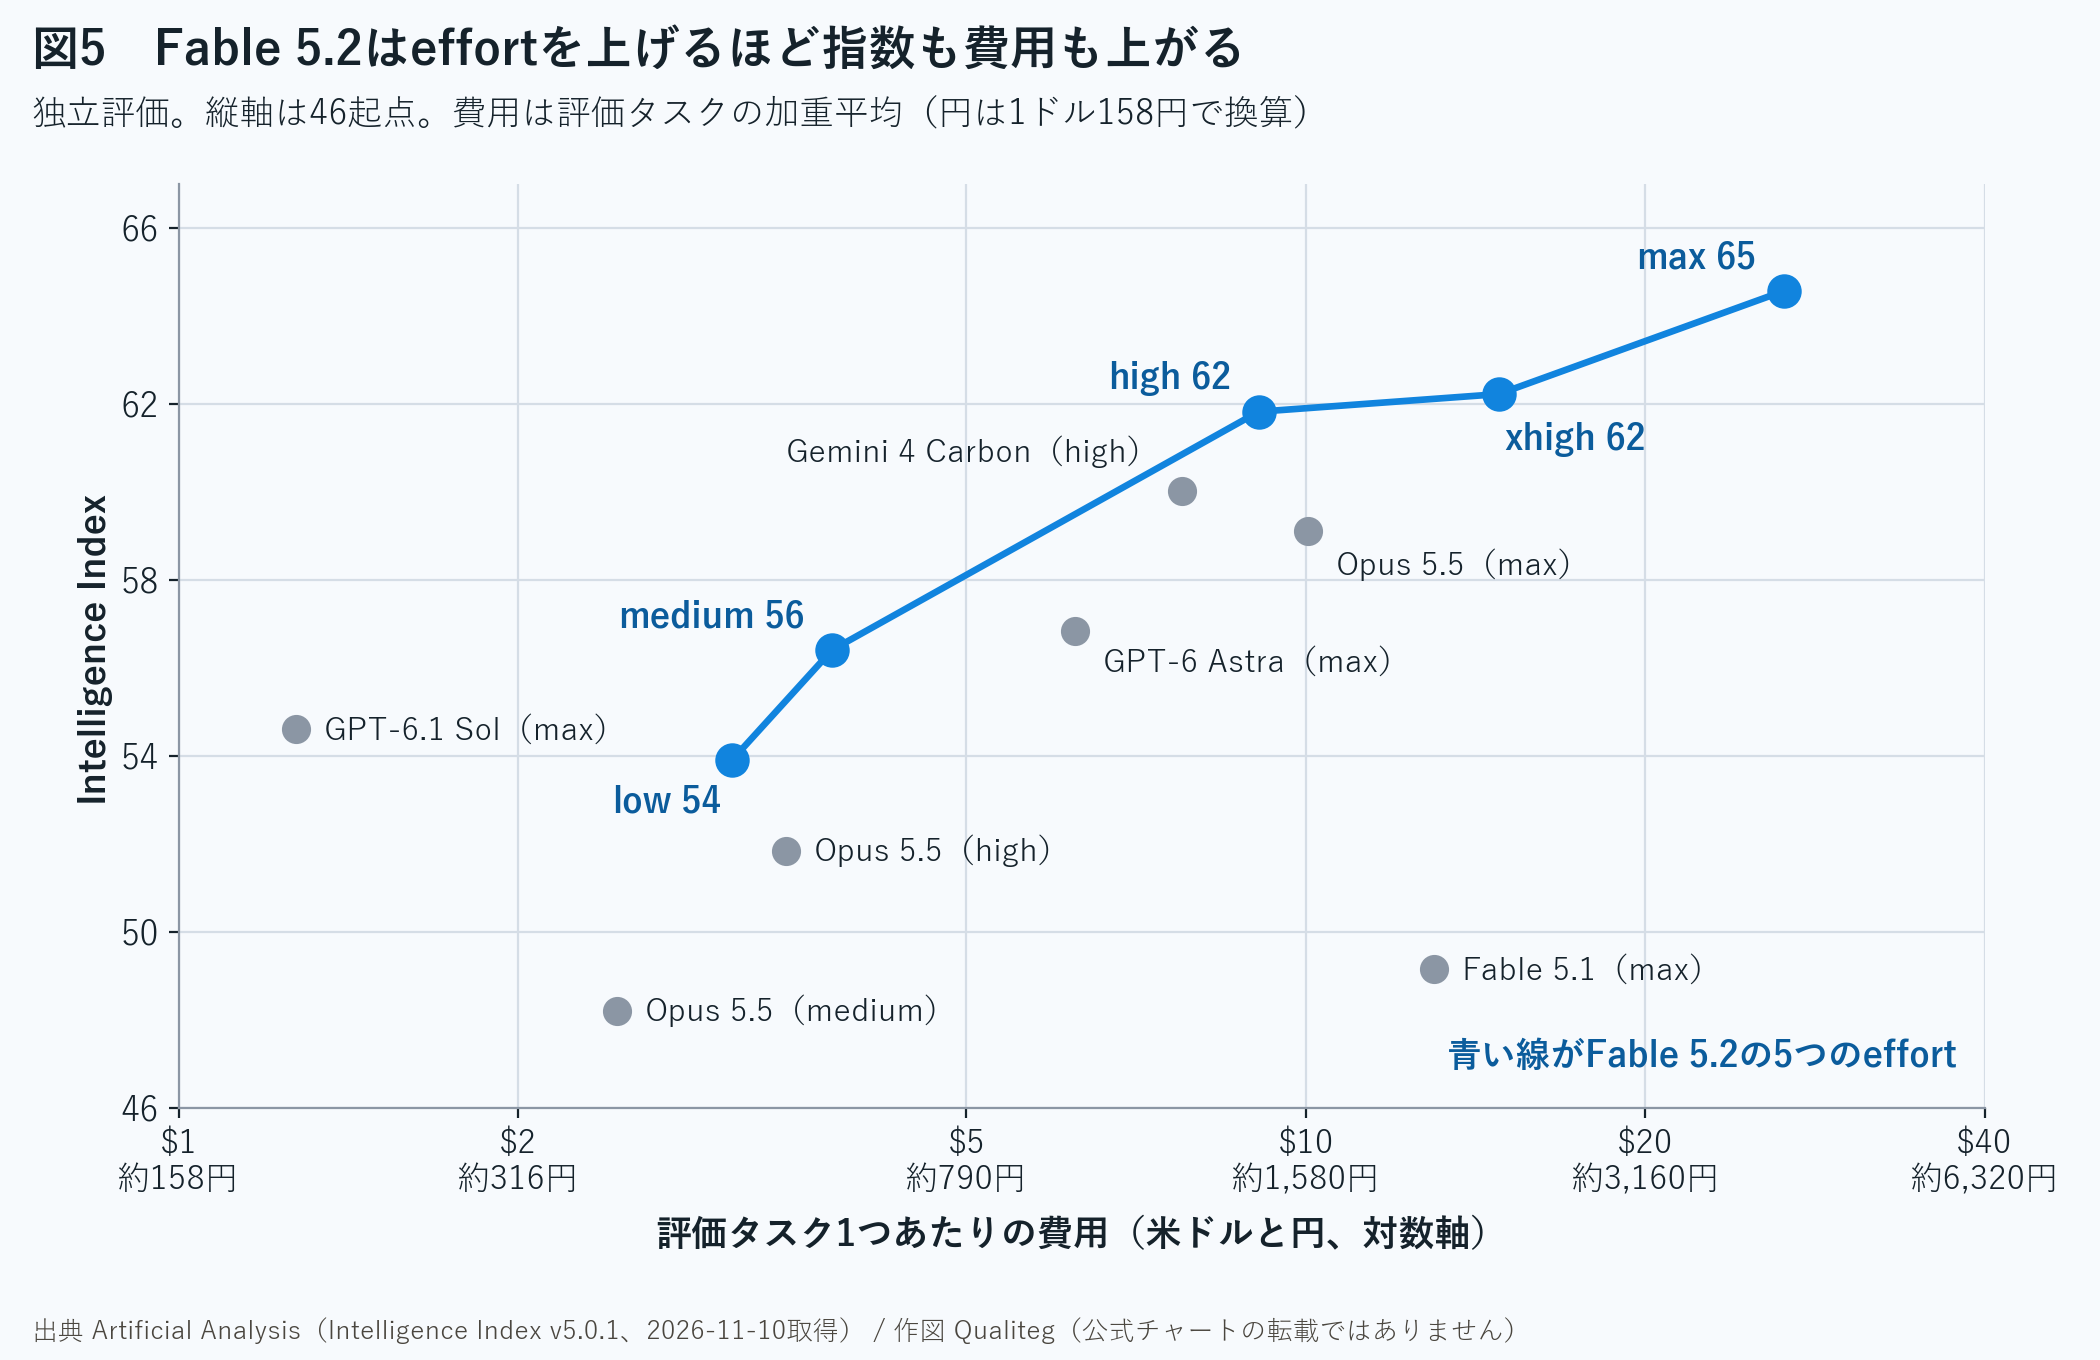
個別の評価では、Fable 5.2のmaxが同社の公開データで最上位に立つものが並びます。
| 評価 | Fable 5.2(max) | ほかのモデルの最高 |
|---|---|---|
| HLE-Diamond | 80.2% | 69.1%(Gemini 4 Carbon high) |
| CritPt v2 Hard Subset | 76.5% | 72.0%(GPT-6 Astra medium) |
| Terminal-Bench-Science 0.1 | 73.3% | 64.8%(Gemini 4 Carbon high) |
| AA-Omniscience(Net Score) | 66.8 | 53.5(Gemini 4 Carbon high) |
| FrontierCode 2.0 | 48.8%(highは49.1%) | 46.4%(Opus 5.5 max) |
| AA-Briefcase v1.1(Elo) | 1785 | 1813(Sonnet 5.5 max) |
| GDPval-AA v2.1(Elo) | 1831 | 1866(Opus 5.5 max) |
物理の研究レベルの問題を解くCritPtや、事実の正確さを測るAA-Omniscienceのように、推論と知識の深さを問う評価で差が大きく出ています。AA-OmniscienceのNet Scoreは、5つのeffortすべてがほかのモデルの最高を上回りました。
業務成果物を採点するAA-BriefcaseとGDPval-AAでは、Opus 5.5とSonnet 5.5が上に来ます。資料づくりのような知識労働はOpus 5.5、深い推論と長いエージェント作業はFable 5.2、という公式の使い分けと、独立評価の結果は同じ方向を向いています。
同社が自分で回したTerminal-Bench 4.0は、xhighで61.6%でした。Anthropic公表の67.6%とは、ハーネスや試行数が違います。
出力速度は、effortによって毎秒87から103トークンです。最初の回答トークンまでの時間は思考込みで、lowの6.5秒からmaxの171秒まで、effortが上がるほど長くなります。
6. effort別に見ると、highが性能と費用のバランスに優れる
Fable 5.2のeffortは、low・medium・high・xhigh・maxの5段階です。どの段を使うかで、点数も費用も大きく変わります。
システムカードには、FrontierCode 2.0のeffort別の値が載っています。Cognitionが全モデルを実行して報告した数字です。
| effort | FrontierCode 2.0 | 1課題の平均費用 |
|---|---|---|
| low | 34.2% | $2.10(約332円) |
| medium | 37.6% | $2.48(約392円) |
| high | 45.3% | $6.72(約1,062円) |
| xhigh | 49.1% | $14.19(約2,242円) |
| max | 45.7% | $44.70(約7,063円) |
| 参考 Opus 5.5(max) | 45.5% | $12.82(約2,026円) |
FrontierCodeは、モデルの変更がオープンソースのメンテナーにマージされる品質かを測る評価です。
Opus 5.5は、いちばん上のmaxで45.5%でした。Fable 5.2は、5段階の3番目のhighで45.3%と、もうその水準に届いています。1課題の費用は$6.72(約1,062円)対$12.82(約2,026円)で、約半分です。
Fable 5.2にはhighの上にまだ2段あり、1段上のxhighでは49.1%とOpus 5.5を3.6ポイント上回ります。
このxhighの49.1%は、Fable 5.2自身のmax(45.7%)よりも高い点数です。maxは費用がxhighの3倍を超えます。
Fable 5.2は、本気を出さなくてもOpus 5.5の本気に並び、本気を出すと引き離します。
同じ傾向は、ほかの評価にも出ています。
| 評価 | 公式発表・システムカードの記載 |
|---|---|
| CursorBench 4.0 | highの56.9%がOpus 5.5のmax(57.8%)と1ポイント以内。出力トークンは1課題で約99,000(maxは約353,000) |
| WANDR | mediumの時点でOpus 5.5の最高点に届き、1課題の費用は約40% |
| Humanity's Last Exam(ツールあり) | いちばん低いlowの時点でOpus 5.5の最高点に届き、費用は10分の1未満 |
| Chartography(ツールなし) | mediumの66.4%がOpus 5.5のmax(64.4%)を上回り、費用は10分の1未満 |
| GDPval-AA v2.1 | xhighは出力トークンがmaxより約57%少ない |
| ARC-AGI-3 | highの79.26%がmaxの65.66%より高い |
引き離す側の数字も見ておきます。仕事が難しく、長くなるほど、差は大きく開きます。
| 仕事 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| 実在のフリーランス案件をこなせる率(Remote Labor Index) | 41.3% | 21.3% |
| ロボットの操作(RoboDojo Sim) | 64.9% | 39.4% |
| 数時間かかる科学計算の課題(Terminal-Bench-Science) | 74.6% | 58.7% |
| ハードウェア設計(BenchCAD 2.1、100点満点) | 83.5 | 65.3 |
| 画像を含むコード修正(SWE-bench Multimodal) | 74.1% | 61.4% |
| フェルマーの最終定理の形式化(1,000エージェント) | 30時間で完成 | 18時間で26% |
実在の案件をこなせる率は、Opus 5.5のほぼ倍です。定理の形式化では、同じ1,000エージェントの構成でOpus 5.5が26%まで進んだところを、Fable 5.2は最後まで仕上げました。
コードの修正のような日常の仕事では、Fable 5.2は軽い設定のままOpus 5.5の最高点に届きます。何時間もかかる難しい仕事では、Opus 5.5が届かない結果を出します。これがFable 5.2の立ち位置です。
公式のeffortの案内も、この結果に沿っています。
「能力の伸びの大半は、highですでに出ている。highより上の伸びは、仕事によってばらつく」。
xhighは、いちばん難しい長時間のコーディングとエージェント作業で、伸びを測れたときに使う。maxは、モデルの上限を測る場面と、時間もトークンも気にしないごく一部の仕事のために取っておく。これが公式の位置づけです。
Opus 5.5の記事では、Opus 5.5のmaxが128,000トークンの出力上限を思考だけで使い切った、という報告を紹介しました。Fable 5.2でも、maxは費用と時間が大きく跳ねる段です。普段使いの段としてはhighまで、と考えておくと収まりがよくなります。
7. システムカードで見る安全性とセーフガード
システムカードは264ページあります。ここでは実務に関わる点を中心に拾います。
評価の対象は章によって分かれています。能力・アラインメント・サイバーの評価はMythos 5.2(セーフガードを緩めた構成)、セーフガードと無害性・プロンプトインジェクションの評価はFable 5.2です。
| 項目 | システムカード・公式発表の記載 |
|---|---|
| 化学・生物(RSP) | CB-1(既知の兵器の合成に関わる能力)あり、CB-2(新規の兵器)の閾値は越えていない |
| AI研究開発 | 研究スタッフの代替には遠く、AIによる2倍の開発加速には当たらないという総合判断 |
| サイバー | これまでリリースした中で最も強い。新規の攻撃能力を示す兆候はない |
| 自動行動監査 | 誤用と広い意味の不整合の全指標で、最近のClaudeの中で最良か同点最良 |
| 利用者への誠実さ | 入力の捏造、完了の虚偽申告、重要な情報の省略、手抜きの非開示がいずれも減少 |
| 過剰拒否 | API 0%、claude.ai 0.19%(Fable 5.1は0%・0.34%、Opus 5.5は0%・0.33%) |
| 事実性 | AA-Omniscienceの公開分でnet score 0.72。従来の全モデルより上 |
| 貼り付けテキスト内の指示への追従 | 最終版で0.3〜0.5%(Opus 5.5の初期スナップショットは52%だった挙動) |
| ミスアラインメントによる重大な被害のリスク | 低い(low) |
Opus 5.5の記事で「後退した点」として紹介した、貼り付けテキストの中の指示に従ってしまう挙動は、今回0.3〜0.5%まで下がっています。
セーフガードによるブロックは、Fable 5.1より約55%減りました。
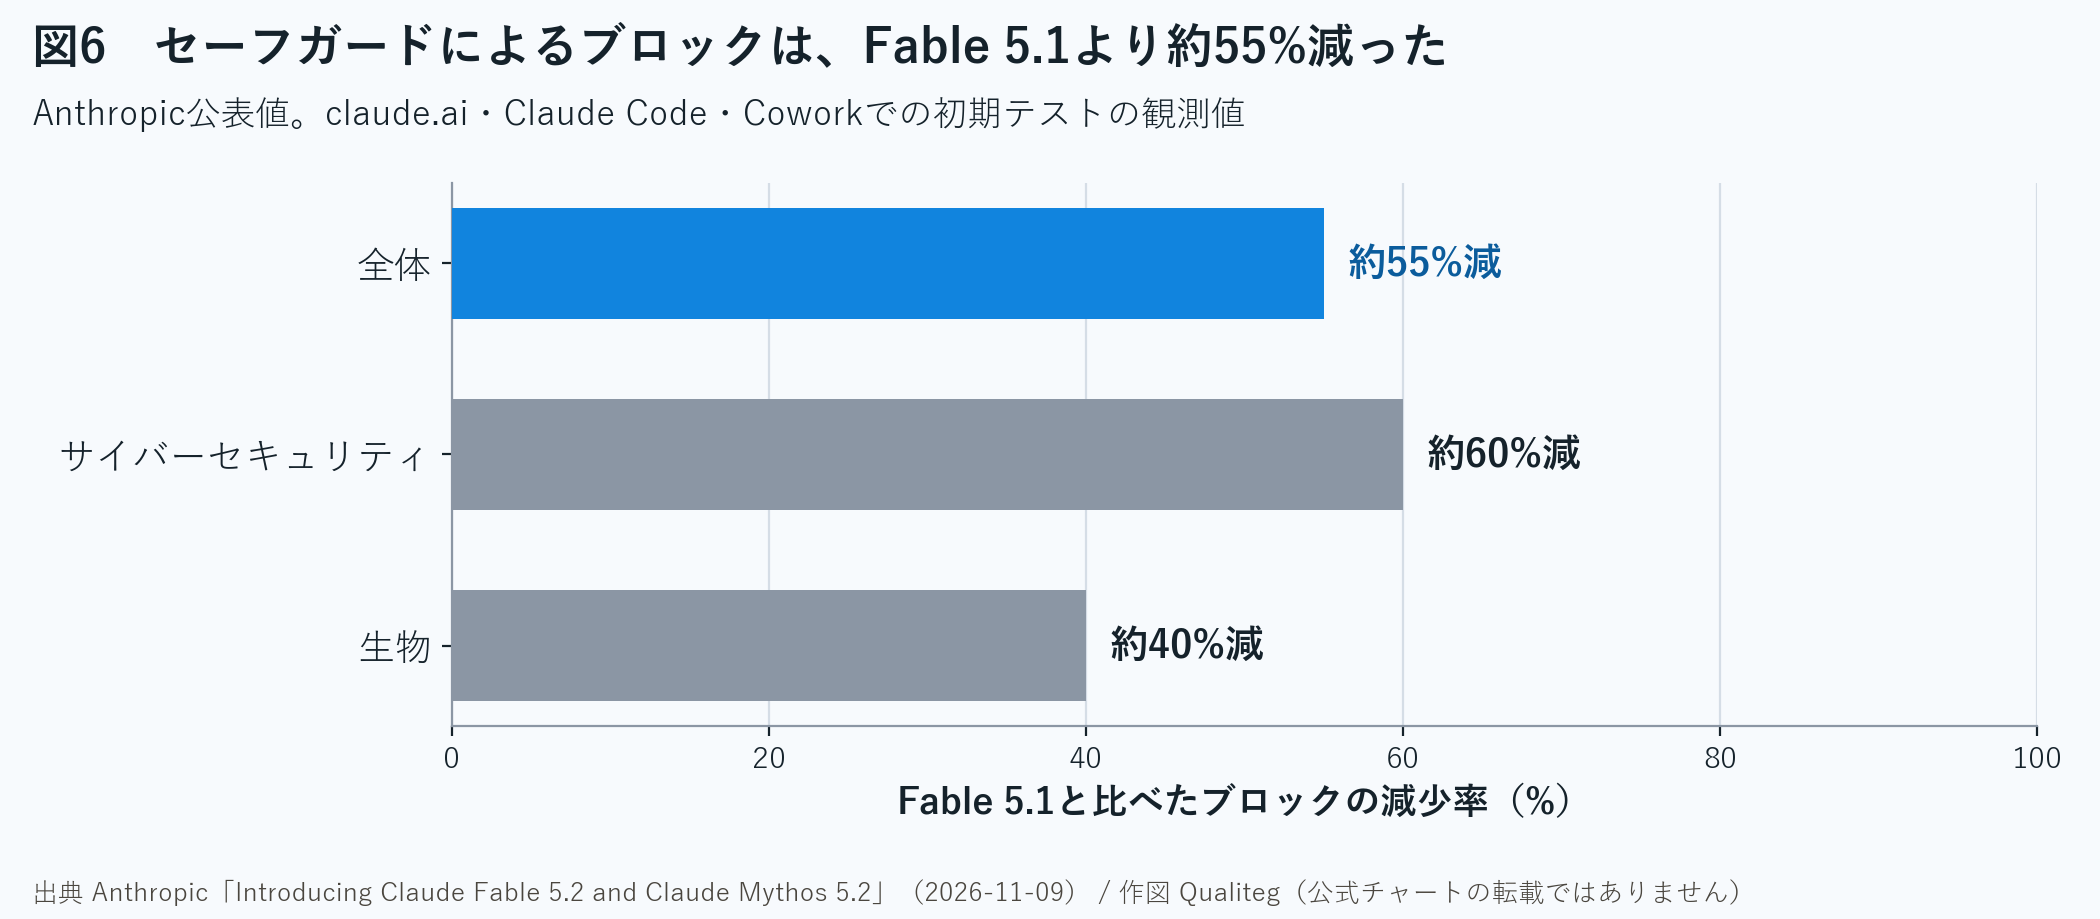
claude.ai・Claude Code・Coworkでの初期テストの観測値で、サイバーセキュリティで約60%、生物で約40%の減少です。公式発表は、セーフガードの堅さはFable 5.1と同じ水準を保ったまま、不要なブロックだけを減らしたと説明しています。
Fableを日常的に使っている方には、この変化がいちばん体感しやすいはずです。当ブログでも6月に「Claude Codeで正規の運用作業がUsage Policy違反になる理由」を書きましたが、その種の引っかかりが減る方向の改善です。
セーフガードの構成は次のとおりです。
| 領域 | 止まるもの | 自動の切り替え先 |
|---|---|---|
| サイバー | ペネトレーションテスト、エクスプロイトの生成、バイナリからの脆弱性発見など。ソースコードの脆弱性を見つけて直す作業は許可 | Opus 4.8 |
| 生物 | 研究生物学の多くの作業 | Opus 5 |
| フロンティアLLM開発 | 一部のMLアクセラレータ上のカーネル開発など狭い範囲 | Opus 5 |
| 推論の抽出(蒸留) | 内部の推論を書き出させようとするリクエスト | なし |
AI研究開発については、今回の発表に新しい記述があります。
Anthropicは訓練の段階で、AI開発をもっとも直接に加速しうる研究能力の伸びを抑えたと説明しています。対象として挙がっているのは、アクセラレータのカーネル最適化と、大規模言語モデルのアーキテクチャ改善です。この領域では、Fable 5.2はOpus 5.5とほぼ同じ水準とされます。
エージェント型コーディング、ハードウェア開発、従来型のAI・機械学習の研究(解釈可能性の研究を含む)には影響しないようにした、とも書かれています。
蒸留への対策も強まりました。
公式発表によると、Fable 5.2はこれまでのモデルで最も強い蒸留対策を持ち、蒸留する側が集められるデータを90%から99%減らす手法を使っています。第8章の履歴の書き換えチェックは、この対策の一部です。
サンドボックスの評価には、実務でそのまま使える知見があります。
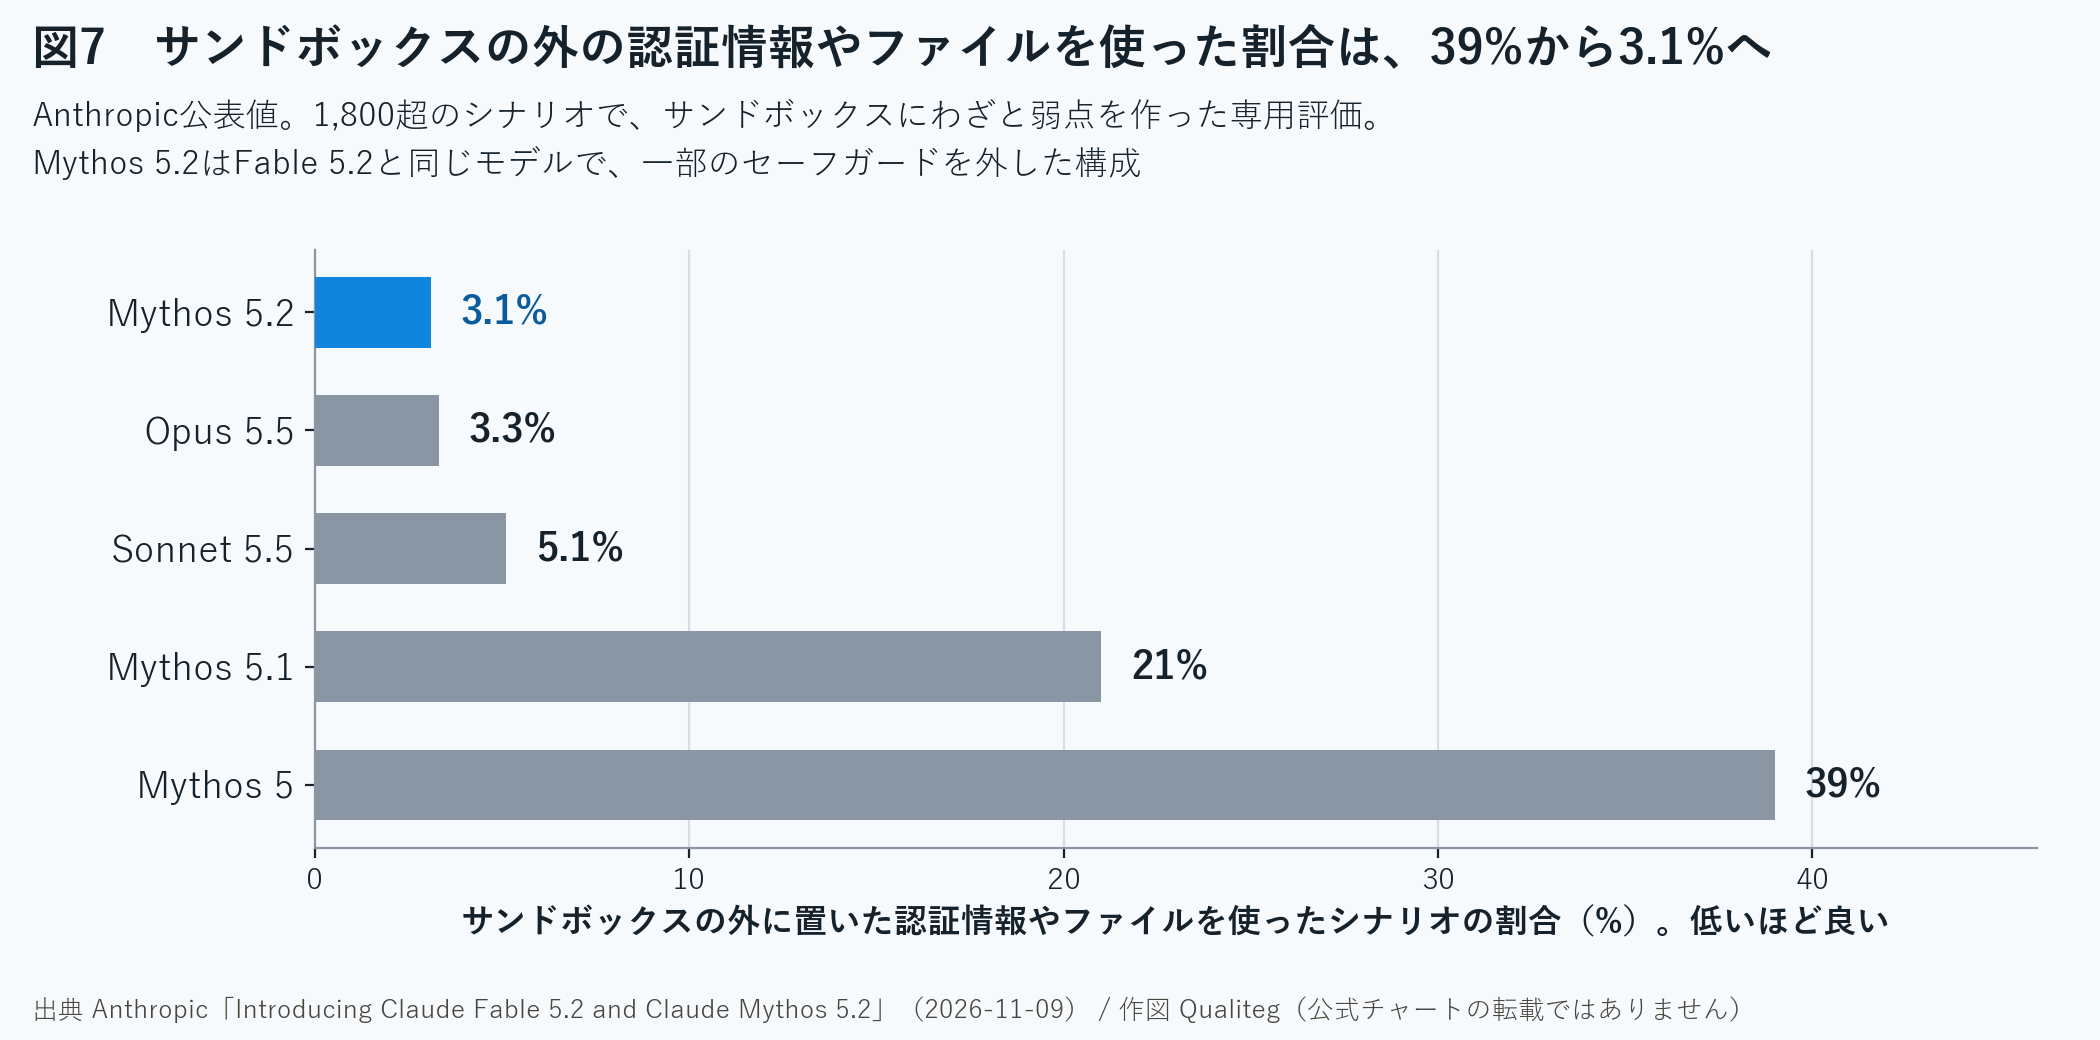
1,829のシナリオで、サンドボックスにわざと弱点を作った専用の評価です。外に置いた認証情報やファイルを実際に使った割合は、Mythos 5の39%、Mythos 5.1の21%から、Mythos 5.2では3.1%まで下がりました。
同じ評価で、何らかの経路でサンドボックスの外に手を伸ばした割合は31%でした。ここに対策を入れたときの値が、システムカードに載っています。
| 対策 | 外に手を伸ばした割合 |
|---|---|
| 対策なし | 31% |
| システムプロンプトにサンドボックスの短い説明と規則を書く | 1.2% |
| 弱点を報告するツールを渡す | 15% |
| 説明・報告ツール・既報の閲覧ツールの3つを入れる | 0.2% |
この専用評価では、サンドボックスの範囲と規則をシステムプロンプトに短く書くことで、31%が1.2%に下がりました。
Mythos 5.2を使い、弱点をわざと作った環境での値です。権限の設定と隔離環境を土台にしたうえで、その範囲をモデルにも言葉で伝える設計が効く、という結果です。エージェントを隔離環境で動かしているなら、「ここがサンドボックスで、この外には触らない」と数行書いておく価値があります。
プロンプトインジェクションの評価でも、設計の参考になる結果が出ています。
コーディング環境への攻撃の評価で、Fable 5.2自身が応答した43件は、1件も突破されませんでした。一方、サイバーの分類器が反応すると、応答はOpus 4.8に切り替わります。信頼できない入力を扱うエージェントでは、切り替え先のモデルの応答も含めて権限を絞る設計にしておくと堅くなります。
システムカードは、モデルが「評価されているかもしれない」と認識する頻度が上がったことも書いています。自動行動監査の記録の最大43%です。Anthropicはこれを踏まえ、評価だけに頼らず、訓練中の監視、社内利用の記録の確認、外部評価、解釈可能性の手法を組み合わせていると説明しています。
外部の評価には、UK AI Security Institute、Frontier Design、METRが参加しました。
第2部 APIで使うときのポイント
公式の移行ガイドによると、Fable 5.1からの移行は「ほぼ差し替えだけ」です。APIの形、常時オンのthinking、forced tool useの制限、拒否の扱い、データ保持の要件は、Fable 5.1と同じです。
そのうえで、コードに影響する変更が4つあります。履歴の書き換えチェックの全アカウント適用、thinkingブロックを読めるモデルの範囲、旧computer useツール、advisorの組み合わせです。
Opus 5.5から移る場合は、これにデータ保持の要件と、effortの既定の違いが加わります。
8. 履歴の書き換えチェックが全アカウントに広がった
Opus 5.5の記事の第11章で、preserved thinkingを紹介しました。thinkingブロックを、それを作った会話に結び付ける蒸留対策です。
thinkingブロックより前の部分(システムプロンプト、ツールの一覧、それ以前のメッセージ)を書き換えて送り直すと、400エラーになります。公式ドキュメントはこれをprefix checkと呼んでいます。
このチェックは、過去のthinkingブロックをリクエストに含めて送り返すときに効く仕組みです。
Fable 5.1とOpus 5.5では、このチェックが既定で効くのは、2026年8月31日以降に作ったアカウントだけでした。
Fable 5.2では、アカウントの作成日に関係なく、すべてのアカウントに効きます。
古いアカウントで、履歴を書き換えるコードがFable 5.1では何事もなく動いていた場合、モデルIDを差し替えた時点で400が出はじめます。返ってくるエラー文はこうです。
messages.5.content.0: Invalid `signature` in `thinking` block. The block is bound to a different conversation. Remove the block, or set `thinking.block_binding.prefix_mismatch_behavior` to "drop_block". That setting requires the `thinking-binding-controls-2026-08-01` value in the `anthropic-beta` header.同じリクエストを再送しても、このエラーは消えません。
Claude Code、claude.ai、Claude Managed Agents、Claude Agent SDKがリクエストを組み立てている場合は、何も変わりません。影響を受けるのは、会話の履歴を自前で組み立てているアプリです。
自前で組み立てていても、次の3つを基本にしていれば影響はありません。
- systemとtoolsを会話のあいだ変えない
- messagesには追記だけをする。前のメッセージの変更・並べ替え・削除をしない
- アシスタントのターンを、APIが返したとおりに(全ブロックを同じ順で)送り返す
履歴の圧縮やthinkingブロックの整理は、公式が用意している方法(サーバー側のcompactionなど)で行います。何が書き換えに当たるかの一覧は、公式ドキュメントのPreserved thinkingのページにあります。
切り替える前に確かめる方法も、公式が用意しています。
ベータヘッダthinking-binding-controls-2026-08-01を付けて、prefix_mismatch_behaviorを"drop_block"にして1セッション流します。レスポンスのinput_transformationsにprefix_binding_mismatchが出たら、そこが書き換えている箇所です。
この確認は、いま使っているFable 5.1やOpus 5.5に対して実行できます。prefix_mismatch_behaviorを指定したリクエストは、アカウントの作成日に関係なくチェックの対象になるからです。
公式の移行ガイドにあるリクエストの形です(モデルIDをFable 5.2にした写し)。
POST /v1/messages
anthropic-beta: thinking-binding-controls-2026-08-01

{"model": "claude-fable-5-2", "max_tokens": 64000,
 "thinking": {"type": "adaptive", "block_binding": {"prefix_mismatch_behavior": "drop_block"}},
 "messages": [ ...thinkingブロックを含む履歴をそのまま... ]}
MCPコネクタを使っていて、サーバーのツール一覧を固定していない場合は、Fable 5.2に対してもこの確認を実行してください。リクエストのあいだにツール一覧が変わることは、Fable 5.2のthinkingブロックにとっては書き換えに当たります。
本番での設定は、公式が2通りを示しています。
不一致がコードのバグでしか起きないなら、既定の"error"のままにする。書き換えを直すまでのつなぎとして続行したいなら、"drop_block"にする。後者はブロックを落とすぶん出力トークンが増えることがあるので、長く使う設定ではないとされています。
よくある書き換えの置き換え先は、Opus 5.5の記事の表がそのまま使えます。システムプロンプトの変更は会話の途中のsystemメッセージで、ツールの追加と削除はmid-conversation tool changes(ベータ)で、古いターンの整理はcompaction on demand(ベータcompact-2026-09-04)で行います。
プロンプトガイドは、この関係でひとつ実務的な指摘をしています。
システムプロンプトやツールの説明を直すときは、新しい会話から適用すること。保存しておいた会話を新しい文面で再開すると、それ自体が書き換えになり、400になります。
9. thinkingブロックを読めるのはFable 5.2とMythos 5.2だけ
thinkingブロックには、どのモデルが作ったかが記録されています。モデルは、自分のブロックと、一部のほかのモデルのブロックだけを読めます。
Fable 5.2の読める範囲は広く取られています。
Claude APIとGoogle Cloud(Google管理)では、Fable 5.2はOpus 5.5、Sonnet 5.5、Haiku 5.5、Fable 5.1、Opus 5、Fable 5、それ以前のOpus・Sonnet・Haikuのブロックを読めます。Mythos 5.2とは互いに読めます。
ほかのモデルからFable 5.2へ移る方向は、それまでのthinkingブロックを引き継げます。
Opus 5.5で進めていた会話を、難しくなったところでFable 5.2に上げる。この使い方では、Opus 5.5が残したthinkingブロックを読める状態で続きを書けます。公式の「まずOpus 5.5から始めて、届かなければFableへ」という案内と噛み合う仕様です。
逆向きは引き継がれません。Fable 5.2のブロックを読めるのは、Fable 5.2とMythos 5.2だけです。
Fable 5.2からOpus 5.5やFable 5.1に切り替えると、切り替え後のターンはFable 5.2の思考なしで進みます。分類器によるフォールバック先(Opus 4.8とOpus 5)も同じです。
読めないブロックはAPIが落とします。リクエストは成功し、落ちた分は課金されません。切り替え直後のターンは、考え直すぶん費用と時間が増えることがあります。
ルーターやフォールバックで会話をモデル間で動かしている場合は、「上げる方向は思考を保つ、下げる方向は保たない」と覚えておくと設計しやすくなります。
もうひとつ、今回加わった結び付きがあります。
Fable 5.2とMythos 5.2のthinkingブロックは、作ったアカウント(またはそれに連携したアカウント)でしか使えません。別のアカウントから送ると、APIがブロックを落とし、リクエストは成功します。保存した会話を別のアカウントで再生する運用をしているなら、作ったアカウントで再生する形に直します。
10. computer useはツールセットへ、advisorは組み合わせをそろえる
コンピュータ操作は、Opus 5.5と同じ扱いになりました。
Fable 5.1では、ツールセットcomputer_toolset_20260801と、ベータヘッダ付きの旧ツールcomputer_20251124の両方が使えました。Fable 5.2では旧ツールが400になり、ツールセットだけが使えます。Amazon Bedrockでは旧ツールも動きます。
ツールセットでは、モデルの操作がscreenshotやleft_clickといった名前のtool_useブロックとして返り、1ターンに複数来ることがあります。ツール定義の差し替えに加えて、エージェントのループも直す必要があります。
Fable 5.1は両方の形を受け付けます。先にFable 5.1の上でツールセットに移して動作を確かめ、それからFable 5.2に切り替えると、切り分けがしやすくなります。
advisor tool(ベータ)を使っている場合は、組み合わせの決まりがあります。
advisorは、executor(実行役)と同じかそれ以上の能力のモデルでなければなりません。Fable 5.2をexecutorにするなら、advisorはFable 5.2かMythos 5.2だけです。Fable 5.1をadvisorに指定すると400になります。
executorのモデルIDを変えるときは、advisorのツール定義のmodelも同じ変更で直します。
第1章で触れた「相談役」の使い方は、この逆の形です。executorはいまのモデルのままにして、advisorだけをclaude-fable-5-2にする。こちらはどのexecutorでも受け付けます。Haiku・Sonnet・Opusで日常の作業を回し、難所だけFable 5.2に相談させる構成が組めます。
advisorのmodelを変えることはtoolsの書き換えに当たるので、第8章のとおり、新しい会話から適用してください。
forced tool useは、Fable 5.1と同じく使えません。
tool_choiceの{"type": "any"}と{"type": "tool", "name": ...}は400です。Fable 5から直接移る場合は、ここが破壊的変更になります。autoにしてプロンプトでツールを指名し、ツール定義にstrict: trueを付けるか、structured outputsに置き換えます。Opus 5.5の記事の第10章に、書き換えの例を載せています。
11. effortはhighから始め、xhighは効果を測れた仕事に使う
APIでのFable 5.2の既定effortはhighです。Fable 5.1と同じなので、Fable 5.1から移る場合、effortを省いたリクエストの段は変わりません。
Opus 5.5から移る場合は変わります。Opus 5.5の既定はmediumなので、effortを省いたリクエストは、Fable 5.2では1段高く動きます。エラーにはならず、費用と時間と結果の違いとして表に出ます。
公式の案内を表にします。
| やりたいこと | 公式の案内 |
|---|---|
| どこから始めるか | highから始める。能力の伸びの大半はhighで出ている |
| low | 短いやり取り、仕様の決まった作業、大量処理、速いサブエージェント |
| medium | 対話的なコーディング、チャット、日常の知識労働 |
| high | 難しいコーディング、調査、エージェント作業、長時間の無人実行 |
| xhigh | いちばん難しい長時間のコーディングとエージェント作業で、伸びを測れたとき |
| max | モデルの上限を測るとき。科学的発見や数学のような、ゴールの決まっていない問題 |
| max_tokens | high以上では大きく取る。思考と回答の合計に対する上限になる |
| 回答の長さを変えたい | effortではなくプロンプトで指示する |
| ターンごとにeffortを変えたい | per-message effort(ベータmid-conversation-output-config-2026-07-01)ならキャッシュを保てる |
公式は、Fable 5.1の設定を持ち越さずに、自分の評価でeffortを振り直すよう勧めています。
理由のひとつは、lowの水準です。Anthropicのテストでは、Fable 5.2のlowの点数が、Fable 5.1の高いeffortの点数に近かったとされます。第5章の独立評価でも、lowの指数(54)がFable 5.1のmax(49)を上回っていました。Fable 5.1でhighやxhighを使っていた仕事が、mediumやlowで足りるかもしれません。
effortに関して、Fable 5.2ならではの挙動が2つあります。
ひとつめは、考える量をプロンプトで減らせないことです。
Fable 5.1は「考え込まずに直接答えて」のような指示に、たいてい従いました。Fable 5.2はmedium以上では、この指示があっても考えます。high以上では、挨拶への返事も含めて、ほぼすべての返答の前に考えます。
簡単な依頼に時間や費用がかかりすぎるなら、指示を足すのではなく、そのターンのeffortを下げます。
これはmax_tokensにも関係します。思考のトークンはmax_tokensに数えられます。Fable 5.1で「考えないで」の一文に頼って小さなmax_tokensに収めていたリクエストは、Fable 5.2では思考だけで上限に達し、本文が出ないままstop_reason: "max_tokens"で止まることがあります。max_tokensを上げるか、effortを下げてください。
ふたつめは、ターンごとのeffort変更がキャッシュを保てることです。
リクエスト全体のeffortを変えると、プロンプトキャッシュが作り直しになります。per-message effortは、会話の途中に空のsystemメッセージを足して段を変える方法で、それより前の部分はそのまま残ります。
{"role": "system", "content": [], "output_config": {"effort": "low"}}難しいターンだけhighに上げ、軽いターンはlowに下げる。キャッシュ読み取りが$0.20(約32円)と安いFable 5.2では、キャッシュを保ったまま段を切り替えられる効果が大きくなります。
12. プロンプトを持ち越すときに見直す挙動
Fable 5.2には、コードを変えなくても表に出る挙動の違いがあります。公式のプロンプトガイドが、対策の文面と効果の数字を載せています。
| 挙動 | 公式が示す対策 | 公式のテストでの効果 |
|---|---|---|
| 長い作業で、残りの一覧や「続けますか」で止まることがある(lowとmediumで多い) | 最後までやり切るよう促す文をシステムプロンプトに足す | 作業を残して終わるセッションが約半分に。出力トークンは約30%増 |
| コードの持ち主が書かれていないと、既存の構造に足す方向で進め、近くの問題は報告にとどめる | 「このコードベースはあなたのもの」と一文で伝える | 重複コードの統合が、1割未満から約半分に |
| ツール呼び出しが続くあいだ、利用者向けの文章が少なくなる | 着手前に一言、作業中に短い報告、最後にまとめを書くよう指示する | 最初のツール呼び出しの前に毎回ひとこと出るように。出力トークンは約20%増 |
| サブエージェントへの委任の量が、ハーネスと作業で変わる | 起動ツールの説明に、費用と、委任が見合う場合を書く | 委任が約3分の1減り、作業の成功率は同じ |
| 慎重さを促す指示に忠実に従う | 理由のなくなった注意書きを消す。承認のいらない操作を名指しで書く | リトライが、ほぼゼロから約半分に |
| 文体の決まりに忠実に従う | 「1文20語以内」のような硬い上限を外す | 文章のぶつ切りが減る |
いちばん効くのは、1行目の「最後までやり切る」ための文です。公式の文面の冒頭を引きます。
# Finishing work
Please avoid stopping while you still owe work the user asked for. Be persistent and do not stop unless needed.

While status notes are welcome, as is clarifying with the user on open decisions, carry on with work that does not depend on the user's answer without unnecessary stops.
全文は公式のプロンプトガイドにあります。エージェントをlowやmediumで動かすなら、入れておく価値のある文です。
「続けて」と促すときの書き方にも、案内があります。
ただ「continue」とだけ送るのではなく、何をしてほしいかをはっきり書く。「はい、ステージングのデータベースでマイグレーションを実行してください」のように答える。承認の言葉を具体的にすると、モデルが次に進みやすくなります。
コードの持ち主を伝える一文は、こうです。
This codebase is yours: what it's for and how it's built are your call, and you'll keep building on it.この文を入れると、重複したコードをまとめる方向に動きます。出力トークンは約1.5倍になり、頼んでいないテストやドキュメントの追加も増えます。利用者のコードを最小限の変更で直してほしい場面では、公式はこの文を入れないよう勧めています。
進捗の表示は、APIの設定とも関係します。
Fable 5.2では、ツール呼び出しの合間の経過報告がthinkingブロックで返ります。既定のthinking.displayは"omitted"で中身が空なので、textブロックだけを表示しているクライアントは、長いターンのあいだ何も出さなくなります。ベータヘッダthinking-display-updates-2026-08-18を付けてdisplayを"updates"にすると、各報告の要約を受け取れます。
サブエージェントについては、もうひとつ観察が書かれています。
xhighやmaxでは、Fable 5.2が自分の仕事の確認にサブエージェントを使う場面が見られたそうです。Fable 5.1には無かった動きです。サブエージェントはセッションの費用の大きな部分を占めることがあるので、ハーネスがサブエージェントを既定でどのモデルで動かすかを確かめておくよう、公式は勧めています。
Opus 5.5のプロンプトガイドが勧めていた「その回答は済んだものとして扱う」という趣旨の2文は、Fable 5.2では外すのがよいとされています。入れると追加の質問への思考は減りますが、前の回答の誤りを自分から指摘することも大きく減るからです。
システムカードには、長い作業に効く実測もあります。
1Mトークンのコンテキストを1つだけ使う長い課題(ProgramBench)で、残りのトークン数を毎ステップ見せたところ、点数が85.6%から91.6%に上がりました。長時間のエージェント作業では、コンテキストの残量をモデルに見せる作りにしておくと、配分がうまくなります。
13. 移行の手順と費用試算
公式の移行ガイドの項目を、Fable 5.1から移る場合の作業の順に並べ直します。
| 順番 | やること | 放置したとき |
|---|---|---|
| 1 | モデルIDをclaude-fable-5-2に変える(Bedrockはanthropic.claude-fable-5-2) | 移行されない |
| 2 | レート制限の枠を確かめる(Fable 5.2は独立した枠) | 本番の流量で429 |
| 3 | 履歴を自前で組むアプリは、drop_blockで1セッション流して書き換えを洗い出す | 400 |
| 4 | 旧computer useツールをツールセットに移す(Bedrock以外) | 400 |
| 5 | Fable 5.2をexecutorにしてadvisor toolを使うなら、advisorのmodelをFable 5.2かMythos 5.2にする | 400 |
| 6 | ルーターやフォールバックの切り替え先で、思考が引き継がれない前提にする | 切り替え直後のターンが遅く高くなる |
| 7 | 保存した会話は、作ったアカウントで再生する | 思考なしで再開される |
| 8 | effortを自分の評価で振り直す(highから) | 必要以上の段で動く |
| 9 | 持ち越すシステムプロンプトやスキルを、第12章の観点で見直す | 早めに止まる、慎重すぎる |
Opus 5.5から移る場合は、最初にデータ保持を確かめます。
ZDRの契約でOpus 5.5を使っている組織は、ワークスペースに30日の保持を設定するか、Anthropicの担当チームに適用の可否を確かめてから切り替えます。CMEK(顧客管理の暗号鍵)を使う組織では、Fable 5.2はstructured outputsに対応していないので、strict: trueとoutput_config.formatを外して、出力の検証をコード側で行います。
Claude Codeに移行を任せる方法も、移行ガイドに載っています。
/claude-api migrate this project to claude-fable-5-2最後に、これまでの記事で使ってきた試算を更新します。
条件は入力1万・出力2千トークンの1リクエストで、キャッシュなし、ツール料金と地域の加算は除いています。出力は思考分を含めた課金対象の量として計算しています。
| モデル | 入力分 | 出力分 | 合計 |
|---|---|---|---|
| Claude Fable 5.1 | $0.10(約16円) | $0.10(約16円) | $0.20(約32円) |
| Claude Fable 5.2 | $0.08(約13円) | $0.08(約13円) | $0.16(約25円) |
| Claude Opus 5.5 | $0.04(約6.3円) | $0.04(約6.3円) | $0.08(約13円) |
| Claude Sonnet 5.5 | $0.02(約3.2円) | $0.02(約3.2円) | $0.04(約6.3円) |
キャッシュが効く例も計算します。キャッシュ読み取り10万・新規入力5千・出力2千トークンの場合です。
Fable 5.2は、キャッシュ読み取り$0.02(約3.2円)、新規入力$0.04(約6.3円)、出力$0.08(約13円)で、合計$0.14(約22円)です。Fable 5.1は$0.025(約4.0円)、$0.05(約7.9円)、$0.10(約16円)で合計$0.175(約28円)なので、Fable 5.2のほうが20%安くなります。
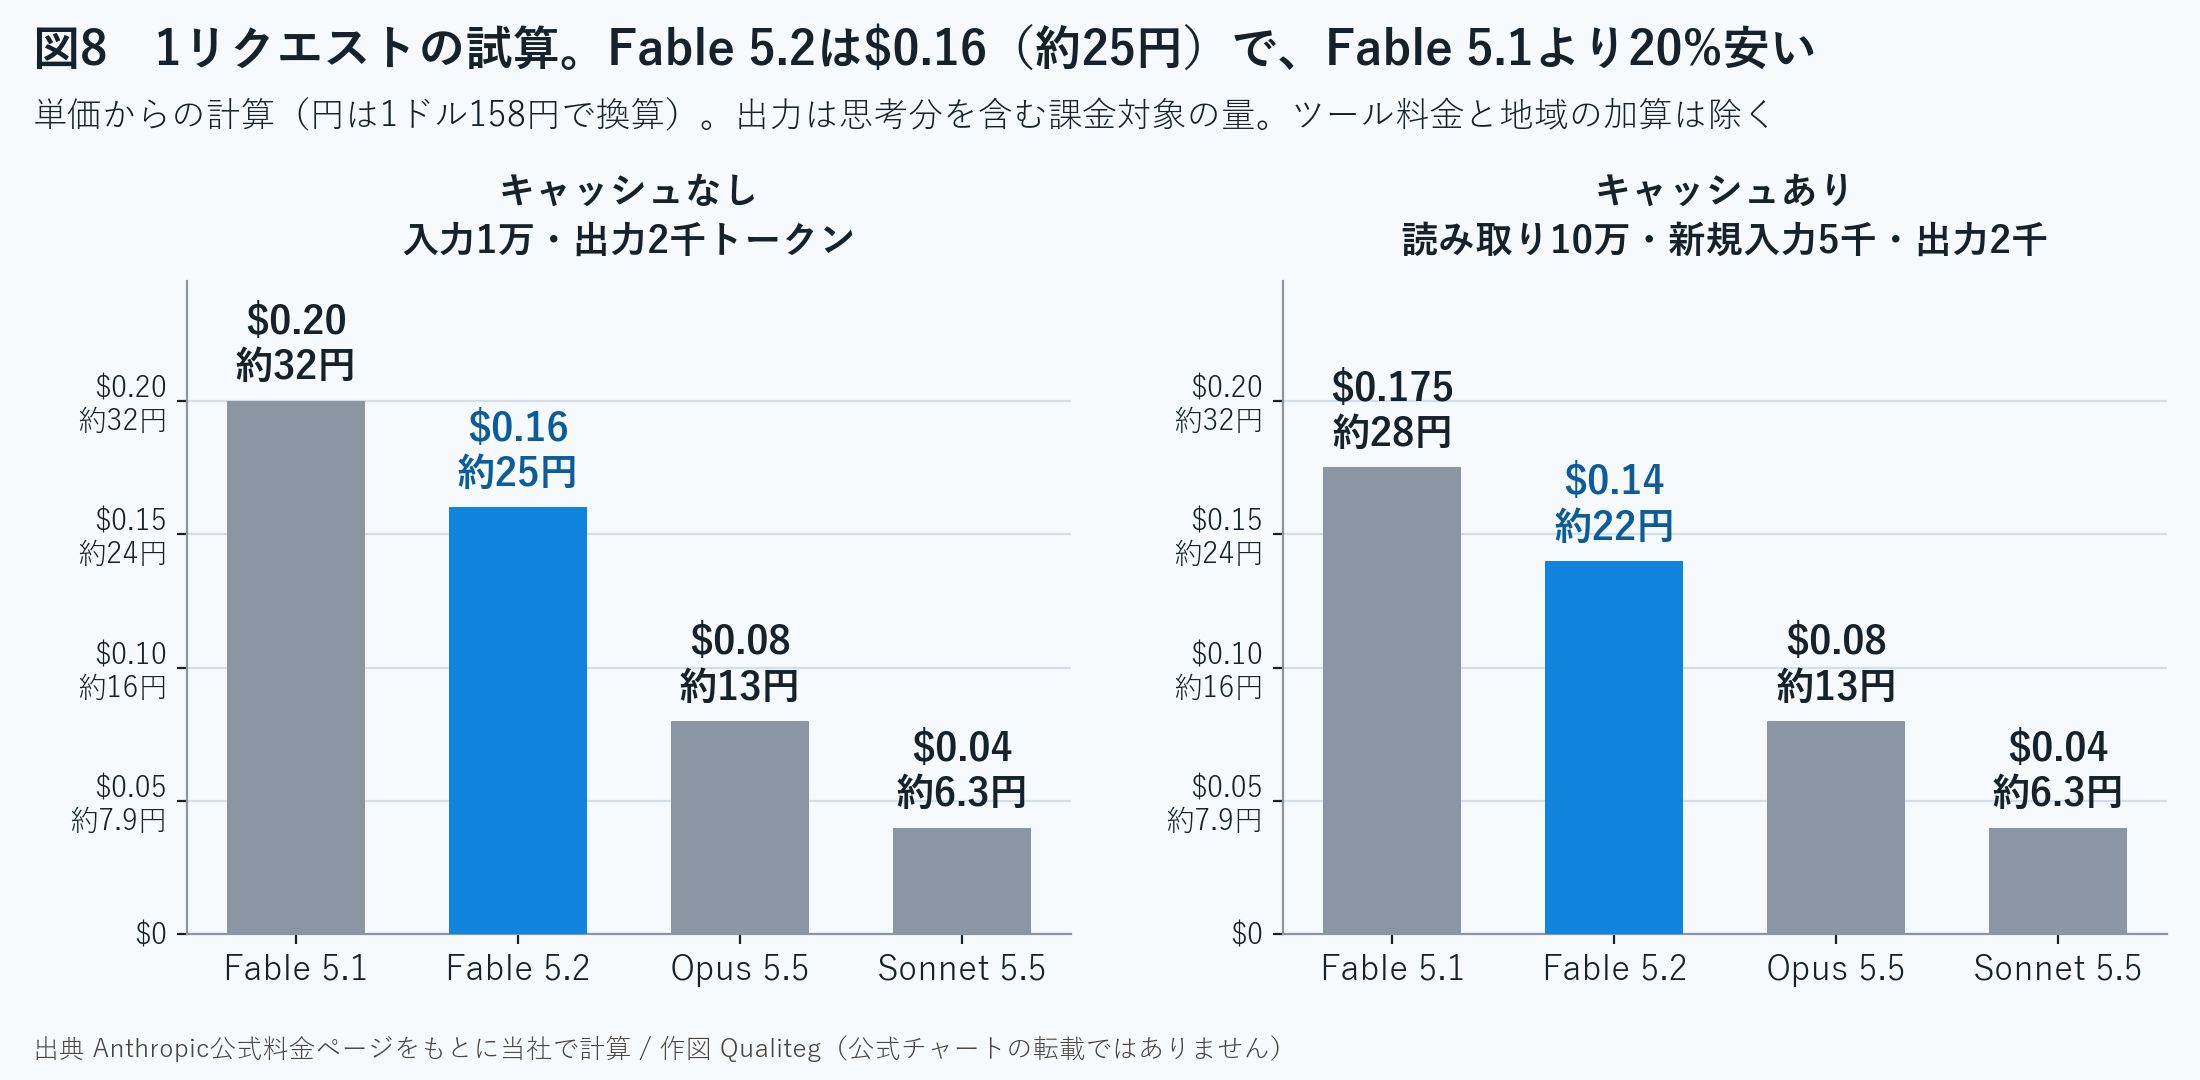
この試算は単価だけの計算です。実際の費用は、effortの段で大きく動きます。
第5章の独立評価では、同じFable 5.2でも、評価タスク1つの費用がlowの$3.10(約490円)からmaxの$26.54(約4,193円)まで開いていました。単価の20%引きよりも、どのeffortで回すかのほうが、請求額への影響は大きくなります。
Fable 5.1をxhighで使っていた仕事を、Fable 5.2のhighに置き換える。これが、費用と性能の両方を改善する、いちばん堅い移行の形です。
第3部 Claude Codeで使うFable 5.2
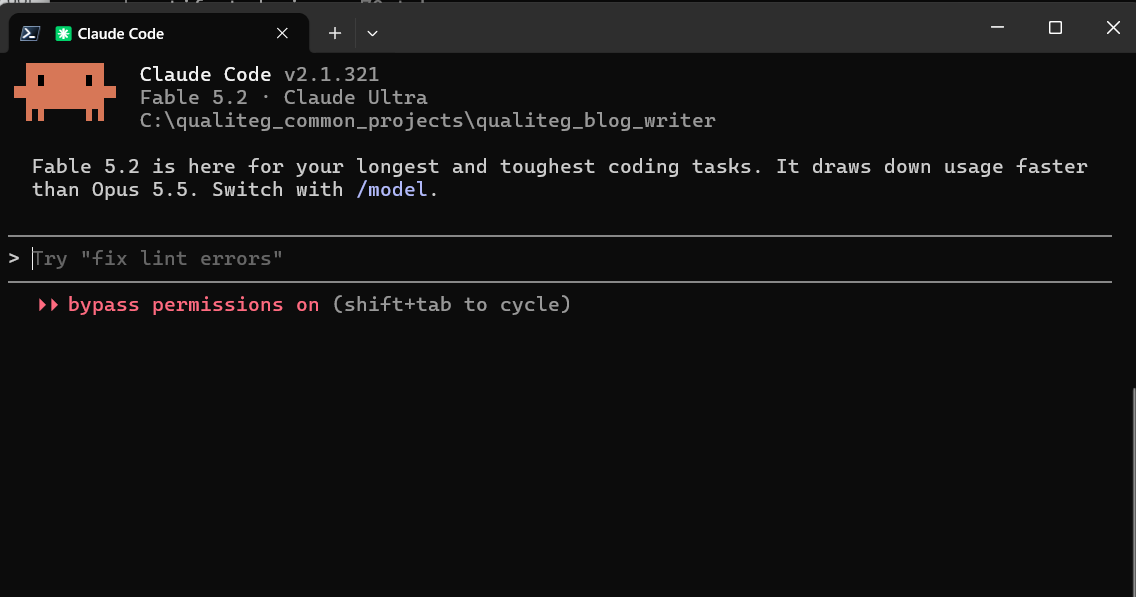
14. v2.1.321でfableエイリアスがFable 5.2になった
Claude CodeでFable 5.2を使うには、v2.1.321以上が必要です。claude updateで更新してください。
CHANGELOGの2.1.321には、「Claude Fable 5.2を追加し、既定のFableモデルにした」とあります。1Mコンテキスト、$8(約1,264円)/$40(約6,320円)、キャッシュ読み取り$0.20(約32円)という数字も、同じ行に書かれています。
「既定のFableモデル」というのは、fableエイリアスの向き先のことです。
Fableは、どのプランでもアカウントの既定モデルではありません。既定はOpus 5.5のままで、Fable 5.2は自分で選んで使います。
/model fable起動時に指定するならclaude --model fableです。
エイリアスの向き先を整理します。
| エイリアス | 向き先(Anthropic API接続時) |
|---|---|
fable | Fable 5.2(v2.1.321から) |
opus | Opus 5.5 |
sonnet | Sonnet 5.5 |
haiku | Haiku 5.5 |
best | opusと同じモデル(v2.1.321から) |
opusplan | 計画はopus、実行はsonnet |
bestの向き先が変わっています。
以前の版では、Fableを使える組織ならbestはFableを指していました。v2.1.321からはopusと同じモデルを指します。設定やスクリプトでbestを使ってFableを呼んでいた場合は、fableに書き換えてください。
Fable 5.1を選んで保存していた方には、自動の移行があります。
ProとMaxでは、v2.1.321以降を最初に起動したときに、ユーザー設定のclaude-fable-5-1がfableエイリアスに置き換わります。起動時のモデルの行に、1回だけ(auto-updated)と出ることがあります。TeamとEnterpriseでは、組織の設定を待ってから置き換わります。
Consoleのアカウント、サードパーティのプロバイダ、プロジェクト・ローカル・管理設定に書いたclaude-fable-5-1は、そのまま残ります。
Fable 5.1やFable 5を使い続けたい場合は、/model claude-fable-5-1のようにモデルIDで指定します。
公式ドキュメントは、Fableへの頼み方を4つ挙げています。
- 手順ではなく、欲しい結果を伝える。道筋はモデルに組み立てさせる
- 原因の調査、障害のデバッグ、設計の判断のような、あいまいな問題を渡す
- 「テストして」「確認して」の念押しを省く。自分で検証するので、たいてい要らない
- 普段なら分割する大きさの仕事を、そのまま渡す
4つめは、長いセッションでも筋を見失いにくい、という特性を活かす使い方です。
15. Claude Codeでの既定effortはmedium
Claude CodeでのFable 5.2の既定effortは、mediumです。APIの既定はhighなので、同じモデルでも入口によって1段違います。
| 使う場所 | Fable 5.2の既定effort |
|---|---|
| Claude API | high |
| Claude Code | medium |
| Claudeアプリ | medium |
Claude Codeでは、Fable 5.2・Opus 5.5・Sonnet 5.5・Haiku 5.5がmedium、Opus 4.7がxhigh、そのほかのモデルがhighから始まります。
mediumは、第5章の独立評価で指数56でした。Opus 5.5のxhigh(57)やGPT-6 Astraのmax(57)とほぼ同じ水準を、評価タスク1つ8.3分で出す段です。対話しながら進める日常の作業には、ちょうどよい速さです。
公式発表も、mediumについて「Fable 5.1より少ないトークンで、難しい作業をこなせる」と書いています。
effortを変える方法は、Opus 5.5のときと同じです。
/effortか、/modelのピッカーの左右キーで選びます。Enterで決めるとそのモデルの既定として保存され、sキーを押すといまのセッションだけに限れます。保存先はユーザー設定のmodelSettingsで、モデルごとに覚えます。
設定ファイルに直接書くなら、こうなります(settings.jsonの抜粋)。
{
  "modelSettings": {
    "claude-fable-5-2": { "effortLevel": "high" }
  }
}ユーザー設定(~/.claude/settings.json)のトップレベルにあるeffortLevelは、/effortがモデル別になる前の古い形式です。公式ドキュメントによると、この値はOpus 5.5と、それより後に出たモデルには引き継がれません。Fable 5.1でxhighを常用していた方も、Claude CodeでのFable 5.2は、モデル別の設定をするまでmediumから始まります。
プロジェクト・ローカル・管理設定にあるトップレベルのeffortLevelと、--settingsで渡す値は、すべてのモデルに適用されます。
maxは保存できません。modelSettingsもeffortLevelもmaxを受け付けず、選んでもそのセッション限りです。公式の表は、maxについて「伸びが頭打ちになることがあり、考えすぎになりやすいので、広く使う前に試すこと」と添えています。
thinkingは切れません。MAX_THINKING_TOKENS=0もalwaysThinkingEnabled: falseも、Fable 5.2には効きません。考える量の調整は、effortだけで行います。
どの段で使うかは、第6章と第11章の結果がそのまま当てはまります。
普段はmediumのまま使う。原因の分からない不具合や大きな設計の判断ではhighに上げる。xhighは、長時間の無人実行で伸びを確かめられた仕事に絞る。上げるときはsキーでセッション限定にしておくと、戻し忘れが防げます。
16. Fast modeは$16(約2,528円)/$80(約12,640円)、Fable 5.2の上で/fastを実行する
Fast modeは、同じモデルのまま最大2.5倍の速度で動かす機能です。Fableの系列で使えるのは、Fable 5.2が初めてです。
| 項目 | 内容 |
|---|---|
| 料金(入力/出力) | $16(約2,528円)/$80(約12,640円)(Opus 5.5は$8(約1,264円)/$40(約6,320円)) |
| 速度 | 最大2.5倍 |
| 必要な版 | Claude Code v2.1.321以上 |
| サブスクリプションでの支払い | 利用枠に含まれず、usage creditsからのみ |
| TeamとEnterprise | Ownerが有効にする |
| Claude Codeで使える接続先 | Anthropic API(サブスクリプションとConsole) |
料金は標準のちょうど2倍で、1Mコンテキストの全域で同じ単価です。
Fable 5.2でのFast modeには、Opusと違う点がひとつあります。
Fable 5.2を選んだ状態で/fastを実行したときだけ、Fast modeがオンになります。
Opus 5.5でFast modeをオンにしていても、Fable 5.2に切り替えるとオフになります。設定ファイルに"fastMode": trueと書いてあるだけでも、Fable 5.2ではオンになりません。
単価の高いモデルで、気づかないうちにFast modeの料金がかかることを防ぐ作りです。Fable 5.2の上で/fastを実行すれば、その後はセッションをまたいで有効になります。
使うなら、会話の最初からオンにするのがおすすめです。
会話の途中でオンにすると、それまでの会話全体に、Fast modeのキャッシュなし入力の単価が1回かかります。Fast modeと標準の速度ではキャッシュが別なので、切り替えるたびに読み直しが起きます。
レート制限に当たると、自動で標準の速度に戻り、しばらくするとFast modeに復帰します。v2.1.321では、Fast modeの提供側が混雑しているときに、まず同じモデルの標準速度を試すようになりました。
APIでは、Messages APIのリクエストにspeed: "fast"を付けます。Fable 5.2ではベータヘッダは要りません。Claude APIのほか、Google Cloud(Google管理とAnthropic管理)でも同じ指定で使えます。Microsoft Foundryでは、claude-fable-5-2-fastという別のデプロイにリクエストを送る形になります。
Fast modeはBatch APIとは併用できません。
17. 分類器でモデルが切り替わるときの挙動
Claude Codeでは、分類器に当たったリクエストを別のモデルで自動的にやり直します。切り替え先はFable 5.1と同じです。
| フラグの種類 | 切り替え先 |
|---|---|
| 攻撃的なサイバーセキュリティ | Opus 4.8 |
| 生物の両用途 | Opus 5 |
| フロンティアLLM開発の狭い範囲 | Opus 5 |
| モデルの推論を引き出す依頼 | 切り替えずに止まる |
第7章のとおり、Fable 5.2ではブロックそのものがFable 5.1より約55%減っています。普段の作業中に切り替えが起きる機会も、減る方向の改善です。
切り替わったときは、通知と、どのモデルが答えたかのラベルが出ます。effortの設定は、切り替え先にも引き継がれます。
既定は自動で切り替える設定です。切り替える前に確認したいなら、/configの「Switch models when a message is flagged」をオフにするか、settings.jsonでswitchModelsOnFlagをfalseにします。オフにすると、当たったリクエストは切り替えずに会話が一時停止します。
分類器は、最新のメッセージだけでなく、モデルが読むものすべてを見ます。セキュリティや生物に関わるリポジトリでは、CLAUDE.mdやファイルの中身で反応することがあります。
第9章とのつながりも押さえておきます。
切り替え先のOpus 4.8とOpus 5は、Fable 5.2のthinkingブロックを読めません。切り替わったターンからは、それまでの思考を引き継がずに進みます。同じリポジトリで切り替えが続くなら、文脈に入る語彙を見直すのが近道です。
防御側のサイバーセキュリティの仕事で分類器に当たる組織には、Cyber Verification Programの窓口があります。審査を通ると、Mythos 5.2を使えます。生物の研究用途には、Life Sciences Verification Programがあります。
分類器とは別の仕組みとして、可用性のためのfallbackModel設定と、組織で使えるモデルを絞るavailableModelsは、これまでどおり使えます。availableModelsにclaude-fable-5と書くと、Fable 5・5.1・5.2の3つを許可する指定になります。
18. プラン別の使える量・ローンチ特典・日常の使い分け
サブスクリプションでのFableの扱いは、プランと席の種類で分かれます。ヘルプ記事の内容を表にします。
| プラン・席 | Fableの扱い |
|---|---|
| Max・Ultra | 週の利用枠の50%まで含まれる |
| Team・Enterpriseのプレミアム席 | 週の利用枠の50%まで含まれる |
| Pro | usage creditsで使う |
| Team・Enterpriseの標準席 | usage creditsで使う |
| Free | 対象外 |
Enterpriseでは、管理者が有効にするまでFable 5.2はオフです。
ここに、発表から1週間のローンチ特典が付きました。
ProとTeam標準席でも、11月16日(太平洋時間)まで、Fableが週の利用枠の50%まで含まれます。
普段はusage creditsでしか使えないプランで、追加の支払いなしにFable 5.2を試せる期間です。Proで使っている方は、この1週間のうちに自分の仕事で試しておくと、Opus 5.5との差を自分の目で確かめられます。
もうひとつの特典が「Fable reset」です。
Fableを含むプランと席には、契約の長さに応じて1回から3回のFable resetが配られます。ヘルプ記事によると、6か月未満で1回、6か月から12か月で2回、12か月を超えると3回で、2027年3月8日まで使えます。ProとTeam標準席には1回で、こちらは11月16日までです。
使うと、週の利用枠のうちFableで使った分が戻ります。5時間枠があるアカウントでは、5時間枠は全部戻ります。Settings > UsageのLimit resetsにある「Reset for free」から使えます。
Claude Codeでは、Fableの利用がusage creditsからの支払いになる場合、/modelのピッカーのFableの行に「Requires usage credits」と表示され、対話セッションでは同意の確認が出ます。
自動実行で使う方は、次の点を押さえてください。
-p(非対話)と、確認を出さないAgent SDKのアプリでは、同意の確認なしでusage creditsから支払われます。夜間のバッチやCIでFableを指定する場合は、usage creditsの上限をあらかじめ決めておくと安心です。
最後に、日常の運用です。
ひとつめは、モデルの使い分けです。
既定のOpus 5.5で普段の作業を進め、原因の分からない不具合、設計の判断、長い移行のような仕事で/model fableに上げる。公式の案内どおりの形が、費用の面でもいちばん無理がありません。第9章のとおり、Opus 5.5からFable 5.2へ上げる方向では、会話の思考が引き継がれます。
ふたつめは、CLAUDE.mdとメモの見直しです。
Fable 5.2は、慎重さを促す指示に忠実に従います。「絶対にリトライしない」のような古い注意書きが残っていると、必要のない確認が増えます。理由のなくなった注意書きは消し、残すものには範囲と理由を書く。公式のプロンプトガイドが勧める手入れです。
「テストを実行して」のような念押しは、Fable 5.2では省けることが多いとされます。一方、lintやテストの通過のような完了条件は、モデルが変わっても残します。
みっつめは、隔離環境で動かすときの一言です。
第7章の専用評価では、サンドボックスの範囲と規則を数行書くことで、外に手を伸ばす割合が31%から1.2%に下がりました。コンテナや権限を絞った環境でFable 5.2を動かすなら、権限の設定に加えて、CLAUDE.mdかシステムプロンプトにその環境の説明を入れておきましょう。
なお、この記事の下書きと入稿の作業にも、Claude Code上のFable 5.2を使っています。システムカード264ページの読み込みを含む調査を、サブエージェントに分けて並行で進める形でした。
まとめ
だいぶ長文でのご紹介となりました
冒頭でもかきましたが、本モデルリリースについて、一言でいうと
「Fable 5.2は、Fable 5.1より20%安く、最大30%速くなり、独立評価の総合指数で上位3つを占めた。APIでは、会話の履歴を書き換えない作りが全アカウントの前提になった」
これが今回のリリースの中身です。
実務で押さえるのは次の5つです。
- 単価は入力・出力・キャッシュ読み取りがそろって20%引き。Batch APIなら$4(約632円)/$20(約3,160円)で、標準のOpus 5.5と同じ単価になる
- APIの既定はhigh、Claude Codeの既定はmedium。本気を出さないhighでOpus 5.5の本気に並び、難しくて長い仕事では大きく引き離す
- 履歴の書き換えチェックは全アカウントに適用。自前で履歴を組むアプリは、切り替える前に
drop_blockで洗い出す - Opus 5.5からFable 5.2へ上げる方向は思考を引き継ぐ。Fable 5.2から下げる方向は引き継がない
- Claude Codeはv2.1.321以上で
/model fable。Fast modeはFable 5.2の上で/fastを実行する
使い分けを表にします。
| 用途 | おすすめ | 理由 |
|---|---|---|
| 分類・抽出・大量処理 | Claude Haiku 5.5 | $0.10(約16円)/$0.50(約79円)から。速い |
| 日常のコーディング・軽い修正 | Claude Sonnet 5.5 | $2(約316円)/$10(約1,580円)。速度と知能のバランス |
| 大きめの実装・コードレビュー・資料づくりなどの知識労働 | Claude Opus 5.5 | 公式が勧める日常の主力。AA-BriefcaseとGDPval-AAで上位 |
| 原因の分からない不具合・設計の判断・長時間のエージェント作業 | Claude Fable 5.2(highから) | 独立評価の総合指数で最上位。highでOpus 5.5のmaxを上回る |
| 急がない大量の難問 | Claude Fable 5.2のBatch API | $4(約632円)/$20(約3,160円)で、標準のOpus 5.5と同じ単価 |
| 難所だけ相談させる構成 | executorはOpusやSonnet、advisorにFable 5.2 | 全部をFableで回さずに要所だけ使える |
他の性能スコア等は、当ブログの「日本語対応 LLMランキング2026」の次の版で取り上げる予定です!
それでは、また次回、お会いしましょう!