AIエージェント
ゼロから作るコーディングエージェント【第6回】評価をどう作るか。動くものを作らせて自動採点し、採点器そのものを疑う
採点器の「テスト」10点が3日間ずっと0/0でした。点数の表を見ているだけでは気づけません。仕様書を渡してWebシステムを作らせ、起動して叩いて採点する評価装置の作り方、5種類×3本の合否基準、対照実験を先にやる理由、自作でない課題で「テストだけが決めている契約」を先に洗う話を、測った数字で書きます。
AIエージェント
採点器の「テスト」10点が3日間ずっと0/0でした。点数の表を見ているだけでは気づけません。仕様書を渡してWebシステムを作らせ、起動して叩いて採点する評価装置の作り方、5種類×3本の合否基準、対照実験を先にやる理由、自作でない課題で「テストだけが決めている契約」を先に洗う話を、測った数字で書きます。
IT & AIテクノロジー
こんにちは、今回はシリーズ第7回セキュリティとベストプラクティス - 本番環境での考慮事項 について解説いたします! 連載の構成 * 第1章:基本概念の理解 - Active DirectoryとKerberos/NTLM認証の基礎 * 第2章:ドメイン環境の構築 - 検証環境の構築手順 * 第3章:クライアントとサーバーのドメイン参加 - ドメイン参加の詳細手順 * 第4章:プロキシサーバーと統合Windows認証 * 第5章:ブラウザ設定と認証 - 各ブラウザでの設定方法 * 第6章:トラブルシューティング - よくある問題と解決方法 * 【★今回です★】第7章:セキュリティとベストプラクティス - 本番環境での考慮事項 * 第8章:実践的な構成例 - AIセキュリティツールとの統合事例 第7章:セキュリティとベストプラクティス 第 7 回は、ここまでの回で作った認証基盤を「本番で運用できる状態」にするための話です。 前半の 7.1
AIエージェント
RTX A5000(24GB)1枚で始めて、ローカルモデル7種類が全滅。RTX A4000(16GB)2枚にQwen3.6-35B-A3BをAWQ 4bitで載せ、fp8のKVキャッシュと98kの文脈で、認証つきWebシステムを3本連続93.8〜96.5点で作らせるまでの構成と落とし穴。モデルの癖、量子化の劣化、文脈長、壊れたツール呼び出しの直し方を、測った数字で書きます。
AIエージェント
評価ランで鍛えた「止まらない」規律を、人が答えられる場面にまで効かせていました。曖昧な指示に聞き返したモデルを押し戻して勝手に作らせる、断られた確認を形を変えて7回聞き直す、他人のプロセスの止め方を教える。6種類の使い方を演じて出た19件から、人がいる場面の設計と、設定の不備を1行で止める話を書きます。
AIエージェント
300ターン走ってAPIが0本。「モデルの限界」と結論を書いた翌日、記録を読み直すと234ターンがツールを1度も呼んでいませんでした。空転率という指標、1つ塞ぐと次の形に移る空転、思考をオフにすると95点が71点に落ちて時間も縮まなかった話、出力枠を広げたら反対側を数える話を書きます。
AIエージェント
モデルの「完了しました」は5つの形ですり抜けました。構文検査だけ、テストは通るが動かない、待ち受けは立つが最初の要求で落ちる、起動するが仕様のAPIが無い、assertの無いテスト。完了の門を3段で閉じる設計と、押し戻しに「落ちた行と調べ方」を書いて「答え」を書かない理由を、数字つきで書きます。
AIエージェント
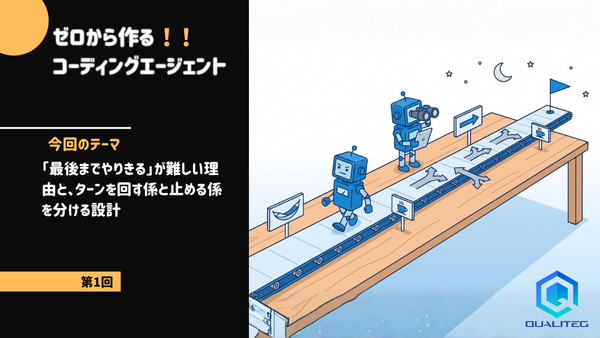
コーディングエージェントを自作すると、いちばん難しいのはループを回すことではなく「いつ止めるか」を決めることでした。あるランでは、300ターン中234ターンでツールが1度も呼ばれていませんでした。この数字を出発点に、ターンを回す係と止めてよいか決める係を分け、押し戻しの送り方を直すまでを書きます。
GPU
こんにちは! 新しい GPU を手に入れてワクワクしながら既存の推論環境を載せ替えたら、 昨日まで普通に動いていたものが軒並みエラーで止まった そんな経験はないでしょうか。NVIDIA RTX 50 系、NVIDIA RTX PRO 系(Blackwell 世代)への移行では、これがかなりの高確率で起きます。 そして厄介なことに、エラーで止まってくれるのは、まだ親切なほうで、、TensorRT の世界には 「ビルドは通る、実行も通る、速度もちゃんと出る、けれど出力だけが静かに壊れている」 という、いちばん見つけにくい失敗の仕方が存在します。 本記事はその全体像を扱うシリーズの前編です。 回テーマ 前編(Part 1)RTX 50 で推論資産が動かない — 基本と最初の壁(本記事) 中編(Part 2)ビルドが通っても正しいとは限らない — 沈黙劣化 5 連発 後編(Part 3)5D
生成AI最前線
こんにちは! 前回の記事では、Anthropicが2026年6月9日に発表したClaude Fable 5とClaude Mythos 5について取り上げました。 Mythos級の強力な能力にセーフガードを加え、一般ユーザーにも提供できる形へと降ろしたFable 5。 私たちはそれを、「神話が寓話になって降りてきた」と表現しました。 しかし、その寓話は、わずか3日で公開の場から姿を消すことになります。 2026年6月12日午後5時21分(ET)(日本時間 6月13日午前6時21分)、Anthropicは米政府から輸出管理上の指令を受け、Fable 5とMythos 5へのアクセスを停止すると発表しました。 指令の対象とされたのは、米国外の利用者だけではありません。 Anthropicの説明によれば、米国内にいる外国籍者や、同社で働く外国籍の従業員も含まれます。 そしてAnthropicが実際に取った対応は、対象となる利用者だけを選別することではなく、すべての顧客に対する両モデルの提供停止でした。 今回の出来事は、Fable 5のセーフガードが十分だったのかという技術論
AI数理
こんにちは。Qualiteg研究部です。 私たちは、個人情報(PII)や機密情報、要配慮個人情報を含むセンシティブな情報を検出・マスキングする技術(https://pii-fi.com)の開発に取り組んでいます。 その中で日々向き合っているのが、 「精度の数字を、どうすれば正直に、正しく語れるのか」 という問題です。 たとえば、検出器の Recall(再現率)が 0.95 だったとします。 これは高い数字に見えます。しかし、その数字はどの種類の文書で測ったものなのか。正解データはどう作ったのか。サンプル数は十分なのか。別の業務文書にも同じ数字を当てはめてよいのか。 精度の数字は、単独ではほとんど意味を持ちません。 「何を、どの条件で、どう数えたか」とセットになって、はじめて実務で使える数字になります。 本記事では、私たちが PII 検出の精度評価に取り組む中で得た、精度を誠実に語るための考え方を紹介します。アルゴリズムの中身ではなく、評価のしかたに焦点を当てます。 1. はじめに:「Recall 0.95
日々の開発Tips
こんにちは!Qualitegプロダクト開発部です! PyCharmの内蔵npmツールで npm start を実行した瞬間、何のエラーメッセージもなくIDEが消える。 再起動してもう一度試すとまた落ちる。ログを見ても手がかりがない——。 今回はこの「サイレントクラッシュ」に遭遇し、原因の絞り込みから回避策の確立まで至った過程を書き残しておきます。同じ現象で困っている方の参考になれば幸いです。 環境 項目 内容 OS Windows 10/11 PyCharm 2026.1(2023.1.6時代から連綿とUpdateをした状態) Python 3.11.4(venv使用) Node.js v25.2.1 プロジェクト Python + Node.js 混合構成 上記のとおり、PyCharmは執筆時点の最新版(2026.1)となります。 確認できたこと・推測していること まず最初に、
LLM セキュリティ
こんにちは! 第5回では、ブラウザーに届く認証設定と、その確認方法を整理しました。今回は、認証やドメイン参加がうまくいかないときの調べ方です。 「共有が遅い」「名前は引けるのに参加できない」という症状から、原因を一つに決めることはできません。変更前の状態を残し、名前・時刻・サービスの鍵・権限・通信を順に切り分けます。 対象は主にWindowsクライアントとAD DSです。漫画は理解のための架空の会話です。コマンドは説明用の名前を使った診断例であり、本記事のために実AD環境で実行した結果ではありません。実行には端末やADの参照権限が必要で、一部は管理者として開いたシェルを使います。 連載の構成 * 第1章:基本概念の理解 - Active DirectoryとKerberos/NTLM認証の基礎 * 第2章:ドメイン環境の構築 - 検証環境の構築手順 * 第3章:クライアントとサーバーのドメイン参加 - ドメイン参加の詳細手順 * 第4章:プロキシサーバーと統合Windows認証 * 第5章:ブラウザ設定と認証 - 各ブラウザでの設定方法 * 【★今回です★】第6章
LLM セキュリティ
こんにちは!Qualiteg研究部です! 個人情報(PII: Personally Identifiable Information)の自動検出は、テキスト中から特定の表現を抽出し、それがどの種類のPIIに当たるかを判定する問題として捉えることができます。 電話番号、人名、口座番号、金額表現など、検出対象のPIIタイプが増えるにつれて、単一の手法ではカバーしきれなくなり、性質の異なる複数の認識器(Recognizer)を組み合わせるマルチレイヤー構成が採用されるのが一般的です。 本稿で想定しているのは、ユーザーが海外製LLMにチャットを送信する直前に、その内容に個人情報や機密情報が含まれていないかをリアルタイムに検査するユースケースです。 この場面では、検出精度だけでなく、送信体験を損ねない速度が不可欠です。 高精度なLLMやBERT系モデル、NERベースの手法は有力ですが、送信前チェックの第一層として常時適用するには、レイテンシやコストの面で不利になることがあります。 そのため、本システムでは、正規表現、辞書、軽量なルールベース認識器を組み合わせた超高速な第一層を設け、そ
IT & AIテクノロジー
こんにちは! 第4回では、プロキシの認証とアクセス制御を整理しました。今回は、ブラウザー側で何を確認し、どう設定を配るかを見ていきます。 同じページでも、ブラウザーや接続方法によって認証画面が出ることがあります。ここで許可先や認証方式を広げる前に、誰が認証を求めているのかを確かめます。 主にWindows上の管理対象Chrome・Edge・Firefoxと、明示的なフォワードプロキシを扱います。漫画は理解のための架空の会話です。設定例は説明用で、実環境へのポリシー配布や認証試験を実施した記録ではありません。 連載の構成 * 第1章:基本概念の理解 - Active DirectoryとKerberos/NTLM認証の基礎 * 第2章:ドメイン環境の構築 - 検証環境の構築手順 * 第3章:クライアントとサーバーのドメイン参加 - ドメイン参加の詳細手順 * 第4章:プロキシサーバーと統合Windows認証 * 【★今回です★】第5章:ブラウザ設定と認証 - 各ブラウザでの設定方法 * 第6章:トラブルシューティング - よくある問題と解決方法 * 第7章:セキュ
IT & AIテクノロジー
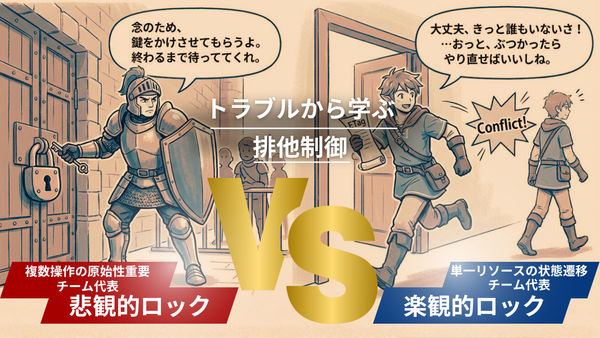
こんにちは! Qualitegプロダクト開発部です! 「楽観的ロックを実装したのに、まだ競合エラーが出るんですけど...」 これは私たちが実際に経験したことです。 本記事では、楽観的ロックと悲観的ロックの違いを、実際に発生したトラブルを通じて解説します。 抽象的な説明ではなく、 「なぜそれが必要なのか」「どんな問題を解決できるのか」 を実感できる内容を目指します。 目次 1. 問題の背景:並列処理で謎のエラー 2. ロックなしの世界:なぜ競合が起きるのか 3. 楽観的ロックの導入:期待と現実 4. 楽観的ロックの限界:解決できなかった問題 5. 悲観的ロックによる解決 6. 実装時のハマりポイント 7. どちらを選ぶべきか:判断基準 8. まとめ 1. 問題の背景:並列処理で謎のエラー 1.1 システムの概要 私たちが開発していたのは、 複数のワークスペースを切り替えて使用するAPIサーバー でした。 当社AI関係のプロダクトの一部だったのですが、結合テスト兼負荷テストを実行すると、まれに発生してしまっていました。 ユーザーは複数のワーキン
LLM セキュリティ
こんにちは! ChatGPTやClaudeといった生成AIサービスが業務に浸透し始めた今、 「AIに機密情報を送ってしまうリスク」 が新たなセキュリティ課題として浮上しています。 この課題に向き合う中で、私たちは改めて「企業のセキュリティアーキテクチャはどう変遷してきたのか」を振り返る機会がありました。 すると、ある疑問が浮かんできます。 「なんでこんなに複雑になってるんだっけ?」 企業のセキュリティ担当者なら、一度は思ったことがあるのではないでしょうか。 アルファベット3〜4文字の製品が乱立し、それぞれが微妙に重複した機能を持ち、設定は複雑化し、コストは膨らみ続けています。 当社ではAIセキュリティ関連プロダクトをご提供しておりますが、AI時代のセキュリティを考える上でも、この歴史を理解することは重要ではないかと考えました。 本記事では、企業ネットワークセキュリティの変遷を振り返りながら、「なぜこうなったのか」を整理してみたいと思います。 第1章:観測点を集約できた時代 ― オンプレAD + Proxy(〜2010年代前半) 統制しやすかったモデル かつ