ゼロから作るコーディングエージェント【第5回】ローカルLLMを一級市民にする。16GBのGPU2枚でWebシステムを自走で作らせるまで
RTX A5000(24GB)1枚で始めて、ローカルモデル7種類が全滅。RTX A4000(16GB)2枚にQwen3.6-35B-A3BをAWQ 4bitで載せ、fp8のKVキャッシュと98kの文脈で、認証つきWebシステムを3本連続93.8〜96.5点で作らせるまでの構成と落とし穴。モデルの癖、量子化の劣化、文脈長、壊れたツール呼び出しの直し方を、測った数字で書きます。
こんにちは!
この連載の実験は、すべて手元のGPUで動くローカルLLMでやっています。
最初に用意したのはRTX A5000(24GB)のカード1枚でした。
そこに載るモデルを7種類試して、認証つきのタスク管理Webを作らせた結果は、7種類すべて失格でした。
起動しないものを書き続ける。禁止した外部パッケージを入れる。データベースのAPIを毎回間違える。出力が同じ単語の繰り返しに崩れる。
結論から言うと、いま弊社の手元で「Webシステムをゼロから自走で作れる」ローカル構成は1つ確定しています。
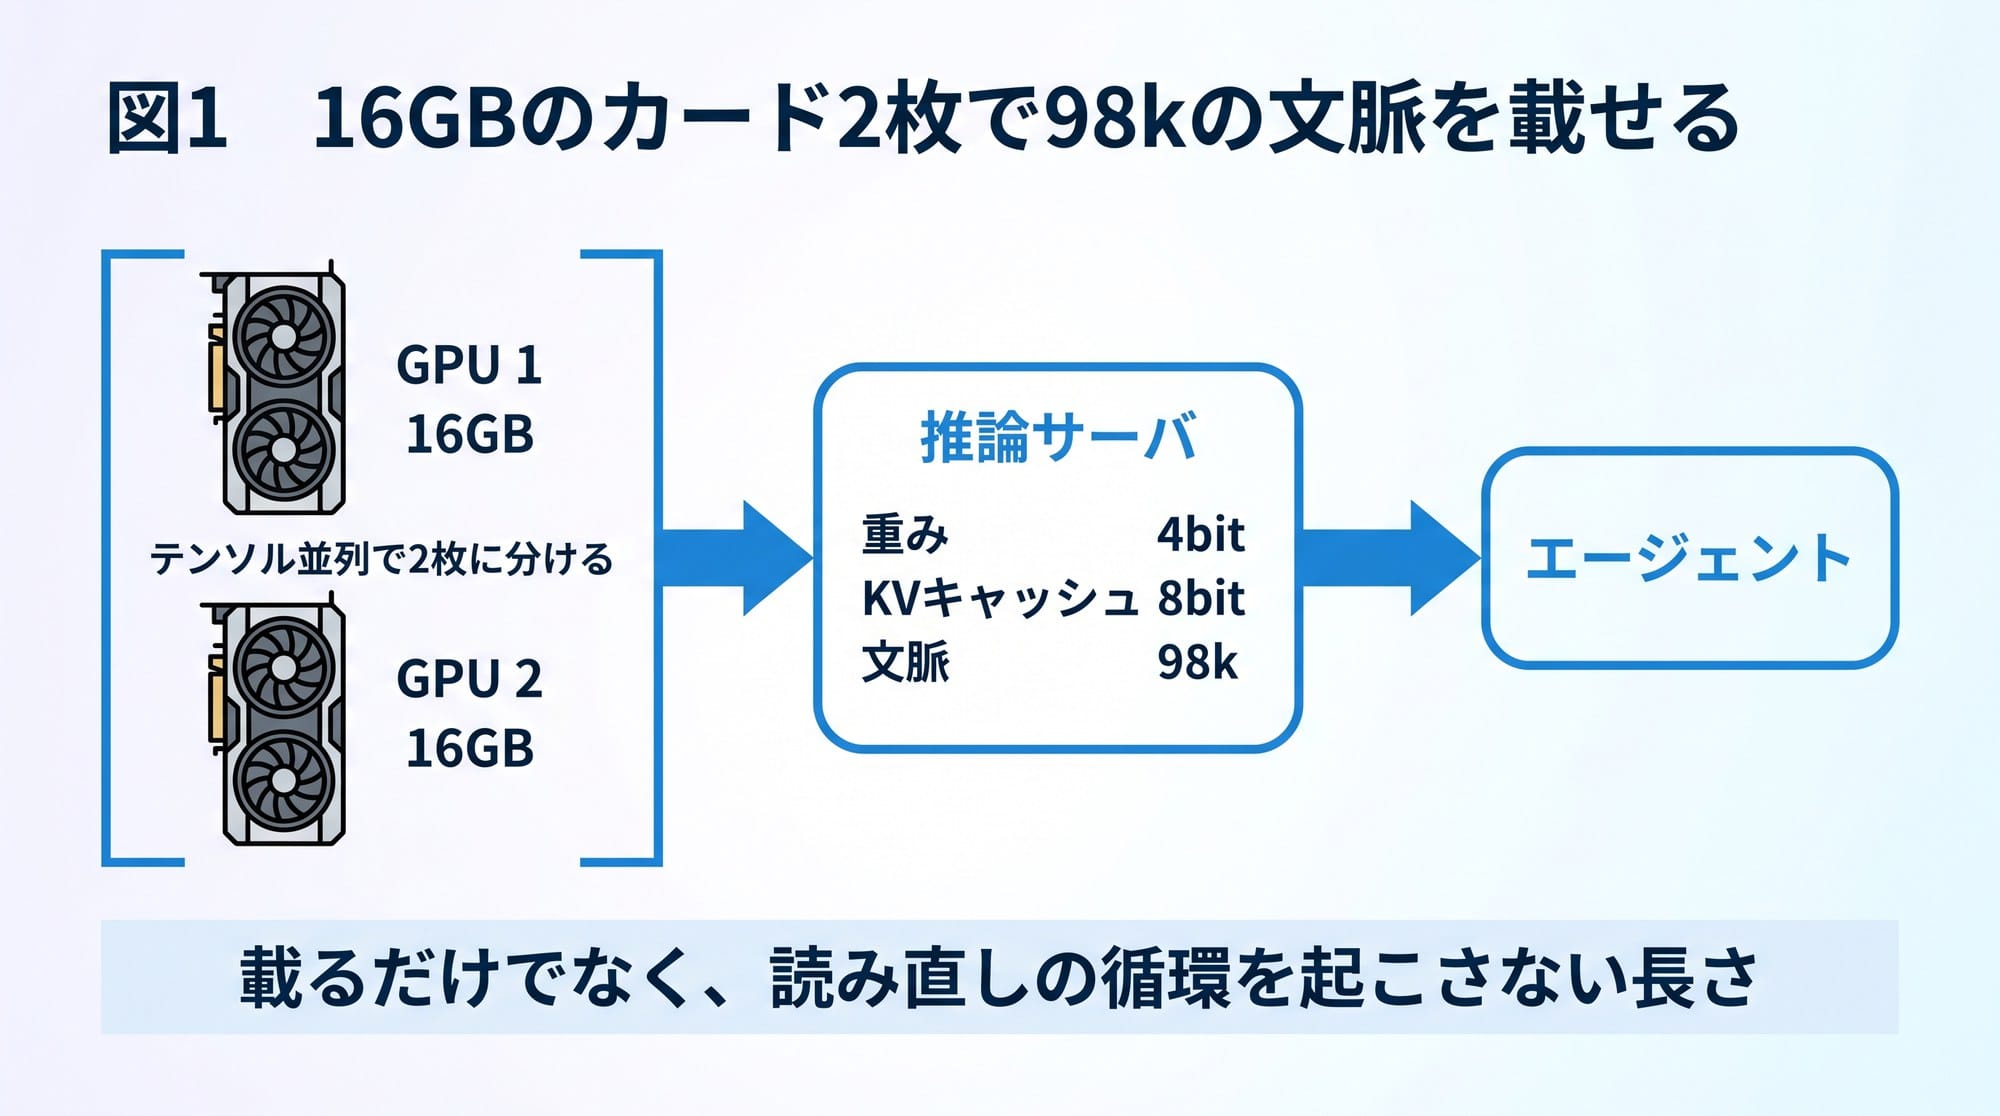
RTX A4000(16GB)のカード2枚にQwen3.6-35B-A3B(MoE、活性3B)をAWQ 4bitで載せ、KVキャッシュを8bitにして98kの文脈を確保する構成です。
同じ課題を3本走らせて94.9、93.8、96.5点。ただし、この構成が確定した時点で、ハーネス側の欠陥を64件直していました。モデルを変えるだけでは届きませんでした。
この記事は連載「ゼロから作るコーディングエージェント」の第5回です。今回はローカルLLMの話に絞って、モデルの癖、GPUメモリ、文脈長、壊れたツール呼び出しの直し方を、測った数字で書きます。
なぜ、小さなモデルと小さなGPUなのか
先に、なぜこの組み合わせなのかを書きます。弊社がこのエージェントで狙っているのは、手元の1台で、Webシステムを最後まで作りきるコーディングエージェントです。大きなクラウドモデルで動くものを作るだけなら、第1回から第4回の話で足ります。この回で扱うのは、その上で「小さなモデルと小さなGPUでも、同じことがちゃんとできる」ようにする、という課題です。
理由は3つあります。
1つ目は、コードを外に出せない現場があることです。顧客のソースコードや、契約で社外に送れないデータを扱う開発では、クラウドのAPIにそのまま渡せません。社内のワークステーションで完結するエージェントなら、この問題がそもそも起きません。
2つ目は、費用の形です。自走するエージェントは、1つの課題で40〜144ターン回り、そのたびに長くなった履歴を丸ごと入力に載せます。あたりまえっちゃ、あたりまえですが、従量課金のAPIでは、この繰り返しがそのまま料金に積み上がります。手元のGPUなら、機材は買った時点の固定費で、走らせるたびの料金はありません。しかも小型GPUなので個人でも手が届きやすいです。
3つ目は、小さいモデルで動かすとハーネスの弱点が全部見えることです。賢いモデルは、ハーネスの穴を自分の判断で埋めてしまうので、欠陥が隠れます。小さなモデルは埋めてくれません。この回で出てくる「ハーネスの欠陥を64件直した」の多くは、小さなモデルが落ちたことで見つかったものです。小さなモデルで見つけた欠陥の直しは、大きなモデルを載せるときにも無駄になりません。完了の判定、空転の検出、ツール呼び出しの検証は、モデルの賢さとは別に要る仕組みだからです。
機材を「16GBのカード2枚」に置いたのも同じ理由です。データセンター用のGPUではなく、机の下のワークステーションに挿せるカードの範囲で、何ができて何ができないかを確かめたい。
RTX A4000は1スロットで、電源も冷却も普通のPCで足りるカードです。その2枚で、認証つきのWebシステムを人が見ていなくても作りきれる構成を、この回では1つ出します。
1. 「一級市民」とは、中核が接続先の語彙を知らないことです
まず設計の話を1つだけ。
ローカルLLMを載せるとき、いちばん最初に決めたのは、エージェントの中核が特定の接続先の語彙を知らないことでした。中核が扱うのは「本文」「ツール呼び出し」「ツールの結果」の3種類の正規化されたブロックだけ。クラウドのAPIも、ローカルの推論サーバも、それぞれのアダプタが自分のワイヤーフォーマットへ双方向に変換します。
(擬似コード)中核とアダプタの境界
core  ──▶ ModelClient(抽象)
             ├─ クラウドA用アダプタ
             ├─ OpenAI互換API用アダプタ   ← ローカルの推論サーバはここ
             ├─ クラウドB用アダプタ
             └─ テスト用の偽アダプタ(ネットワーク不要)
新しい接続先を足すときは、アダプタを1クラス追加するだけ。中核とツールは1行も変えない。変えたくなったら、抽象が漏れています。
なぜこれを最初に決めたか。ローカルモデルは、クラウドのモデルより「壊れた応答」を返すことが多いからです。JSONが途中で切れる。思考が本文に混ざる。ツール呼び出しの引数の順番が違う。こういった癖への対処をアダプタに閉じ込めておかないと、中核が特定のモデルの癖で汚れていきます。
2. 試したローカルモデルと、1つの対照
同じ課題(認証つきタスク管理Web、API12本、SQLite、画面、テスト)で走らせた結果です。最初にRTX A5000(24GB)1枚で試した7種類は、すべて失格でした。表に載せた35B-A3B以外の6種類と、表に無い旧世代のQwen3-30B-A3B(禁止した外部パッケージを入れる癖が直りませんでした)です。そのうち27B、Coder版、Gemma 4はRTX A4000×2でも走らせ直し、本命の35B-A3Bは16GB×2で初めて試したモデルです。表には両方の構成の結果を載せています。
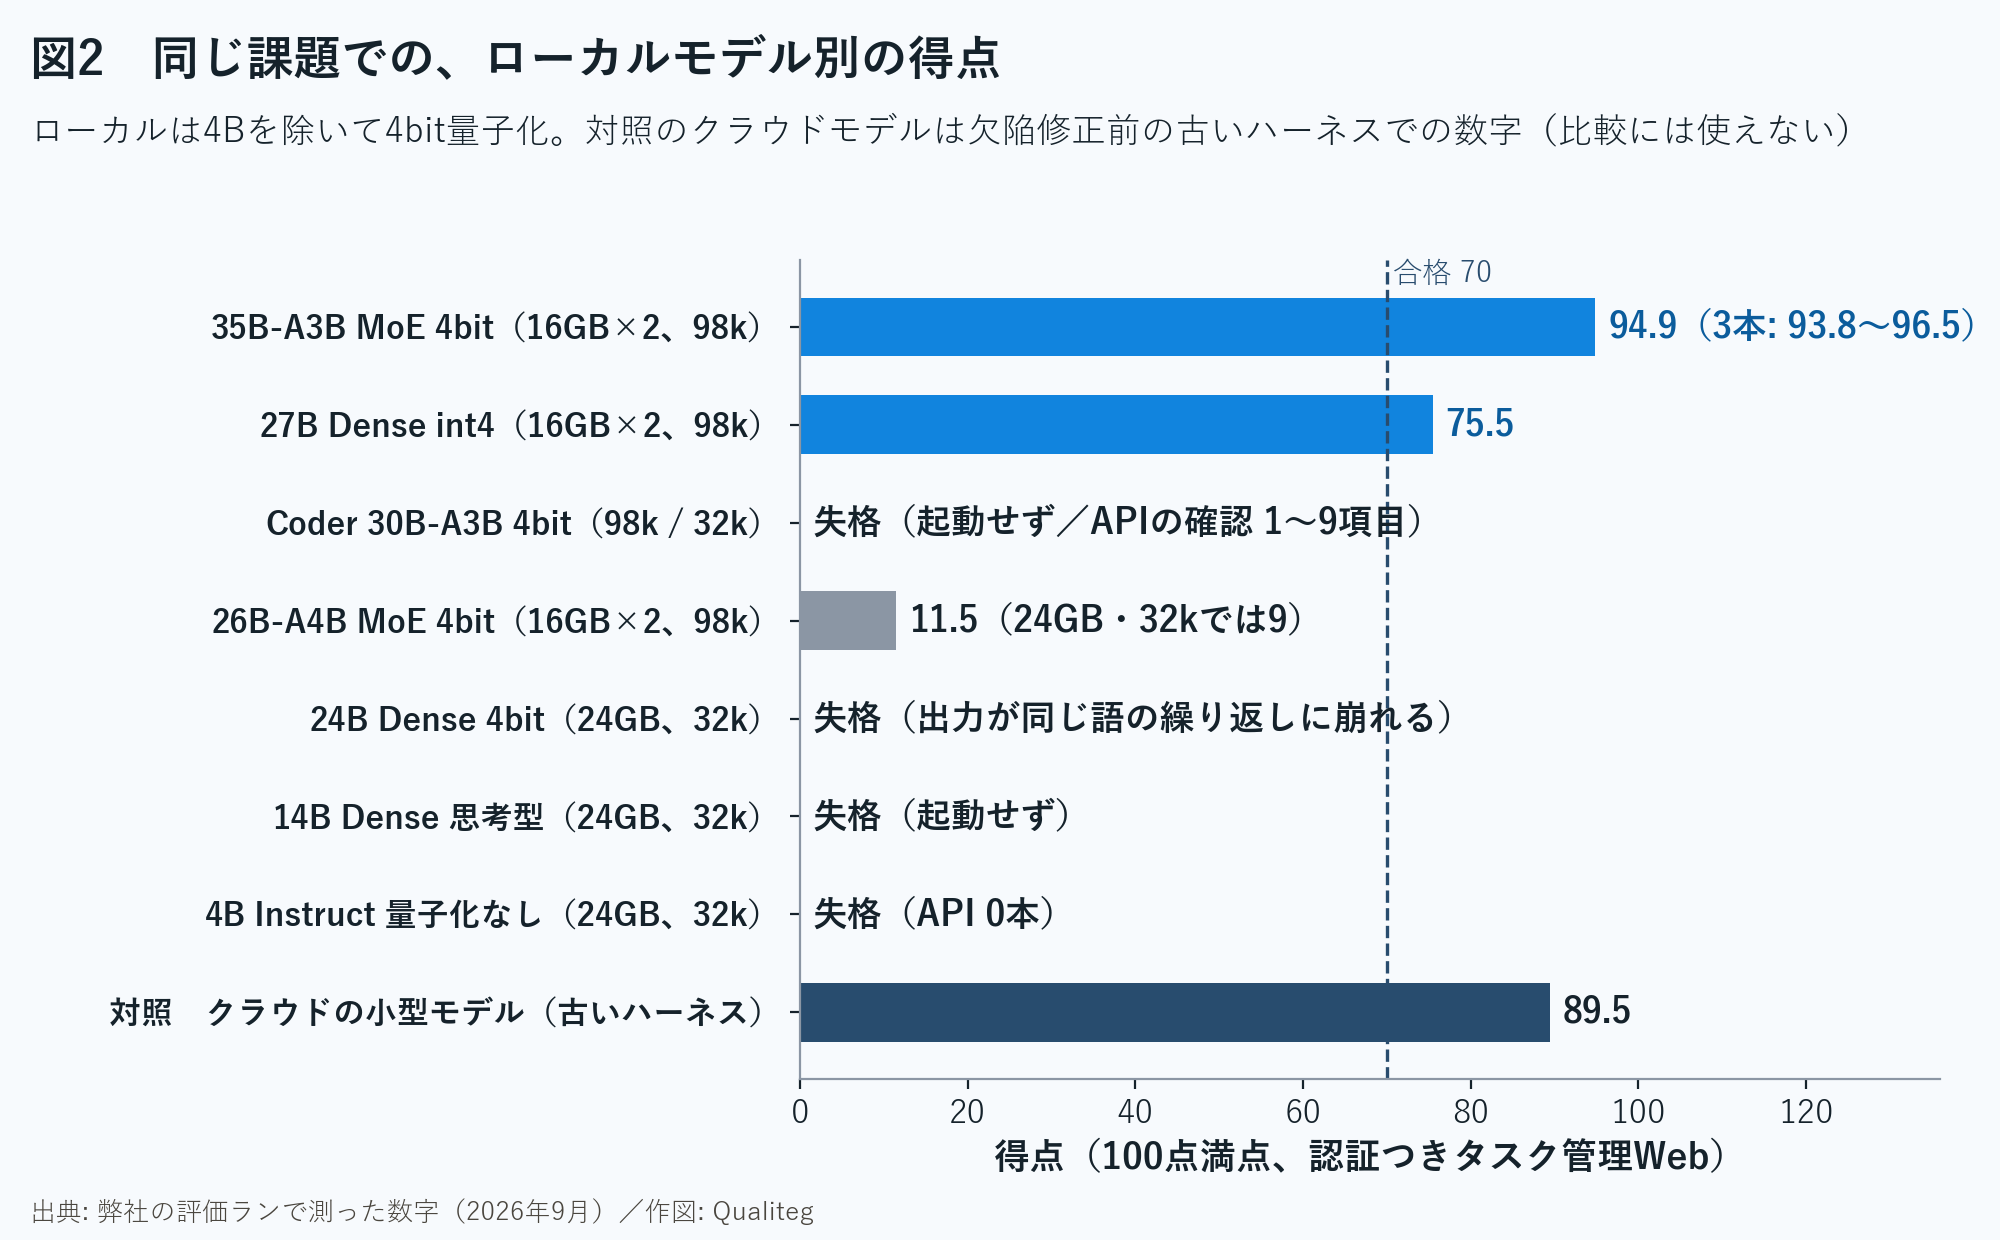
| モデル | 量子化/形 | GPU | 文脈 | 得点 | 1ターン | 一言 |
|---|---|---|---|---|---|---|
| Qwen3.6-35B-A3B | AWQ 4bit/MoE | 16GB×2 | 98k | 94.9 / 93.8 / 96.5 | 25〜36秒 | 本命。仕様の細部まで読む |
| Qwen3.6-27B | int4/Dense | 16GB×2 | 98k | 75.5 | 54秒 | 合格するが遅い |
| Qwen3-Coder-30B-A3B | AWQ 4bit/MoE | 16GB×2、24GB | 98k、32k | 失格×9 | 14〜24秒 | 速いが、DBのAPIを毎回間違える |
| Gemma 4 26B-A4B | AWQ 4bit/MoE | 24GB、16GB×2 | 32k、98k | 9 / 11.5 | 不定 | 起動しないものを書き続ける |
| Devstral-Small-2 24B | AWQ 4bit/Dense | 24GB | 32k | 失格 | 不定 | 出力が同じ語の繰り返しに崩れる |
| Qwen3-14B | AWQ/Dense(思考型) | 24GB | 32k | 失格 | 不定 | 思考が履歴の93%を占めた |
| Qwen3-4B-Instruct | 無し | 24GB | 32k | 失格 | 不定 | 起動と画面はできる。APIは0 |
| 対照 クラウドの小型有料モデル | API | 無し | API側 | 89.5 | 未計測 | 33ターンで完了。欠陥修正前の古いハーネス |
対照のクラウドモデルについて1つ注意があります。この89.5点は、ハーネスの欠陥を16件直した段階の古いハーネスでの数字です。同じ古いハーネスでローカル勢は、APIの配点35点のうち最高でも6.4点で全滅していました。ローカルの35Bの3本(94.9 / 93.8 / 96.5)は、欠陥を64件まで直した段階のハーネスでの数字です。その後も直し続けて累計105件になった最新のハーネスでは、同じ課題で98.3点でした。版が違うので、モデルの優劣の比較にはなりません。読み取れるのは「賢いモデルを載せるだけでは届かない」ことのほうです。
2-1. 本命の35B-A3Bは、仕様書を読みます
他のモデルが落とす status の既定値やクエリの並び順まで実装します。3本目は、APIの確認22項目がすべて通りました。
ただし弱点もあります。同じTODOを11ターン保存し直す。27KBを1回で書こうとして切られる。READMEを書き忘れる。ターン数は40〜144とばらつきますが、得点は平均から±1.5以内に収まります(第3回)。
2-2. Coder版は「速いが知らない」
Coder版は1.5〜2倍速い(14〜24秒/ターン)のですが、Node.js標準のSQLiteモジュールのAPIを9本すべてで間違え(open という関数は無く、正しくは DatabaseSync クラス)、動くものになりませんでした。知識の欠落はハーネスでは埋まりません。
ただし、課題の形を変えると別の顔が出ます。既存コードの不具合修正なら12ターン、35秒で92.5点。既存コードへの機能追加は20ターン、70秒で96.7点。CLIのゼロ構築は70点。背景処理つきサーバは24.3点(ワーカーが一度も動かないまま完了報告)。
課題の形で4段階に分かれる(Web 0/背景処理 24/CLI 70/修正と機能追加 92〜97)。1つの課題の点数で「使える」「使えない」を言うのは危険で、弱いモデルでも「構造が既にある仕事」なら実用になります。この話は第6回で「課題の種類を増やす」として書きます。
2-3. 量子化の劣化は「モデルが悪い」に見えます
Devstralの4bit版は「Let me create files are files as files are files...」と同じ語の繰り返しに崩れました。空転33%という数字だけ見ると能力不足に見えますが、原因は量子化と長い出力の相性です。同じモデルの別の量子化では24GBで重みだけで枠を使い切り、起動できませんでした。
第3回で書いたとおり、空転が30%を超えるランの低得点を、モデルの能力のせいにしてはいけません。量子化の版を変えるだけで結果が変わることがあります。
3. 16GB×2で98kの文脈を載せる
本命の構成です(冒頭の図1)。
モデルはcyankiwiのAWQ 4bit版です。Qwen公式の量子化版はBF16とFP8だけで4bitは無く、16GB×2に載せるにはサードパーティの量子化版を使うことになります。cyankiwiはQwenやGemmaのAWQ版を継続して公開している量子化の専門アカウントで、NVIDIAのJetson AI Labの手順でも同じモデルが使われています。重みはsafetensors形式で配られていて、読み込みに独自のPythonコードは要りません。
# 推論サーバ(vLLM 0.28)の起動。16GB × 2、WSL2 上の Ubuntu
export NCCL_P2P_DISABLE=1 NCCL_SHM_DISABLE=1 NCCL_CUMEM_ENABLE=0 NCCL_IB_DISABLE=1
vllm serve cyankiwi/Qwen3.6-35B-A3B-AWQ-4bit \
  --tensor-parallel-size 2 --kv-cache-dtype fp8 \
  --max-model-len 98304 --gpu-memory-utilization 0.92 \
  --max-num-batched-tokens 2048 --max-num-seqs 4 \
  --compilation-config '{"cudagraph_capture_sizes":[1,2,4]}' \
  --reasoning-parser qwen3 --tool-call-parser qwen3_coder --enable-auto-tool-choice
重みを4bitにして2枚に分け(テンソル並列)、KVキャッシュを8bitにして、文脈を98,304トークン確保しています。ここまでに踏んだ落とし穴を表にします。
| 落とし穴 | 何が起きるか | 対処 |
|---|---|---|
--enforce-eager(CUDAグラフを切る) | 6.8トークン/秒、63秒/ターン。実用外 | CUDAグラフを絞って有効化。同時実行4、捕捉サイズ1/2/4。グラフ用メモリ0.51GiBで収まり30〜39トークン/秒 |
| メモリ利用率 0.95 | 起動できない(空き14.77/16GiB) | 0.92 |
| 0.92 と既定のCUDAグラフ | 「KV用メモリ無し」 | 上の絞り込み |
| 文脈長 131072 | KVに3.0GiB必要で載らない | 98304(KV 2.42GiB) |
| PyPI既定のホイール(cu130) | 手元のドライバ(CUDA 12.8)で "driver too old" | cu129版のホイールを指定 |
| WSL2でテンソル並列 | NCCLが止まる | NCCL_P2P_DISABLE=1 NCCL_SHM_DISABLE=1 NCCL_CUMEM_ENABLE=0 NCCL_IB_DISABLE=1 |
| TritonのJIT | ヘッダが無い | python3-dev |
| 背景で起こす | nohup がWSLのセッション終了で止まる | Windows側からプロセスを作って前景を保持 |
いちばん効いたのは1行目です。メモリが足りなくてCUDAグラフを切ると、速度が5分の1になります。切るのではなく、同時実行数と捕捉サイズを絞って有効にしたまま載せる。この違いで、1ターンが63秒から30秒前後になりました。
WSL2でのNCCLの問題は、以前に別の記事で詳しく書いています(関連記事を参照)。
4. 文脈長は「載る」だけでなく「循環を起こさない」ために効きます
同じ27Bのモデルを、24GB1枚で16kの文脈と、16GB×2で98kの文脈で走らせました。
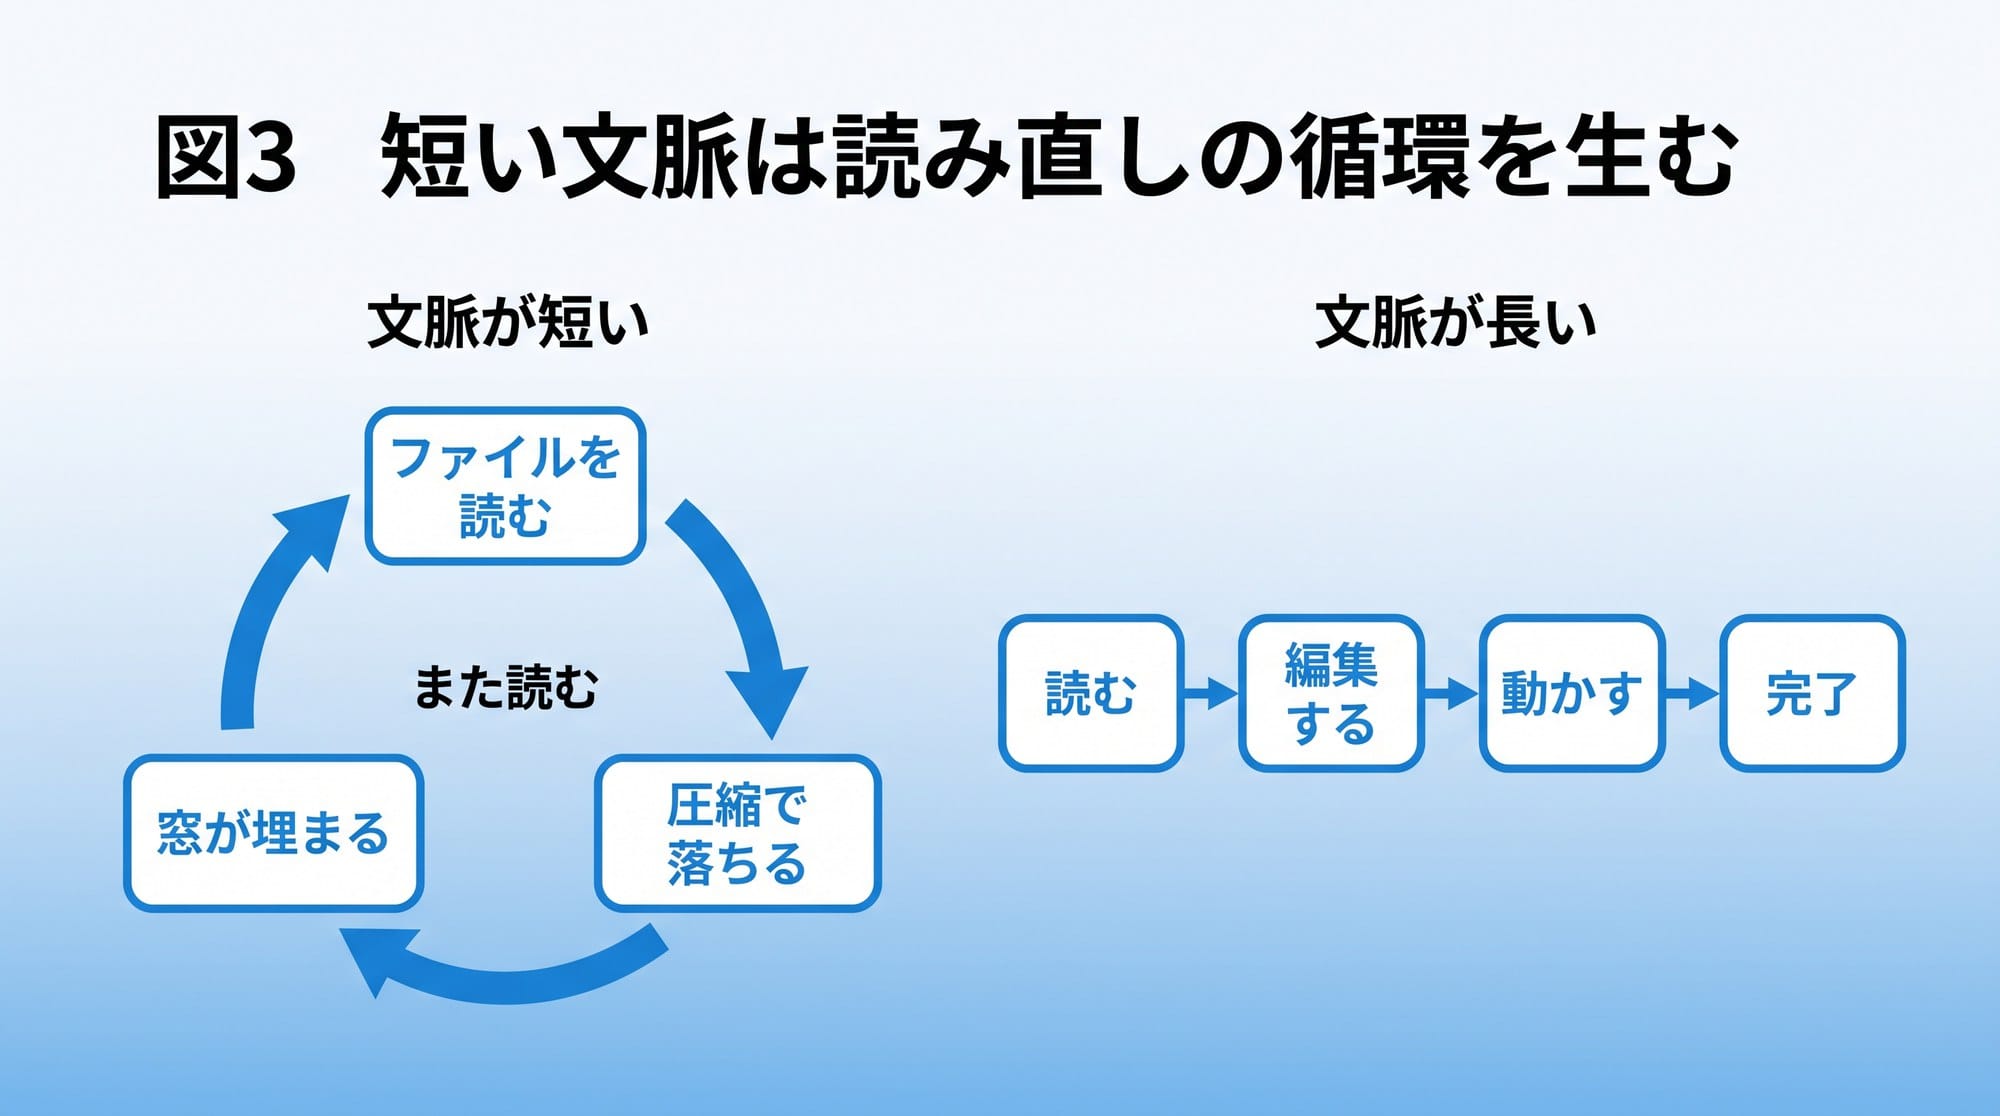
16kでは、4つのファイルを48回ずつ読み直す圧縮の循環に入って打ち切り。98kでは75.5点で合格しました。
仕組みは第3回で書いたとおりです。読んだ結果が窓に溜まり、圧縮で落ち、落ちたのでまた読む。32kの24GB単機では300ターンで圧縮が6〜54回、98kでは0〜5回でした。文脈長は「モデルが載る」だけの話ではなく、読み直しの循環を起こさない長さかどうかの話です。
もう1つ、地味な落とし穴を書きます。推論サーバが98,304で待ち受けているのに、ハーネス側がモデルのカタログにある32,768を使っていました。3分の1で圧縮が始まります。文脈長はカタログではなく、サーバの /v1/models が返す max_model_len を見て、起動時に差し替えるようにしました。出力枠も窓に合わせて広げます。
5. 思考モデルの落とし穴。比較の前に、同じ扱いか確かめる
思考(reasoning)を出す型のモデルを載せたときの話です。
推論サーバは、--reasoning-parser を指定したときだけ、思考を本文とは別の欄に分離して返します。指定が無いと <think> タグが本文に混ざって届きます。最初の版はそれを知らず、思考が履歴の93%を占めていました。モデルの応答のほとんどが思考で、それが全部履歴に積まれ、次のターンの入力になっていたわけです。
サーバの設定に依存しないよう、ハーネス側で本文から <think> を剥がす層を入れました。
ここで大事なのは、比較する前に、比較する両者が同じ扱いを受けているか確かめることです。この件では、思考モデルだけが不利になっていました。「14Bは弱い」という結論は、ハーネスの欠陥が作った結論でした。
6. 壊れたツール呼び出しは、引数の形では判定できません
ローカルモデルとクラウドモデルで、いちばん扱いが違ったのがここです。
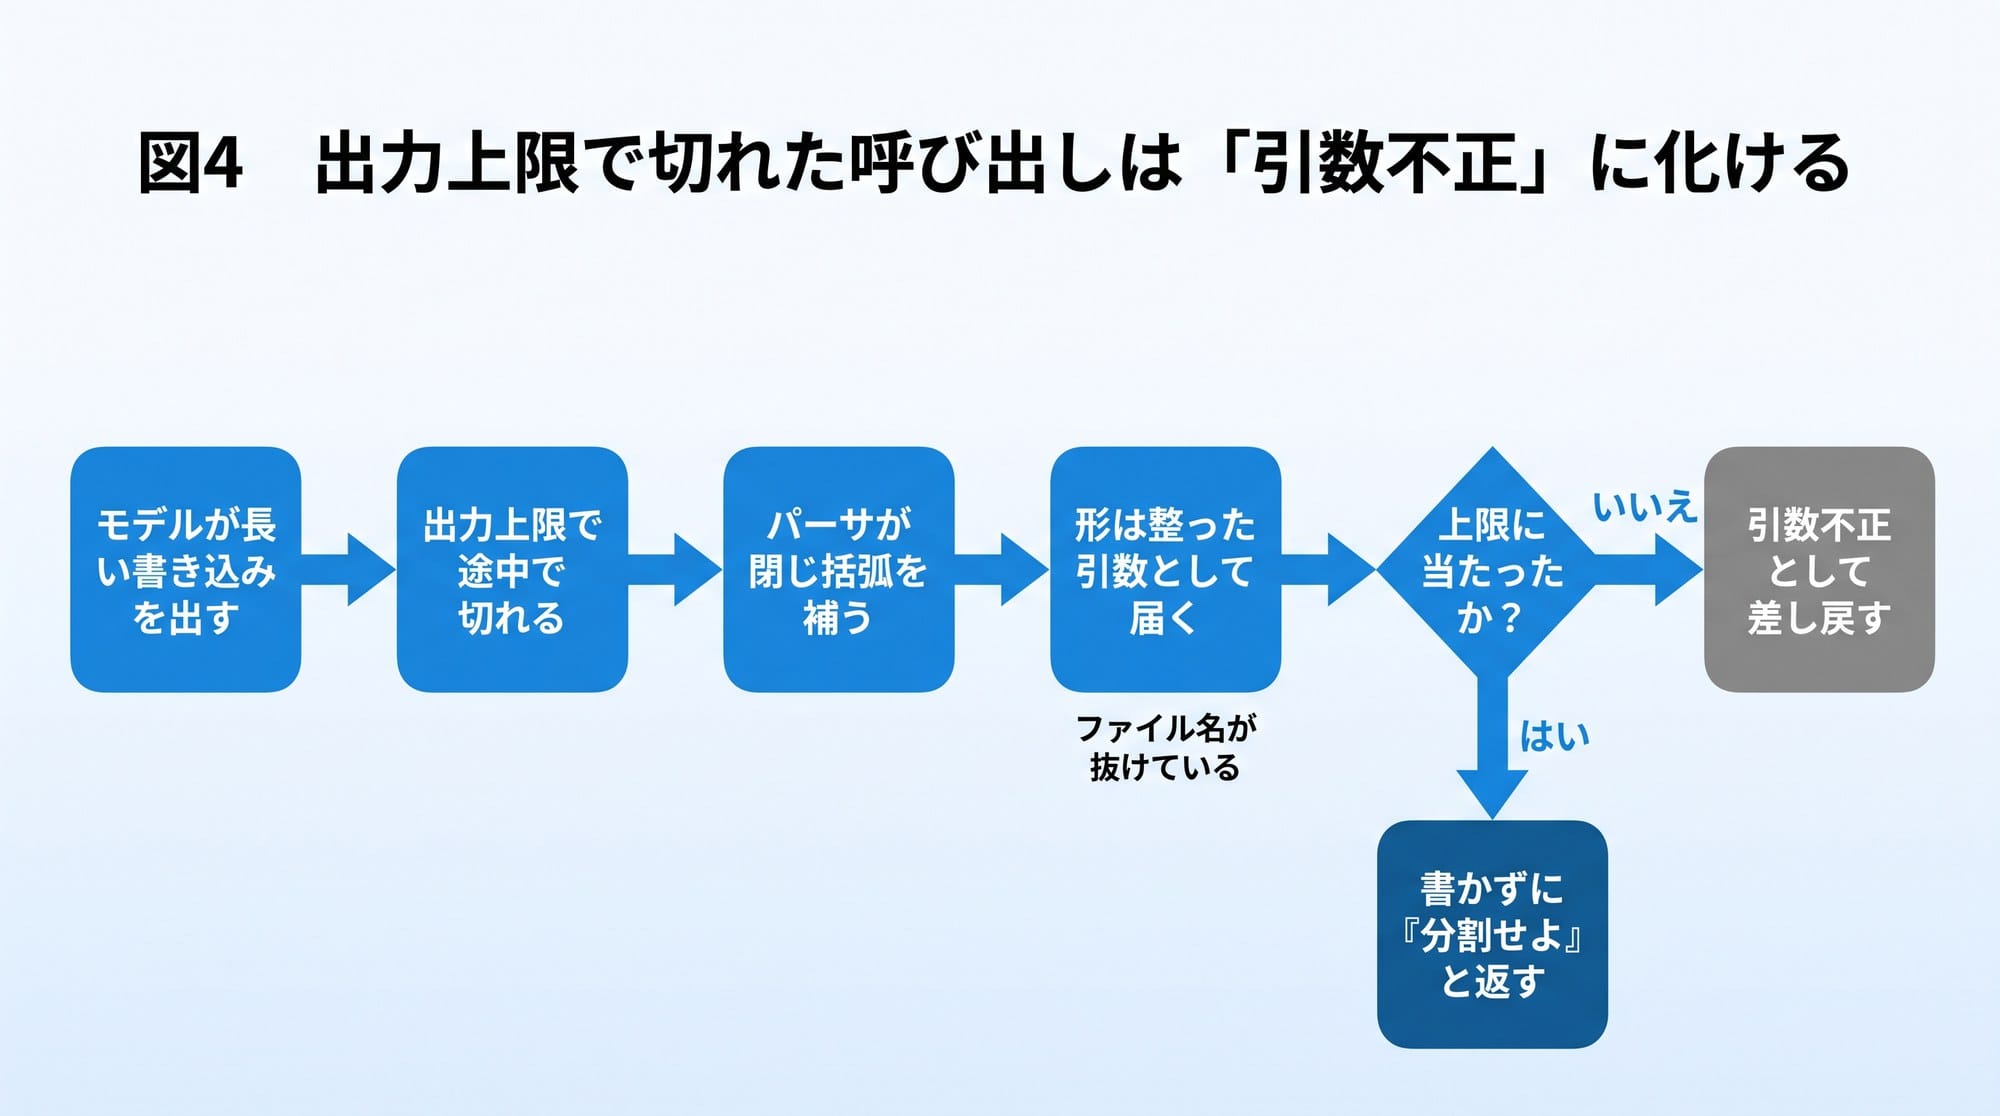
あるモデルは、ファイル書き込みの引数で content(本文)を先に、file_path(パス)を後ろに出す癖がありました。出力上限(当時4096)で途中で切られると、パスが落ちます。ここまでは想定内です。
想定外だったのは、推論サーバのパーサが切れたJSONを閉じて返すことでした。ハーネスには、形の整った「パス無し」の引数として届きます。ハーネスは「引数不正」と差し戻し、モデルは同じ大きさの書き込みを18回繰り返しました。切られた事実が、どこにも残っていなかったからです。
対処は、引数の形ではなく finish_reason と出力トークン数から「応答全体が上限に当たったか」を判定すること。当たっていれば、書き込み系のツールは書かずに「分割せよ、短い引数を先に」と返します。
ここで1つ、決めたことがあります。値の途中で切れた引数は修復しません。閉じて成功扱いにすれば動いたように見えますが、切れた本文をファイルに書き込むことになり、中身が捏造されます。壊れたものは壊れたと返して、モデルにやり直させます。
ローカルモデル向けに効いた他の対処も2つ書いておきます。
編集ツールは、置換の照合を「完全一致 → 空白の違いを許容 → 前後のアンカーで探す」の順にフォールバックさせています。ローカルモデルはインデントを揺らすので、完全一致だけだと編集の失敗率が跳ね上がります。
ツールの数は19個に絞りました。参考にした実装には42個ありましたが、小さなモデルは選択肢が多いと選択そのものを誤ります。
まとめ。モデルとハーネスの両方が要る
| 見ること | 測った結果 |
|---|---|
| GPUメモリ | 16GB×2で、4bitの35B-A3B + fp8 KV + 98k文脈。CUDAグラフは切らずに絞る |
| 文脈長 | 16kでは読み直しの循環、98kで合格。サーバに聞いて差し替える |
| モデルの形 | MoE 35B(活性3B)が本命。Dense 27Bは合格するが2倍遅い。Coder版は知識の欠落で失格 |
| 量子化 | 版によって同じ語の繰り返しに崩れる。空転30%超の低得点はモデルのせいにしない |
| 思考モデル | パーサの指定が無いと思考が本文に混ざる。ハーネス側で剥がす |
| ツール呼び出し | 出力上限で切れた呼び出しは形が整って届く。上限に当たったかで判定し、切れた引数は修復しない |
| 課題の形 | 同じモデルでもWeb 0/背景処理 24/CLI 70/修正と追加 92〜97 |
「賢いモデルを載せれば動く」でもなく、「ハーネスを鍛えれば弱いモデルでも動く」でもなく、両方が要りました。16GB×2の構成が確定したのは、ハーネスの欠陥を64件直した後です。
次回は、この連載の数字をすべて出している評価装置の話です。動くものを作らせて自動採点する仕組み、5種類の課題を3本ずつ走らせる合否の基準、そして採点器そのものが3日間ずっと壊れていた話を書きます。
それでは、また次回、お会いしましょう!