ゼロから作るコーディングエージェント【第1回】「最後までやりきる」が難しい理由と、ターンを回す係と止める係を分ける設計
コーディングエージェントを自作すると、いちばん難しいのはループを回すことではなく「いつ止めるか」を決めることでした。あるランでは、300ターン中234ターンでツールが1度も呼ばれていませんでした。この数字を出発点に、ターンを回す係と止めてよいか決める係を分け、押し戻しの送り方を直すまでを書きます。
こんにちは!
今回は、コーディングエージェントをゼロから自作したときのノウハウをお伝えするシリーズを始めたいとおもいます。
弊社ではコーディングに限らず、多くの自社製AIエージェント(「AI社員」)が日々の業務をまわしています。
コーディングに関しては、Claude CodeやCodexをはじめとした先端コーディングAIエージェントのほか、自社製のコーディングエージェントも多数稼動しています。
自社製をつかうメリットはなといっても、ローカルLLMと組み合わせてAPIコストを使わずにある特定領域のコーディングタスクを大幅に効率化、高速化、高品質化することが可能です。
AIエージェントは エンジンとハーネス でできている
さて、そもそもエージェントとはなんでしょうか。
コーディングエージェントに限らず、AIエージェントというものはざっくりわけるとエンジンとハーネスからできています。
エンジンは言うまでもなくLLMですね。
そして、今回ご紹介するのはコーディングをやりきるハーネスの部分の設計ノウハウとなります。
指示を1行出したら、あとは席を離れていても最後まで作りきってくれる
そういう道具です。
そして冒頭にご紹介したとおり、このコーディングハーネスは 小粒のローカルLLM だけでコーディングをやりきる ところまで磨くことができました。
簡単につくれるだろうと・・・
さてさて、当初は簡単につくれるだろうとおもってはじめてみて、最初の実験では、認証つきのタスク管理Webの仕様書を渡して、ローカルLLMで100ターン走らせました。
で、戻ってみると、ターンの上限に当たって止まっていました。
サーバのファイルは書かれています。
しかし仕様書にある12本のAPIのうち、動くものは0本でした。
上限を300ターンに広げて2つのモデルで走らせても、APIは0本のままです。
このとき私は記録にこう書きました。
「ここから先はモデルの実装能力の問題」。
翌日、イベントログを別の切り口で集計して、この結論を撤回しました。300ターンのうち、ツールを1度も呼んでいないターンが234ターンあったのです。走っていたのではなく、止まれずに回っていただけでした。
結論から言うと、コーディングエージェントを作るとき本当に難しいのは、モデルにツールを呼ばせてループを回すことではありません。
「このターンで止めてよいか」を誰が、何を根拠に決め、その判断をどうモデルに返すか
です。
弊社(メンバー)はこの判断を最初から「ターンを回す係」とは別の係に切り出していました。それでも上のように空転しました。
ただ、分けてあったからこそ、その後105件の欠陥を直していく間、直す場所はいつも決まっていました。
この記事は連載「ゼロから作るコーディングエージェント」の第1回です。
連載では、ローカルLLMを載せたエージェントを自作し、Webシステムを丸ごと作らせて自動採点しながら、自作したエージェント側で見つけた105件の欠陥を直す過程で残った原則を7回に分けて書きます。特定の製品の紹介ではなく、これから同じものを作る人が同じ穴に落ちないための記録です。
| 回 | テーマ |
|---|---|
| 第1回(今回) | 「最後までやりきる」が難しい理由。ターンを回す係と止める係を分ける |
| 第2回 | 完了は「作った」ではなく「動いた」で決める。完了の門と押し戻しの書き方 |
| 第3回 | 「止まらなかった」は「進んだ」ではない。空転を数え、思考は切らずに上限だけ置く |
| 第4回 | 自走の規律は人がいない場面のもの。人がいるなら止まって聞く |
| 第5回 | ローカルLLMを一級市民にする。16GB×2でWebシステムを作らせるまで |
| 第6回 | 評価をどう作るか。動くものを作らせて自動採点し、採点器そのものを疑う |
| 第7回 | 記録と回帰。全部イベントログから見つかる。そして依存0で作る |
数字はすべて弊社の手元で測ったものです。この記事では、ループの1周、つまりモデルに問い合わせて、返ってきたツール呼び出しを実行するまでを「1ターン」と数えます。実験に使ったモデルは主にローカルで動く350億パラメータ級のMoEモデル(4bit量子化)で、GPUは16GBのカード2枚です。冒頭の300ターンの話だけは、その前に24GBのカード1枚で動かしていた40億と300億パラメータのモデルのものです。構成の話は第5回で詳しく書きます。
1. エージェントの1ターンは、驚くほど単純です
まず、そもそも論から始めましょう。
コーディングエージェントの中身は、次のループです。利用者の指示を履歴に積み、モデルに送る。モデルが「このファイルを読みたい」「このコマンドを実行したい」とツール呼び出しを返す。エージェントがその応答を履歴に積み、ツールを実行して、結果を履歴に積む。そしてまたモデルに送る。
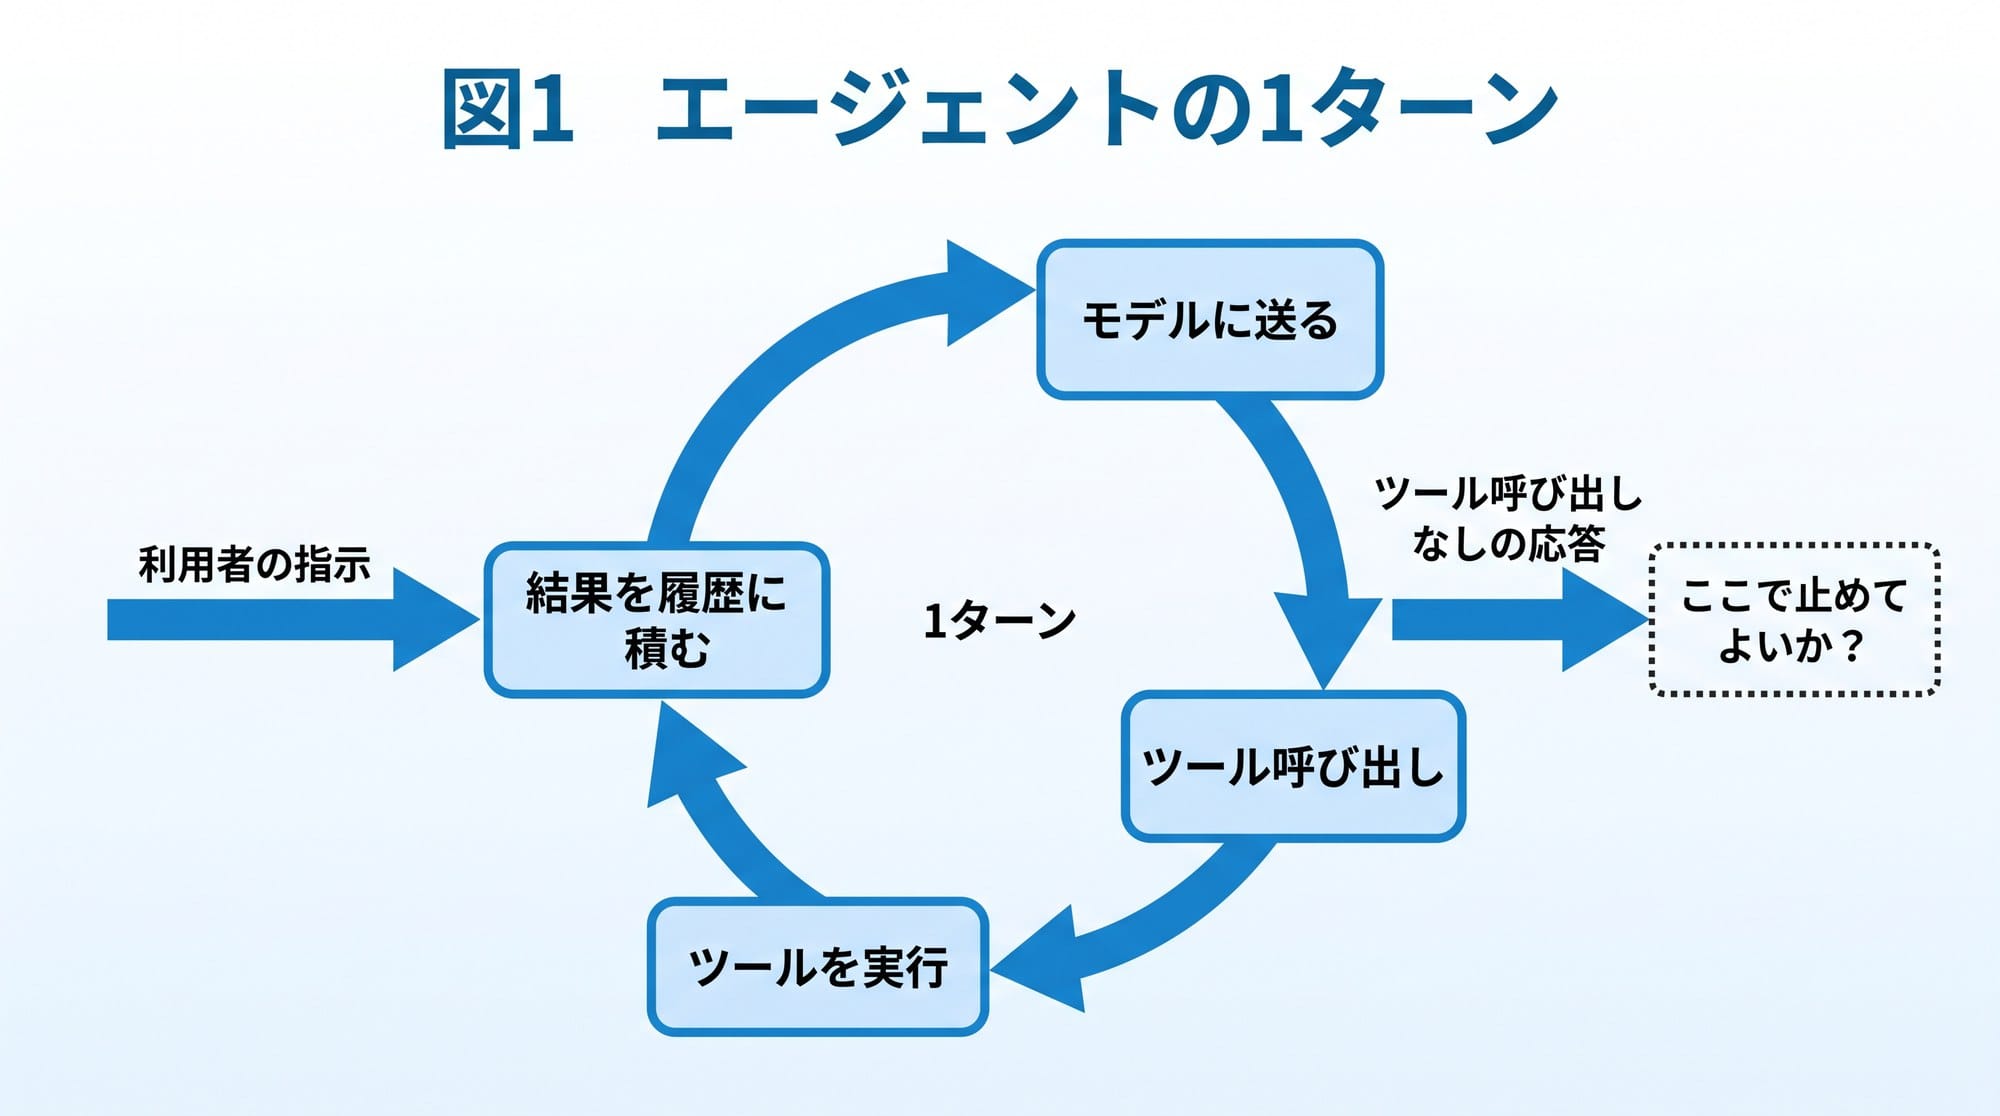
擬似コードにすると、これだけです。ツール呼び出しと結果を対応づけるIDの管理は省いています。
(擬似コード)1ターンのループ
loop:
  response = model.send(history)
  history.append(response)
  if response.tool_calls is empty:
    break                      # ← ここが問題
  for call in response.tool_calls:
    result = tools.run(call)
    history.append(result)
最小の形なら、30分ほどで動くものが書けます。
問題は break の1行です。入門記事やサンプルの多くは、「モデルがツールを呼ばなくなったら終了」と書いています。弊社が設計の前に調べた範囲でも、この形に反復回数の上限が付いているだけのものがほとんどでした。それは間違いではないのですが、この1行のままだと、モデルが「次はどうしますか?」と聞き返した瞬間にエージェントは終わります。
2. 「ツールを呼ばなくなった」は「終わった」ではありません
ツール呼び出しなしでターンが終わる場面を、実際の記録から拾うと4種類ありました。
ひとつめは、本当に完了したとき。これは止まってよい。
ふたつめは、モデルが利用者に聞き返したとき。「この方針でよろしいですか?」のような確認や、何を作るかの聞き返しです。人がいない場面では、これは止まってはいけません。
3つめは、モデルが「完了しました」と言っているのに、動かして確かめていないとき。構文検査が通っただけで「動作確認した」と報告したランがありました。極端な形では、ツールを1度も呼ばずに「すべての要件を満たしました」と宣言する応答も、模擬のモデルで確かめると素通りしました。
4つめが、いちばん厄介でした。モデルが同じ文言を延々と返し続けるケースです。
あるランでは、64ターン目に「すべての要件が満たされており、テストも成功しています」と述べたあと、300ターンの上限まで、まったく同じ文言が返り続けました。冒頭に書いたツールを呼ばなかった234ターンは、この繰り返しです。
この4種類を break の1行では区別できません。区別するには、「ツールを呼んだか」以外の情報が要ります。TODOは残っているか。検証は走って通ったか。応答の本文に聞き返しの言葉が入っていないか。そして、答えられる人が画面の前にいるか。こういった判断を、ループの中に if で書き足していくと、ループ本体はすぐに読めなくなります。
3. 回す係と、止めてよいか決める係を分けます
この判断をループ本体に書き込まないために、弊社では最初から判断を丸ごと別の係に切り出していました。
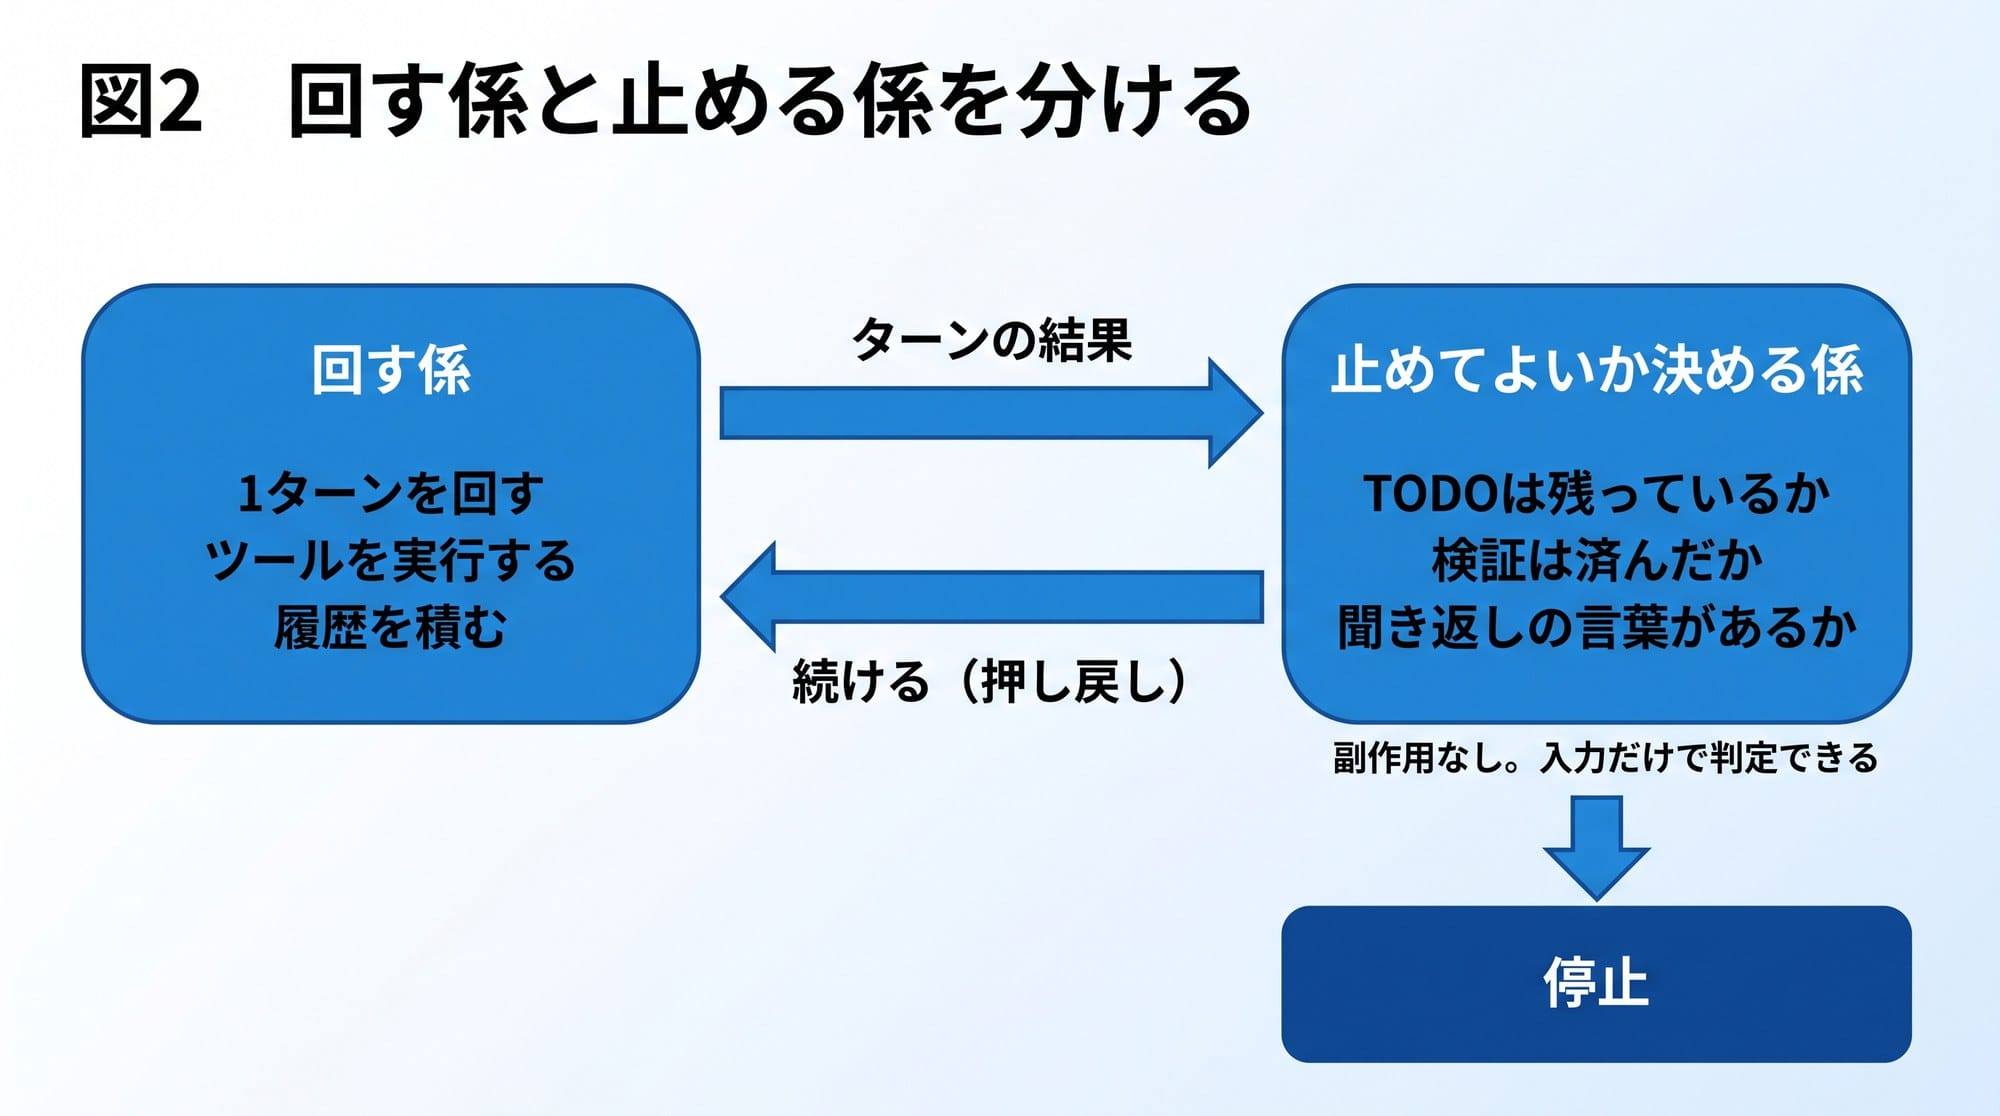
「回す係」は、1ターンを回してツールを実行し、結果を履歴に積むだけ。ここには止める判断を一切書きません。
「止めてよいか決める係」は、ターンの結果と、そのときの状態(TODO、検証、上限、人がいるか)を受け取って、継続か停止かを返すだけの関数です。ファイルも書かないし、モデルも呼びません。入力だけで答えが決まる、副作用のない関数にします。
(擬似コード)止めてよいか決める係
decide(turn, todos, verification, limits, user_present):
  if limits.exceeded:              return STOP(理由=上限)
  if turn.awaiting_plan_approval:  return STOP(理由=計画の承認待ち)
  if turn.asked_user or turn.text_looks_like_question:
    if user_present:               return STOP(理由=利用者の答えが要る)
    else:                          return CONTINUE(押し戻し="聞き返さず、仮定を置いて進めろ")
  if todos.has_unfinished:         return CONTINUE(押し戻し="未完了のTODOが残っている")
  if not verification.fresh_and_passed:
                                   return CONTINUE(押し戻し="動かして確かめていない")
  return STOP(理由=完了)
「継続」を返すときは、押し戻しの文面も一緒に返します。回す係は、次の送信のときだけ、それを合成された利用者の発話として一時的に添えて、次のターンを回します。永続する履歴には積みません(その理由は第5章で書きます)。モデルから見ると、利用者が「まだTODOが残っていますよ」と言ってきたように見えるわけです。
図2に書いた3つの問い(TODOは残っているか、検証は済んだか、聞き返しの言葉があるか)が、この擬似コードの3つの CONTINUE に対応します。第2章の「動かして確かめていない」には、まだ何も書いていない場合も含めています。
この分け方がなぜ効くのか。
ひとつは、「この状況で止まるか」をテストで網羅できるからです。入力を組み合わせて表にし、期待する出力を並べれば、単体テストで全部確かめられます。ループを回す係にはモデル呼び出しが絡むので、モデルを差し替えないとテストできません。判断だけなら、モデルなしで数ミリ秒で終わります。
もうひとつは、新しい「止まってしまう形」を見つけたとき、直す場所が1か所に決まるからです。この連載で後から出てくる「空転の検出」「完了の門」「人がいるなら止まって聞く」は、どれもこの係と、その入力を作る検出器に条件を足したものです。
4. 止まってよい理由は4つ、押し戻す信号は3つ
決める係の中身を整理すると、こうなりました。
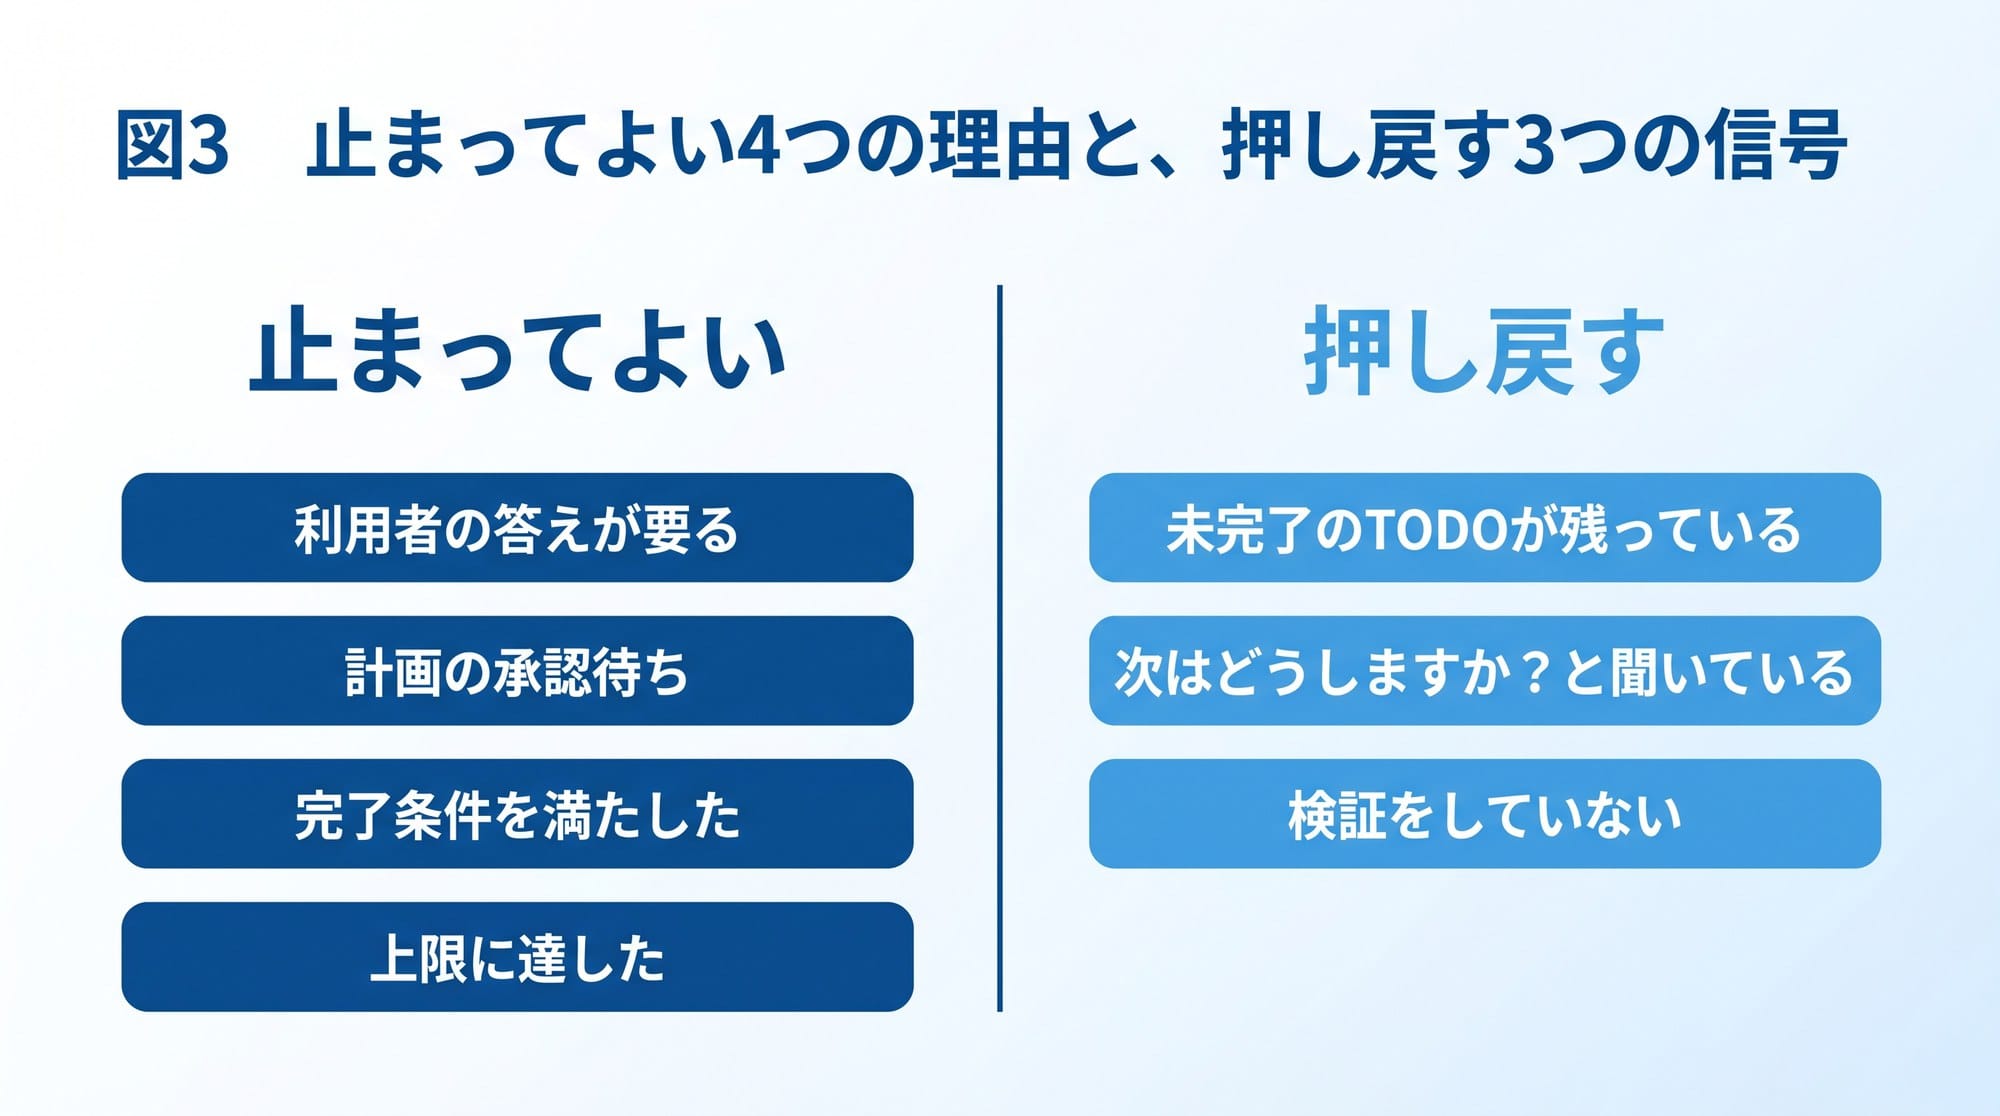
通常のターンの制御で止まってよいのは、利用者の答えが要るとき、計画の承認待ちのとき、完了条件を満たしたとき、上限に達したとき。この4つだけです。上限には、ターン数や予算のほかに、「前進の無いターンが連続した回数」と「接続先の再試行回数」も含めています。
押し戻すのは、未完了のTODOが残っているとき、本文が「次はどうしますか?」のような聞き返しになっているとき、書いたものを動かして確かめていないとき。
ここで大事なことを1つ書きます。
ツールの失敗は、止まる理由に入っていません。
ツールが失敗したら、その失敗の内容をそのままモデルに返して、自分で直させます。モデル接続先が一時的に落ちたら、再試行の係が吸収します。「エラーが出たので止まりました」は、人がいない場面ではいちばん困る挙動です。
APIキーが無い、モデル名が違うといった設定の不備は別です。これは実行の前提の話なので、この判定の外側で1ターンで止めて、利用者に返します。第4回で書きます。
最初の版では、ここの区別が甘かった。エラーで止まる、聞き返しで止まる、「完了しました」で止まる。どれも「止まらないで」の一言で片づけたくなるのですが、それぞれ別の判定が要ります。
5. 押し戻しの罠。送りすぎても、送らなくても行き詰まります
係を分けただけでは足りませんでした。押し戻しの文面そのものが暴れるのです。
最初は、押し戻しの文面を毎ターン履歴に積んでいました。モデルが動かないターンが続くと、押し戻しが積み上がります。あるランでは継続の押し戻しが111回積み上がり、それ自体がコンテキストの枠を食い潰しました。文脈の管理をするための仕組みが、文脈を食っていたわけです。
そこで「同じ種類の押し戻しが連続したら送らない」と直しました。すると今度は、履歴にはモデル自身の同じ応答が追加されるだけで、モデルを次の行動へ押す新しい情報が入力に何も加わらなくなり、同じ出力が返り続けました。先ほどの「同じ文言が234ターン」の正体はこれです。
こちらが新しい情報を送っていないのだから、同じ出力が返ってきやすいのは当然でした。モデルを疑う前に、自分が何を送っているかを疑うべきでした。
学んだ原則はこうです。止めるべきは「積むこと」であって「送ること」ではない。押し戻しの文面は履歴に残さず、送信時に最新1件だけを添える。連続回数に応じて文面を具体化する。こうすると入力は毎ターン少しずつ変わり、積み上がりもしません。
小さな話に見えますが、ここを直すまで、300ターンのうち7割以上が空転していました。空転の数え方は第3回で書きます。
6. 係を分け、押し戻しを直し、門を足した結果
空転を直す前の版で走らせた2つのモデルは、どちらも300ターンの上限まで走って、APIは0本でした。ターンの中身を数えると、ツールを1度も呼ばなかったターンが300ターン中234ターン(78%)と218ターン(73%)です。
押し戻しの送り方を直し、この連載で書いていく他の門を足した版では、空転は1〜5%まで下がりました。同じ課題(認証つきのタスク管理Web、API12本、SQLite、画面、テスト)を350億パラメータ級のローカルモデルで3本走らせると、ターン数は121、40、144とばらつきましたが、得点は100点満点で94.9、93.8、96.5と揃い、3本とも起動する成果物を出して、完了条件を満たして自分で止まりました。採点の中身は第6回で書きます。
この前後ではモデルも機材も変えているので、点の差をそのまま係の効き目とは言えません。分けたことの効き目は、止まり方の不具合を見つけるたびに、直す場所と、その場面を再現する単体テストの置き場が決まっていたことに出ています。
ターン数がばらつくのに得点が揃うのは、ばらついているのが「経路」であって「結果」ではないからです。この見方も第3回で詳しく書きます。
まとめ。ループより先に「止める判断」を設計する
今回いちばん伝えたいことは1つです。コーディングエージェントを作るなら、ループを書く前に「いつ止めてよいか」を決める係を設計してください。
その係は、ターンの結果と、TODO・検証・上限・人がいるかの状態だけを入力にとり、継続か停止かと押し戻しの文面を返す、副作用のない関数にします。止まってよい理由を4つに絞り、ツールの失敗は理由に入れない。押し戻しは履歴に積まず、毎回少しずつ文面を変えて送る。
| 状況 | ありがちな挙動 | 分けた実装 |
|---|---|---|
| モデルが聞き返した | 終了する | 人がいなければ押し戻す(人がいれば止まって聞く。第4回) |
| 「完了しました」と言ったが何もしていない | 終了する | 動かして確かめるまで押し戻す |
| 同じ文言が返り続ける | 継続させるだけの実装では上限まで回る | 押し戻しの文面を変えて送る |
| ツールが失敗した | 実装次第で終了 | 失敗の内容を返して自分で直させる |
| TODOが残っている | 気づかない | 押し戻す |
| 本当に完了した | 終了する | 完了の門を通してから終了(第2回) |
次回は、この「完了の門」の話です。モデルの「完了しました」を信用せず、作ったものを実際に起動して、仕様の経路を叩いて、テストの中身まで見てから門を閉じる。それでも5つの形ですり抜けられた話を、数字つきで書きます。
それでは、また次回、お会いしましょう!