ゼロから作るコーディングエージェント【第6回】評価をどう作るか。動くものを作らせて自動採点し、採点器そのものを疑う
採点器の「テスト」10点が3日間ずっと0/0でした。点数の表を見ているだけでは気づけません。仕様書を渡してWebシステムを作らせ、起動して叩いて採点する評価装置の作り方、5種類×3本の合否基準、対照実験を先にやる理由、自作でない課題で「テストだけが決めている契約」を先に洗う話を、測った数字で書きます。
こんにちは!
自作のコーディングエージェントの評価装置を作って、3週間ほど毎日走らせていた頃の話です。認証つきタスク管理Webの課題を17本走らせ、点数の表を眺めて「合格の幅に収まっている」と判断していました。
ある日、1本の内訳を読んでいて、こんな行を見つけました。
「テスト | 10点 | 0 | 0/0」
17本すべて、テストの配点10点が0/0でした。
採点器を分割した日に入れた振り分けの規則が、テスト関連の項目を別のカテゴリに振っていたのです。単体テストも、その壊れた形を「正しい」として固定していました。3日間、誰も気づきませんでした。
結論から言うと、コーディングエージェントの評価は
「動くものを作らせて、自動で採点する」形にしないと数字が出ません。
そして、その採点器そのものを疑い続けないと、数字が嘘をつきます。この記事では、弊社の評価装置の作り方と、採点器の穴を3つ、そして自作でない課題を取り込むときの落とし穴を書きます。
この記事は連載「ゼロから作るコーディングエージェント」の第6回です。
前回の第5回は、16GBのGPU2枚にローカルLLMを載せて、Webシステムを自走で作らせるまでの話でした。
同じ課題を3本走らせて94.9、93.8、96.5点。この数字で「この構成は動く」と言い切れたのは、点を出す物差しが先にあったからです。
今回は、その物差しの側の話です。連載でこれまで出してきた数字は、すべてこの評価装置が出したものです。
1. 課題は「仕様書を渡して、Webシステムを丸ごと作らせる」形にしました
評価の形はこうです。この記事では、エージェント本体をハーネス、成果物を採点する部分を採点器、課題と採点器と実行の段取りをまとめたものを評価装置と呼びます。
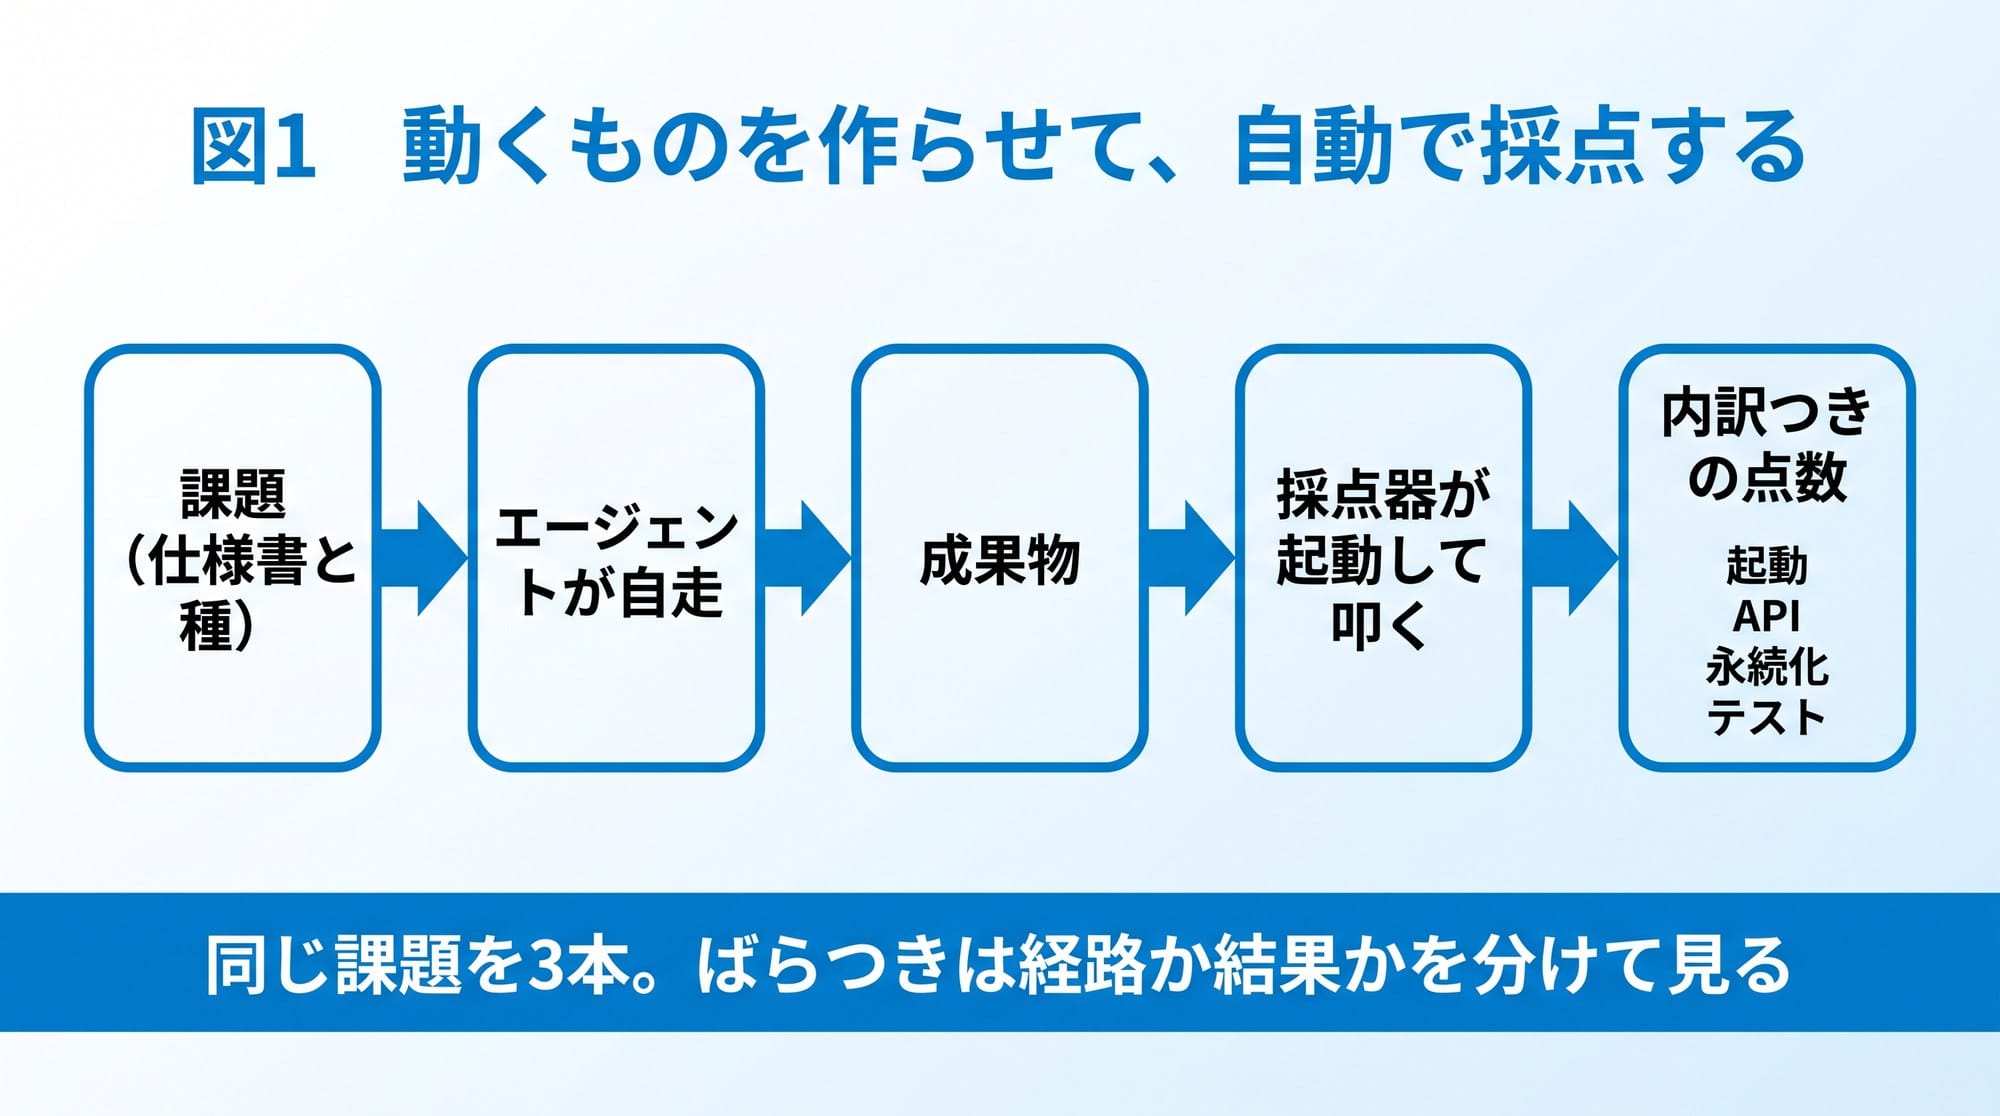
課題は、仕様書と種(空か、途中まで書かれたコード)の組です。エージェントに1行の指示と仕様書を渡して、無人で走らせます。止まったら、採点器が成果物を実際に起動し、仕様の経路を叩いて、データが永続化されているか、画面が返るか、テストが書かれて通るかを見て、内訳つきの点数を出します。
最初の課題は、認証つきのタスク管理Webにしました。API12本、SQLite、ログイン画面とカンバン画面、テスト。「まあまあ複雑なWebシステムを作れるか」を測るためです。配点は起動15、API35、認可15、永続化10、画面10、テスト10、品質5の100点で、70点を合格にしました。
なぜ「動くもの」にこだわるか。第2回で書いたとおり、モデルは「完了しました」と言うからです。テストが通ったかどうかも、モデル自身が書いたテストなら証拠になりません。採点器が別のプロセスで成果物を起動し、外から叩く。それ以外に信用できる物差しがありませんでした。
もう1つ、採点器は課題の答えを知っていますが、ハーネスは知りません。第2回の完了の門は「仕様書に書かれた経路があるか」「状態コードが仕様どおりか」までしか見ず、レスポンスの中身は見ません。門が答えを知ると評価が出来レースになります。この線は最後まで守りました。
2. 対照実験を先にやると、7分半で決着します
評価を作ってすぐに、やっておくべきだったことがあります。対照実験です。
弊社の評価計画には最初から「クラウドの強いモデルで高い点と介入0を確認する」と書いてありました。ところが実行していませんでした。ローカルモデルの点が出ない原因が「ハーネスが壊れている」のか「モデルが足りない」のか、切り分けられないまま、ハーネスの修正を16件積み上げていました。
クラウドの小型モデルで1本走らせたら、7分半で決着しました。33ターン、89.5点、介入0、停止理由は「完了」。サーバは起動し、データは永続化されていました。合格点の70を大きく超えて介入0で完了まで走ったので、切り分けにはこれで足りました。
これで、16件の修正の位置づけが変わりました。「壊れていたものを直した」のではなく、「ローカルモデルが土俵に立てるようにした」修正だったわけです。どちらも要る修正ですが、意味は違います。
「ハーネスが壊れているか」「モデルが足りないか」を切り分ける対照実験は、最初にやってください。弊社はこれを後回しにして、1週間分の修正の意味を取り違えたまま進めていました。
3. 課題の種類を増やし、合否の基準を先に決めます
1つの課題で測っていると、「このモデルは使える/使えない」を1つの点数で言いたくなります。それが危ないことは、Coder版のモデルで分かりました。
同じモデルが、Webのゼロ構築では0点(失格)、背景処理つきサーバでは24点、CLIのゼロ構築では70点、既存コードの不具合修正では92.5点、既存コードへの機能追加では96.7点でした。課題の形で4段階に分かれます。弱いモデルでも、既に構造がある仕事なら実用になります。
そこで課題を5種類にしました。Webをゼロから、不具合修正、CLIをゼロから、既存APIへの機能追加、背景処理つきサーバ。それぞれ隠しテストか専用の採点器で採点します。
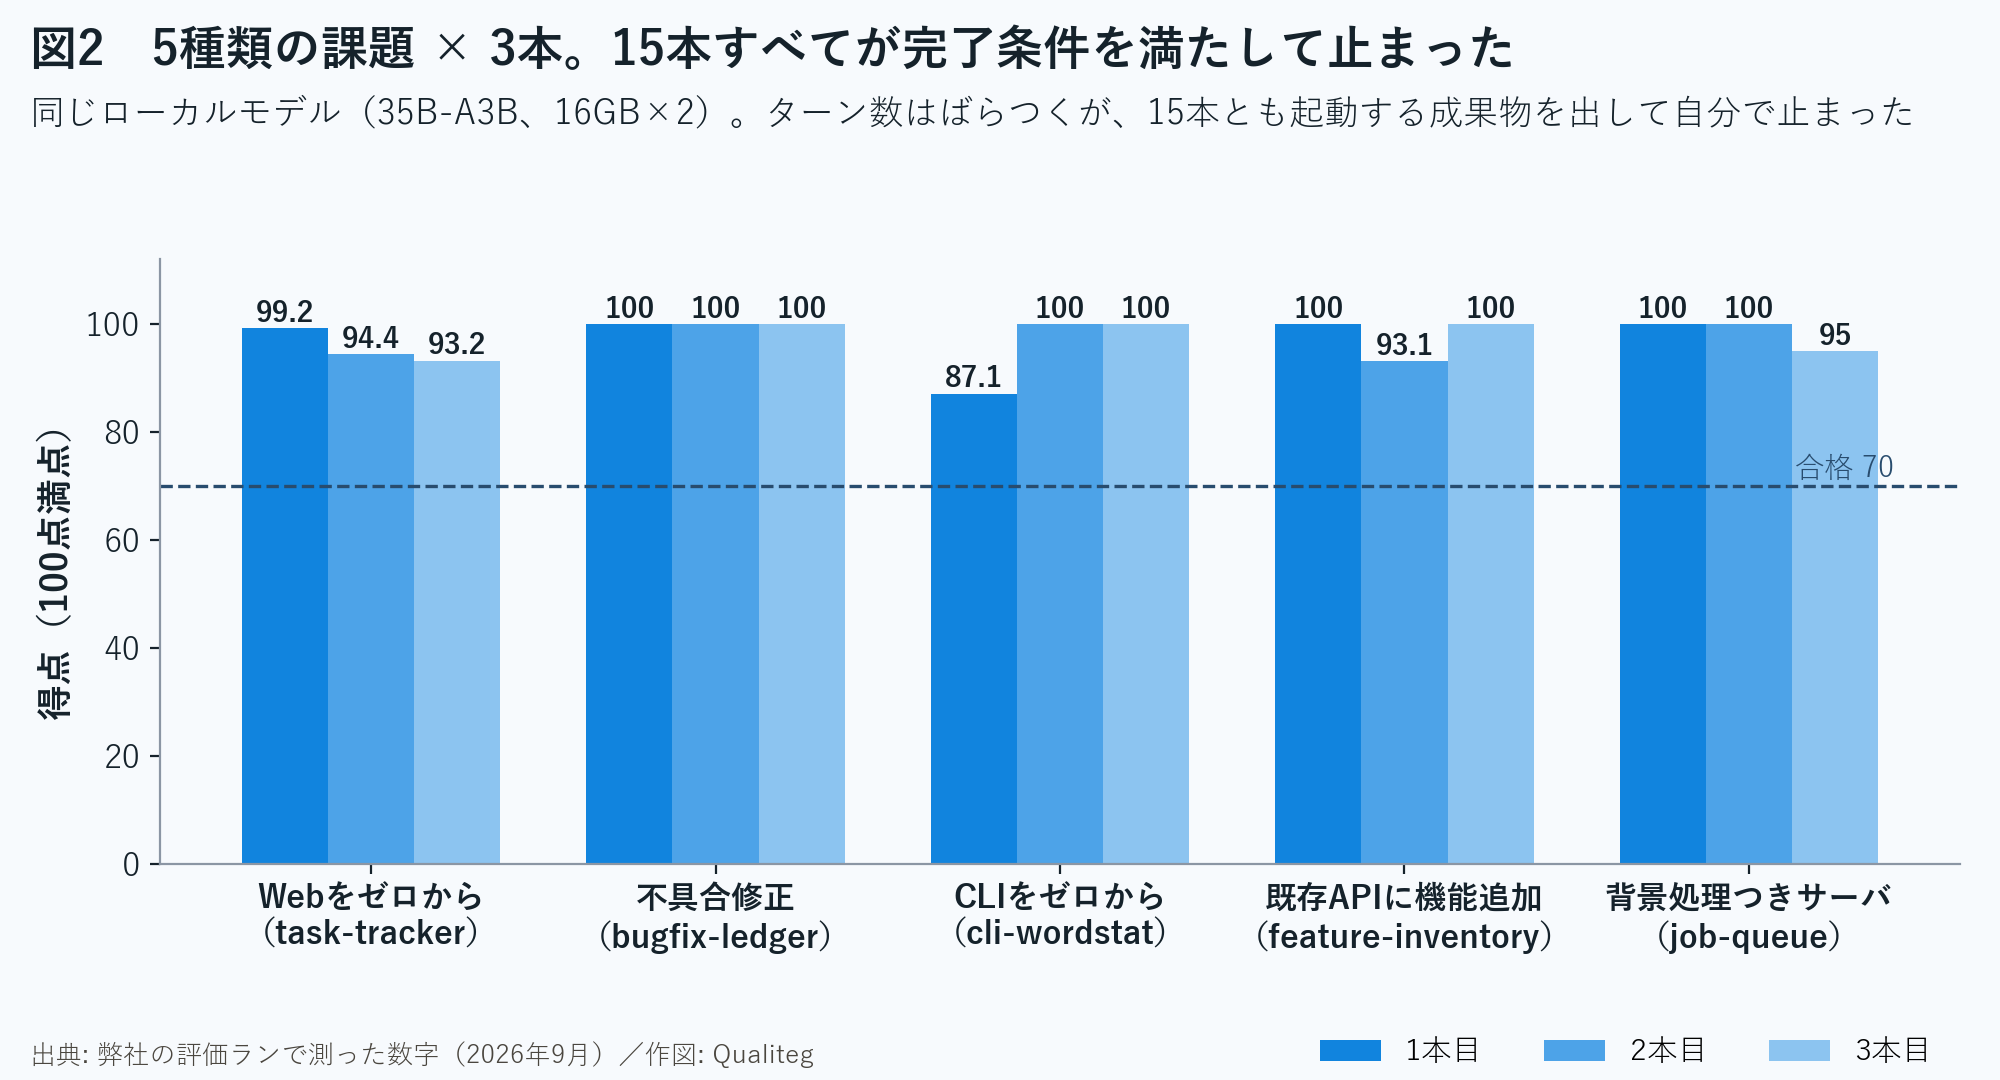
そして、ハーネスの合否の基準を先に決めました。「もう少し走らせてみる」を終わらせるためです。
| 指標 | 基準 |
|---|---|
| 1 | 起動しない成果物を completed と呼ばない |
| 2 | まともなモデルで、空転による停止が0 |
| 3 | ハーネス側の時間(検証と門)が実時間の2割以下 |
| 4 | 同じ課題を3本走らせて、3本の得点が平均から±5以内 |
点数はモデルの成績です。ハーネスの合否は別の指標で見ます。3本走らせるのは、第3回で書いた「経路のばらつきと結果のばらつきを分ける」ためです。
最新のハーネスでの正式判定は、5種類×3本の15本すべてが completed で止まり、サーバを起動する6本はすべて起動確認を通り、ハーネス側の時間は最大12%でした。平均から±5を超えた課題は1つで、CLIをゼロから作る課題の1本目(87.1点)でした。中身を読むと、除外する語の扱いと --json の出力の形をモデルが落としたもので、ハーネスの押し戻しで拾える種類の失点ではありませんでした。
指標ごとに「満たさない原因がハーネスかモデルか」を切り分けられる。これが基準を先に決める効き目です。
4. 評価環境の汚染は、点数に出ずに自律性を壊します
評価を3週目に入ったところで、恥ずかしい発見をしました。
作業機で残っているプロセスを棚卸ししたら、2日前の評価ランが起こしたサーバが3本残っていました。さらに、課題の仕様書が「既定のポートは3000」と書いているその3000番を、評価とは無関係の常駐アプリが2週間前から掴んでいました。つまり、モデルが仕様どおりにサーバを起動すると必ずポート衝突になる環境で、最初の2週間のランはすべて走っていたのです。
過去10本のログを衝突のエラーで数えると、1本は191行、自前テストが127回ポート衝突で失敗していました。モデルは「ポート衝突は実装の欠陥ではない」と結論して先へ進んでいました。
採点器は別のポートを使うので、点数には直接出ていません。壊れていたのは「モデルが自分の成果物を動かして確かめる」工程で、これは自律性の中核です。衝突を「自分のせいではない」と読んだモデルは、動作確認を諦めます。
対処は、ランごとにOSから空きポートを取り、モデルの実行環境に PORT として差し込むこと。採点器のポートも固定をやめて空きから取る。ランの終わりにそのポートを掴んでいるプロセスを止める。他人のポートには触りません。
評価環境の前提は、ランを走らせる前に毎回確かめる。「ポートは空いている」は、書いた時点では真でも2日後には偽になります。集計の切り口(衝突のエラーを数える)を持っていなかったので、191行のログを残していても気づきませんでした。この話は第7回のイベントログにつながります。
5. 採点器そのものを疑います
冒頭の「テスト0/0」に戻ります。採点器の穴は、他にも2つ出ました。
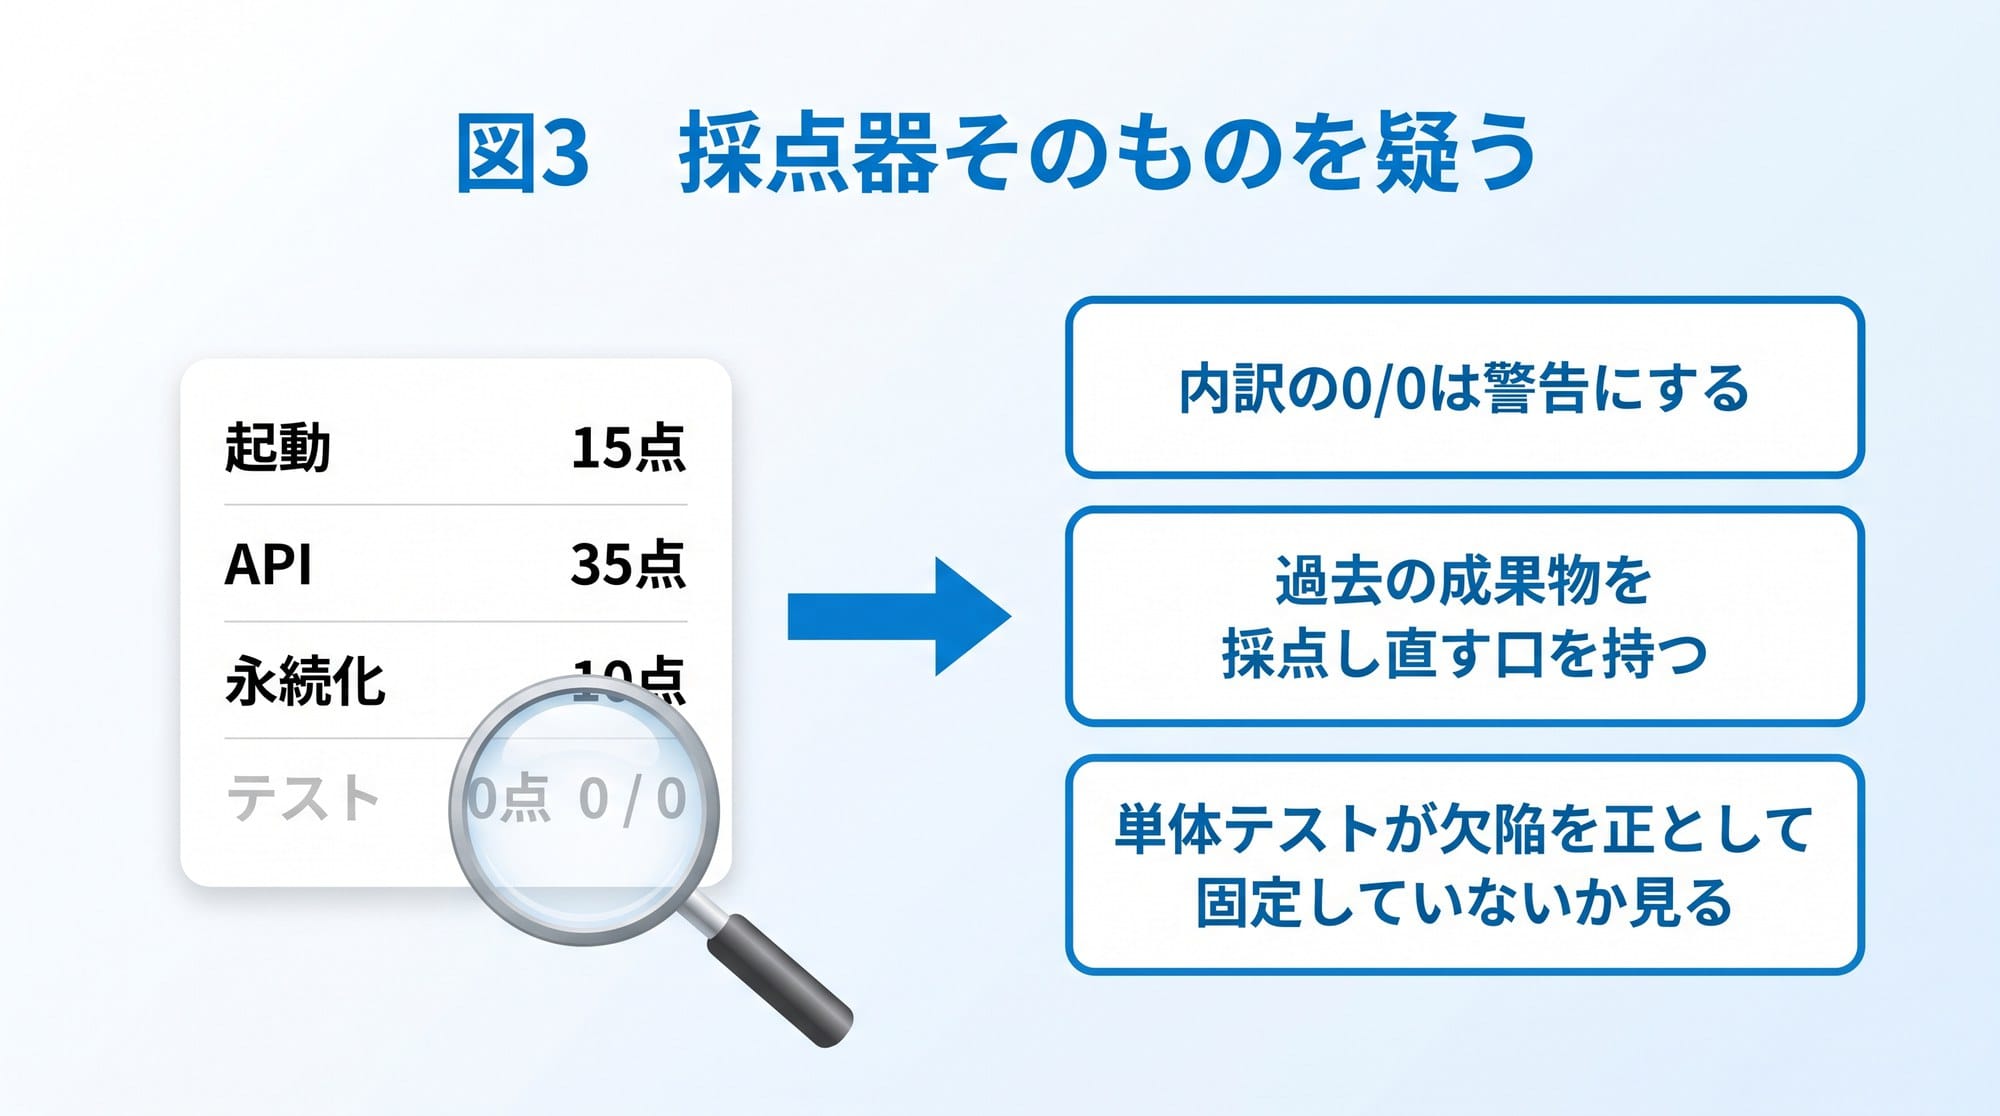
5-1. 内訳の0/0は、警告にする
「テスト0/0」の原因は、採点器を分割したときに足した「接頭辞がカテゴリ名なら、そのカテゴリに振る」という規則でした。テスト関連の3項目は quality: テストが書かれている のように「quality」で始まっていたので品質に振られ、その後ろに書いてあった「quality の中のテスト項目は tests に振る」規則が一度も効かなくなりました。
影響は、テストが3件通っていれば+10点。品質は分母が9から6に減ります。採点し直すと17本はどれも9.8点前後上がり、合否の判定(平均から±5)は動きませんでした。絶対値だけが10点低く見えていた形です。対照のクラウドモデルと並べたとき、その差がちょうど見えなくなっていました。
直したのは3つ。内訳に0/0の項目があれば警告として出す。過去のランの成果物を、いまの採点器で採点し直せる口を持つ(走らせ直さずに済みます)。そして、単体テストが「tests に入る項目は無い」とその形を正として固定していたので、テスト自体を直しました。
「単体テストが通っている」は「物差しが正しい」の証拠になりません。テストが欠陥を正として固定していることがあります。この形は第7回でもう1回出てきます。
5-2. 0/0は「何も書かなかった」とは限らない
自作でない課題(後述)を走らせたとき、6問のうち3問が0/0でした。モデルが何も書かなかったのかと思って中身を見ると、書いてありました。
原因は採点器のほうでした。1問目の成果物が無限ループし、採点器は6問を1つのプロセスで走らせていたので、180秒で全体を打ち切って、まだ走っていなかった3問の結果まで失っていました。ファイルごとに別のプロセスで走らせ、止まったファイルはその問題の失敗として残すようにしました。
採点器の0/0は、理由が出るまで疑ってください。
5-3. 監査の切り口も、種が何かで誤ります
評価ランの集計に「環境由来の失敗の印」(ポート衝突、パッケージの取得、パスの食い違いなど)を数える切り口があります。3万行の既存コードベースに機能を足す課題を走らせたら、4本とも3〜19件の印が出て、評価環境を疑いました。
実際は、種にしたコードベースのテスト名に「EADDRINUSEの助言に…」のような語が入っていて、検証の出力に並んだテスト名を印として数えていただけでした。テスト報告の行を除いてから数えるように直しました。物差しは、測る対象が変わると誤ります。
6. 自作でない課題は「テストだけが決めている契約」を先に洗います
自作の課題だけで測っていると、課題が自分のハーネスに都合よくできている疑いが残ります。そこで公開されている課題を探しました。
| 候補 | 判定 | 理由 |
|---|---|---|
| SWE-bench系 | 不採用 | Dockerのコンテナが必須で、依存0でWindowsのまま走らせる条件に合わない |
| Vibe Code Bench | 不採用 | 100仕様のうち公開は0 |
| ViBench | 不採用 | Docker、Playwright、クラウドLLMの鍵が必須 |
| VibeCodingBench | 不採用 | ライセンスが All rights reserved |
| WebGen-Bench | 不採用 | 採点がブラウザエージェントと視覚モデル。隠しテストに変換できない |
| Web-Bench | 保留 | 課題の形は良いが、テストがPlaywright。移植が要る |
| Exercism(Aider polyglot のJS 49問、MIT) | 採用 | 問題文、骨組み、テスト、参照実装が揃う。テストの使用範囲が狭く、依存0の互換層で原文のまま走る |
「条件を先に決めてから探す」が要点でした。弊社の条件は、依存0、Windowsで動く、隠しテストの形に変換できる、ライセンスが許す。この4つで、ほとんどの公開ベンチが落ちます。
取り込んだ課題は、使う前に種で落ちて、参照実装で満点になることを確かめました。両方の6問セットで、種は15点(品質だけ)、参照実装は100点でした。ここを飛ばすと、採点器の穴と課題の穴が区別できません。
6-1. 問題文ではなく、テストが決めている
下見で走らせると、ある問題が0/95でした。戻り値の型が Date であることをテストだけが決めていて、モデルは日付の数値を返していました。別の問題は49件中15件がエラー文言の違い(Stack empty を .stack too small にしていた)で落ちていました。
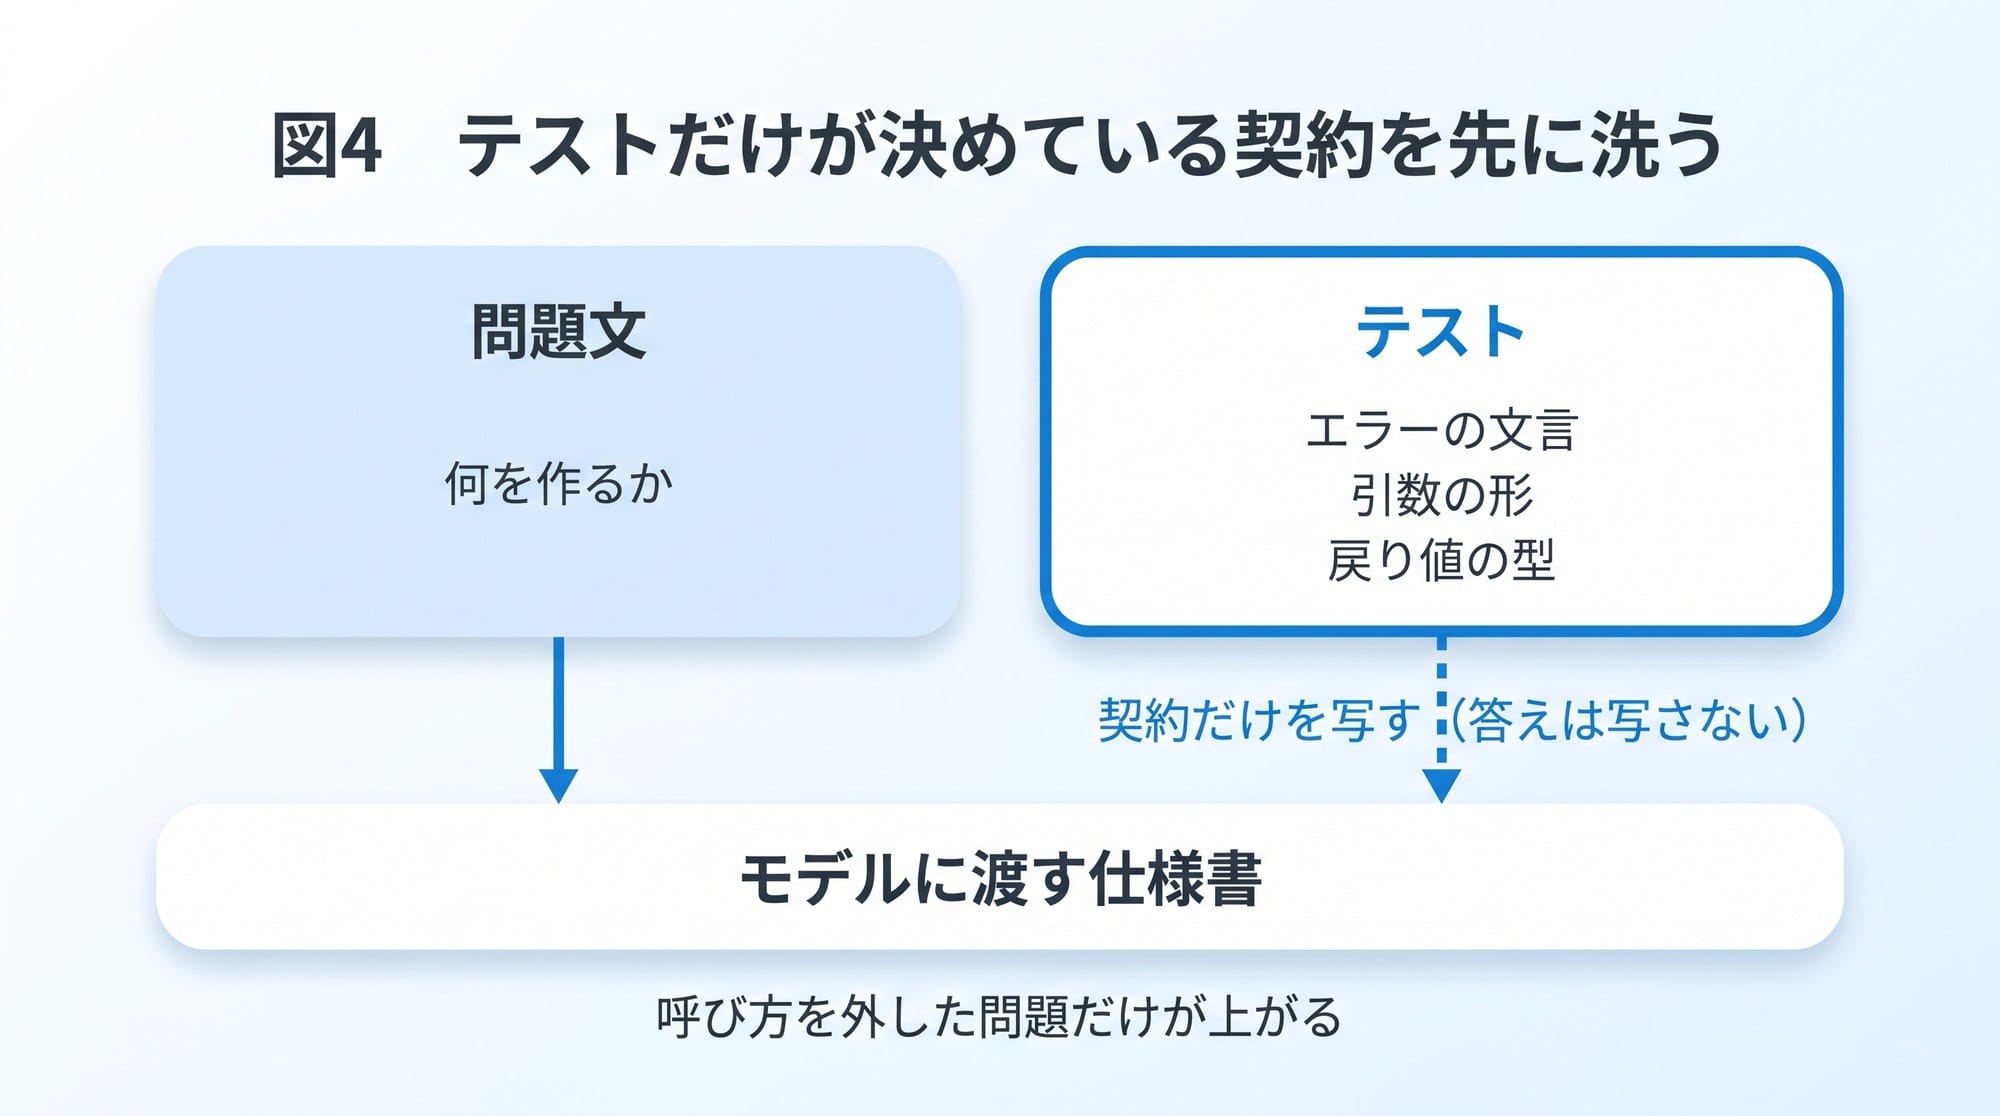
問題文にはなく、テストだけが決めている契約です。元のベンチマークは2回目の試行でテストの出力を見せますが、弊社のハーネスは1回勝負なので、契約を仕様書に添えることにしました。添えるのは、テストが照合するエラーの文言と、外部テストの最初の1件の原文です。1件だけなのは export 名・引数の形・戻り値の型を示すためで、その1件が通るだけでは点になりません。答えの集合は渡しません。
これは第2回の「答えは書かない」と矛盾しません。文言や引数の形は「呼び方」であって「答え」ではなく、状態コードを仕様に書くのと同じ種類です。効き方も「答え」とは違います。
| 条件 | 6問セットA | 6問セットB |
|---|---|---|
| 契約なし(Coder版) | 49.7 | 56.3 |
| エラー文言を添える | 57 | 61.9 |
| 呼び方の例も添える | 60.8 | 同上 |
| 本命の35B(契約あり、2本) | 88.7 / 93.8 | 78.5 / 86 |
上がったのは、呼び出し方が問題文から抜けていた問題だけです。0/95の問題は95/95になり、解き方が分からない問題はそのまま。契約を添えた課題は、モデルの差をそのまま点数に出します。
同じ形は、3万行の既存コードベースへの機能追加でも出ました。本命の35Bで77.1、75.3、77.1点。3本とも完走し既存テストを壊しませんが、落とす2割は全部「仕様書の文言を1字も違えず写す」部分でした。--format の既定値、メッセージの文言、Markdownのコードブロックの並び。テストだけが決めている契約の形です。
7. 対処は、入れる前に記録で数えます
評価を回していると、「こう直せば効くはず」という対処がいくつも思いつきます。弊社は途中から、入れる前に記録で回数を数えることにしました。
第3回で書いた検証の重さの対処で、第一候補は「モデル自身が同じターンでテストを走らせていたら、その結果を流用する」でした。もっともらしい。ところが記録で数えると、その形は8本で1回しかありませんでした。入れませんでした。効かない対処は、門を1つ増やすだけです。
逆に、入れた対処が効いているかも次のランで見ます。出力枠の拡張は、最初の実装が効いていませんでした。要求した出力枠と、実際に切れずに出たトークン数(10,175)を見て初めて分かりました。
そして、対処は次の対処の穴を作ります。「サーバの待ち受けを検知したら残したまま返す」対処は、サーバを起こすテストにも働いて、テストが「背景に残された」と誤認されました。門を1つ入れたら、次のランでその門が何を変えたかを確かめる。ハーネスに手を入れるたびに5種類×1本を回す、と決めたのはこのためです。1回2〜3時間で、5本の内訳を読むだけで次の穴が出ました。
まとめ。物差しを疑い続けないと、数字が嘘をつく
| やること | なぜ |
|---|---|
| 動くものを作らせ、採点器が別プロセスで起動して叩く | モデルの「完了」も自前テストも証拠にならない |
| 対照実験を最初にやる | 「ハーネスが壊れているか」「モデルが足りないか」を7分半で切り分けられる |
| 課題の種類を増やす | 同じモデルがWeb 0/背景処理 24/CLI 70/修正と追加 92〜97 |
| 合否の基準を先に決める(4指標、3本) | 「もう少し走らせる」を終わらせ、原因をハーネスかモデルかに分ける |
| 評価環境の前提を毎回確かめる | ポート衝突は点数に出ず、自律性だけを壊す |
| 内訳の0/0を警告にし、採点し直せる口を持つ | 「テスト0/0」が17本続いても点数の幅では見えない |
| 自作でない課題は、種で落ち参照実装で満点を確かめ、契約を洗う | 文言と型はテストだけが決めている |
| 対処は入れる前に数え、入れたら次のランで効きを見る | 8本で1回の形に門を足しても、門が1つ増えるだけ |
次回は最終回です。
この連載で書いてきた105件の欠陥は、すべて1本の追記専用のイベントログから見つけました。
記録の設計と、回帰テストの「通っている」を疑う話、片方のOSでしか見えない穴、そして依存0で作る理由を書きます。
それでは、また次回、お会いしましょう!
出典・参考
- SWE-bench(公式サイト)
- Vibe Code Bench(論文、arXiv)
- WebGen-Bench(Hugging Face のデータセット)
- Web-Bench(ByteDance、GitHub)
- Aider polyglot benchmark(Exercism の問題集、GitHub)