ゼロから作るコーディングエージェント【第4回】自走の規律は「人がいない場面」のためのもの。人がいるなら止まって聞く
評価ランで鍛えた「止まらない」規律を、人が答えられる場面にまで効かせていました。曖昧な指示に聞き返したモデルを押し戻して勝手に作らせる、断られた確認を形を変えて7回聞き直す、他人のプロセスの止め方を教える。6種類の使い方を演じて出た19件から、人がいる場面の設計と、設定の不備を1行で止める話を書きます。
こんにちは!
自作のコーディングエージェントが評価課題を安定して完走するようになった頃、初めて「人として」使ってみました。空のディレクトリで対話画面を開き、こう打ちました。
「なんか作って」
モデルの最初の応答は「何をお探しでしょうか?どのようなものを作りますか?」でした。これは正しい。曖昧な指示には聞き返すべきです。
ところが、ハーネスがそれを「何もしていない」と判定して押し戻し、モデルは勝手にPythonのWebアプリを作って「完了しました」と報告しました。私は何も答えていません。
結論から言うと、無人の評価ランで鍛えてきた「止まらない」規律は、すべて「答えられる人がいない場面」のためのものでした。人が画面の前にいて、答えられるなら、止まって聞くのが正しい。評価ランで鍛えた規律を、そのまま対話の場面にも効かせていたことが、6種類の使い方を演じたテストで19件の欠陥として出てきました。
この記事は連載「ゼロから作るコーディングエージェント」の第4回です。今回は「止まらない」の裏側、人がいる場面の設計を書きます。
| 回 | テーマ |
|---|---|
| 第1回 | 「最後までやりきる」が難しい理由。ターンを回す係と止める係を分ける |
| 第2回 | 完了は「作った」ではなく「動いた」で決める。完了の門と押し戻しの書き方 |
| 第3回 | 「止まらなかった」は「進んだ」ではない。空転を数え、思考は切らずに上限だけ置く |
| 第4回(今回) | 自走の規律は人がいない場面のもの。人がいるなら止まって聞く |
| 第5回 | ローカルLLMを一級市民にする。16GB×2でWebシステムを作らせるまで |
| 第6回 | 評価をどう作るか。動くものを作らせて自動採点し、採点器そのものを疑う |
| 第7回 | 記録と回帰。全部イベントログから見つかる。そして依存0で作る |
1. 評価ランで見つからない欠陥は、評価ランでは見つかりません
なぜこの欠陥群が、それまでの100本を超える評価ランで1件も出なかったのか。
評価ランは、仕様書を渡して無人で走らせ、成果物を採点します。曖昧な指示は渡さないし、確認を断る人もいないし、他人のプロセスがポートを掴んでいる状況も作りません。評価ランで出る欠陥は、評価ランの形でしか出ません。
弊社は1人で開発しているので、他の人に触ってもらうことができません。そこで、開発者が別の人格になって使うことにしました。6種類です。
| 人格 | 何をするか |
|---|---|
| 初めての人 | 空のディレクトリで「なんか作って」。Enterを3回連打。「ありがとう」 |
| せっかちな人 | 実行中に指示を2件積む。途中でEscで止める。「続けて」 |
| 保守担当 | 落ちているテストを「直して。commitはしないで」 |
| 慎重な人 | 実行の確認を毎回 n で断る。読み取り専用に切り替えて書き込みを頼む |
| Web画面の人 | ブラウザのタブを2つ開く。片方を閉じる。積んで、取り消して、止めて、質問に答える |
| 設定を間違える人 | APIキーが無い機で起動する。モデル名を打ち間違える。無い作業ディレクトリを指す |
1人格あたり1〜5分の台本を用意し、順に演じると、それぞれ2〜5件ずつ別の穴が出ました。この記事の残りは、その中身です。
2. 同じ場面でも、人がいるかで正解が変わります
2-1. 聞き返しは、人がいれば止めて聞く
冒頭の「なんか作って」の件です。
第1回に載せた擬似コードは、この人格テストで直した後の形です。直す前も、止めてよい理由の1つに「利用者の答えが要るとき」はありました。ところがその判定は、モデルが質問ツールを明示的に呼んだときだけ働くようになっていて、本文で聞き返しただけの応答は「何もしていない」に分類されていました。無人の評価ランではそれで正しい。「聞き返さずに仮定して進め」と押し戻すべき場面だからです。
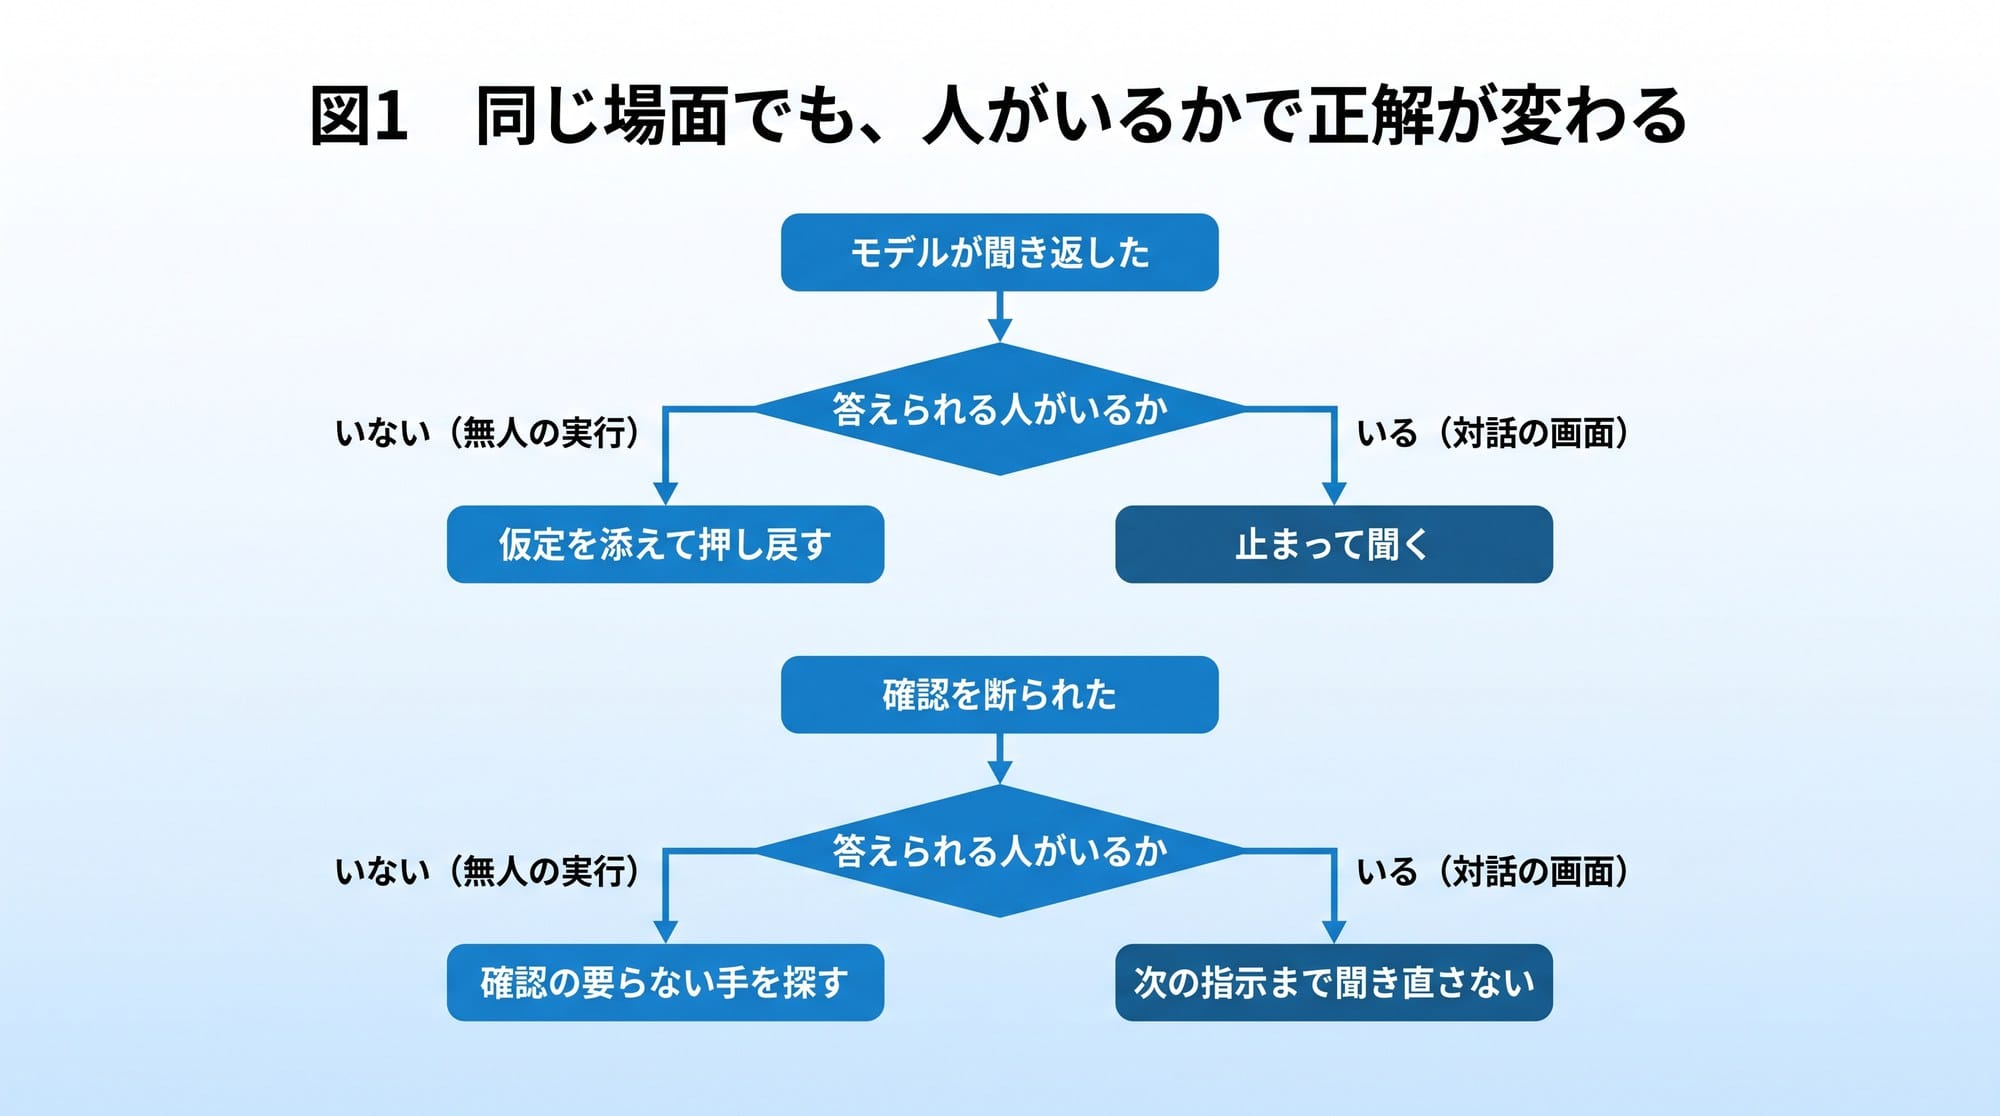
対話の画面では違います。答えられる人がいるなら、最初のターンの聞き返しはそのまま止めて、答えを待つ。人がいなければ「仮定して進め」を添えて押し戻す。同じ応答に対して、人がいるかどうかで判定を分けるようにしました。
2-2. 断られた確認は、次の指示まで聞き直さない
「慎重な人」の台本で、いちばん多くの欠陥が出ました。
実行の確認が要る設定で「テストを走らせて」と頼み、確認に n と答えます。断られた後、ハーネスの助言は「質問ツールで利用者に聞いてから取り直せ」でした。モデルは「standardプロファイルを使用する必要がありますか?」と、意味の通らない質問をしてきました。
助言を「断られたら聞き直すな。無しで進めるか、報告して止まれ」に直して再走すると、今度はモデルが形を変えて4回試しました。npm test を断られたら node --test、それも断られたら cd tests && node --test。そのたびに確認が出て、利用者は毎回止めることになります。
しかもそのとき、ハーネスは「同じ失敗を繰り返すな、原因を直せ」と押し戻していました。確認を断られたことを「直すべき失敗」に数えていたからです。モデルはそれを受けて、抜け道を探していた。ハーネスが抜け道探しを煽っていました。
直したのは3点です。利用者の方針による失敗(確認の拒否、権限の拒否)は継続の判定に数えない。断られた種類(実行や書き込みといった権限の種類)の確認は、利用者が次の指示を出すまで聞き直さず、自動的に失敗にする。そして、そのプロファイルでは自動検証も勝手にテストを回さない。
最後の1つは、実は利用者が n と断った直後に、ハーネスの自動検証が同じ npm test を勝手に走らせていた、という欠陥でした。利用者の意思をモデルには伝えて、自分では守っていなかったわけです。実行の権限が「許可」でなければ、自動検証は構文検査だけにしました。
4周目の再走では、確認は1回だけ出て、以後の試み5回は自動的に失敗し、利用者には聞かれませんでした。
2-3. 「聞き直さない」の鍵は「同じターン」では足りませんでした
細かい話ですが、ここで1つ、測った数字を書きます。
「断られた種類の確認は聞き直さない」を最初は「同じターンの中では」と実装しました。大きなモデルは1ターンに複数のツールを呼ぶので、それで足りると考えたからです。ところが1ターンに1ツールしか呼ばない小さなモデルは、別のターンで7回聞き直し、そのまま40ターンの上限まで走りました。
鍵を「利用者の次の指示まで」に変えて収まりました。小さなモデルで確かめたから見えた穴です。
3. 「誰が起こしたプロセスか」を、モデルに判断させません
「せっかちな人」の台本で、別の種類の欠陥が出ました。
モデルがサーバを3000番で起動しようとして、ポートが使われていた(EADDRINUSE)場面です。そのポートは、この実行とは無関係な別のアプリが掴んでいました。ハーネスの助言はこうでした。
「この実行で起こしたプロセスなら止めろ。止め方は taskkill /PID <番号>」
判断をモデルに委ねていて、しかも止め方まで示していました。今回はモデルが自分の起こしたプロセスだけを止めたので無事でしたが、他人のアプリを止めていた可能性は十分にあります。
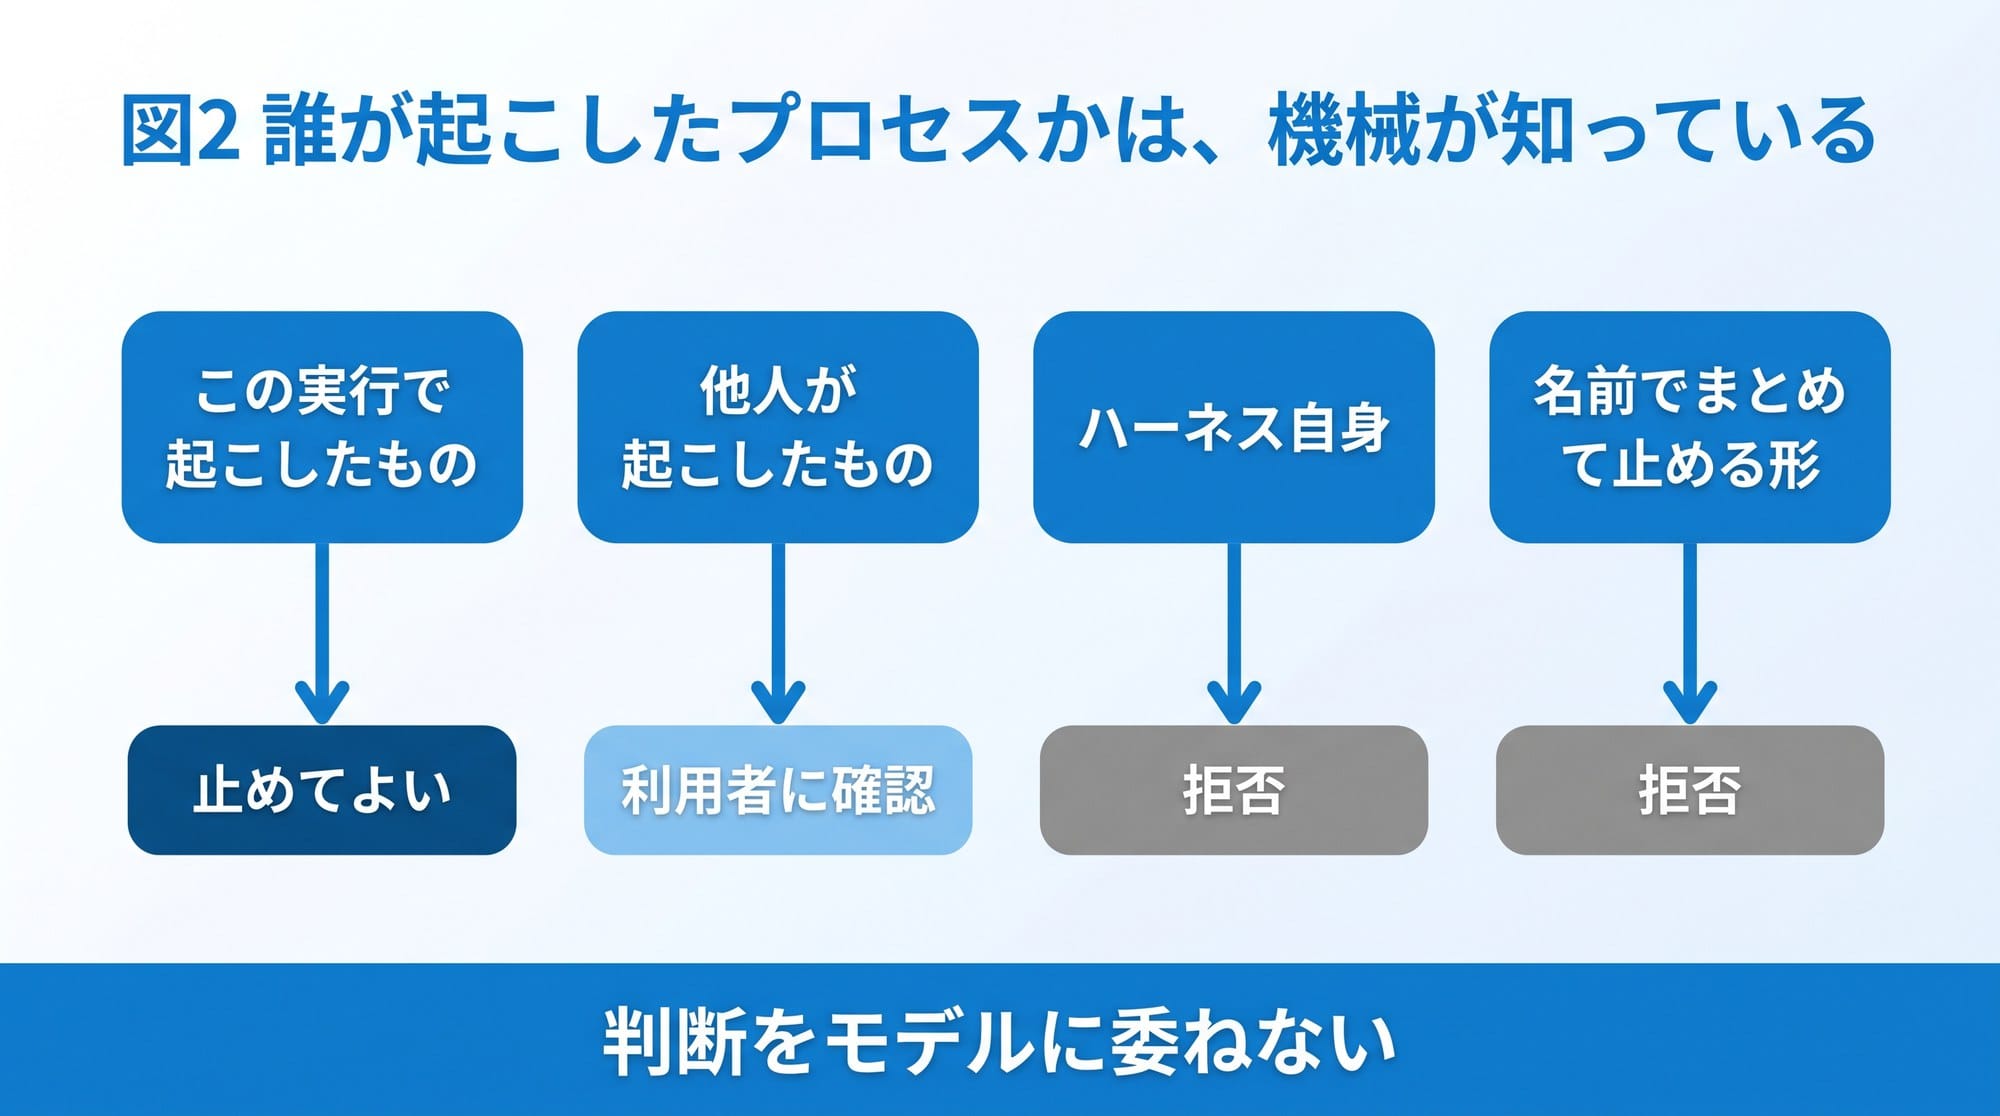
ここで気づいたのは、ハーネスは「誰が起こしたか」を知っているということです。自分が起こしたプロセスはPIDを覚えている。だから判断はモデルにさせず、機械的に分けられます。
この実行で起こしたものは止めてよい。他人が起こしたものは利用者に確認へ回す(無人なら失敗にして別のポートを助言する)。ハーネス自身のプロセスは拒否。そして、名前でまとめて止める形(taskkill /IM node.exe、pkill node)は、引数を見ずに形そのもので拒否します。
最後の1つには前史があります。評価ランで、モデルが Get-Process -Name node | Stop-Process を実行し、ハーネス自身が止まってランが消えたことがありました。「止めるコマンドの引数」を見るだけでは、パイプラインで集めてから止める形を止められません。「名前で集めてから止める形」全体を見る必要がありました。
後始末も同じ考えで直しました。対話を終えるとき、モデルが起こして残していたサーバを止める。あるとき機に3つのサーバが残っていて、評価ランでは評価装置が止めていたので見えていなかった欠陥でした。さらに npm run web & のような連鎖(cmd → node → cmd → node)は混雑した機で子孫の列挙が間に合わず途中が残るので、「その間に生まれて親を失ったもの」もまとめて止めるようにしました。
4. 背景に起こしたものは、「起きた」と伝えます
大きなモデルで同じ台本を回すと、対話の骨組み(積む、中断、続きから、拒否、掃除、記録)は崩れませんでした。代わりに1つ、別の摩擦が出ました。
モデルが node server.js & でサーバを背景に起こすと、シェルは即座に終わります。モデルに返るのは「exit code: 0」と空の出力だけ。動いたのか分からない。モデルは同じ起動を5通り(&、start /b の2つの形、ログへのリダイレクトつき、PowerShellの Start-Process)試し、そのうち2つは120秒のタイムアウトに当たり、「このシェルでは & が機能しない」と結論づけて約4分溶かしました。
ハーネスは背景の子プロセスを引き取ってPIDを覚えていました。覚えているのに、モデルには黙っていた。背景に回したと分かる書き方のときは「背景で起動した(pid n)。同じ起動を繰り返すな。別のコマンドで確かめて、済んだら止めろ」を結果に添えるようにしました。
これは評価ランでは見えにくい形でした。評価ランでは前景で起動して待ち受けを検知する経路が主で、人が「テストも書いて」と頼んで自分でサーバを起こさせる場面で初めて数が出ました。
5. 設定の不備は、スタックトレースではなく1行と次の一手
「設定を間違える人」の台本は、いちばん地味で、いちばん最初に利用者が踏むところです。
APIキーが無い機で起動する。モデル名を打ち間違えて404を受ける。接続先が落ちていて接続できない。無い作業ディレクトリを指す。
最初の版はどれもスタックトレースを出して止まりました。しかも404や401は「一時的な失敗」と同じ扱いで5回送り直し、そのあと遮断器が働いて止まる。利用者から見ると、何が悪いのか分からないまま数十秒待たされます。
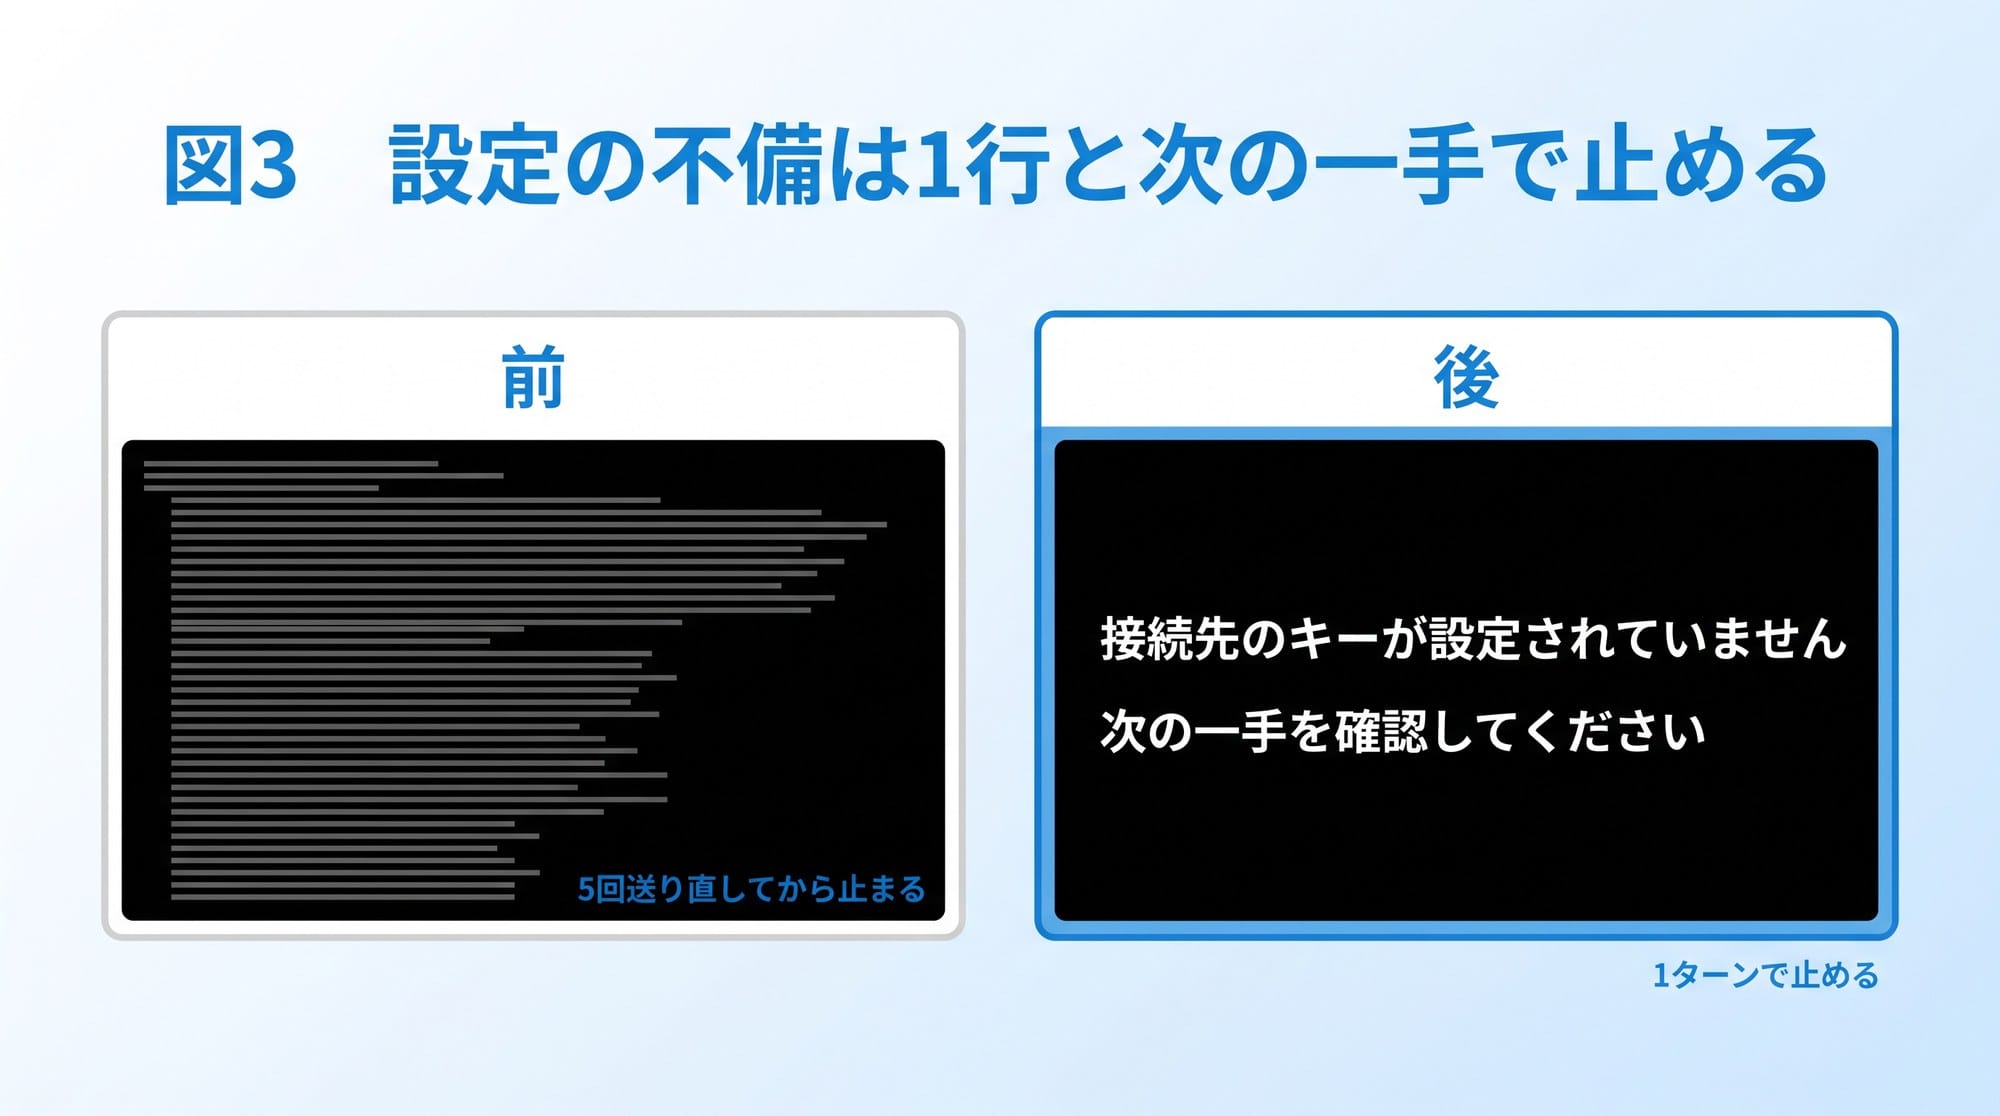
キーが無い401や403、モデル名が違う404、設定値の誤りによる400は、送り直しても通りません。1ターンで止めて、理由を1行と、次の一手(設定の確認コマンド)で報告する。第3回で書いたコンテキスト超過の400は別で、こちらは圧縮して送り直します。接続先が一時的に落ちているだけなら、第1回のとおり再試行の上限まで試してから止めます。終了コードも「利用者が直す種類の失敗」として別の値にしました。
もう1つ、記録を読むだけの操作(過去のセッションの一覧や集計)が、モデル接続の設定を要求していました。読むだけの操作がエージェント全体を組み立てていたからです。読むだけなら記録の係だけを組み立てる。そういう小さな分解でも、キーの無い機で記録を読めるかどうかが変わります。
6. 6種類を演じて、19件
人格テストで見つけて直した欠陥は19件でした。表に並べると、その多くが「評価ランの規律をそのまま対話に効かせていた」形に分類できます。
| 人格 | 件数 | 出た欠陥(要旨) |
|---|---|---|
| 初めての人 | 2 | 聞き返しを押し戻して勝手に作る。「ありがとう」への返答に前のランの検証結果を持ち出す。別の言語で返答する(モデル) |
| せっかちな人 | 4 | 積んだ指示の表示が2行出る。他人のプロセスの止め方を示す。背景起動が「exit 0」だけ返す。終わるときに残したサーバを止めない |
| 保守担当 | 2 | 頼んでいないまとめファイルを作る。作業用ディレクトリが git status に出る |
| 慎重な人 | 4 | 断られた後に聞き直す。形を変えて7回聞き直す。拒否を失敗に数えて押し戻す。自動検証が勝手にテストを回す |
| Web画面の人 | 2 | セッションが1件も保存されていない。TODOの引数の形が違うと12回失敗する |
| 設定を間違える人 | 5 | スタックトレース。記録を読むだけでキーを要求する。404を5回送り直す |
いま、このエージェントは、曖昧な指示には聞き返して止まります。実行中の指示は積んで次のターンで取り込みます。Escで思考の途中でも止まって、次の指示で続きから動きます。確認を断られたら聞き直しません。他人のプロセスは止めません。設定の不備は1行で止まります。終わるときに残したサーバを止めます。
どれも、評価課題の点数には1点も出ません。
まとめ。「止まらない」と「止まって聞く」は同じ係が決める
| 場面 | 人がいない(無人の実行) | 人がいる(対話の画面) |
|---|---|---|
| モデルが聞き返した | 仮定を添えて押し戻す | 止めて聞く |
| 確認を断られた | 確認の要らない手を探す | 次の指示まで同じ種類の確認は聞き直さない |
| 他人のプロセスがポートを掴んでいる | 失敗にして別のポートを助言 | 利用者に確認へ回す |
| 実行の権限が確認つき | (無人では許可を明示する) | 自動検証は構文検査だけ |
| 設定の不備 | 1行と次の一手で止める | 同じ |
第1回で書いた「止めてよいか決める係」は、「止まらない」ためだけの係ではありませんでした。人がいるかどうかを入力に取って、同じ場面で逆の判定を返す係です。
次回は、この連載の実験をすべて支えているローカルLLMの話です。16GBのカード2枚でWebシステムを丸ごと作らせるまでに、モデルの癖、量子化の劣化、GPUメモリ、壊れたツール呼び出しの直し方をどう扱ったか。測った数字の表を並べて書きます。
それでは、また次回、お会いしましょう!