ゼロから作るコーディングエージェント【第3回】「止まらなかった」は「進んだ」ではない。空転を数え、思考は切らずに上限だけ置く
300ターン走ってAPIが0本。「モデルの限界」と結論を書いた翌日、記録を読み直すと234ターンがツールを1度も呼んでいませんでした。空転率という指標、1つ塞ぐと次の形に移る空転、思考をオフにすると95点が71点に落ちて時間も縮まなかった話、出力枠を広げたら反対側を数える話を書きます。
こんにちは!
自作のコーディングエージェントにローカルLLMを載せて、認証つきのWebシステムを作らせていた頃の話です。
小型のオープンモデルで、最後(ねらったゴール)までコーディングをさせるために、エージェントハーネスを鍛えた記録となります。
2つのモデルで走らせて、どちらも300ターンの上限まで走り、仕様のAPIは0本でした。
そのとき私は記録にこう書きました。
「ここから先はモデルの実装能力の問題」。
翌日、イベントログを別の切り口で集計し直して、この結論を撤回しました。
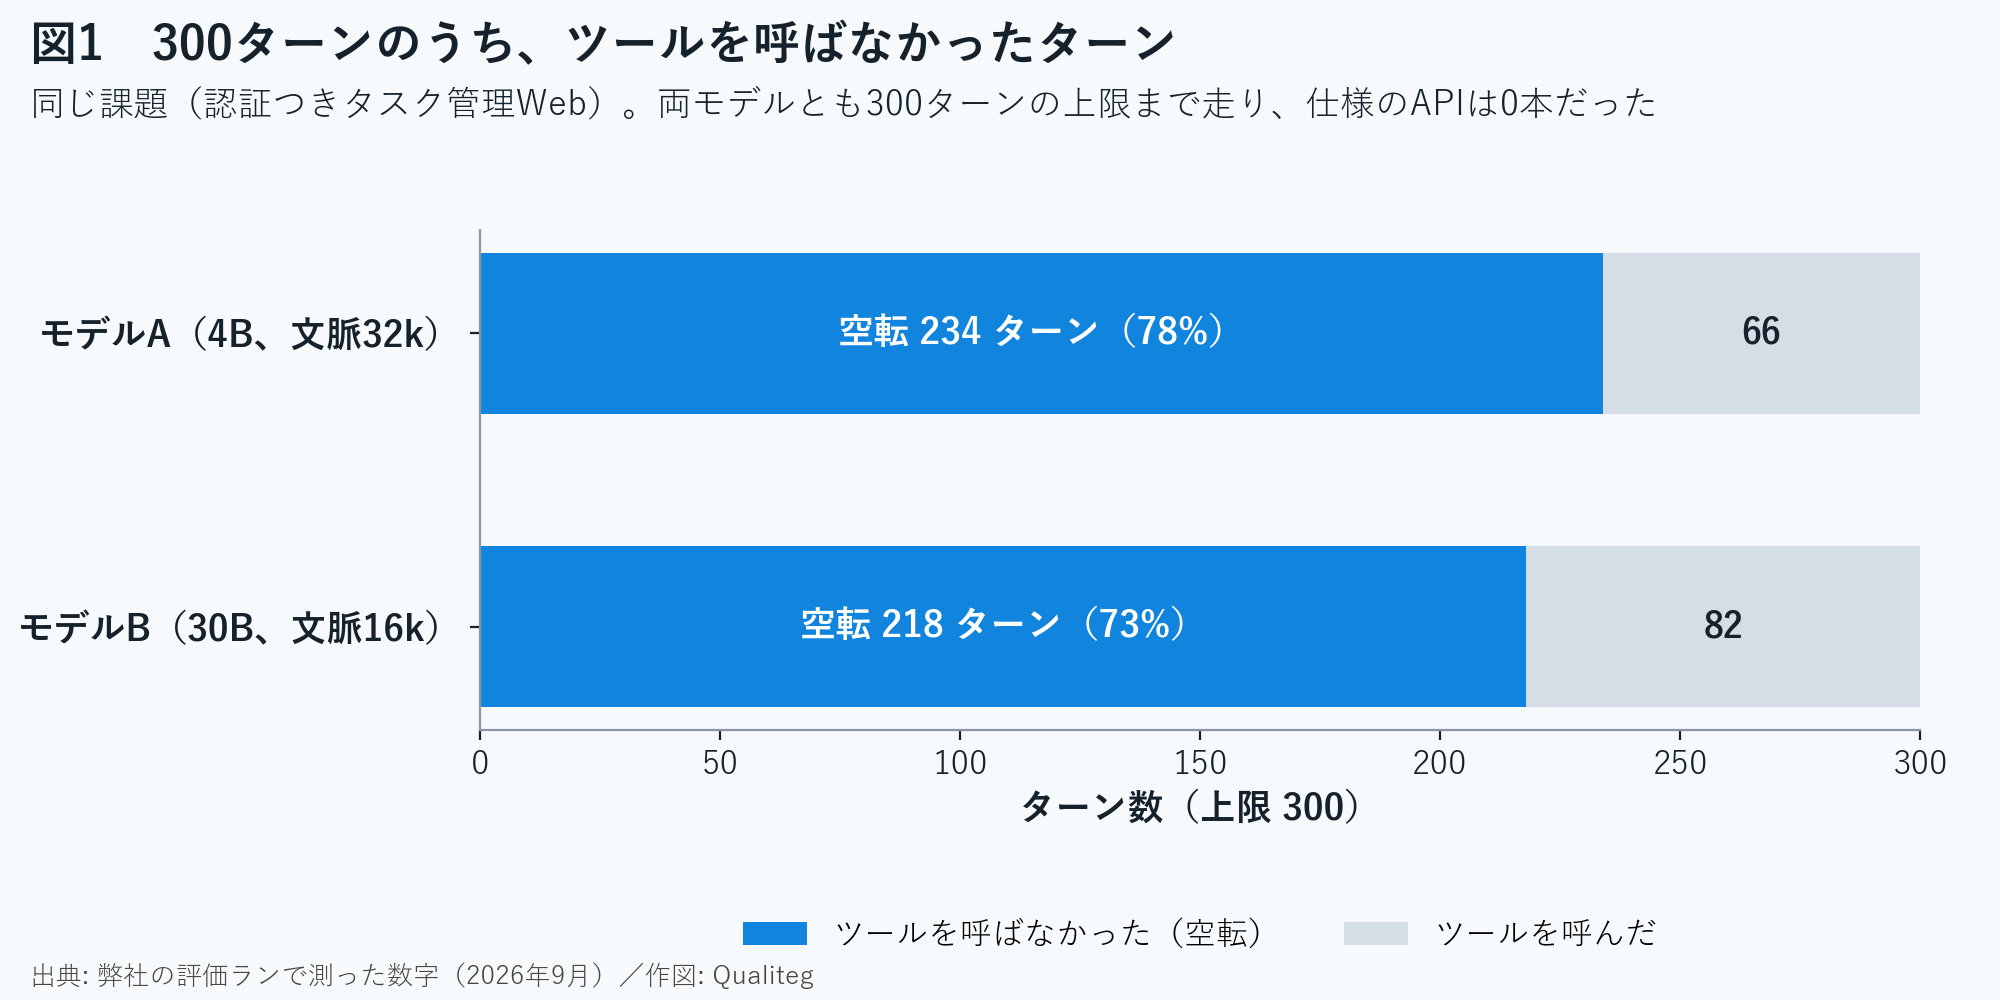
300ターンのうち、ツールを1度も呼んでいないターンが234ターン(78%)あったのです。
もう1つのモデルは218ターン(73%)でした。走っていたのではなく、止まれずに回っていただけです。
結論から言うと、
コーディングエージェントの自律性を測るとき、ターン数は指標になりません。
「止まらなかった」と「進んだ」はまったく別のことで、見るべきは「ツールを呼ばなかったターンの割合」、弊社が空転率と呼んでいる数字です。
この記事では、空転を数え始めてから見えたこと、そして思考(reasoning)を切らずに上限だけ置くことにした経緯を、数字つきで書きます。
この記事は連載「ゼロから作るコーディングエージェント」の第3回です。
第1回で「ターンを回す係と止める係を分ける」、
第2回で「完了の門」を書きました。
今回は、門を通ってもなお「進んでいない」ランをどう見つけるかの話です。
| 回 | テーマ |
|---|---|
| 第1回 | 「最後までやりきる」が難しい理由。ターンを回す係と止める係を分ける |
| 第2回 | 完了は「作った」ではなく「動いた」で決める。完了の門と押し戻しの書き方 |
| 第3回(今回) | 「止まらなかった」は「進んだ」ではない。空転を数え、思考は切らずに上限だけ置く |
| 第4回 | 自走の規律は人がいない場面のもの。人がいるなら止まって聞く |
| 第5回 | ローカルLLMを一級市民にする。16GB×2でWebシステムを作らせるまで |
| 第6回 | 評価をどう作るか。動くものを作らせて自動採点し、採点器そのものを疑う |
| 第7回 | 記録と回帰。全部イベントログから見つかる。そして依存0で作る |
1. 空転を数えると、原因がモデルごとに違って見えました
ちょっと、ここで細かい話をかきます。
234ターンと218ターン。数字は似ていますが、中身はまったく別でした。
218ターンのほうは、コンテキストの超過でした。
ハーネスは送信前に「このまま送ると枠を超える」と検知して記録していたのですが、そのまま送信していました。
コメントには「見積もりのずれで400を食わないための最後の砦」と書いてあるのに、実際には何も止めていない。モデルから400が返ってターンを1つ失い、圧縮は次のターンの頭で走る。しかも圧縮しても超過が解けないケースがあり、直近30件を圧縮対象から外す作りだったので、大きなツール出力が続くとその30件だけで枠を超えていました。73回圧縮しながら218回超過していた理由がこれです。
234ターンのほうは、同じ応答の反復でした。
64ターン目に「すべての要件が満たされており、テストも成功しています」と述べたあと、以降まったく同じ文言が返り続けていました。第1回で書いたとおり、押し戻しの送信を止めたために、履歴には同じ応答が追加されるだけで、モデルを次の行動へ押す新しい情報が加わらなくなっていた。新しい情報を与えていないのだから、同じ出力が返ってきやすいのは当然でした。
どちらも、点数の表を見ているだけでは「300ターン使ってAPI 0本」としか見えません。空転を数えて初めて、2つの別の穴が見えました。
ここから、弊社は1つの決まりを置きました。
空転が30%を超えるランの低得点を、モデルの能力のせいにしない。
あるモデルの4bit量子化版が「Let me create files are files as files are files...」と同じ語の繰り返しに崩れて空転33%になったことがあります。能力不足に見えますが、原因は量子化と長い出力の相性でした。
2. 空転の形は、1つ塞ぐと次の形に移ります
空転を数え始めると、次に「どんな形で空転しているか」が見えてきます。そして塞ぐたびに、別の形が出てきました。
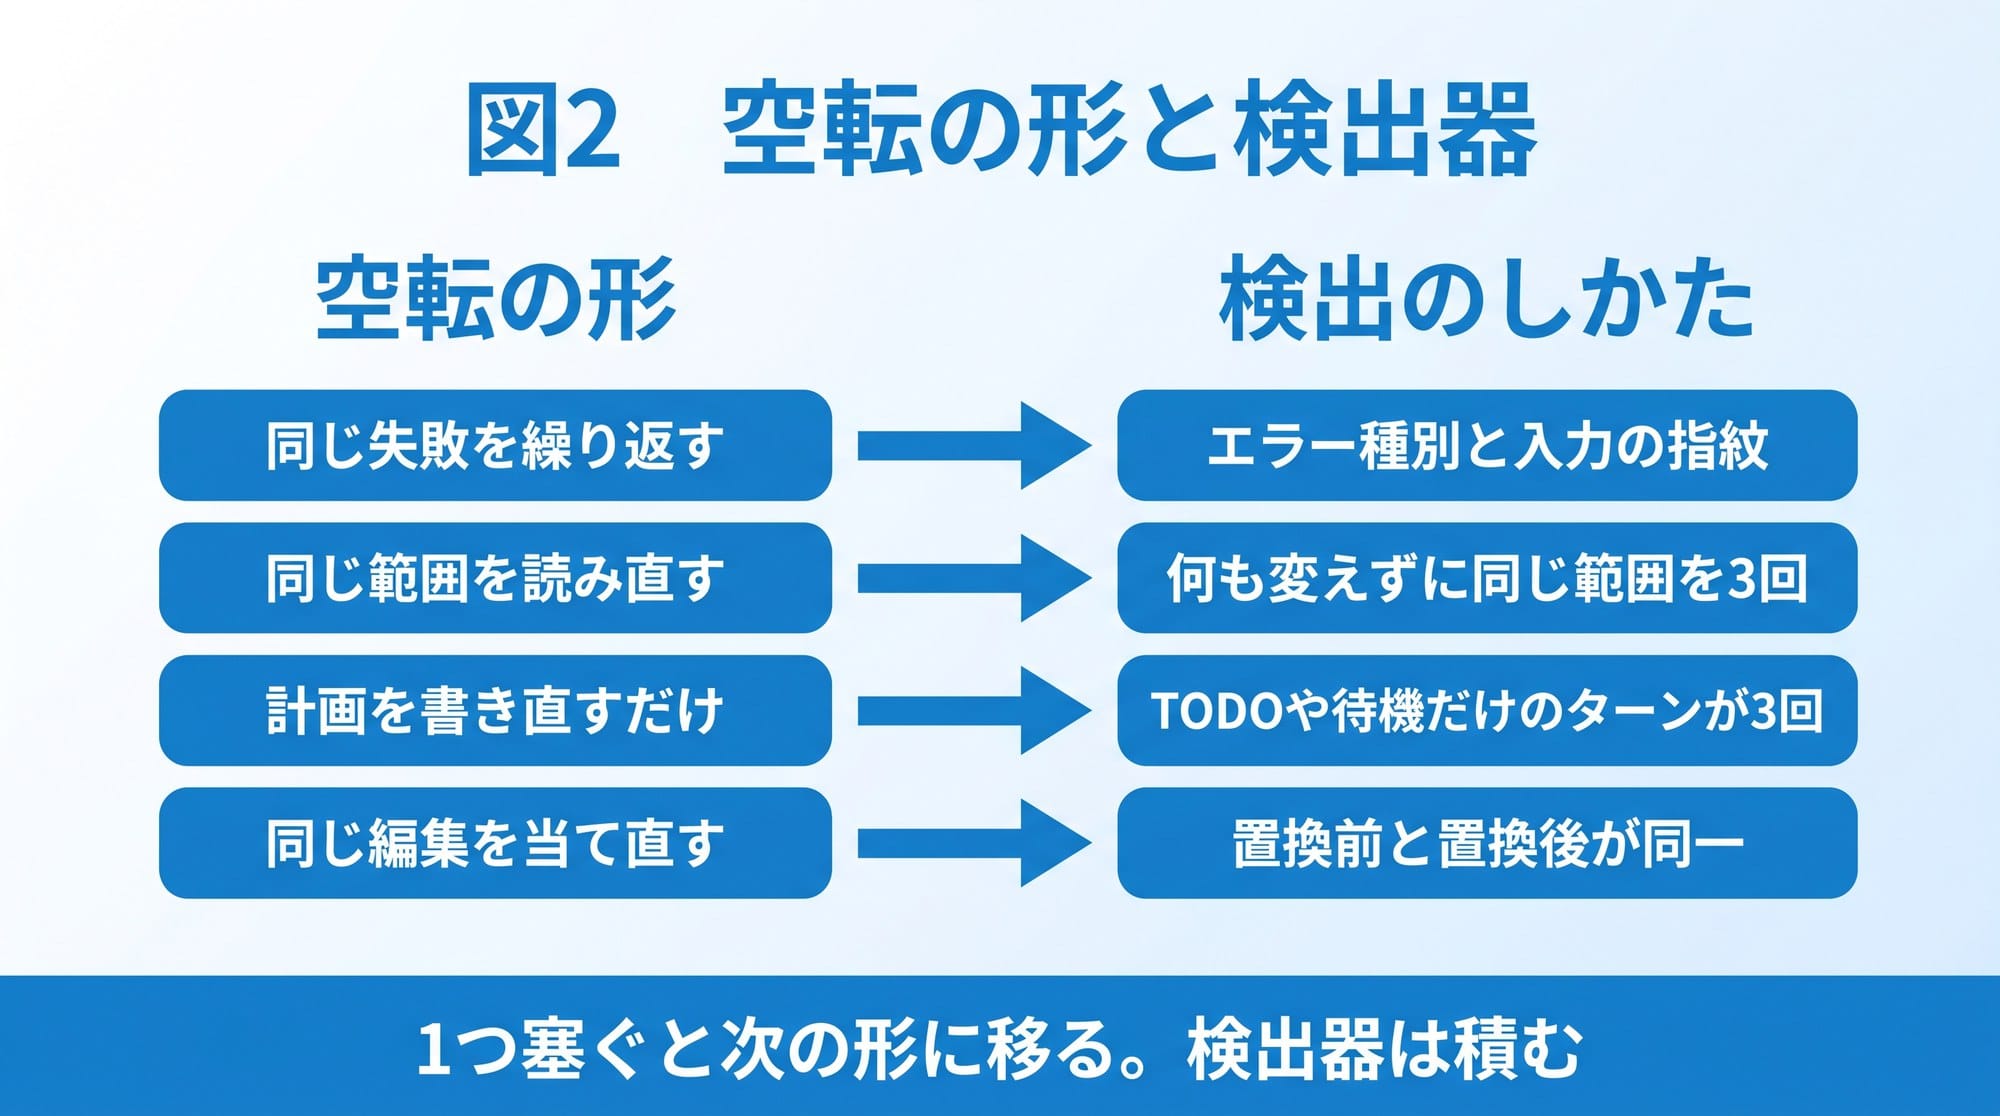
いちばん大きかったのは読み直しです。あるランではツール呼び出しの65〜77%がファイルの読み取りで、同じファイルの同じ範囲を168回読んでいました。
形は「読む → 構文検査 → 読む → 構文検査」の繰り返しで、間に編集がありません。読むたびに成功するので「同じ失敗の繰り返し」には映らず、何が起きているかを言い当てる指標がありませんでした。
なぜ循環するのか。同じ範囲の読み取り結果が文脈の窓に何度も入ると、窓が同じ内容の複製で埋まります。トークンが早く尽きて圧縮が走り、古い読み取りが落ちる。落ちたのでまた読む。
読み直しが圧縮を呼び、圧縮が読み直しを呼ぶ。
対処は、同じ範囲の読み取りはモデルに渡す文脈では最新1件だけ本文を残し、古いほうは「後の読み取りに置き換えられた」と1行にすること。そして、何も変えずに同じ範囲を3回読んだら押し戻すことでした。
読み直しを塞ぐと、次はTODOの書き直しでした。
同じTODOを11ターン連続で保存し直し、1行も編集しない区間が出ました。これも「TODOや待機や再検証だけのターンが3回続いたら押し戻す」で塞ぎました。
その次は、既に入っている編集の当て直し。置換前と置換後が同じで、ファイルにはもう置換後の文字列がある。「その編集は既に入っている。読み直して次へ」と返すようにしました。
ここで1つ注意があります。「同じ失敗を繰り返している」の判定は、エラーの中身まで含めて同じかで見る必要があります。「終了コードが0でない」だけで数えると、別の原因で前進しているものまで「同じ失敗」に見えて、押し戻しが邪魔になります。
文脈を管理する機構が、文脈を食っていました
読み直しの話には、もう1つ教訓があります。弊社はこの穴に3回落ちました。
1回目は第1回で書いた、押し戻しが111回積み上がって枠を食い潰した件。2回目は圧縮の要約そのものが積み上がり、70本、約30,500文字で枠を超えた件。3回目がこの読み取りの複製です。
3回とも、文脈を管理するために作った仕組みが文脈を食っていました。対処の型は同じで、ログは無傷のまま、モデルに渡す文脈だけを間引く。押し戻しは履歴に残さない。要約は1本に統合する。同じ読み取りは1件に畳む。記録と、モデルに見せるものを分ける。この型は第7回のイベントログの話につながります。
3. ばらついているのは「経路」で、「結果」ではありません
空転を潰したあと、同じ課題を同じモデルで3本走らせると、こうなりました。
| 本 | ターン | 実時間 | 得点 |
|---|---|---|---|
| 1本目 | 121 | 73分 | 94.9 |
| 2本目 | 40 | 17分 | 93.8 |
| 3本目 | 144 | 87分 | 96.5 |
ターン数は3倍以上ばらついています。得点は、3本の平均(95.1)から±1.5以内に収まっています。
同じことは、ハーネスをさらに直した後の別の3本でも起きました。ターンは73、263、134とばらつき、得点は99.2、94.4、93.2でした。263ターンの1本は空転ではなく、自分の書いたテストの失敗を直し続けた形で、ハーネス側の時間は4%です。
ばらついているのは経路であって、結果ではない。
これが分かったので、弊社の評価では
同じ課題を3本走らせて、3本の得点がその平均から±5以内に収まるか」
を合否の指標に入れました。ターン数の幅は指標に入れていません。1本だけ見て「このモデルは遅い」「速い」と言うのは、経路の偶然を見ているだけです。
4. 思考をオフにすると、95点が71点になって、時間も縮まりませんでした
空転の話と隣り合っているのが、思考(reasoning)の扱いです。
弊社の本命のローカルモデルは、応答の前に思考を出す型のモデルで、1ターン25〜36秒かかります。思考を切れば速くなるはずだと考えて、思考オフで1本走らせました。
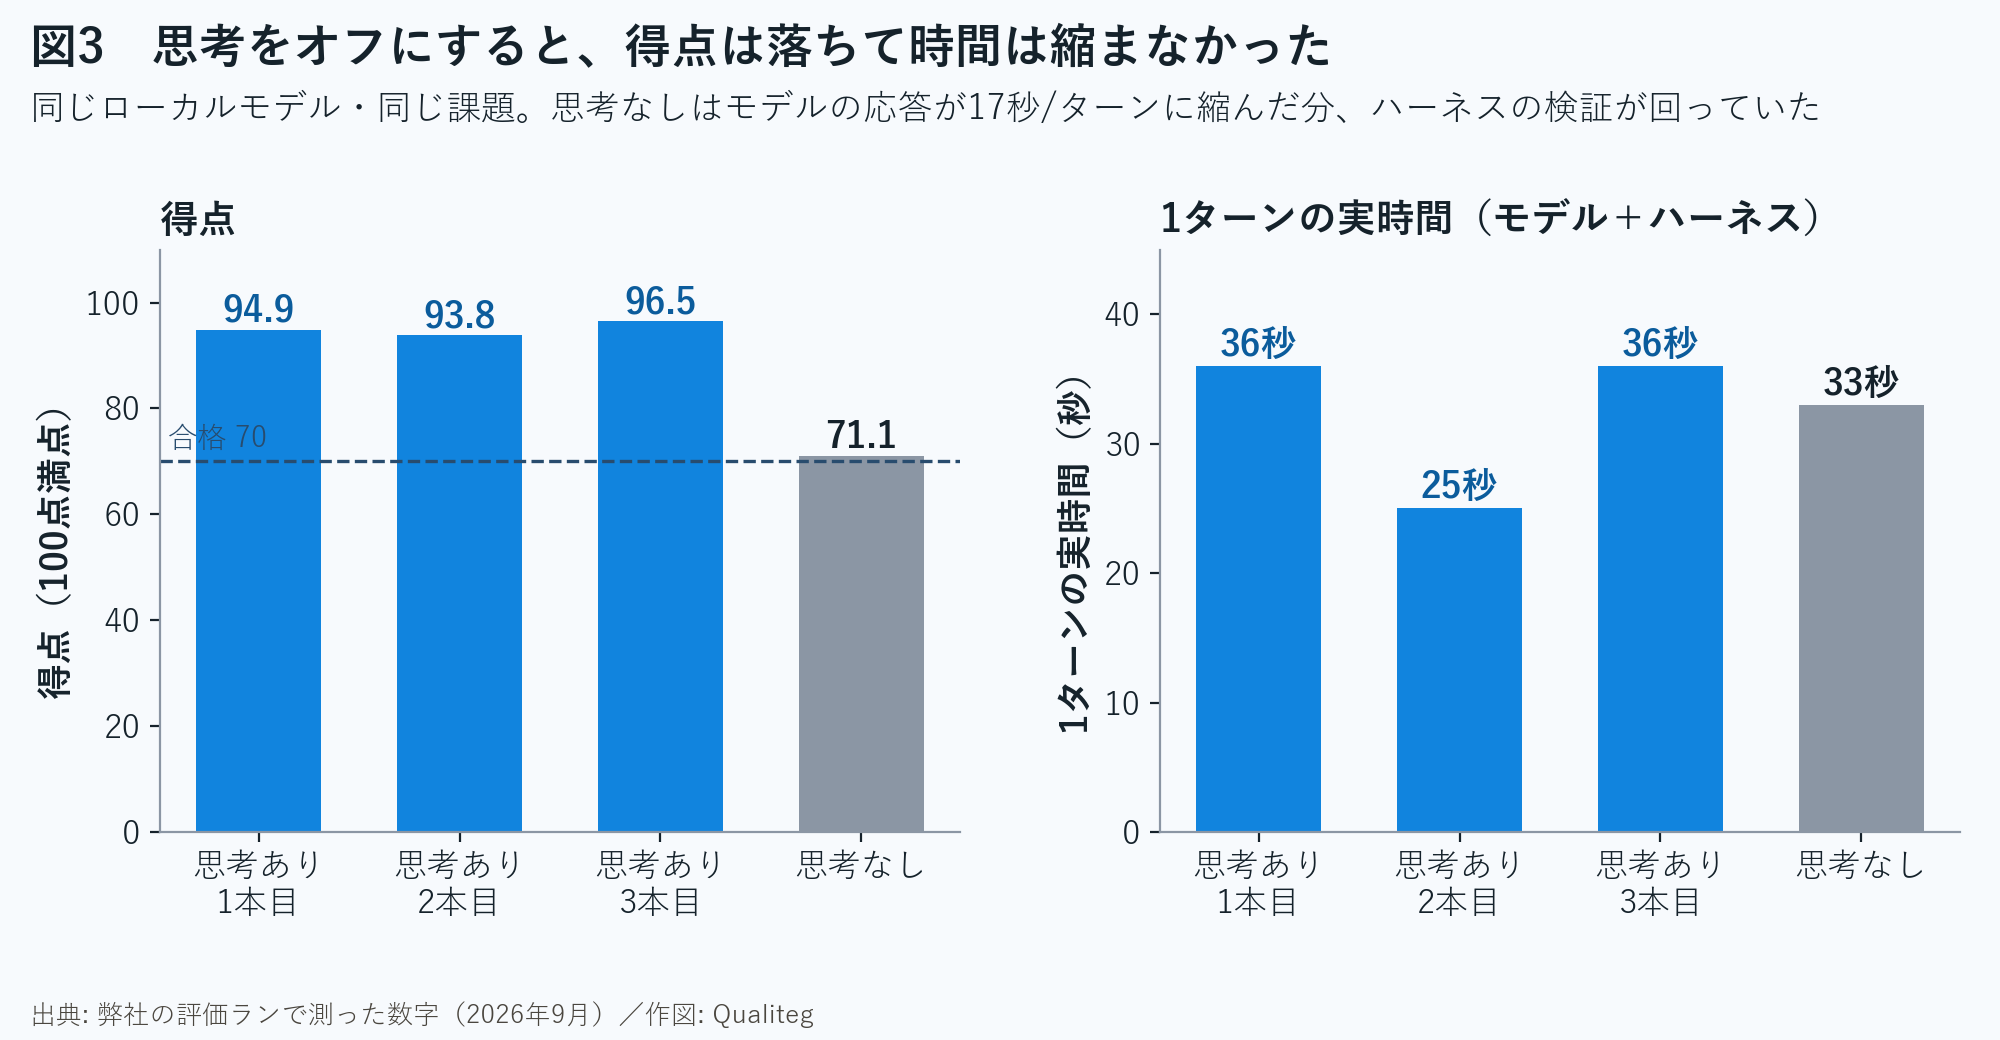
| 条件 | 得点 | ターン | 実時間 | モデルの応答 | 1ターンの実時間 |
|---|---|---|---|---|---|
| 思考あり(3本) | 94.9 / 93.8 / 96.5 | 121 / 40 / 144 | 73 / 17 / 87分 | 25〜36秒/ターン | 25〜36秒 |
| 思考なし(1本) | 71.1 | 63 | 34分 | 17秒/ターン | 33秒 |
モデルの応答は17秒/ターンまで縮みました。ところが1ターンの実時間は33秒で、思考ありと変わりませんでした。差の大半はハーネスの自動検証で、63ターン中58回テストを回し、そのうち24回は読むだけ、TODOだけのターンの後でした。モデルが速くなった分、検証が回っていただけです。
そして得点は95から71に落ちました。仕様の「JSONを返すAPI」と「フォームを受けるページ」を分けずに1つの処理で済ませ、302を返したまま「完了」と報告していました。思考ありの3本ではこの取り違えは出ていません。
思考は速度ではなく、仕様の読み取りに効いていました。既定は思考ありのまま変えていません。
5. ただし、思考には上限が要ります
思考を切らないと決めたあと、逆の穴が出ました。
出力枠を8192から16384に広げたときです。
広げた理由は後で書きますが、広げた結果、思考だけで16384トークンまで走って切れるターンが1本に4回出ました。
1回あたり約7分。そのランは66.2点で130分かかりました。切れたターンではツールを1つも呼べないので、押し戻しの往復が1回余計に要ります。
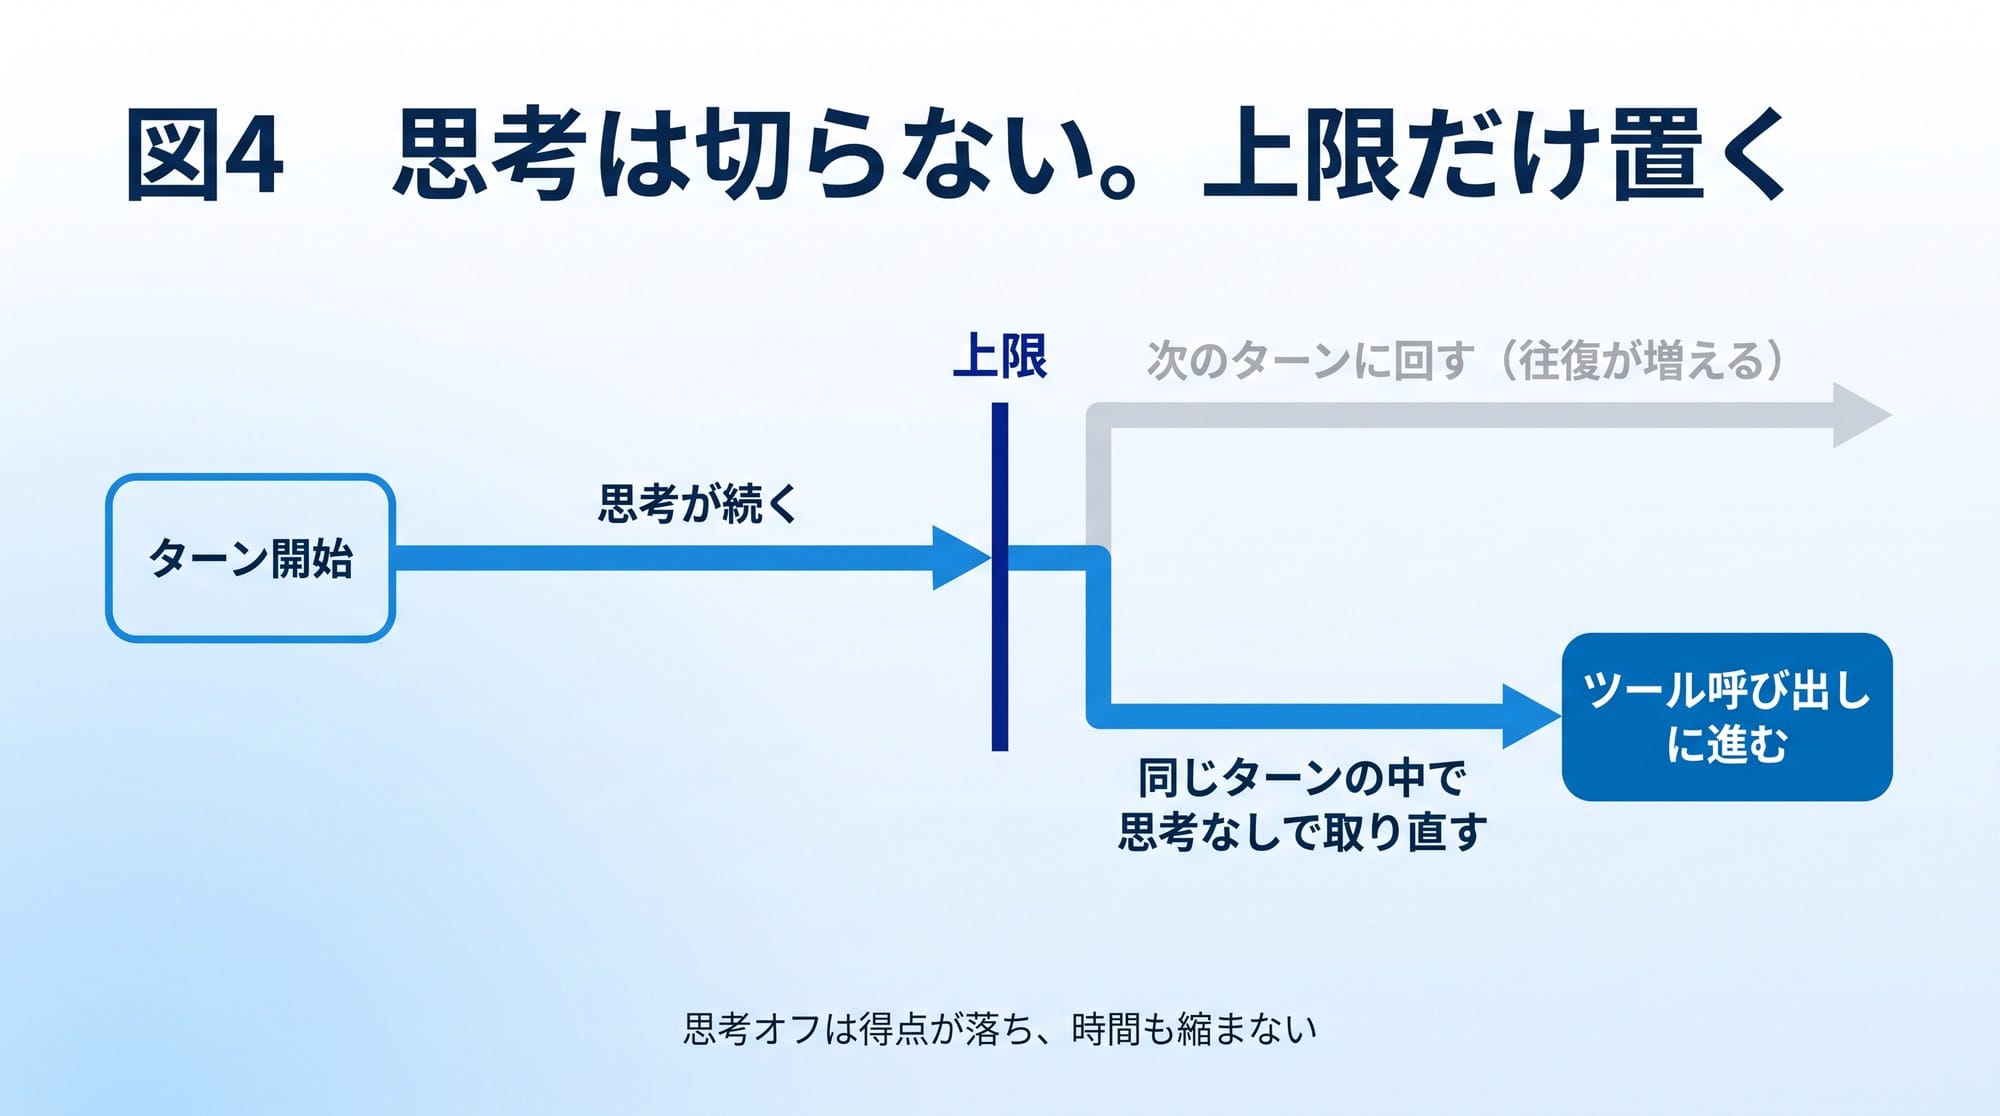
対処は、思考だけで8192トークン相当を超え、本文もツール呼び出しも始まっていなければ、そのストリームを打ち切って同じターンの中で思考なしで取り直すことでした。ターンの番号は進めません。モデルへの問い合わせは2回になりますが、この連載のターン数では1ターンと数えています。同じ課題が83.8点、31分に戻りました。
「同じターンの中で」が要点です。最初は「次のターンで思考を切る」と実装していましたが、それだと、切れたターンと、押し戻しを添えた取り直しで2ターン使います。同じターンの中で取り直せば1ターンで済み、押し戻しも要りません。
6. 出力枠を広げたら、反対側を数えます
出力枠を16384に広げた理由は、39KBのファイルを1回で書けるようにするためでした。8192では27KBの一括書き込みが途中で切られ、分割に誘導する必要があったからです。
広げると、確かに39KBが1回で入りました。代わりに2つのことが起きました。
1つは先ほどの思考の暴走。もう1つは、圧縮が60ターン台から27ターン目に早まったことです。
原因を追うと、ツールの結果(tool_result)は古くなれば間引いていたのに、ツール呼び出しの引数(tool_use、つまり書き込んだファイルの本文)は誰も間引いていませんでした。39KBの書き込みが履歴に残り続け、入力が1ターンで8〜10kトークン増えていました。直近20件より古い、1000文字を超える書き込みは本文を落として「このファイルにこの大きさを書いた」という形だけ渡すようにして収まりました。
枠を広げた対処は、反対側(入力と時間)の消費を必ず数える。この教訓は他にも効きました。コンテキスト超過のエラーは「プロバイダの障害」ではなく「こちらの入力が大きすぎた」ので、再試行ではなく圧縮してから送り直す。同じ400でも扱いが違います。
7. 時間の内訳を出すまで、全部「モデルが遅い」に見えていました
最後に、空転と同じ種類の話を1つ。実時間の内訳です。
あるランでは、実時間の45%がハーネスの自動検証でした。モデルが遅いのではなく、こちらがテストを回しすぎていた。内訳を出して初めて、原因が5つに分かれました。変更の無いターンでも回していた。書き込みのたびに回していた。読むだけのコマンドの後にも回していた。止まったテストを毎回120秒待っていた。そして、何も変えなかったコマンドの後にも回していた。
最後の1つは見つけるのに時間がかかりました。「サーバを起動する」「自作CLIを実行する」というコマンドは、文面からは「何かを変えうる」と読めます。しかしソースは1バイトも変わっていません。文面で推測するのをやめ、コマンドの前後でソースの指紋(サイズと更新時刻)を比べて、実際に変わったときだけ検証を回すようにしました。背景処理つきサーバの課題で、ハーネス側の時間が19%から4%に下がりました。
数字を分解できない改善は当てずっぽうになります。空転率も、時間の内訳も、集計の切り口を1つ足すたびに原因が1つ増えて見えました。
まとめ。ターン数ではなく、前進量を測る
| 見る数字 | 見方 |
|---|---|
| 空転率(ツールを呼ばなかったターンの割合) | 30%を超えたらハーネスを疑う。低得点をモデルのせいにしない |
| 読み取りの割合と、同じ範囲の最多読み取り回数 | 65〜77%、168回が出たら読み直しの循環 |
| TODO、待機、再検証だけのターンの連続 | 計画の書き直しで回っている形 |
| 同じ課題3本の得点 | 平均から±5以内に収まれば、ターン数のばらつきは経路の話 |
| 実時間の内訳(モデル/ツール/検証) | 検証が2割を超えたら引き金を数え直す |
| 思考 | 切らない。上限に当たったら同じターンで思考なしで取り直す |
| 出力枠 | 広げたら入力側の増分と圧縮の開始ターンを見る |
次回は、この「止まらない」規律の裏側です。
評価ランで鍛えた「止まらない」を、人が答えられる場面にまで効かせていた。曖昧な指示に聞き返したモデルを押し戻して勝手に作らせる、断られた確認を形を変えて7回聞かせる。6種類の使い方を演じて出た19件の話を書きます。
それでは、また次回、お会いしましょう!