
AIエージェント
Claude Fable 5.2 完全ガイド モデル仕様とAPI・Claude Code運用ポイント
Claude Fable 5.2の完全ガイド。Fable 5.1より20%安い料金と最大30%の高速化、独立評価の総合指数で上位3つを占めた性能、履歴の書き換えチェックなどAPI移行の要点、Claude Codeでの既定effortとFast modeまで解説。

AIエージェント
Claude Fable 5.2の完全ガイド。Fable 5.1より20%安い料金と最大30%の高速化、独立評価の総合指数で上位3つを占めた性能、履歴の書き換えチェックなどAPI移行の要点、Claude Codeでの既定effortとFast modeまで解説。

AIエージェント
採点器の「テスト」10点が3日間ずっと0/0でした。点数の表を見ているだけでは気づけません。仕様書を渡してWebシステムを作らせ、起動して叩いて採点する評価装置の作り方、5種類×3本の合否基準、対照実験を先にやる理由、自作でない課題で「テストだけが決めている契約」を先に洗う話を、測った数字で書きます。
AIエージェント
RTX A5000(24GB)1枚で始めて、ローカルモデル7種類が全滅。RTX A4000(16GB)2枚にQwen3.6-35B-A3BをAWQ 4bitで載せ、fp8のKVキャッシュと98kの文脈で、認証つきWebシステムを3本連続93.8〜96.5点で作らせるまでの構成と落とし穴。モデルの癖、量子化の劣化、文脈長、壊れたツール呼び出しの直し方を、測った数字で書きます。
AIエージェント
評価ランで鍛えた「止まらない」規律を、人が答えられる場面にまで効かせていました。曖昧な指示に聞き返したモデルを押し戻して勝手に作らせる、断られた確認を形を変えて7回聞き直す、他人のプロセスの止め方を教える。6種類の使い方を演じて出た19件から、人がいる場面の設計と、設定の不備を1行で止める話を書きます。
LLM
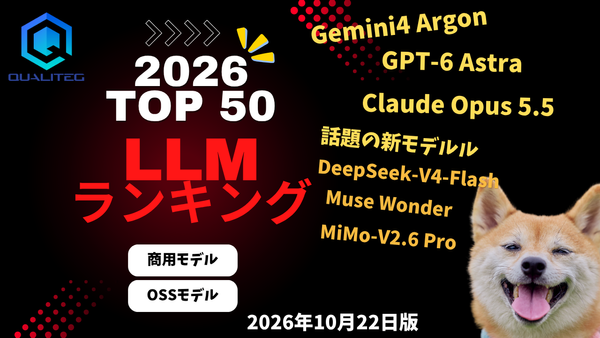
まず結論 2026年10月22日時点のLLMランキング 日本語対応LLMランキングの2026年10月22日版です。前置きは後回しにして、まず最新のランキングからお見せします。 フロンティアモデルの最新ランキング TOP20(Epoch Capabilities Index) 順位 モデル 開発元 提供形態 公開日(Epoch AI記載) ECI 1Claude Opus 5.5AnthropicAPI09/22168.8 2GPT-6 AstraOpenAIAPI09/03168.8 3GPT-6.1 SolOpenAIAPI09/29168.4 4Claude Fable 5.1AnthropicAPI09/01166.5 5Gemini 4 ArgonGoogleAPI09/30166.4 6Claude Sonnet 5.5AnthropicAPI09/28166.2
AIエージェント
300ターン走ってAPIが0本。「モデルの限界」と結論を書いた翌日、記録を読み直すと234ターンがツールを1度も呼んでいませんでした。空転率という指標、1つ塞ぐと次の形に移る空転、思考をオフにすると95点が71点に落ちて時間も縮まなかった話、出力枠を広げたら反対側を数える話を書きます。
AIエージェント
モデルの「完了しました」は5つの形ですり抜けました。構文検査だけ、テストは通るが動かない、待ち受けは立つが最初の要求で落ちる、起動するが仕様のAPIが無い、assertの無いテスト。完了の門を3段で閉じる設計と、押し戻しに「落ちた行と調べ方」を書いて「答え」を書かない理由を、数字つきで書きます。
LLM
TypeSafe AI の Jev は文章を書かず判断だけを返す新種のモデル。9月28日に登録が再開したが直接登録に無料クレジットは無い。$10 入れて Python から 301 回呼び、日本語の振り分け・ガードレール・コマンド承認の正解率、応答時間、試算した費用(約 1 円)を手元で測った。
AIエージェント
Claude Opus 5.5の完全ガイド。Opus 5より20%安い料金とキャッシュ読み取り60%引き、effort既定mediumやthinking無効化不可などAPI移行の注意点、Claude Codeの既定モデル変更とFast modeまで解説。
AIエージェント
コーディングエージェントを自作すると、いちばん難しいのはループを回すことではなく「いつ止めるか」を決めることでした。あるランでは、300ターン中234ターンでツールが1度も呼ばれていませんでした。この数字を出発点に、ターンを回す係と止めてよいか決める係を分け、押し戻しの送り方を直すまでを書きます。
LLM
GPT-6 Astra(アストラ)は何がすごい?Claude Fable 5.1との性能・料金、ChatGPT ProとClaude Maxの20xプランを比較。AGIっぽさを感じる進歩と、実際の開発で気づいた点を図解で紹介します。
LLM
はじめに 本レポートは、Nejumi Leaderboard 4のベンチマークデータ(2026/9/1版)に基づいて、日本語対応LLMの性能を総合的に分析したものです。 前回は 2026/7/10 版の分析レポート を公開しましたが、わずか2か月弱で首位が入れ替わり、 オープンモデルが総合3位に食い込む激アツの回となりました! (定期的に最新LLMランキングを更新してまいります。当社のX(旧Twitter)をフォローいただくことで更新情報を受け取り可能です) Nejumi Leaderboard 4は、日本語タスクにおけるLLMの性能を多角的に評価する信頼性の高いベンチマークとして知られています。汎用的言語性能(GLP)とアラインメント(ALT)の2軸で構成され、翻訳・要約・推論・コーディングから毒性・バイアス・真実性まで、幅広い観点をカバーしているのが特徴です。 本分析では、商用APIモデルとオープンモデルの両方を対象に、それぞれの特徴や傾向を詳しく見ていきます。 まず、今回の3大トピックを先にご紹介します。 * Claude Opus 5が総合スコア0.8720で
LLM
こんにちは! 2026年7月24日、AnthropicからClaude Opus 5がリリースされました。 Opus 4.8(5月28日リリース)からわずか2ヶ月での世代交代です。このあたりのスピード感、加速していますね。 さて、当ブログではClaude Opus 4.7 完全ガイド、Claude Opus 4.8 完全ガイドとOpusの世代を追いかけてきましたが、今回のOpus 5は過去2回の「4.x内のアップデート」とは立て付けが根本的に違います。 何が違うのか。まず、Opus 5は「最上位モデル」ではありません。 Anthropicのラインナップには2026年6月9日リリースのClaude Fable 5が最上位として存在し、Opus 5はその下位、Sonnet 5の上位という「中上位」ポジションで投入されました。 Opusという名前が「最上位ティア」を意味した時代は、Fable 5の登場で終わっています。 そのうえでAnthropicはOpus 5を「
LLM
こんにちは! 2026年7月16日、中国・北京の Moonshot AI が新しいフラッグシップモデル Kimi K3 を発表し、APIやWebサービスでの提供を開始しました。 総パラメータ2.8兆という規模、100万トークンのコンテキスト、そして 「史上最大のオープンウェイトモデルになる」 という宣言がAI界隈をにぎわせています。 当ブログでは今年5月の記事「Mythos(ミュトス)レベルのオープンモデルはいつ出るのか」で、オープンモデルがクローズドのフロンティアにいつ追いつくのかを予測しました。 Kimi K3 は、まさにその問いに対する現時点での最新の「回答」のひとつです。 一方で、この記事を書いている7月20日時点では、モデルのウェイトも技術レポートもまだ公開されていません。 ただし、XなどSNSかいわいでは、 「ガードレールが弱めで、Fable5では拒否されるようなプロンプトでも対応してくれる」 「すぐにOpus4.8にフォールバックする Fable5より使い勝手がいい」 といった声が散見されており、 米国産のガードレール強め方針にたいして、ガードレール
LLM
はじめに 本レポートは、Nejumi Leaderboard 4のベンチマークデータ(2026/7/10版)に基づいて、日本語対応LLMの性能を総合的に分析したものです。 前回は 2026/3/6 版の分析レポート を公開しましたが、 約4か月ぶりとなる今回も、上位勢の顔ぶれが大きく入れ替わる激動の回となりました! (定期的に最新LLMランキングを更新してまいります。当社のX(旧Twitter)をフォローいただくことで更新情報を受け取り可能です) Nejumi Leaderboard 4は、日本語タスクにおけるLLMの性能を多角的に評価する信頼性の高いベンチマークとして知られています。汎用的言語性能(GLP)とアラインメント(ALT)の2軸で構成され、翻訳・要約・推論・コーディングから毒性・バイアス・真実性まで、幅広い観点をカバーしているのが特徴です。 本分析では、商用APIモデルとオープンモデルの両方を対象に、それぞれの特徴や傾向を詳しく見ていきます。まず、今回の3大トピックを先にご紹介します。 * Claude Opus 4.8がリーダーボード史上初の総合スコア0.8
AIエージェント
ここ数年で、サイバーセキュリティをめぐる議論の前提は大きく変わりました。かつての中心は「いかに侵入を防ぐか」でしたが、いまは攻撃側も防御側も、ともにAIを使い始めています。攻撃が機械の速度で自動化・大規模化する一方、防御も人手だけでは追いつかない領域に入りつつあります。本記事では、公開されている市場データをもとに、AI時代のセキュリティ市場を「どこが伸び、どこが重なり、どこに注意すべきか」という観点から整理します。 「AIとセキュリティ」には三つの市場がある 最初に、用語を整理しておきます。「AIセキュリティ」とひとくくりにすると分かりにくいのですが、実際には少なくとも三つの異なるテーマが同時に進んでいます。 この三つの違いは、「誰がAIを使うのか」と「何を守るのか」で考えると分かりやすくなります。 第一は、防御側がAIを使う「AIで守る」領域です。 攻撃者がAIを使っているかどうかにかかわらず、企業やセキュリティ事業者がAIを利用して、サイバー攻撃やインシデントを検知・分析・阻止します。大量のログやアラートの分析、脅威の優先順位付け、異常の検知、初動対応の支援などは、すでに