GPUリッチと日本の現状

世界的なGPU不足が深刻化しており、特に高性能なグラフィックスプロセッシングユニット(GPU)の確保が困難な状況に直面しています。この不足は、AI研究開発をはじめとする多くのテクノロジー業界に大きな影響を及ぼしており、企業や研究機関の間で新たな競争が生まれています。
GPU不足の現状
「GPUが非常に不足しているため、当社の製品を使用する人が少ないほど良いです」「GPUが不足しているため、当社の製品の使用量が減ってくれると嬉しいです」との声が業界内で聞かれるほど、GPUの調達は困難を極めています。
イーロン・マスクは、GPUの入手困難さを「麻薬よりも取得が難しい」と形容しています。
米国のビッグテックやメガベンチャーでは、GPUを万単位で確保しており、一例として1万台のGPUを確保するには約600億円の投資が必要とされています。これらの企業は、「GPUリッチ」と呼ばれるほどに、NVIDIAのA100やH100などの高性能GPUを大量に所有しています。

GPUリッチの影響
このGPUリッチな環境は、米国内でのAI研究開発競争を加速させています。ベイエリアのトップAI研究者たちは、GPUへのアクセスを自慢し、それが彼らの職場選びに大きな影響を与え始めています。Metaなどの企業は、採用戦術としてGPUリソースを活用しており、豊富な資金力により高性能のGPUを大量に確保し、競争に勝ちに行く戦略を取っています。
日本の状況
一方、日本では、国策とも言える産業技術総合研究所(産総研)のABCI(AI Bridging Cloud Infrastructure)でさえ、新モデルのH100は保有している気配は無く、旧式のGPUしか保有できていない状態です。このような状況は、日本が国際競争において不利な立場に立たされていることを示しており、どう頑張っても、小粒な日本語LLMしか作れない可能性があります。
(そもそも、日本語の言語リソースが英語のそれよりもずっと少ないという課題もあります)
日本の戦い方
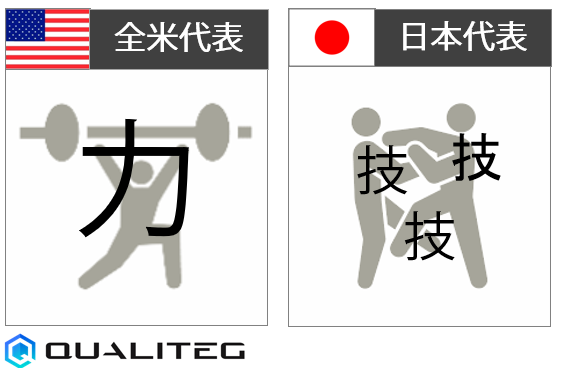
日本がこのGPUリッチな環境においてどのように競争していくべきかは、重要な課題となっています。私たちは日本の企業や研究機関は、限られたリソースの中で、高度に最適化されたアルゴリズム、効率的なデータ処理、そして創造的な問題解決戦略を発見していくことと信じています。また当社のようなLLMプラットフォーム企業をハブとして活用していただくことで、相互のパートナーシップが生まれ、新しい技術の開発において力を結集することができるのではないでしょうか。そのためのネットワーキングの支援、事例共有なども積極的に行っていきたいとおもいます。つまり、米国が力で戦っているのにたいして、日本は技と技の結集で戦うというわけです。
LLMスタートアップには依然厳しい
その「技」を担う重要なプレイヤーとして、LLMを研究しているベンチャー・スタートアップという存在を忘れてはいけないでしょう。
彼らはさらに深刻で、GPU Poor ともいえるべき状況ではないでしょうか。たとえば、NVIDIA A100(80GB)は1台300万円、H100(80GB)は600万円以上します。 大学発スタートアップなどがエクイティ調達しようとすると例えばシード期 Post Valuation で数億円。実際の調達額はせいぜい数千万円となり、いまの日本のスタートアップエコシステムでの調達額では、高性能GPUを数枚買ったら枯渇してしまいます。

この業界は、とにかく GPUありきなので、従来のAASのように小さく生んで大きく育てられるビジネスモデルとコスト構造が決定的に違いますが、なかなかそれを説明して正しく理解していただくのは難しいという話を聞きます。また、仮に数億円調達できても、数億円程度ではとても”大規模な”LLMをトレーニングすることはできません。GPUクラウド環境も割高で、そもそも、学習をまわしてもうまくいく保証はないので何百万円かけてトレーニングしても成果無しということもよく起こり、なかなか厳しい状況です。このままでは運よくスポンサーをみつけたスタートアップや大企業にM&Aされたスタートアップ以外は打席に立つ前に淘汰されてしまうとおもいます。それが競争といえば競争かもしれませんが、せめて打席に立つ(GPU資源は気軽に使える)チャンスが必要でしょう。AWS による支援プログラムなど太っ腹な救済策?もはじまっていますが、より多くの挑戦者が打席に立つためには、豊富なGPU資源に”気軽に”アクセスできる環境が必要であり、「GPU使用無償化」の国策に期待したいところであります。これはまったく他人事ではなく、私たちもトレーニングほどの資源は使用しないものの、推論環境に必要な GPU資源 の確保に苦慮しており、心を同じくしております。
All you all need is GPU! (^_-)