AI数理
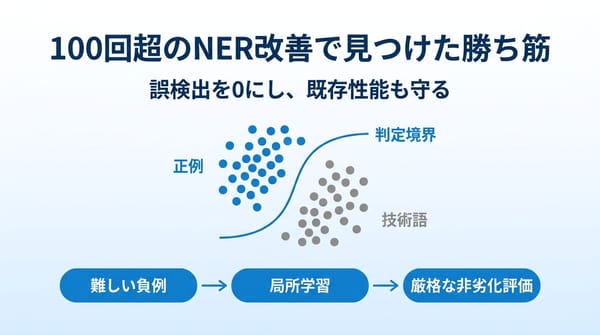
誤検出を0にしても採用しない NER改善100回超の勝ち筋
GitHub技術語の誤検出を0にしつつ既存性能も上げるまで、100回超のNER改善で得た難しい負例、局所損失、蒸留、残差修復、種類別スコア補正の実務上の要点を紹介します。
AI数理
GitHub技術語の誤検出を0にしつつ既存性能も上げるまで、100回超のNER改善で得た難しい負例、局所損失、蒸留、残差修復、種類別スコア補正の実務上の要点を紹介します。
PII-FI
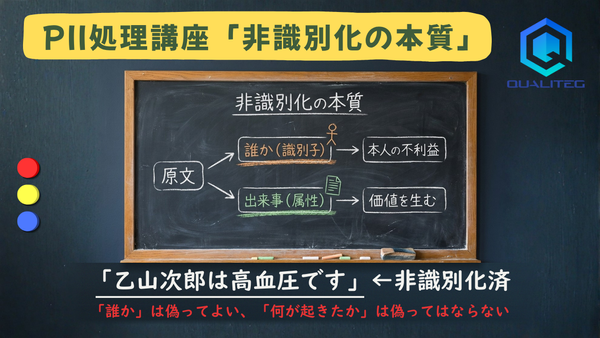
こんにちは!Qualitegプロダクト開発部です! 本日は、PII( Personally Identifiable Information→個人情報)の非識別化に関する内容を解説いたします。 当社ではこれまで、高精度なPII検出技術やLLM利用時の段階的PIIマスキング、PII検出のテスト設計など、個人情報検出とAIセキュリティに関する技術解説をお届けしてきました。 現在、当社では、PII検出マスキング技術「PII-FIエンジン」と、それを活用したPIIのマスキング・非識別化サービス「PII-FI Scan」「PII-FI API」を開発・提供しています。 本記事では、「PIIを検出したあと、それをどう書き換えるか」の設計原則を、1つの例文を試金石にして、私たちが実際のプロダクトで採用している整理をご紹介します。 先にことわっておきますと、本記事でいう「非識別化(de-identification)」は、文書やログを安全に共有・分析するための技術的な加工(個人を特定できないように加工する処理)のお話です。 個人情報保護法上の「仮名加工情報」「匿名加工情報」に該当することを
AI数理
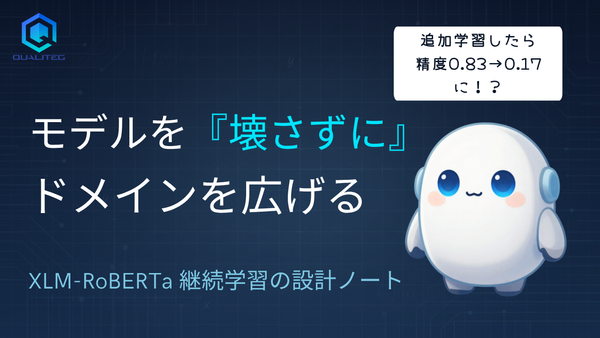
こんにちは、Qualiteg研究部です。 今日は「すでに完成している強いモデルを、壊さずに広げる」という、地味だけど実務でとても大事なテーマを取り上げたいと思います。 機械学習に取り組んでいると、 「一度しっかり仕上げたモデルを、新しい用途やデータに合わせてもう少し広げたい」 そんな場面はよく出てきます。 今回ご紹介するNER(固有表現抽出)のシーンに限らず、いろいろなタスクで共通する悩みではないでしょうか。 ところが、ここで素朴に追加学習をかけると、せっかくの強みがあっさり崩れてしまう。 私たちは、PII(個人特定情報や要配慮情報)を検出・マスキングするエンジン(PII-FI)を構築する際、実際にそれを経験しました。 Precision(適合率)が 0.83 から 0.17 まで転げ落ちる、なんてことも本当に起きるんです。 PII検出では、ドメイン(分野)ごとに検出したいPII型の種類や求められる精度が異なる場合があります。そこで1つのエンジンといっても、対応ドメインを広げていくたびに(そのドメインに適応させるための)追加学習が求められることがあります。 本稿は、そう
AI数理
こんにちは。Qualiteg研究部です。 私たちは、個人情報(PII)や機密情報、要配慮個人情報を含むセンシティブな情報を検出・マスキングする技術(https://pii-fi.com)の開発に取り組んでいます。 その中で日々向き合っているのが、 「精度の数字を、どうすれば正直に、正しく語れるのか」 という問題です。 たとえば、検出器の Recall(再現率)が 0.95 だったとします。 これは高い数字に見えます。しかし、その数字はどの種類の文書で測ったものなのか。正解データはどう作ったのか。サンプル数は十分なのか。別の業務文書にも同じ数字を当てはめてよいのか。 精度の数字は、単独ではほとんど意味を持ちません。 「何を、どの条件で、どう数えたか」とセットになって、はじめて実務で使える数字になります。 本記事では、私たちが PII 検出の精度評価に取り組む中で得た、精度を誠実に語るための考え方を紹介します。アルゴリズムの中身ではなく、評価のしかたに焦点を当てます。 1. はじめに:「Recall 0.95
LLM セキュリティ
こんにちは!Qualiteg研究部です! 個人情報(PII: Personally Identifiable Information)の自動検出は、テキスト中から特定の表現を抽出し、それがどの種類のPIIに当たるかを判定する問題として捉えることができます。 電話番号、人名、口座番号、金額表現など、検出対象のPIIタイプが増えるにつれて、単一の手法ではカバーしきれなくなり、性質の異なる複数の認識器(Recognizer)を組み合わせるマルチレイヤー構成が採用されるのが一般的です。 本稿で想定しているのは、ユーザーが海外製LLMにチャットを送信する直前に、その内容に個人情報や機密情報が含まれていないかをリアルタイムに検査するユースケースです。 この場面では、検出精度だけでなく、送信体験を損ねない速度が不可欠です。 高精度なLLMやBERT系モデル、NERベースの手法は有力ですが、送信前チェックの第一層として常時適用するには、レイテンシやコストの面で不利になることがあります。 そのため、本システムでは、正規表現、辞書、軽量なルールベース認識器を組み合わせた超高速な第一層を設け、そ
LLM-Audit
こんにちは、Qualitegプロダクト開発部です! 前回の技術解説では、「三沢」が人名なのか地名なのか判断できない日本語の曖昧性から始まり、正規表現からLLM統合まで5段階のPII検出アプローチをご紹介しました。今回は、これらの技術を搭載した LLM-Audit™ PII Protector が実際のLLM活用シーンでどのように動いているのか、実際のプロダクト処理の観点で、もう一歩踏み込んで解説します。 ファイルの中に潜む、見えないPII LLM Audit™ PII Protectorをご紹介した際、多くの方から「テキスト入力のPII検出は分かったけど、ファイルをまるごとLLMに投げる場合はどうなるの?」というご質問をいただきました。 確かに現在のLLM活用は、単純なテキスト入力から、PowerPoint、Excel、PDF、画像ファイルなど、様々な形式のファイルを直接処理する段階に進化しています。「この提案書を要約して」「このExcelから傾向を分析して」といった使い方が当たり前になってきました。 PowerPointの「スピーカーノート」を見たことがありますか?
LLM-Audit
こんにちは、Qualiteg研究部です! 本日はPII(個人識別情報)検出技術について解説いたします。 グローバルツールと日本語特化ツールの共存 個人情報保護は世界共通の課題です。 GDPR、CCPA、そして日本の改正個人情報保護法など、世界中で規制が強化される中、多くの優れたPII(個人識別情報)検出ツールが研究・開発されていますが、日本語を中心としたビジネスシーンで利用しようとすると「おや?」っとなることが多く割と無視できない規模の追加開発、特別対応による追加工数が発生することがあります。なぜなら、それらツールは英語(および英語文化圏)を中心に設計されており、スペック上は日本語も対応言語の1つとして挙げられておりますがきめ細やかな対応が後手にまわることが多いです。 当然ですが言語には固有の文化と構造があり日本語は、その独特な文字体系と文化的背景により、特別なアプローチが必要となるシーンが存在しています。 私たちが開発している日本語特化型PII検出技術は、グローバルに採用されている優れた基盤技術も活かし共存ながら、日本語の特性に深く寄り添うことで、日本企業により実用的なソリュ
LLM-Audit
はじめに なぜ今、PIIセキュリティが重要なのか 私たちは大規模言語モデル(LLM)が業務の隅々まで浸透した時代を生きています。ChatGPT、Claude、Geminiなどの生成AIツールは、もはや実験的な技術ではなく、日常業務に欠かせないインフラとなりました。しかし、この便利さの裏側で、企業の個人識別情報(PII)は前例のない脅威にさらされています。 従来のセキュリティ対策では想定していなかった「AIへの情報漏洩」という新たなリスクが生まれ、企業は情報防衛戦略の根本的な見直しを迫られています。 PIIとは何か ~生成AI&LLM時代の再定義~ 従来のPII定義 個人識別情報(Personal Identifiable Information)は、単独または他の情報と組み合わせることで特定の個人を識別できる情報を指します。 たとえば、従来は以下のような情報が主な対象でした * 直接識別子:氏名、住所、電話番号、メールアドレス、マイナンバー * 間接識別子:生年月日、職業、勤務先、IPアドレス * 機密情報:医療記録、金融情報、生体認証データ LLM時