Ubuntu 24.04 の GPU サーバーが shutdown で固まる。犯人は HWE カーネルだった
Ubuntu 24.04 の GPU 推論サーバーが shutdown で固まり、電源長押しになった。前回ブートのジャーナルで追うと、HWE カーネル 7.0 系と NVIDIA 595 open の組み合わせで CUDA プロセスの SIGKILL 直後にページ管理の異常が記録されていた。カーネルと対応する NVIDIA モジュールの組を GA 6.8 系に切り替えて正常な停止を確認し、うっかり HWE に戻らない 4 層の防御まで入れた記録。
こんにちは!
Ubuntu 24.04 で動かしている GPU 推論サーバーを、別ラックへ移すために shutdown -h now しました。
ところが、十数分たっても電源が落ちません。
SSH は TCP のハンドシェイクまでは通るのにログインできない。実機のコンソールには停止処理の最後のターゲットまで出ている。
それでも落ちない。最後は電源ボタンの長押しになりました。
犯人は HWE カーネル 7.0 系と NVIDIA ドライバ 595 open の組み合わせでした。
CUDA を使うプロセスを SIGKILL した直後に、カーネルのページ管理に異常が記録されます。その後、ext4 の書き戻しや複数のプロセスが進まなくなり、停止処理が完了しなくなりました。
この記事では、前回ブートのジャーナルからの切り分け、カーネルと対応する NVIDIA モジュールの組だけを GA 6.8 系に切り替えた再現試験、その構成への固定、そして「うっかり HWE に戻らない」ための 4 層の防御までを、手元で実際にやった順に書きます。
同じ症状で電源ボタンを押しに行っている方の時間を、少しでも節約できれば幸いです。
1. 何が起きたか。同じ引き金で 2 回固まった
手元の環境はこうです。
| 項目 | 値 |
|---|---|
| OS | Ubuntu 24.04.5 LTS(Desktop ISO から構築。Desktop は HWE カーネルが既定) |
| カーネル(発生時) | 7.0.0-42-generic(linux-generic-hwe-24.04) |
| NVIDIA | nvidia-driver-595-open 595.99.02(linux-modules-nvidia-595-open-7.0.0-42-generic。Canonical 署名、Secure Boot 有効) |
| GPU | NVIDIA RTX 2000 Ada ×2 |
| ワークロード | Docker(NVIDIA Container Toolkit)上の GPU 推論コンテナ(CUDA と cuDNN を使用) |
| カーネル(復旧後) | 6.8.0-147-generic(GA。linux-generic) |
1 回目は、ふつうの shutdown -h now でした。
停止処理は進むのに、Docker、NetworkManager、wpa_supplicant が SIGKILL しても消えず、最終段で止まりました。SSH の挙動は時間とともに変わります。最初は「Connection closed」で、ssh.socket は受けるのに sshd を起動できない状態。しばらくすると「Connection refused」になり、カーネルの IP スタックだけが生きている状態になりました。遠隔からできることは無く、電源長押しで落としました。
2 回目は、対策の途中で起きました。
CUDA コンテナを 1 本ずつ docker stop -t 300 で止めていたとき、SIGTERM に応じないコンテナが 300 秒後に SIGKILL された直後、同じ壊れ方が再現しました。SSH は TCP 接続とバナーまで通り、その先のログイン処理、つまりユーザー空間のディスク待ちが進まない。再び電源長押しです。
同じ引き金で 2 回。「個体の調子が悪い」ではなく、再現性のある不具合だと分かりました。
2. 切り分けは journalctl -b -1 -k から始める
再起動後に前回ブートのカーネルログを読むと、流れがそのまま残っていました。
journalctl -b -1 -kjournalctl -k は現在のブートしか見ないので、固まった回の記録は -b -1 で前回ブートを指定して読みます。
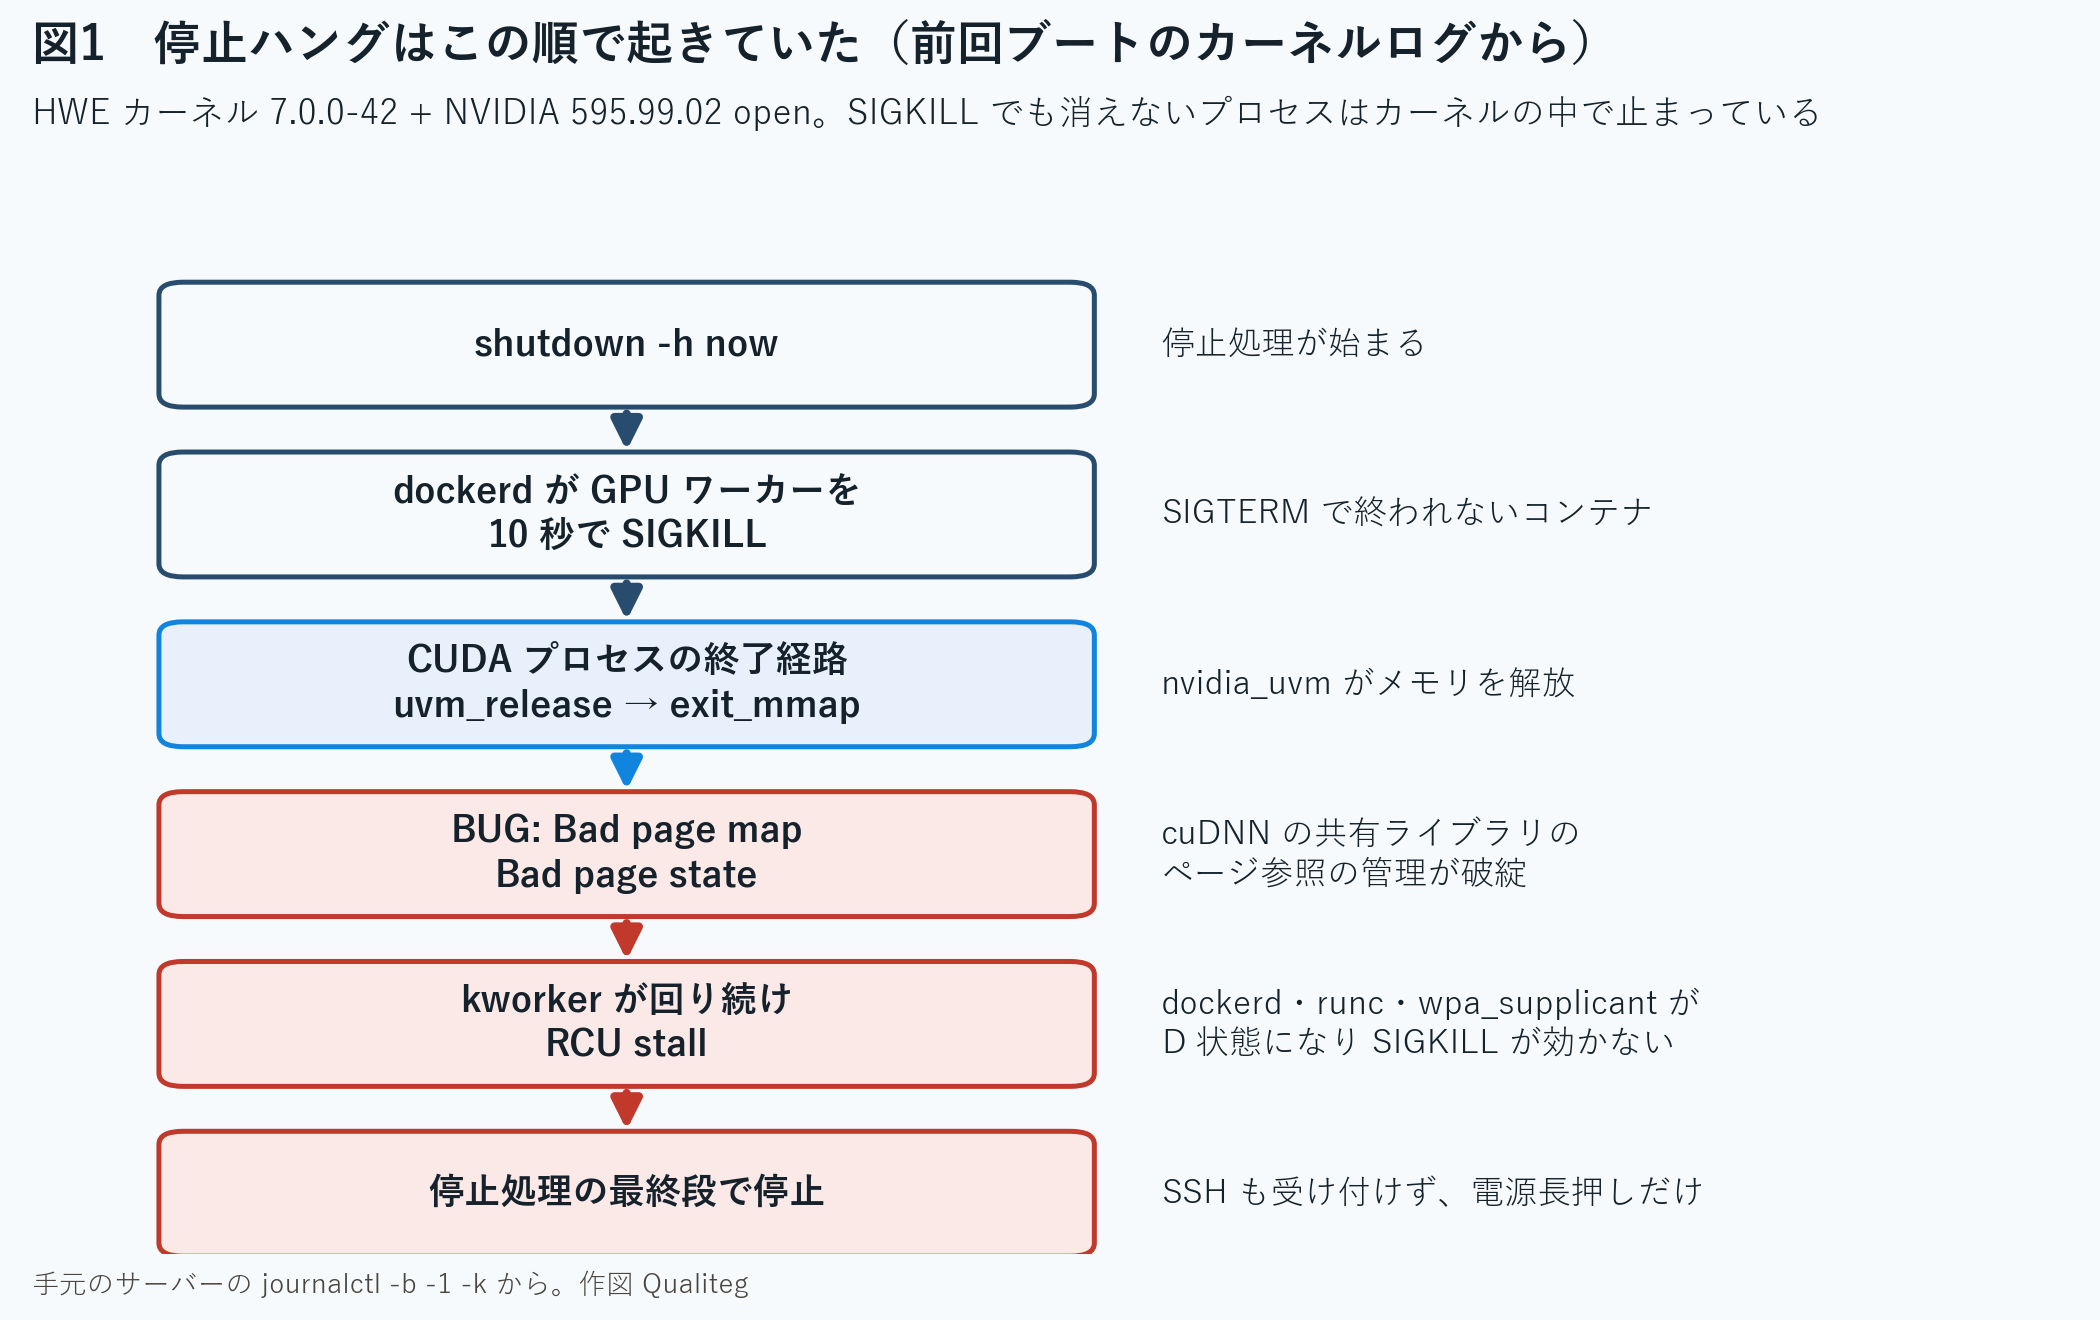
shutdown 開始の約 10 秒後、dockerd が GPU コンテナのうち数本を「10 秒で exit しないので force」として SIGKILL します。ここまでは Docker の仕様どおりです。
問題はその直後でした。CUDA を使う python の終了経路 do_exit → uvm_release [nvidia_uvm] → exit_mmap → zap_present_ptes で、ログにこの行が並びます(抜粋。時刻とホスト名は省いています)。
WARNING: fs/ext4/inode.c ext4_dirty_folio
BUG: Bad rss-counter state (dockerd)
BUG: Bad page map in process python
Bad page state
rcu: INFO: rcu_preempt detected expedited stalls
Processes still around after SIGKILL
異常が記録されたのは、cuDNN の共有ライブラリ libcudnn_engines_precompiled.so.9 に対応するページでした。mapcount が -1 になっており、ページのマッピング参照の管理が破綻しています。
以後、ext4 の書き戻しを担う kworker が回り続け、dockerd、runc、wpa_supplicant、CUDA のスレッドが D 状態になります。D 状態のプロセスには SIGKILL が効きません。systemd は docker.service に対して stop-sigterm timeout、SIGKILL、「Processes still around after SIGKILL」、final SIGKILL を繰り返した末に、停止処理の最終段で止まりました。
ログに残っているのは、この時間的な順序です。この一連の異常が停止ハングにつながったと判断しました。
Tainted フラグは G B W O でした。EDAC と MCE は ECC 非対応の初期化行だけで、メモリエラーの記録はありません。
SIGKILL でも消えないプロセスは、カーネルの中で止まっている。
ユーザー空間の問題なら SIGKILL で消えます。消えないなら、疑うのはカーネル側です。この型を押さえておくと、次に同じ目に遭ったとき迷いません。
3. 「ほかの機は動いているのに」の答えは版の差だった
同じ手順で構築した同型の機が 3 台あり、そちらは何週間も動いていました。「なぜこの 1 台だけ」という問いに、比べてみると答えは 2 つに分かれました。
ひとつは、3 台が「GPU コンテナを強制終了しながらの停止」をその時点まで一度も通っていなかったことです。docker の force-kill の記録が 0 件で、引き金そのものを引いていませんでした。
もうひとつは、問題の機だけ、カーネルもドライバも GPU の世代も新しかったことです。3 台は 7.0.0-34 と 7.0.0-38 に 595.91.07。問題の機は 7.0.0-42 に 595.99.02。構築手順は同じでも、構築した時期が違うと入る版が違います。配布元から古い版が消えて、新しい版が入っていました。
比べた条件を表にするとこうなります。
| 比較項目 | 問題の機 | 旧構成の 3 台 |
|---|---|---|
| カーネル | 7.0.0-42 | 7.0.0-34 が 2 台、7.0.0-38 が 1 台 |
| NVIDIA | 595.99.02 open | 595.91.07 |
| GPU | NVIDIA RTX 2000 Ada ×2 | 前世代の GPU |
| Secure Boot | 有効 | 有効 1 台、無効 2 台 |
| GPU コンテナの強制終了を通ったか | 通った(2 回ハング) | 横展開の停止時に 2 台が通った(第 7 節) |
ここから「個体のハード問題」より「版の組み合わせ問題」が濃厚になりました。
4. 復旧と再発防止。カーネル構成を GA 6.8 系に切り替える
候補は 3 つありました。ドライバを proprietary 版に変える、GA カーネルに戻す、メモリ試験を回す。
一度に複数を変えると、何が効いたか分からなくなります。まずカーネルだけを 7.0.0-42 から GA 6.8.0-147 に戻し、ドライバ 595.99.02 open は据え置きました。
4-1. GA メタと 6.8 用の署名済み NVIDIA モジュールを入れる
Secure Boot が有効なので DKMS は採らず、Canonical 署名のビルド済みモジュールを使います。先に、6.8 用のモジュールが配布されているかを確認します。当時、595-open、595、580、580-open、615-open にはあり、590 系にはありませんでした。
apt-cache policy linux-modules-nvidia-595-open-6.8.0-147-generic
apt-get install linux-generic linux-image-generic linux-headers-generic linux-modules-nvidia-595-open-generic
4-2. GRUB の既定を 6.8 の実エントリ名で固定して再起動する
7.0 側は試験に合格するまで残しておきます。戻れる道を確保したうえで、既定だけを 6.8 にします。
まず、GRUB が実際に生成しているメニュー名を確認します。GRUB_DEFAULT に書くエントリ名は、この出力と一致していなければ効きません。
grep -E "submenu |menuentry " /boot/grub/grub.cfg次に /etc/default/grub の GRUB_DEFAULT の行を、確認した実エントリ名に書き換えます。
GRUB_DEFAULT="Advanced options for Ubuntu>Ubuntu, with Linux 6.8.0-147-generic"書き換えたら、設定の反映と、起動先のカーネルに NVIDIA モジュールがあることを確認してから再起動します。
cp /etc/default/grub /etc/default/grub.bak
grep '^GRUB_DEFAULT=' /etc/default/grub
update-grub
modinfo -k 6.8.0-147-generic -F filename nvidia
systemctl reboot
modinfo が /lib/modules/6.8.0-147-generic/kernel/nvidia-595-open/nvidia.ko のようなパスを返せば、起動先にモジュールがあります。ERROR なら、その版のモジュールを入れてから再起動します。手元では、4-1 の apt-get install の直後に同じパスへ nvidia.ko などが置かれたことを確認してから再起動しました。再起動前のこの確認は、後述の横展開のときに検証スクリプトに組み込み、4 台とも通しています。
4-3. 起動と kill -9 を 3 セット。1 秒以内に終わり、警告は 0
ホスト側の conda 環境(PyTorch の CUDA 版)で、両 GPU の cuDNN 畳み込みを回す python を起動して kill -9 で殺す、を 3 セット繰り返しました。7.0 系で踏んだ引き金そのものを、意図的に再現する試験です。
結果は 3 回とも 1 秒以内に終了。カーネル警告 0、D 状態のプロセス 0、GPU メモリは正常、稼働中のコンテナに影響なし。
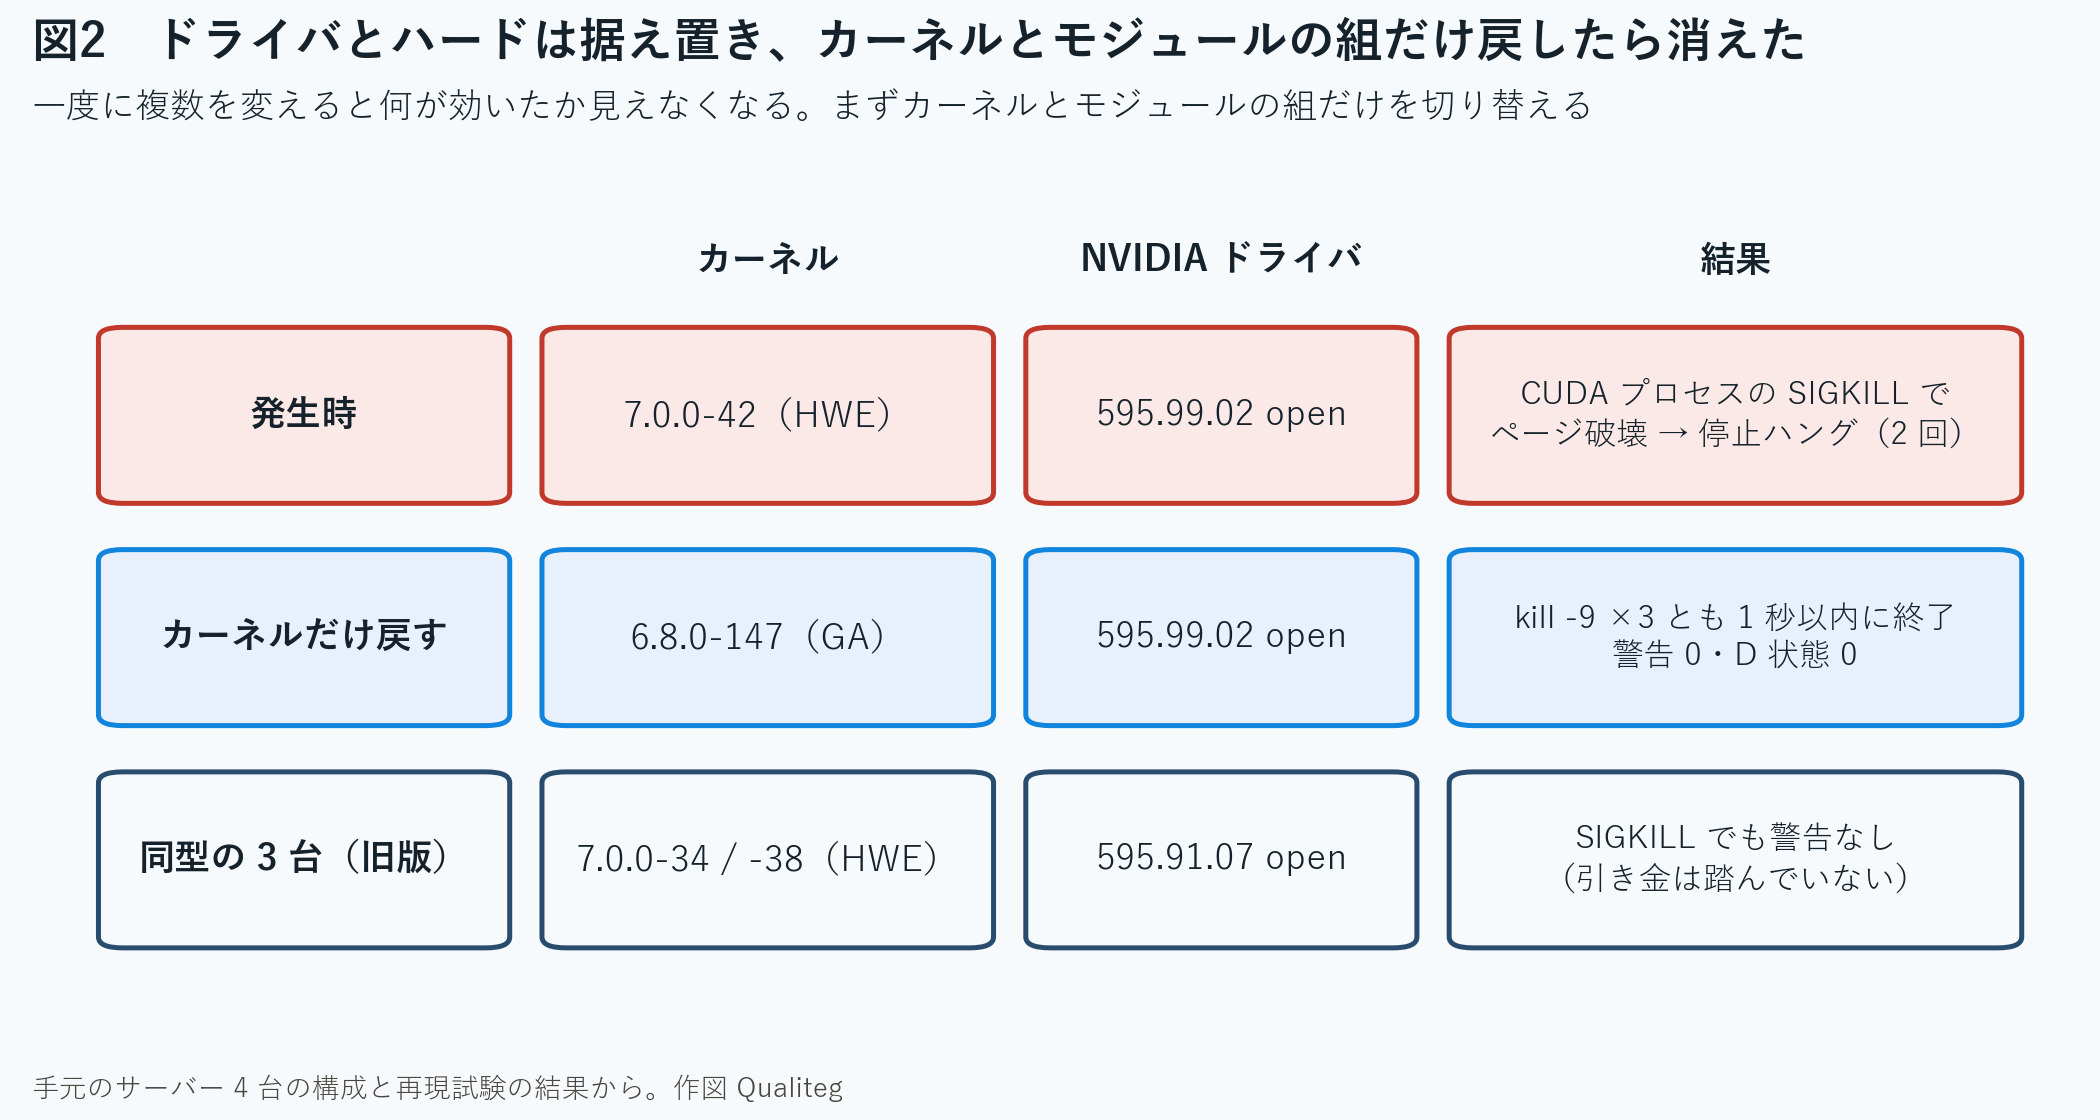
ハードもドライバもそのままで、カーネルだけ戻したら、同じ SIGKILL 試験で異常が出なくなりました。今回の障害の回避にはカーネル構成の変更が有効で、7.0.0-42 と 595.99.02 open の組み合わせが原因である可能性が強く支持されました。
なお、カーネルを変えると NVIDIA のカーネルモジュールも 6.8 用のビルドに替わります。切り替えたのは、カーネルとそれに対応する NVIDIA カーネルモジュールの組です。
5. うっかり 7.0 に戻らないように 4 層で防ぐ
ここで終わると、次の apt upgrade で HWE に戻ってしまいます。防御を 4 層にしました。
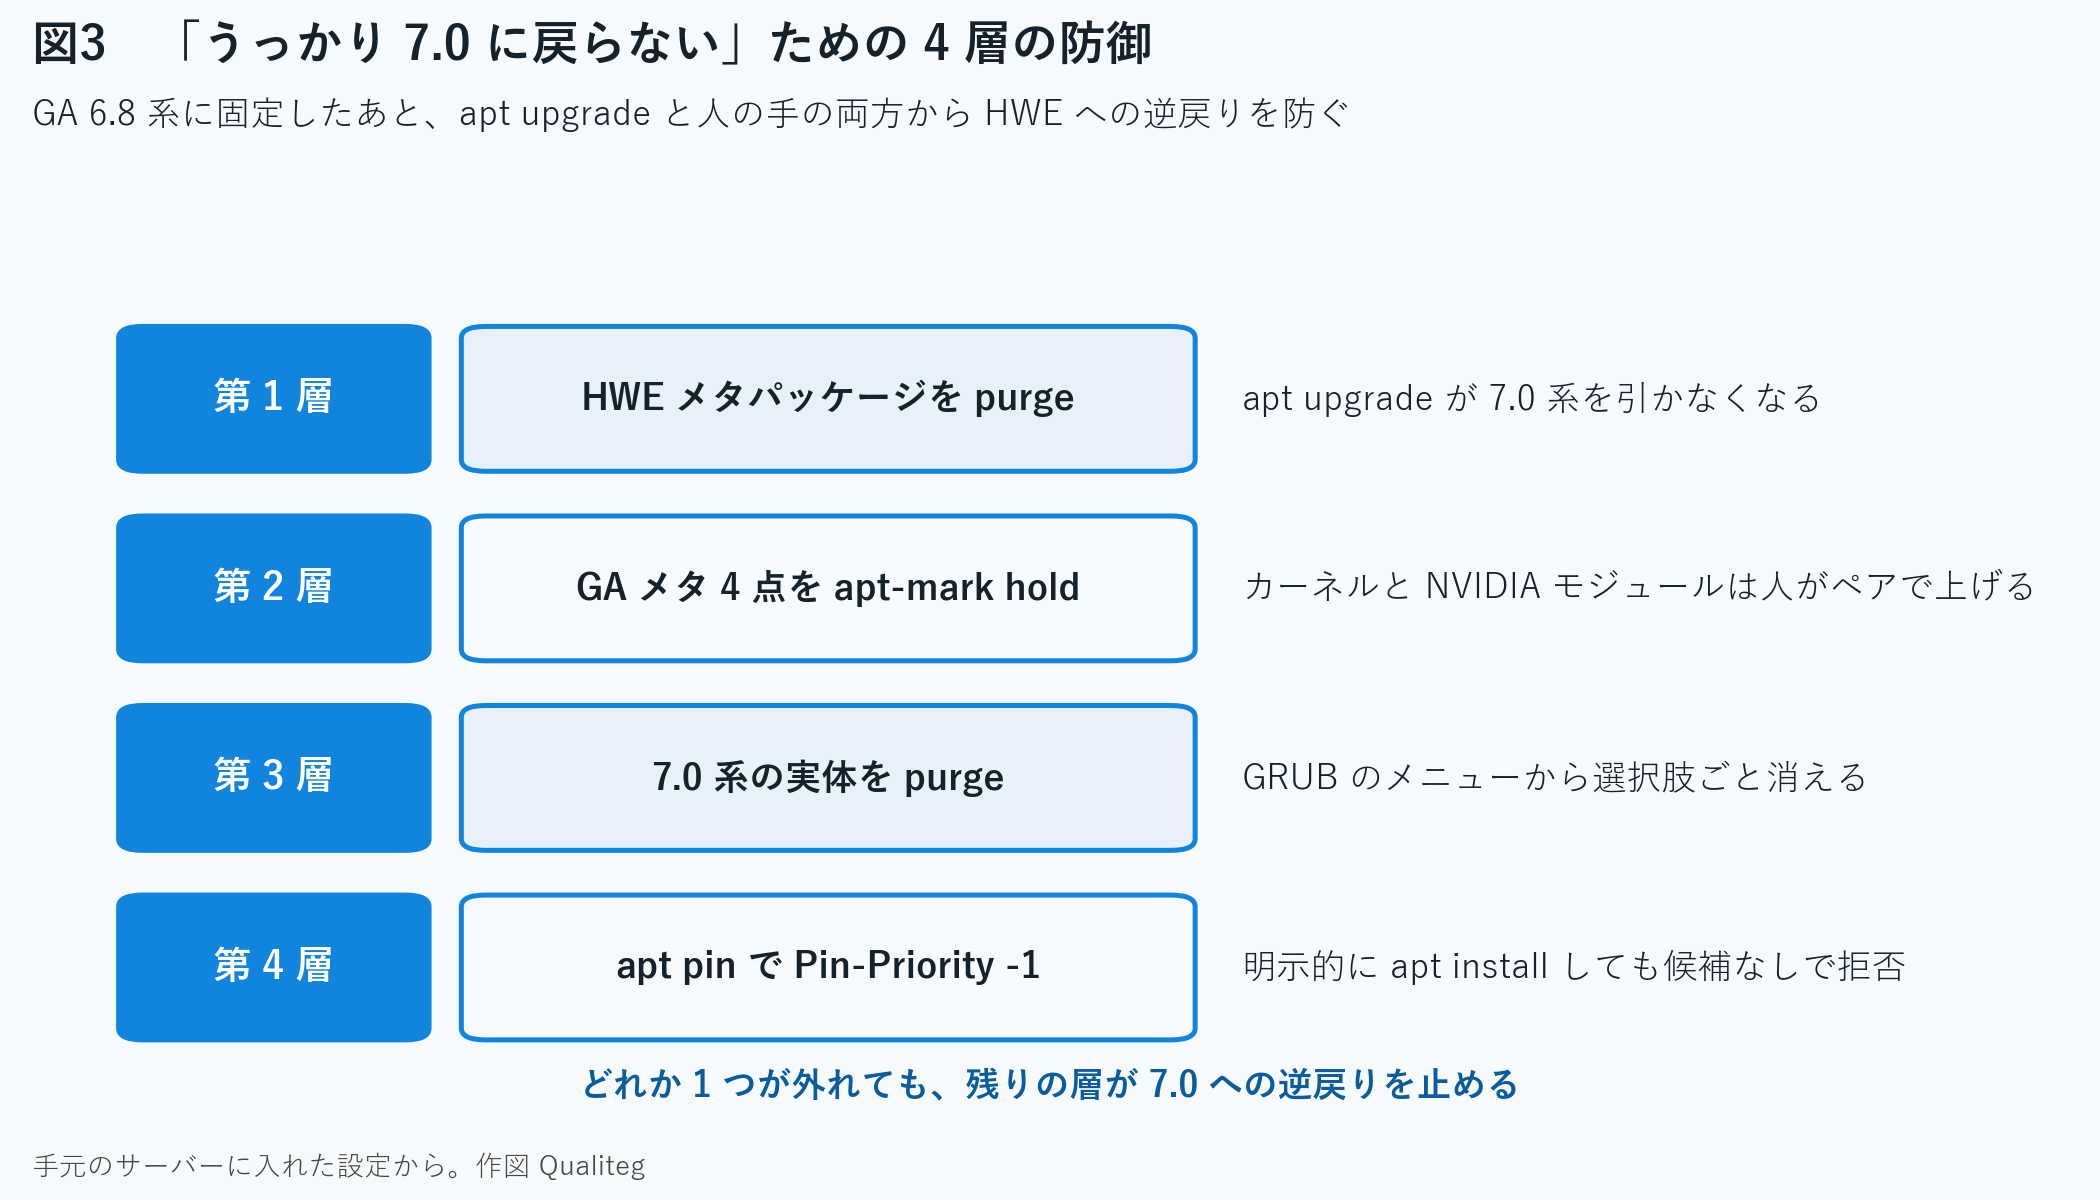
第 1 層は HWE メタパッケージの削除です。入っている HWE メタを列挙してから purge すると、apt upgrade が 7.0 を引かなくなります。
dpkg -l | awk '/^ii/ && $2 ~ /^linux-.*-hwe-[0-9.]+$/ {print $2}'
apt-get purge linux-generic-hwe-24.04 linux-image-generic-hwe-24.04 linux-headers-generic-hwe-24.04 linux-modules-nvidia-595-open-generic-hwe-24.04
第 2 層は GA メタ 4 点の hold です。カーネルと NVIDIA モジュールは、人がペアで上げる運用にします。
apt-mark hold linux-generic linux-image-generic linux-headers-generic linux-modules-nvidia-595-open-genericここで固定しているのは「6.8 系」という系列ではなく、動作を確認した 6.8.0-147 の ABI です。GA 6.8 系は継続して保守されるカーネルなので、この hold は GA 系のセキュリティ更新も止めます。更新を当てるときは、カーネルと対応する NVIDIA モジュールをセットで上げ、4-3 と同じ SIGKILL 試験と再起動試験を通してから、再び hold します。
第 3 層は 7.0 系の実体の purge です。ワイルドカードで無条件に消すのではなく、入っている 7.0 系のパッケージを列挙してから purge します。GRUB のメニューから選択肢ごと消え、GRUB_DEFAULT=0 に戻して update-grub すれば先頭が 6.8 になります。
dpkg -l | awk '/^ii/ && $2 ~ /7\.0\.0-/ {print $2}'
apt-get purge <上で列挙した 7.0 系のパッケージ>
apt-get autoremove
第 4 層は apt pin です。明示的に apt install linux-generic-hwe-24.04 と打っても「has no installation candidate」になるようにします。
# /etc/apt/preferences.d/qualiteg-no-hwe-kernel
Package: linux-generic-hwe-24.04 linux-image-generic-hwe-24.04 linux-headers-generic-hwe-24.04 linux-modules-nvidia-*-hwe-24.04 linux-tools-generic-hwe-24.04
Pin: release *
Pin-Priority: -1

Package: linux-image-7.* linux-modules-7.* linux-modules-extra-7.* linux-headers-7.* linux-tools-7.* linux-modules-nvidia-*-7.* linux-objects-nvidia-*-7.* linux-signatures-nvidia-7.* linux-hwe-7.*
Pin: release *
Pin-Priority: -1
効いているかの確認は 1 コマンドです。Candidate が (none) なら成功です。
apt-cache policy linux-generic-hwe-24.04この設定は 4 台に入れ、4 台とも Candidate が (none) になり、明示の apt install linux-generic-hwe-24.04 が「has no installation candidate」で止まることを実測しています。
apt_preferences(5) の man では、特定のパッケージの「どの版でも」を指す書き方として Pin: version * が示されています。手元では上の形で効いていて、man に沿わせるなら 2 つの Pin: 行を Pin: version * にします。
4 層が揃った状態は、次のコマンドで確認できます。uname -r は 6.8 で再起動したあとに見ます。
uname -r
dpkg -l | grep -E 'linux-(image|headers|modules).*7\.0'
apt-mark showhold
apt-cache policy linux-generic-hwe-24.04
どれか 1 つが外れても、残りの層が逆戻りを止めます。「二重三重にしてある?」と聞かれて、はいと答えられる状態にしておきたかったのです。
6. コンテナを動かしたまま再起動。59 秒で無人復帰した
仕上げに、コンテナを稼働させたまま systemctl reboot しました。
停止処理 29 秒、SSH 復帰まで合計 59 秒で無人復帰です。後日、同じ機を shutdown -h now したときは、停止処理 14 秒で電源まで落ちました。
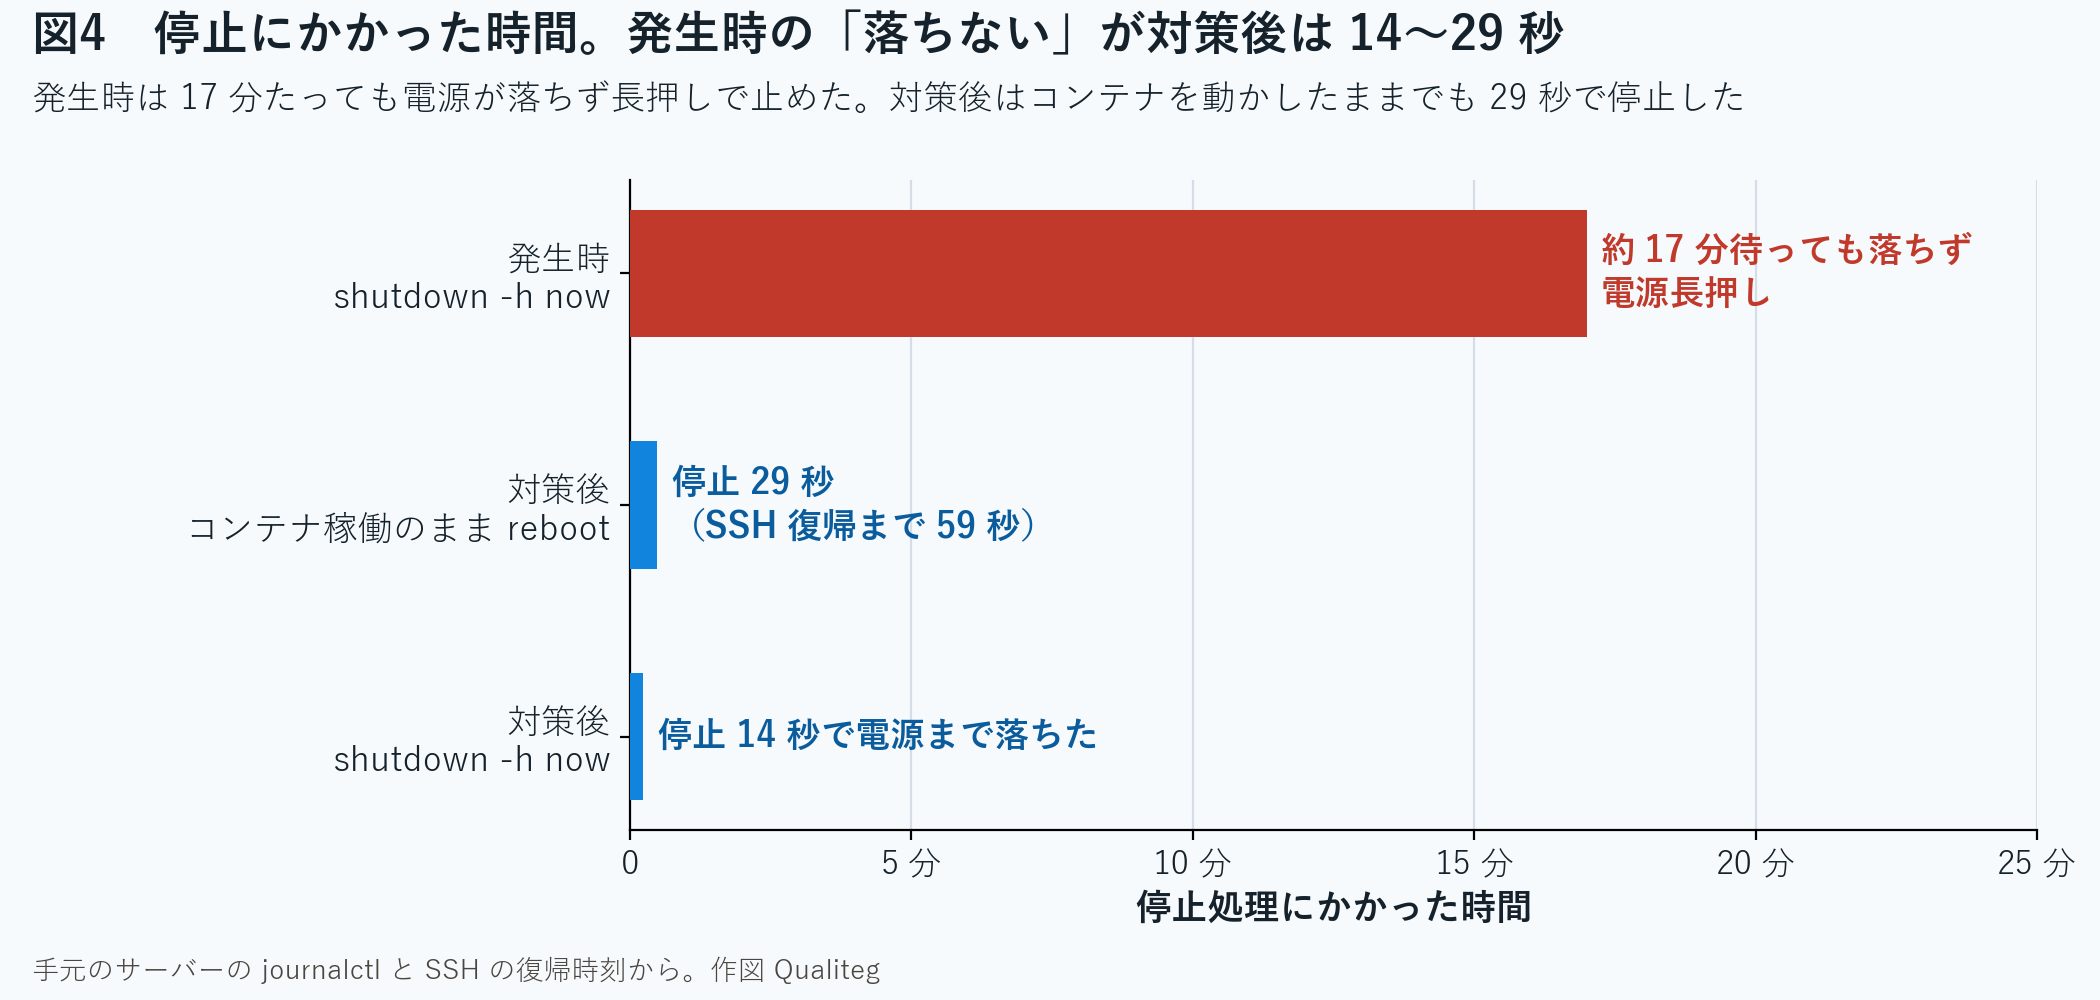
発生時の「十数分待って電源長押し」との差が、そのまま復旧の証拠になります。
7. 横展開で踏んだワナ。hold 中の HWE メタが邪魔をする
残りの 3 台にも同じ対策を入れました。手順は同じなのに、1 つ罠がありました。
| 罠 | 対処 |
|---|---|
hold 中の HWE メタ linux-modules-nvidia-595-open-generic-hwe-24.04 が GA 用の 595 モジュールの導入を阻む。apt は「Depends: linux-modules-nvidia-595-open-7.0.0-38-generic (= …) but it is not going to be installed」と言って止まる | 先に HWE メタ 2 本を apt-mark unhold してから入れる。副作用で 7.0 の新版も一緒に入るが、GRUB の既定を 6.8 の実エントリ名で固定して再起動し、検証後に 7.x 系をまとめて purge すればよい |
journalctl -k は現ブート限定 | 固まった回は journalctl -b -1 -k で見る。「全ブートで Bad page が 0 件」の比較には使えない |
| SIGTERM に応じないワーカーがいると、停止のたびに SIGKILL 経路を通る | 手元では Docker デーモンの停止処理に shutdown-timeout 120 秒(daemon.json)、systemd 側に docker.service の TimeoutStopSec=180s を設定した。コンテナごとの SIGTERM 猶予はこれとは別で、default-stop-timeout やコンテナ側の停止タイムアウトで管理する。根本はアプリ側で SIGTERM を処理する |
横展開の停止作業そのものが、旧構成での試験になりました。GA 6.8 系へ移る前、つまり 7.0.0-34 と 595.91.07 のままコンテナを docker stop で止めたとき、2 台では SIGTERM を無視するコンテナが 120 秒の猶予のあとに SIGKILL されましたが、カーネル警告は 0 でハングもしませんでした。残る 1 台(7.0.0-38)は全コンテナが SIGTERM で止まり、SIGKILL の経路を通っていません。
その後 3 台とも GA 6.8 系へ移行し、4-3 と同じ「起動と kill -9 を 3 セット」の試験で警告 0、稼働のまま再起動して停止 14〜20 秒でした。
移行前の 7.0.0-34 と 595.91.07 の組み合わせでは、SIGTERM を無視するコンテナを SIGKILL してもカーネル警告は出ませんでした。7.0.0-42 と 595.99.02 の組み合わせに固有の挙動とみています。3 台には「次の apt upgrade と再起動でその組み合わせになる」保留更新が並んでいたので、固定しておいて正解でした。
8. 運用で変えたこと
今回の件で、GPU サーバーの標準を 5 つ変えました。
| 変えたこと | 理由 |
|---|---|
| 停止と再起動の前に、CUDA コンテナを穏やかに止める | SIGKILL の経路が引き金だった。SIGTERM を処理しないコンテナはアプリ側で直す。OS 側で猶予を伸ばすのは対症療法 |
| Desktop ISO で作った GPU サーバーは、構築手順に「GA に戻す」を入れる | Desktop ISO は HWE が既定。サーバー用途なら GA 6.8 系で十分 |
入る版を先に apt-cache policy で見て、その版を正として記録し、hold で固定する | 同じ手順でも構築時期で版が変わる |
| GA 系の更新を定期的に確認する | hold は 6.8.0-147 の ABI 固定なので、セキュリティ更新も止まる。当てるときはカーネルと NVIDIA モジュールをセットで上げ、同じ試験を通してから再び固定する |
| ハードウェアウォッチドッグと panic 自動再起動を入れる | 固まったときに遠隔で復旧できないのは怖い。これは別記事で扱います |
今回の学びは、「SIGKILL で消えないプロセスを見たらカーネルを疑い、カーネルとモジュールの組だけを切り替えて効き目を確かめ、効いた構成を 4 層で固定する」の 3 つです。
次回は、固まっても電源ボタンを押しに行かずに済むように、ハードウェアウォッチドッグと panic 自動再起動を入れた話を書きます。
それでは、また次回、お会いしましょう!
参考資料
- Ubuntu 公式「Kernel lifecycle」(一次情報。GA カーネルと HWE カーネルの位置づけ) https://ubuntu.com/kernel/lifecycle
- Ubuntu manpage「apt_preferences(5)」(一次情報。Pin-Priority の仕様) https://manpages.ubuntu.com/manpages/noble/man5/apt_preferences.5.html
- Ubuntu manpage「journalctl(1)」(一次情報。
-bの指定) https://manpages.ubuntu.com/manpages/noble/man1/journalctl.1.html - 当社記事 Ubuntu の自動更新でカーネルだけ上がり、再起動したら GPU が消えた https://blog.qualiteg.com/ubuntu-kernel-update-nvidia-driver-lost/