LLM推論基盤プロビジョニング講座 第2回 LLMサービスのリクエスト数を見積もる
こんにちは!
今回はLLM推論基盤プロビジョニング講座 第2回です!
LLM推論基盤プロビジョニング講座 シリーズ記事一覧
- 第1回 基本概念と推論速度
- 第2回 LLMサービスのリクエスト数を見積もる
- 第3回 使用モデルの推論時消費メモリ見積もり
- 第4回 推論エンジンの選定
- 第5回 GPUノード構成から負荷試験までの実践プロセス
- 番外編 KVキャッシュのオフロード戦略とGQA
STEP2 LLMサービスへのリクエスト数見積もり
それでは、早速、LLM推論基盤プロビジョニングの第2ステップである「リクエスト数見積もり」の重要性と方法を解説いたします。
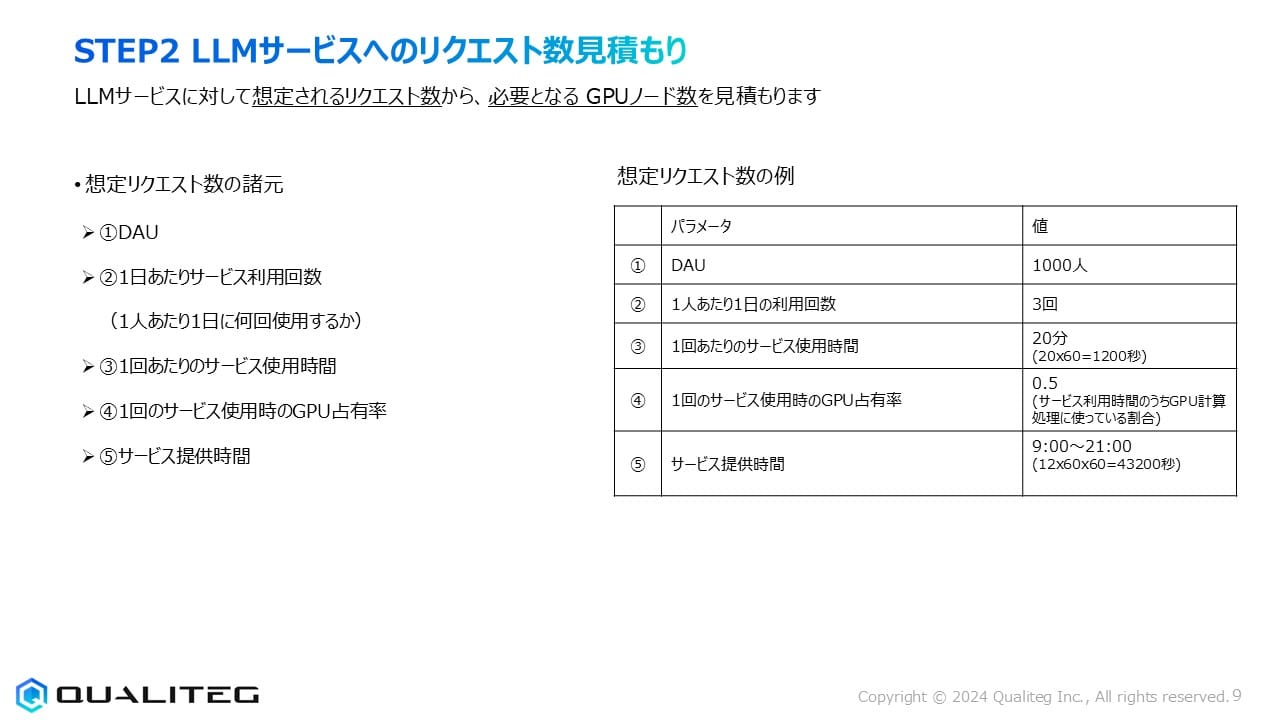
LLMサービスを構築する際に必要となるGPUノード数を適切に見積もるためには、まずサービスに対して想定されるリクエスト数を正確に予測する必要があります。
リクエスト数見積もりの基本的な考え方
LLMサービスへの想定リクエスト数から必要なGPUノード数を算出するプロセスは、サービス設計において非常に重要です。過小評価すればサービス品質が低下し、過大評価すれば無駄なコストが発生します。このバランスを適切に取るための基礎となるのがリクエスト数の見積もりです。
想定リクエスト数の諸元
リクエスト数を見積もるための5つの重要な要素(諸元)をみてみましょう。
- DAU(Daily Active Users): 1日あたりの実際にサービスを利用するユーザー数です。これはサービスの規模を示す最も基本的な指標となります。
- 1日あたりサービス利用回数: 各ユーザーが1日のうちに何回サービスを利用するかという頻度指標です。ユーザー1人あたり1日に何回使用するかを示し、これによって総リクエスト数が大きく変動します。
- 1回あたりのサービス使用時間: ユーザーが1回のサービス利用で平均どれくらいの時間(秒数)サービスを使用するかを表します。LLMサービスでは、ユーザーと対話する時間やコンテンツ生成にかかる時間がこれに該当します。
- 1回のサービス使用時のGPU占有率: サービス利用時間のうち、実際にGPU計算処理に使われている割合を示します。常にGPUがフル稼働しているわけではなく、入力待ちなどでGPUが使用されない時間も存在することを考慮した指標です。
- サービス提供時間: 1日のうちサービスを提供する時間帯を指します。24時間365日提供するサービスもあれば、業務時間内(例:9:00~21:00)のみ提供するサービスもあります。
想定リクエスト数の具体例
具体的な数値例で考えてみるとより理解の解像度があがるので以下のような数字をあげてみました
- DAU: 1,000人 - 中規模のエンタープライズ向けLLMサービスを想定
- 1人あたり1日の利用回数: 3回 - 各ユーザーが1日に平均3回利用
- 1回あたりのサービス使用時間: 20分(20×60=1,200秒)- LLMとの対話やコンテンツ生成に要する時間
- 1回のサービス使用時のGPU占有率: 0.5(50%)- サービス利用時間中、実際にGPU計算処理に費やされる割合
- サービス提供時間: 9:00~21:00(12時間=12×60×60=43,200秒)- 業務時間を想定
この例では、1日あたり合計3,000回(1,000人×3回)のサービス利用があり、各利用には平均20分かかり、そのうち約半分の時間がGPU計算に使われると想定しています。また、サービスは1日12時間提供されています。
これらの値は、企業内での特定領域向けLLMサービス(例:社内ナレッジベース検索・質問応答システム)を想定した現実的な数字で考えていくのがポイントとなります。
同時リクエスト数を割り出す
さて、前述の5つのパラメータを用いて、実際にLLMサービスに必要なGPUリソースを計算していきましょう。
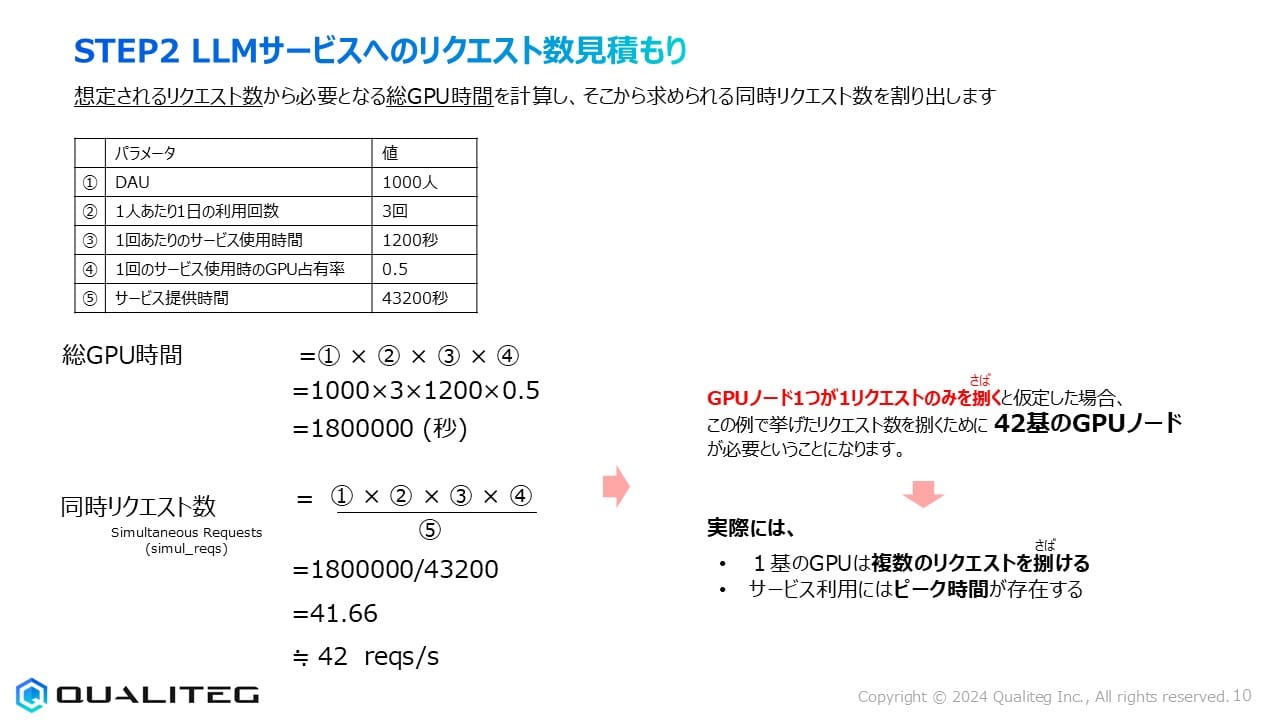
ここでは想定されるリクエスト数から必要となる総GPU時間を計算し、それを基に同時リクエスト数を割り出すプロセスを詳細に見ていきます。
「総GPU時間」の計算
総GPU時間とは、LLMサービスの運用中に必要となるGPU処理時間の合計値です。これは、すべてのユーザーのリクエストを処理するために必要なGPUの総稼働時間を表します。
計算式は以下の通りとなります
総GPU時間 = ①DAU × ②1人あたり1日の利用回数 × ③1回あたりのサービス使用時間 × ④GPU占有率
具体的な数値を当てはめると
- DAU:1,000人
- 1人あたり1日の利用回数:3回
- 1回あたりのサービス使用時間:1,200秒
- GPU占有率:0.5
総GPU時間 = 1,000 × 3 × 1,200 × 0.5 = 1,800,000(秒)
ということで、この計算結果は、1日あたり約1,800,000秒(約500時間)のGPU処理時間が必要であることを示しています。
「同時リクエスト数」の計算
次に重要なのは「同時リクエスト数」の算出です。これは、サービス提供時間内に平均して何件のリクエストを同時に処理する必要があるかを示す指標です。計算式は以下の通りです。
同時リクエスト数 = (①DAU × ②1人あたり1日の利用回数 × ③1回あたりのサービス使用時間 × ④GPU占有率) ÷ ⑤サービス提供時間
つまり 同時リクエスト数 = 1,800,000 ÷ 43,200 = 41.66 ≒ 42 reqs/s
つまり、このLLMサービスでは毎秒平均42件のリクエストを同時に処理できる能力が必要ということになります。
GPUノード数の見積もり
さて、このリクエストをさばくには、いったいどれくらいのGPUノードが必要でしょうか。
まずシンプルに理解するために、少し極端な例で考えると
「GPUノード1個が1リクエストのみを捌く」
と仮定した場合、この例で挙げたリクエスト数を捌くためには
「42基のGPUノードが必要」
という計算になります。
はい、これは最も単純な見積もり方法なので同時にアクセスしてくる人の数だけGPUが必要というちょっと乱暴な展開ですが、1つのGPUで複数人のリクエストをさばくようにしたり、アクセス時間の分散を考えてみましょう。
コラム
実はGPU自体は「同時アクセス」ができるようには設計されていません。
GPUは同時にアクセスできるのは一人(人ではなくプログラムですが)のみです。
ただこの言い方は語弊があります。
GPUは同時に大量の計算をすることができます。並列に。でも複数のユーザーが同時にインターネットからアクセスしてきて、それをどうじに「さばく」ということはGPUの仕事ではなく、GPUのとりまわしをするソフトウェアの仕事です。そのソフトウェアは複数のユーザーからのリクエストや計算のリクエストをGPUからみたときには「1つの巨大な計算」に置き換えるための各種工夫をしています。本記事では詳細には触れておりませんが当社もそういったGPUにうまく分散させる「連続バッチ」「分散バッチ」といった技術開発をしていますhttps://blog.qualiteg.com/deep_learning_model_safe_inference_and_pooling/
- 1基のGPUは複数のリクエストを捌く
実際のGPUは、メモリ容量やモデルサイズによりますが、複数のリクエストを同時に処理できることが多いです。例えば、1台のGPUで2~4件のリクエストを同時処理できれば、必要なGPU数は大幅に削減できます。 - サービス利用にはピーク時間が存在する
実際のサービス利用は一日を通して均一ではなく、特定の時間帯に集中することが一般的です。例えば、業務時間中のサービスであれば午前中や午後の特定時間帯にリクエストが集中する傾向があります。このピーク時の負荷に対応できるシステム設計が必要です。
この2つの要素を考慮することで、より現実的なGPUノード数を見積もることができます。例えば、1台のGPUが平均3件のリクエストを同時処理でき、ピーク時のリクエスト数が平均の1.5倍だとすると
必要GPUノード数 = 42 ÷ 3 × 1.5 ≒ 21台
というように計算を修正することができるということになります。
LLMサービスへのリクエストのピーク時間の考慮
実際のサービス運用においては、より現実的な要素として「ピーク時間」を考慮する必要があります。
ここではピーク時のリクエスト数見積もりについてみていきましょう。
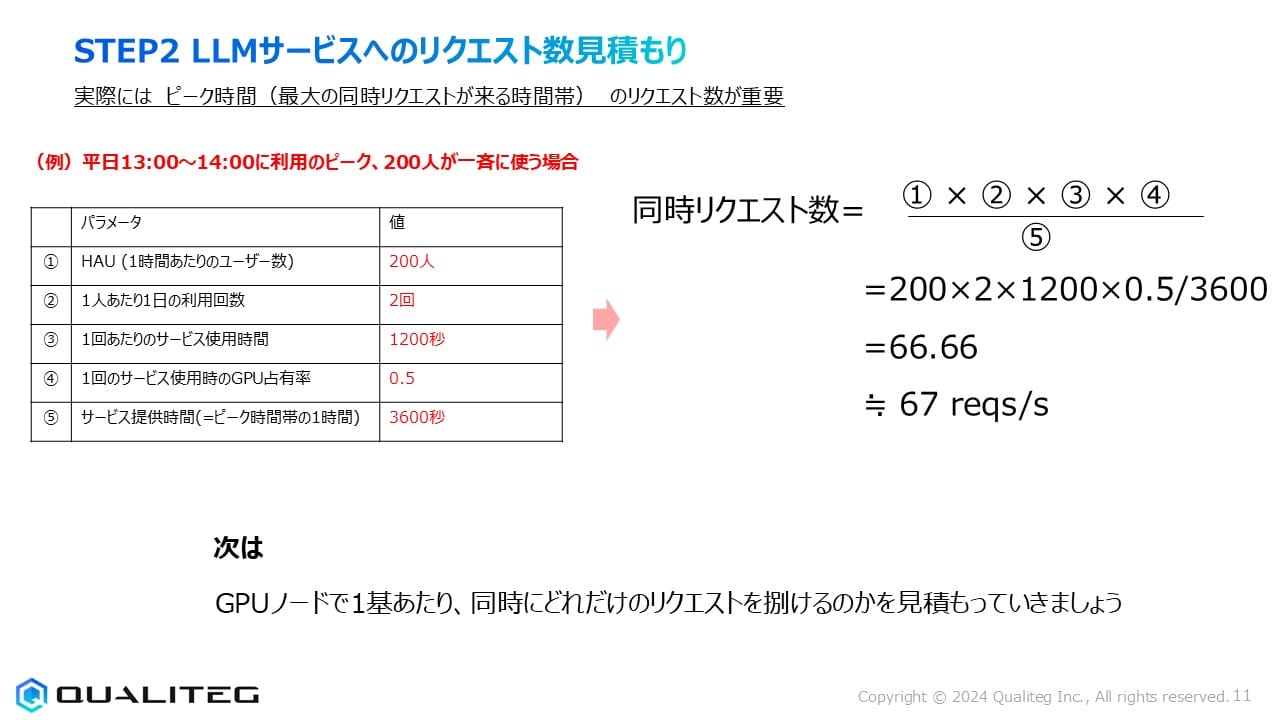
ピーク時間のリクエスト数が重要である理由
GPUをつかったLLMサービスの見積もりでは、平均的にどのくらいのアクセスがあるかではなくピーク時間(最大の同時リクエストが来る時間帯)のリクエスト数が重要です。なぜなら、サービスの安定性と品質はピーク負荷時にどれだけ正常に機能できるかによって評価されるからです。
日中のうち、特定の時間帯にリクエストが集中するのは多くのサービスで見られる現象です。例えば企業内のLLMサービスであれば、会議前の情報収集時間、昼休み後、または業務のまとめ作業をする夕方などに利用が集中することがあります。こうしたピーク時に十分なパフォーマンスを確保できるようにシステムを設計する必要があります。
ピーク時のリクエスト数計算例
図では具体的な例として「平日13:00~14:00に利用のピーク、200人が一斉に使う場合」というシナリオを提示しています。このピーク時における5つのパラメータは次のように設定されています
- HAU(1時間あたりのユーザー数): 200人 - ピーク1時間に集中するユーザー数
- 1人あたり1日の利用回数: 2回 - ピーク時間内での平均利用回数
- 1回あたりのサービス使用時間: 1200秒 - 1つのセッションに要する時間
- 1回のサービス使用時のGPU占有率: 0.5 - 実際にGPUを使用する割合
- サービス提供時間(ピーク時間帯の1時間): 3600秒 - 計算の基準となる時間枠
これらの値を用いて、ピーク時の同時リクエスト数を計算してみましょう。
同時リクエスト数 = (①HAU × ②1人あたり利用回数 × ③1回あたりのサービス使用時間 × ④GPU占有率) ÷ ⑤サービス提供時間
具体的な数値を代入すると
同時リクエスト数 = (200 × 2 × 1200 × 0.5) ÷ 3600 = 66.66 ≒ 67 reqs/s
この計算結果は、ピーク時間帯には毎秒約67件のリクエストを同時に処理できる能力が必要であることを示しています。これは先ほどの一日平均(42 reqs/s)と比較して約1.6倍の処理能力が必要になるということになります。
ピーク時対応の重要性
この計算例から分かるようにシステム設計時には平均的な負荷だけでなく、ピーク時の負荷に対応できる余裕を持たせる必要があるということです。仮に平均負荷のみを基準にシステムを設計すると、ピーク時には処理能力不足によるレスポンス遅延やサービス停止などの問題が発生する可能性があります。
例えば、平均では42 reqs/sの処理能力があれば十分ですが、ピーク時には67 reqs/sの処理能力が必要です。この差を考慮せずにシステムを設計すると、ピーク時にはシステムがオーバーロードし、ユーザー体験が著しく低下してしまう恐れがあります。
今回のまとめ
今回は、LLMサービス構築において必要となるGPUノード数を適切に見積もるための重要なステップ、「リクエスト数見積もり」について詳しく解説してきました。リクエスト数見積もりの基本的な考え方は、サービス設計における重要な基盤となります。過小評価すればサービス品質が低下し、過大評価すれば無駄なコストが発生するため、適切なバランスを取ることが重要ですね。
次のステップではGPUのスペックとLLMモデルの特性から、1台のGPUで同時に処理できるリクエスト数を見積もる方法、高精度なGPUノード構成の基本となる設計方法を学んでいきましょう。
それでは、また次回おあいしましょう
参考
GPUサーバーの最適容量計算: キューイング理論と実践的モデル
以下ブログではGPU負荷をキューイング理論で見積もる方法について解説しています、あわせてご参考になれば幸いです
https://blog.qualiteg.com/gpu-server-capacity-calculation-queuing-theory/
LLM/AIセキュリティのことなら株式会社Qualiteg
私たちQualitegは、LLMの推論・サービング基盤を実際に設計してきたエンジニアリングチームを有しており推論エンジンを単なる箱として扱わず、アテンション計算やKVキャッシュの挙動など深い知見をベースにしたローカルLLM技術のご支援を提供しています。「VRAMに収まる構成はどこか」「vLLMとHugging Face、判断軸は何か」「既存モデルを自社ドメインへ適応させる最短経路は」「オープンLLMと商用LLMの使い分け」「セキュアなローカルLLM構成はどうすればいいか」「ローカルLLMとGPUの選び方」「GPUデータセンターの需要と市場予測」「AI市場予測」などコア技術からAI市場分析まで、お気軽にご相談くださいませ。