
AIエージェント
Claude Fable 5.2 完全ガイド モデル仕様とAPI・Claude Code運用ポイント
Claude Fable 5.2の完全ガイド。Fable 5.1より20%安い料金と最大30%の高速化、独立評価の総合指数で上位3つを占めた性能、履歴の書き換えチェックなどAPI移行の要点、Claude Codeでの既定effortとFast modeまで解説。

AIエージェント
Claude Fable 5.2の完全ガイド。Fable 5.1より20%安い料金と最大30%の高速化、独立評価の総合指数で上位3つを占めた性能、履歴の書き換えチェックなどAPI移行の要点、Claude Codeでの既定effortとFast modeまで解説。
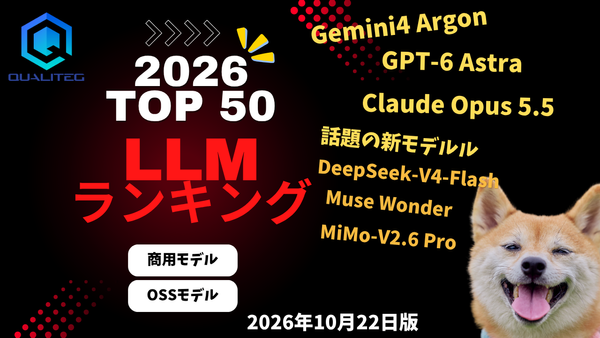
LLM
まず結論 2026年10月22日時点のLLMランキング 日本語対応LLMランキングの2026年10月22日版です。前置きは後回しにして、まず最新のランキングからお見せします。 フロンティアモデルの最新ランキング TOP20(Epoch Capabilities Index) 順位 モデル 開発元 提供形態 公開日(Epoch AI記載) ECI 1Claude Opus 5.5AnthropicAPI09/22168.8 2GPT-6 AstraOpenAIAPI09/03168.8 3GPT-6.1 SolOpenAIAPI09/29168.4 4Claude Fable 5.1AnthropicAPI09/01166.5 5Gemini 4 ArgonGoogleAPI09/30166.4 6Claude Sonnet 5.5AnthropicAPI09/28166.2
GPU
Ubuntu 24.04のGPUサーバーを再起動したらnvidia-smiが動かない。原因はunattended-upgradesがカーネルだけを更新し、NVIDIAモジュールが依存関係の都合で見送られていたこと。ログで原因を突き止め、1コマンドで復旧し、apt-mark holdを含む3つの再発防止策を比べて採用した記録。
LLM
TypeSafe AI の Jev は文章を書かず判断だけを返す新種のモデル。9月28日に登録が再開したが直接登録に無料クレジットは無い。$10 入れて Python から 301 回呼び、日本語の振り分け・ガードレール・コマンド承認の正解率、応答時間、試算した費用(約 1 円)を手元で測った。
OpenAI
GPT-6 Sol・Luna の完全解説。API 単価が半額になった中身、Astra や Claude Opus 5.5 との比べ方、推論量 none や入力 272K 超の割増など移行の注意点、Codex・Copilot での提供状況まで。
AIエージェント
Codex CLIのUpdate nowでGet-FileHashが見つからないエラー。PowerShell 7とWindows PowerShell 5.1の間で引き継がれるPSModulePathを調べ、0.154.0から0.156.1への更新に成功した手順を紹介します。
LLM
はじめに 本レポートは、Nejumi Leaderboard 4のベンチマークデータ(2026/9/1版)に基づいて、日本語対応LLMの性能を総合的に分析したものです。 前回は 2026/7/10 版の分析レポート を公開しましたが、わずか2か月弱で首位が入れ替わり、 オープンモデルが総合3位に食い込む激アツの回となりました! (定期的に最新LLMランキングを更新してまいります。当社のX(旧Twitter)をフォローいただくことで更新情報を受け取り可能です) Nejumi Leaderboard 4は、日本語タスクにおけるLLMの性能を多角的に評価する信頼性の高いベンチマークとして知られています。汎用的言語性能(GLP)とアラインメント(ALT)の2軸で構成され、翻訳・要約・推論・コーディングから毒性・バイアス・真実性まで、幅広い観点をカバーしているのが特徴です。 本分析では、商用APIモデルとオープンモデルの両方を対象に、それぞれの特徴や傾向を詳しく見ていきます。 まず、今回の3大トピックを先にご紹介します。 * Claude Opus 5が総合スコア0.8720で
LLM
こんにちは! 2026年7月24日、AnthropicからClaude Opus 5がリリースされました。 Opus 4.8(5月28日リリース)からわずか2ヶ月での世代交代です。このあたりのスピード感、加速していますね。 さて、当ブログではClaude Opus 4.7 完全ガイド、Claude Opus 4.8 完全ガイドとOpusの世代を追いかけてきましたが、今回のOpus 5は過去2回の「4.x内のアップデート」とは立て付けが根本的に違います。 何が違うのか。まず、Opus 5は「最上位モデル」ではありません。 Anthropicのラインナップには2026年6月9日リリースのClaude Fable 5が最上位として存在し、Opus 5はその下位、Sonnet 5の上位という「中上位」ポジションで投入されました。 Opusという名前が「最上位ティア」を意味した時代は、Fable 5の登場で終わっています。 そのうえでAnthropicはOpus 5を「
LLM
こんにちは! 2026年7月16日、中国・北京の Moonshot AI が新しいフラッグシップモデル Kimi K3 を発表し、APIやWebサービスでの提供を開始しました。 総パラメータ2.8兆という規模、100万トークンのコンテキスト、そして 「史上最大のオープンウェイトモデルになる」 という宣言がAI界隈をにぎわせています。 当ブログでは今年5月の記事「Mythos(ミュトス)レベルのオープンモデルはいつ出るのか」で、オープンモデルがクローズドのフロンティアにいつ追いつくのかを予測しました。 Kimi K3 は、まさにその問いに対する現時点での最新の「回答」のひとつです。 一方で、この記事を書いている7月20日時点では、モデルのウェイトも技術レポートもまだ公開されていません。 ただし、XなどSNSかいわいでは、 「ガードレールが弱めで、Fable5では拒否されるようなプロンプトでも対応してくれる」 「すぐにOpus4.8にフォールバックする Fable5より使い勝手がいい」 といった声が散見されており、 米国産のガードレール強め方針にたいして、ガードレール
LLM
はじめに 本レポートは、Nejumi Leaderboard 4のベンチマークデータ(2026/7/10版)に基づいて、日本語対応LLMの性能を総合的に分析したものです。 前回は 2026/3/6 版の分析レポート を公開しましたが、 約4か月ぶりとなる今回も、上位勢の顔ぶれが大きく入れ替わる激動の回となりました! (定期的に最新LLMランキングを更新してまいります。当社のX(旧Twitter)をフォローいただくことで更新情報を受け取り可能です) Nejumi Leaderboard 4は、日本語タスクにおけるLLMの性能を多角的に評価する信頼性の高いベンチマークとして知られています。汎用的言語性能(GLP)とアラインメント(ALT)の2軸で構成され、翻訳・要約・推論・コーディングから毒性・バイアス・真実性まで、幅広い観点をカバーしているのが特徴です。 本分析では、商用APIモデルとオープンモデルの両方を対象に、それぞれの特徴や傾向を詳しく見ていきます。まず、今回の3大トピックを先にご紹介します。 * Claude Opus 4.8がリーダーボード史上初の総合スコア0.8
ClaudeCode
こんにちは! 2026年6月に登場した Claude Fable 5 は、公開直後の輸出規制による一時停止、グローバル再展開、そしてサブスクリプション枠からの離脱と、わずか1か月でめまぐるしい動きを見せています。 当ブログでもその時々の状況を追ってきました。 まず全体像は ついに一般公開、Claude Mythos 5 / Fable 5 を実務視点で読み解く で、公開直後の停止騒動は 公開から3日で停止──Fable 5/Mythos 5 をめぐる米政府指令が示した、AI の新しい可用性リスク で、料金と今後の見通しは Claude Fable 5 はこれからどうなる? 経緯・コスト・今後の見通し で扱っています。 本記事は、それらを踏まえた「実務で使うための決定版ガイド」です。 とくに 2026年7月12日(日本時間7月13日)を境にサブスクリプション枠から外れ、使用クレジットを有効化しないと使えなくなる (この期限は当初2026年7月7日とされていましたが、のちに5日間延長されて7月12日になりました。
ClaudeCode
こんにちは! 2026年7月2日(日本時間)、日本からもClaude Fable 5が再び利用できるようになりました。 2026年6月に大きな注目を集めて登場し、わずか3日で米政府の指令により停止、そして7月1日(米国時間)に復活したAnthropicの最上位モデル「Claude Fable 5」。 復活と同時に 「サブスクで使えるのは7月7日まで」 という条件が付いたことで、利用者の間ではコストへの懸念の声も見られます。 本記事では、憶測と事実を切り分けながら、 (1)これまでの経緯、 (2)確定している料金体系、 (3)実際のコスト試算、 (4)今後の見通し、 の4点を整理します。確定情報(ファクト)と筆者の推測は明確に区別して書きます。 ※本記事の日付は、特記のない限りAnthropicの発表に基づく米国時間を基準としています。 なお当ブログでは、Fable 5 / Mythos 5についてリリース直後の技術解説、米政府指令による停止が示した可用性リスクの考察、Fable 5の安全分類器がClaude Code上で実際にどう振る舞ったかの体験記を公開してきました。
AIエージェント
ここ数年で、サイバーセキュリティをめぐる議論の前提は大きく変わりました。かつての中心は「いかに侵入を防ぐか」でしたが、いまは攻撃側も防御側も、ともにAIを使い始めています。攻撃が機械の速度で自動化・大規模化する一方、防御も人手だけでは追いつかない領域に入りつつあります。本記事では、公開されている市場データをもとに、AI時代のセキュリティ市場を「どこが伸び、どこが重なり、どこに注意すべきか」という観点から整理します。 「AIとセキュリティ」には三つの市場がある 最初に、用語を整理しておきます。「AIセキュリティ」とひとくくりにすると分かりにくいのですが、実際には少なくとも三つの異なるテーマが同時に進んでいます。 この三つの違いは、「誰がAIを使うのか」と「何を守るのか」で考えると分かりやすくなります。 第一は、防御側がAIを使う「AIで守る」領域です。 攻撃者がAIを使っているかどうかにかかわらず、企業やセキュリティ事業者がAIを利用して、サイバー攻撃やインシデントを検知・分析・阻止します。大量のログやアラートの分析、脅威の優先順位付け、異常の検知、初動対応の支援などは、すでに
生成AI最前線
こんにちは! 前回の記事では、Anthropicが2026年6月9日に発表したClaude Fable 5とClaude Mythos 5について取り上げました。 Mythos級の強力な能力にセーフガードを加え、一般ユーザーにも提供できる形へと降ろしたFable 5。 私たちはそれを、「神話が寓話になって降りてきた」と表現しました。 しかし、その寓話は、わずか3日で公開の場から姿を消すことになります。 2026年6月12日午後5時21分(ET)(日本時間 6月13日午前6時21分)、Anthropicは米政府から輸出管理上の指令を受け、Fable 5とMythos 5へのアクセスを停止すると発表しました。 指令の対象とされたのは、米国外の利用者だけではありません。 Anthropicの説明によれば、米国内にいる外国籍者や、同社で働く外国籍の従業員も含まれます。 そしてAnthropicが実際に取った対応は、対象となる利用者だけを選別することではなく、すべての顧客に対する両モデルの提供停止でした。 今回の出来事は、Fable 5のセーフガードが十分だったのかという技術論
LLM
こんにちは! Qualitegプロダクト開発部です。 2026年6月9日、Anthropicから Claude Fable 5(フェイブル5)と Claude Mythos 5(ミュトス5)が発表されました。 この記事では、 Fable 5 とは何か、Mythos 5 と何が違うのか、 Claude Code やAIエージェントを実務で使う立場から見て何が変わるのか を整理します。当社ブログを読んでくださっている方は、4月の「強すぎて出せないモデル "Mythos"」や「Mythosレベルのオープンモデルはいつ出るのか」でも触れた、あの Mythosクラスの一般公開版がついに来た、という話でもあります。 この記事でわかること * Fable 5 と Mythos 5 は「同じ基盤モデルだが、安全装置の有無が違う」こと * 高リスク領域では応答が Opus 4.
Bestllam
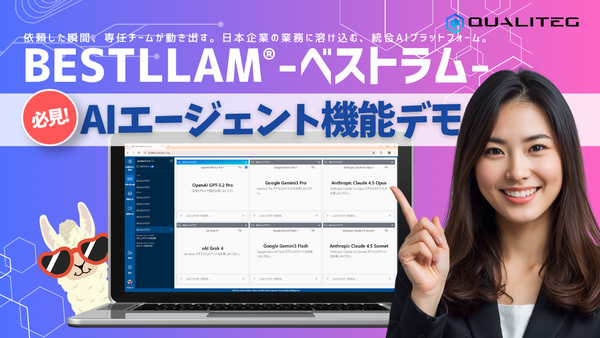
2026年11月2日 追記 動画の先へ。いまのBestllamでできること この動画は公開当時の画面・機能を紹介しています。現在のBestllamは40種類以上のAIモデルから選べ、会議録音からの議事録、会社の書式を使ったPowerPoint作成など、実際の成果物つきで活用方法をご覧いただけます。 * 40種類以上のモデルと、それぞれの特徴を見る * 会議録音から作った議事録のプレビュー・サンプル * 会社のPowerPointテンプレートを使った作成例 こんにちは! 本日は当社の統合AIプラットフォーム "Bestllam®" の AIエージェント機能のデモをご紹介いたします! 「指示は出せても、AIが本当に仕事を仕上げてくれるのか」 生成AIを業務に取り入れる企業が増えています。 しかし現場からは、こんな本音も聞こえてきます。 「使い方を覚えるより、自分でやったほうが早い」 「指示を細かく出し直しているうちに、結局時間がかかる」 「便利なのは分かるが、機密情報を入力していいのか不安」 AIを"個人の便利ツール"の域から、"部門の成果"